Utilice la función Data Import de SLS para ingerir los registros del agente de IA OpenClaw con un solo clic. Los paneles integrados de auditoría y observability proporcionan capacidades listas para usar en auditoría de seguridad y monitoreo operativo.
Contexto
Riesgos de seguridad en OpenClaw
OpenClaw es una plataforma líder de agentes de IA de código abierto que permite a los LLM manipular directamente sistemas de archivos, ejecutar comandos de shell, navegar por la web y enviar mensajes. Esta capacidad de ejecución autónoma constituye tanto su valor principal como su riesgo primario.
-
Incidentes de seguridad en la industria
A principios de 2026, los proveedores de seguridad revelaron varias vulnerabilidades en OpenClaw:
Fuente
Hallazgos
Estadísticas de investigación de seguridad
Más de 40,000 instancias de OpenClaw son accesibles desde la internet pública en varios países. De estas, aproximadamente 15,000 no tienen parches aplicados o utilizan configuraciones predeterminadas, lo que representa un riesgo de control remoto. Cerca del 93% de las instancias expuestas presentan vulnerabilidades graves de omisión de autenticación.
GitHub Security Advisory
(GHSA-g8p2-7wf7-98mq)
La interfaz de control (Control UI) confía ciegamente en el parámetro gatewayUrl de la URL y se conecta automáticamente. Al engañar a un usuario para que haga clic en un enlace malicioso, un atacante puede robar el token de la puerta de enlace y enviarlo a su servidor, lo que provoca una ejecución remota de código (RCE) con un solo clic (CVSS 8.8), incluso si la puerta de enlace solo escucha en localhost. Este problema se corrigió en la versión v2026.1.29.
Cadena de suministro de Skills
Se encontraron más de 800 Skills maliciosas (alrededor del 20% de todos los paquetes publicados) en el registro de Skills de OpenClaw, incluidas Skills diseñadas para el robo de credenciales y la instalación de puertas traseras. La instalación de Skills no verificadas escala los permisos del agente de IA.
Unit 42 y otras investigaciones
Se ha observado inyección indirecta de prompts (IDPI) en escenarios reales. Los atacantes insertan instrucciones ocultas en el contenido de páginas web. Cuando el agente recupera este contenido, puede ejecutar inadvertidamente dichas instrucciones, lo que deriva en exfiltración de datos u operaciones no autorizadas.
Supervisión regulatoria y advertencias
Los reguladores de varios países están prestando atención a los riesgos de los agentes de IA. El Ministerio de Industria y Tecnología de la Información de China (MIIT) emitió una alerta de seguridad sobre los riesgos del agente de IA de código abierto OpenClaw, y recomendó actualizaciones inmediatas y reforzamiento de la seguridad.
-
Frecuencia de correcciones de seguridad en el código fuente de OpenClaw
Más allá de las amenazas externas, una auditoría del código fuente de OpenClaw revela que el propio proyecto corrige problemas de seguridad con frecuencia. El análisis semántico del historial de commits de git cuantifica la escala y distribución de los cambios relacionados con la seguridad, e identifica dónde se concentra la superficie de ataque.
Tras filtrar y categorizar los commits recientes en el repositorio de OpenClaw, se observa que los riesgos se concentran en las capas de entrada y ejecución:
Módulo
Correcciones de seguridad
Porcentaje
Riesgos principales
src/tools/52
35%
Inyección de comandos, recorrido de rutas
src/gateway/38
26%
Control de acceso, autenticación, autorización
src/auth/18
12%
Omisión de autenticación, CSRF
src/sandbox/15
10%
Recorrido de rutas, SSRF
src/hooks/12
8%
Inyección de prompts, divulgación de información
Las capas
tools/ygateway/representan compensaciones inherentes a las operaciones autónomas. Las auditorías estáticas solo cubren los cambios confirmados y no pueden contemplar todas las variaciones de comportamiento en tiempo de ejecución ni las rutas de ataque impulsadas por entradas externas. -
Por qué la protección en tiempo de ejecución no es suficiente
Si se configura correctamente, OpenClaw puede reducir la superficie de ataque. Sin embargo, se trata de verificaciones en tiempo de ejecución dentro del mismo dominio de confianza, con limitaciones inherentes:
Capa de protección
Mecanismo y capacidad
Limitaciones inherentes
Pipeline de directivas de herramientas
Permite, deniega o solicita aprobación manual para llamadas a herramientas según directivas (por ejemplo, por remitente, canal o nombre de herramienta). Admite flujos de trabajo de aprobación ACP.
Configuraciones incorrectas de directivas, omisiones de reglas o evasiones de directivas (como encadenar herramientas legítimas para lograr efectos de alto riesgo) pueden provocar ejecuciones no autorizadas. La falta de auditoría independiente para cambios en las directivas dificulta la atribución posterior al incidente.
Detección de bloqueos/bucles
Detecta cuando una sesión no muestra progreso sustancial durante varios turnos (por ejemplo, sin nuevos mensajes de usuario/asistente, solo llamadas repetidas a herramientas) y activa una alerta o finalización.
Solo identifica bucles de "sin progreso". No detecta cadenas de operaciones de múltiples pasos que son lógicamente consistentes pero tienen resultados desastrosos (por ejemplo, inducir gradualmente la eliminación o exfiltración de datos). Los falsos positivos y negativos dependen del ajuste de umbrales.
Lista de permitidos/denegados de comandos
Filtra comandos ejecutables para herramientas como
execyshellmediante una lista de permitidos o denegados para reducir la ejecución arbitraria de comandos.Históricamente, los comandos ofuscados o codificados (como ejecución decodificada en base64, uso de alias o concatenación con saltos de línea) han evadido los filtros, lo que ha generado CVE y correcciones correspondientes. El mantenimiento de listas suele ir a la zaga de las nuevas técnicas de ataque.
Instrucciones de contexto y seguridad
Inyecta restricciones como "No hacer X" o "Se requiere aprobación para Y" a través de System Prompts, y depende de que el modelo las cumpla.
En conversaciones largas, la compresión de la ventana de contexto, la resumización o el truncamiento pueden diluir o hacer que el modelo "olvide" instrucciones críticas de seguridad. Las entradas adversarias pueden intentar anular o debilitar estas restricciones (inyección de prompts).
La protección en tiempo de ejecución bloquea la mayoría de las rutas de ataque conocidas, pero no garantiza una configuración perfecta ni cubre evasiones desconocidas. Una arquitectura segura necesita un "centinela" complementario para garantizar la observability continua y la auditoría de los llamadores del agente, el consumo de recursos y las secuencias de llamadas a herramientas.
Descripción general de la solución
La observability actúa como este "centinela", ya que utiliza datos de registros, métricas y trazas para monitorear el comportamiento del agente, respaldar pistas de auditoría y responder a preguntas como "quién llama, cuánto se gasta y qué se hace". Esto permite la detección temprana cuando fallan las directivas o surgen nuevos ataques.
Pilares de observability para agentes de IA
La observability se basa en tres pilares: datos de registros, métricas y trazas. Para OpenClaw, cada pilar se asigna a fuentes de datos específicas y preguntas clave:
|
Pilar |
Fuente de datos de OpenClaw |
Pregunta clave |
|
Registros (Registros de auditoría de sesiones) |
|
¿Qué hizo el agente? ¿Qué herramientas llamó? ¿Cuántos tokens utilizó y qué costo se generó? |
|
Registros (Registros de ejecución de aplicaciones) |
|
¿Dónde falló el sistema? ¿Hubo fallos de webhook, rechazos de autenticación o errores de puerta de enlace? |
|
Métricas |
Salida OTLP del plugin |
¿Son normales los costos y latencias actuales? ¿Hay sesiones bloqueadas o reintentos anormales? |
|
Trazas |
Salida OTLP del plugin |
¿Qué ruta siguió un mensaje individual desde su recepción hasta la respuesta? ¿Cómo se conecta la cadena de llamadas? |
Los tres pilares son esenciales. Las métricas por sí solas no responden al "quién" ni al "por qué". Los registros de sesión carecen de una vista global de la salud del sistema. Los registros de ejecución omiten el comportamiento empresarial. Solo en conjunto permiten realizar auditorías de seguridad, gestión de costos y resolución de problemas operativos.
Capacidades de SLS
SLS ofrece las siguientes ventajas para escenarios de OpenClaw:
-
Alineación nativa con el stack tecnológico de OpenClaw
LoongCollector admite de forma nativa los protocolos de registros y OTLP, y destaca en la recolección de registros de sesión de texto largo. Se integra perfectamente con el plugin
diagnostics-otelde OpenClaw sin requerir modificaciones, y envía métricas y trazas directamente a SLS mediante OTLP. -
Amplios operadores de consulta, análisis y procesamiento
Los registros de sesión utilizan JSON anidado (por ejemplo,
message.content,message.usage.cost,message.toolName). El motor SQL + SPL de SLS indexa y analiza campos anidados en tiempo real sin necesidad de ETL adicional. -
Capacidades de seguridad y cumplimiento
El control de acceso RAM, el enmascaramiento de datos sensibles y el almacenamiento cifrado cumplen con los requisitos de pistas de auditoría y normativas. SLS cuenta con una certificación dedicada de productos de seguridad de red, lo que lo hace adecuado para escenarios que requieren cumplimiento del Esquema de Protección Multinivel (MLPS). Los canales de alerta admiten DingTalk, SMS y correo electrónico para notificar incidentes oportunamente.
-
Totalmente gestionado, pay-as-you-go y auto scaling
El análisis de registros es un pipeline integral: "Recolección → Almacenamiento → Indexación → Consulta → Panel → Alertas", totalmente gestionado por LogStore y MetricStore. El modelo pay-as-you-go mantiene bajos los costos a pequeña escala, mientras que el auto scaling maneja el crecimiento del tráfico sin planificación manual de capacidad ni clústeres autogestionados de Elasticsearch o Prometheus.
SLS es una base ideal de observability y auditoría para la ejecución controlada de OpenClaw.
SLS ahora ofrece una solución de integración integral para OpenClaw:
Utilice el asistente Data Import para configurar la recolección. La configuración genera automáticamente un punto de entrada unificado y un Project para registros de sesión, registros de aplicación y telemetría OTLP, lo que reduce la complejidad de gestionar fuentes separadas.
Una única fuente de datos de sesión atiende múltiples escenarios, incluidos auditoría de seguridad, análisis de costos y análisis de comportamiento.
Paneles predefinidos para auditoría, análisis de costos y métricas de ejecución proporcionan una solución de observability lista para usar en la ejecución controlada.
Procedimiento
Paso 1: Ingesta de registros (ejemplo de registro de sesión)
Los registros de sesión capturan cada turno de conversación, llamada a herramienta y token consumido.
Requisitos previos
Cuenta con created a Project (por ejemplo,
openclaw-observability) y created a LogStore.Asegúrese de que LoongCollector is installed en la instancia ECS o en el servidor local donde se ejecuta OpenClaw.
Proceso de ingesta
Inicie sesión en la consola de Log Service. En el panel derecho, haga clic en Quick Data Import, seleccione la tarjeta de integración OpenClaw-Session Log y, a continuación, seleccione el Project y el LogStore de destino.
-
En la sección Machine Group Configurations, busque el grupo de máquinas que creó al instalar LoongCollector en la lista Source Machine Group y agréguelo a la lista Applied Machine Group.
Si un grupo de máquinas presenta una excepción de latido: Troubleshoot heartbeat exceptions .
-
En la página Logtail Configuration, Log Service completa automáticamente la configuración de recolección integrada. Si no requiere cambios, haga clic en Next.
El campo Configuration Name viene prellenado. Puede modificarlo si es necesario.
-
En Other Global Configurations, el campo Log Topic Type ya está configurado.
Acerca del tipo de tema de registro: LoongCollector puede extraer automáticamente el tema y el session_id de la ruta del archivo. Si personalizó la ruta del archivo y esta no coincide con el valor prellenado, debe ajustarla en consecuencia.
-
La File Path se llena automáticamente.
Acerca de la ruta del archivo de texto: La ruta de archivo prellenada asume una instalación predeterminada realizada por un usuario sin privilegios root en un host Linux. Si su ruta real es diferente, asegúrese de modificarla.
-
En Processing Method, hay una combinación de complementos de procesamiento preconfigurada.
Acerca del análisis de tiempo: De forma predeterminada, OpenClaw genera registros en la zona horaria UTC+0. Si modificó esta configuración, también debe cambiar la zona horaria en el complemento de análisis de tiempo para evitar discrepancias temporales.
-
En la página Query and Analysis Configurations, Log Service crea automáticamente un índice integrado y reportes. Puede consultarlos posteriormente en Dashboard y en los paneles correspondientes.
-
Índice integrado: Los índices de campo generados automáticamente incluyen los siguientes campos:
Ruta del campo
Tipo
__tag__:__hostname__text
__tag__:__session_id__text
__tag__:_pod_name_text
idtext
messagejson
El campo
messagecontiene los siguientes subcampos anidados:Ruta del campo
Tipo
apitext
contenttext
detailstext
details.aggregatedtext
details.cwdtext
details.durationMslong
details.exitCodelong
details.statustext
-
Paneles:
Panel de análisis de comportamiento de OpenClaw
Panel de auditoría de seguridad de OpenClaw
Panel de métricas de OpenClaw
Panel de análisis de tokens de OpenClaw
-
Paso 2: Auditoría y observación
SLS ofrece paneles predefinidos para OpenClaw que abarcan auditoría de seguridad, análisis de costos, análisis de comportamiento y métricas de tiempo de ejecución.
Inicie sesión en la consola de Log Service. En Projects, seleccione el Project de destino.
En Log Storage, vaya al LogStore de destino y haga clic en Search & Analyze para verificar la ingesta de datos y el formato de los registros.
-
En el panel de navegación izquierdo, haga clic en Dashboard para ver los paneles predefinidos.
-
Panel de auditoría de seguridad
El panel de auditoría de seguridad es el componente central para la ejecución controlada de OpenClaw. Responde a preguntas como: "¿Qué está haciendo el agente?, ¿existen acciones de alto riesgo? y ¿quién realiza operaciones fuera de los límites permitidos?". Proporciona monitoreo de comportamiento en tiempo real, identificación de amenazas y capacidades forenses que abarcan un resumen del comportamiento, comandos de alto riesgo, inyección de prompts y exfiltración de datos.
-
Página de resumen de estadísticas de auditoría de seguridad:
Esta página ofrece una instantánea de riesgos con conteos multidimensionales de operaciones de alto riesgo en una ventana de tiempo determinada. Muestra siete métricas (ejecuciones de comandos de alto riesgo, solicitudes web salientes, ejecuciones de línea de comandos salientes, comunicaciones salientes, acceso a archivos sensibles e inyección de prompts) junto con comparaciones respecto al periodo anterior para evaluar anomalías rápidamente.
Preste especial atención a las operaciones de alto riesgo que ocurren después de un evento de inyección de prompt. Aunque las operaciones de alto riesgo comunes pueden ser legítimas, un comportamiento de alto riesgo posterior a una inyección es una señal clara de amenaza que indica que instrucciones maliciosas impulsaron al agente a actuar. El indicador "Número de sesiones con llamadas a herramientas tras la inyección" es la señal de mayor confianza en esta página; tres sesiones de este tipo suelen justificar una prioridad más alta que cientos de comandos de alto riesgo ordinarios.
La tabla de sesiones de alto riesgo agrega los conteos de riesgo por sesión y los ordena según una puntuación de riesgo compuesta, lo que permite identificar primero las sesiones que requieren intervención manual.
-
Análisis de uso de Skills
Las Skills son el mecanismo de OpenClaw para ampliar sus capacidades, pero también constituyen un punto de entrada principal para la inyección de prompts. Los usuarios pueden instalar inadvertidamente Skills con vulnerabilidades o instrucciones maliciosas integradas. Por ello, la distribución de llamadas a Skills es fundamental para analizar las rutas de ataque.
El gráfico circular de distribución de uso establece una línea base para las llamadas a Skills. Un aumento repentino en una Skill poco común o la aparición de una nueva Skill suele indicar que el agente sigue una ruta no deseada y requiere investigación.
Las nuevas entradas en la tabla de Skills son críticas. Dado que las nuevas Skills no han sido evaluadas completamente en materia de seguridad, sus límites de permisos y patrones de comportamiento representan un punto ciego para el equipo de seguridad. Para detectar nuevas Skills tan pronto como aparezcan, ordénelas por hora de primera llamada en orden descendente. Esto le permite revisarlas antes de que sean explotadas.
-
Monitoreo de llamadas a comandos de alto riesgo
La capacidad de OpenClaw para ejecutar comandos del sistema lo convierte en un posible trampolín para atacantes. Un agente comprometido puede eliminar archivos, elevar privilegios o exfiltrar datos mientras aparenta un comportamiento normal de tareas.
El monitoreo de comandos de alto riesgo establece una capa de observability independiente de la protección en tiempo de ejecución. Los errores de configuración o los límites de permisos mal definidos pueden permitir que estos comandos pasen desapercibidos. La capa de observability garantiza que, incluso si fallan los controles en tiempo de ejecución, las operaciones de alto riesgo se detecten.
La vista de línea de tiempo identifica patrones de comportamiento más allá del simple conteo de eventos. Una ráfaga densa de llamadas de alto riesgo en un periodo breve —señal de un agente comprometido que ejecuta instrucciones maliciosas— requiere intervención inmediata. La tabla de detalles proporciona el contexto forense completo para rastrear anomalías hasta sesiones y comandos específicos.
-
Detección de inyección de prompts
La inyección de prompts es un método de ataque central que impulsa a una IA a realizar acciones dañinas. Independientemente de la ruta de ataque, las instrucciones maliciosas deben ingresar al prompt para afectar al agente. Estas rutas pueden incluir entradas directas del usuario, datos devueltos por llamadas a Skills o datos externos leídos por herramientas como
web_fetchyread. El prompt es el punto de entrada final para todas las rutas de ataque.La distribución de fuentes de inyección ayuda a determinar la naturaleza del riesgo. Las inyecciones provenientes de entradas directas del usuario suelen ser intencionales. En cambio, los usuarios a menudo desconocen las inyecciones entregadas mediante
toolResult. Para agentes de asistencia personal como OpenClaw, la inyección indirecta representa la amenaza principal. Las Skills instaladas o el contenido externo accedido pueden convertirse en vectores de inyección difíciles de identificar y evitar para los usuarios.Clasificar las inyecciones permite identificar la intención del ataque, no solo marcar anomalías. Por ejemplo, las inyecciones
ROLE_HIJACKyJAILBREAKindican que un atacante intenta evadir los límites de comportamiento del agente.HIDDEN_INSTRUCTIONrepresenta una técnica de implantación más sigilosa. La prioridad de respuesta y los procedimientos de manejo difieren para cada tipo. Monitorear continuamente los cambios en la distribución de estas clasificaciones ayuda a detectar intentos focalizados sobre superficies de ataque específicas.Una tabla de detalles registra la herramienta desencadenante, el contexto de la sesión y el contenido original de cada evento de inyección. Esta tabla permite a los equipos de seguridad pasar rápidamente de las estadísticas resumidas a incidentes específicos, cerrando el ciclo desde el reconocimiento de patrones hasta el análisis de causa raíz y la respuesta.
-
Detección de exfiltración de datos sensibles
La exfiltración de datos desde un agente de IA suele seguir una cadena: el agente lee un archivo sensible, el contenido ingresa al contexto del modelo y una llamada posterior a una herramienta lo transmite externamente. Solo la correlación entre el acceso a archivos y el comportamiento saliente revela la intención completa del ataque.
La detección utiliza un enfoque de embudo: la primera capa registra el acceso a archivos sensibles por tipo de activo (SSH_KEY, ENV_FILE, CREDENTIALS, CONFIG_SECRET, HISTORY). La segunda capa rastrea el comportamiento saliente por canal (API_CALL, MESSAGE_SEND, WEB_ACCESS, EMAIL). La tercera capa correlaciona ambos aspectos: si el acceso a un archivo sensible y una operación saliente ocurren en rápida sucesión dentro de la misma sesión, se marca un evento de exfiltración de alta prioridad.
El valor reside en la localización causal, no en alertas de puntos aislados. Leer un SSH_KEY por sí solo no constituye una amenaza, ni tampoco un API_CALL. Pero ambos en la misma sesión, separados por minutos, con parámetros salientes que contienen el contenido del archivo, aumentan drásticamente la confianza en la amenaza. La tabla de cadenas de comportamiento muestra la diferencia horaria y los parámetros completos de la llamada para facilitar el juicio forense sin necesidad de correlacionar registros manualmente.
-
-
Panel de análisis de tokens
El consumo de tokens se relaciona directamente con los costos, y sus fluctuaciones suelen señalar anomalías como la inflación de contexto por inyección de prompts. El panel de análisis de tokens responde a: "¿En qué se gasta el dinero?, ¿es razonable? y ¿existen anomalías?".
Acerca de los datos de costos: El campo
costdel panel proviene del campousage.costde OpenClaw. OpenClaw no admite de forma nativa precios escalonados, y su lógica de cálculo de cacheRead + cacheWrite puede no coincidir con la del proveedor. Solo estima el costo de una sola llamada mediante una fórmula comoinputTokens × input + outputTokens × output + .... Por lo tanto, los costos mostrados en el panel son una línea base para la estimación de costos , no un estado de cuenta exacto. Para los modelos en los quecostno está configurado, la columna de costo mostrará 0.Tome como ejemplo el modelo Qwen3.5-Plus. Los costos de las llamadas a la API de Model Studio se encuentran en Model List.
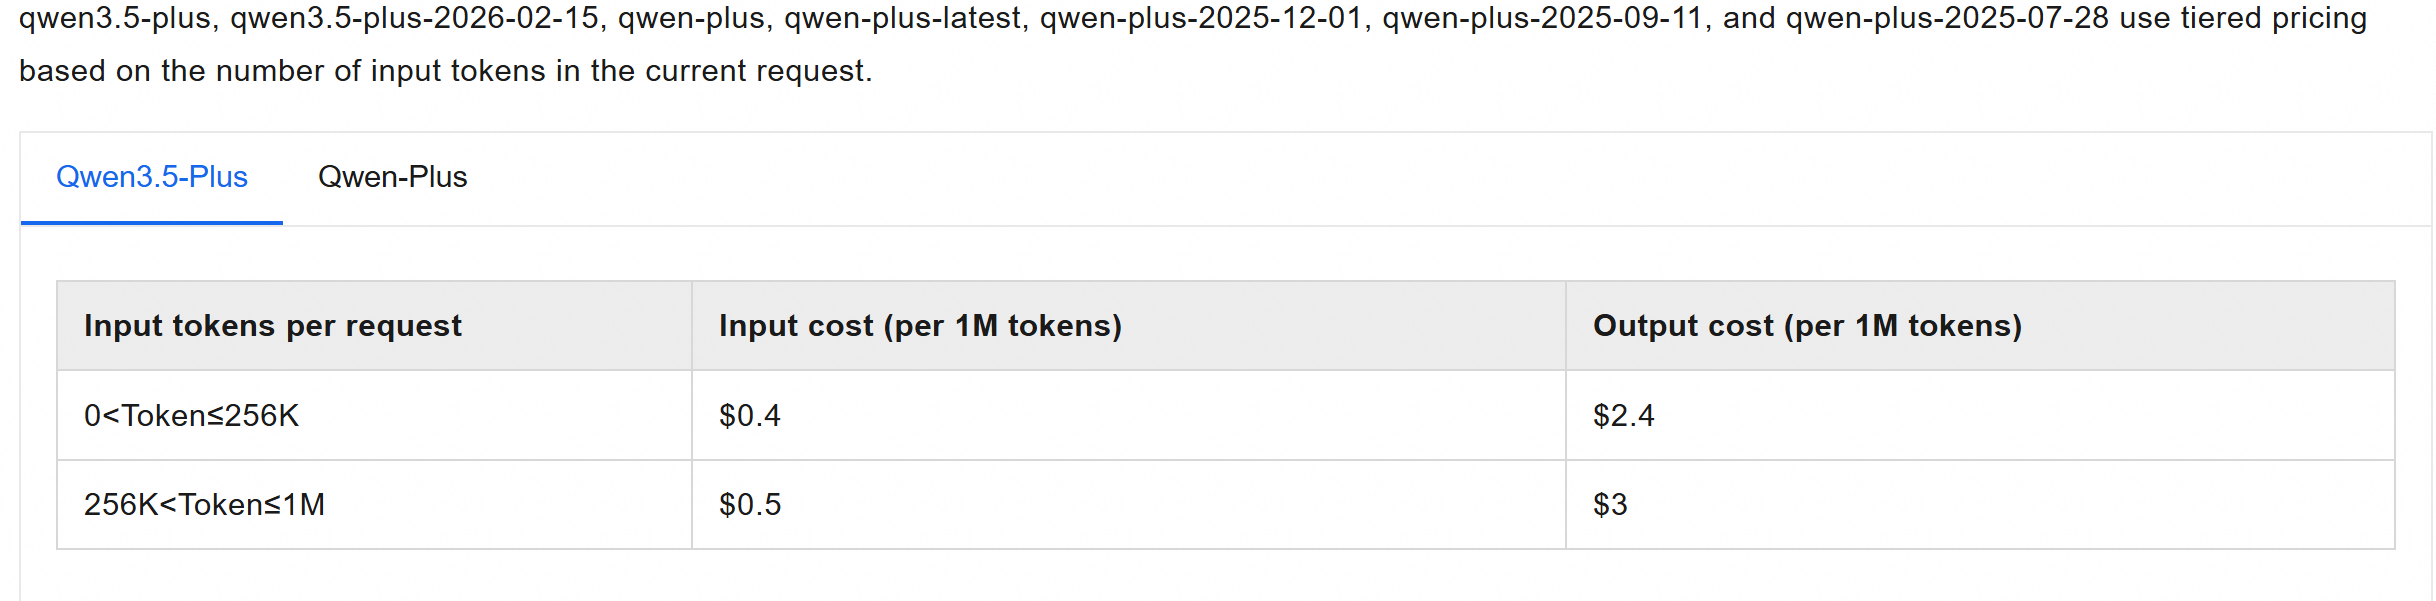
La configuración de costos del modelo en .openclaw es la siguiente:
{ "id": "qwen3.5-plus", "name": "Qwen3.5 Plus", "cost": { "input": 0.4, // From the lowest tier input price "output": 2.4, // From the lowest tier output price "cacheRead": 0.2, // Estimated as half of the input cost "cacheWrite": 0 }, }-
Resumen general y distribución por modelo
El panel muestra comparaciones diarias de tokens totales y costos con porcentajes respecto al periodo anterior. Si el cambio diario supera un umbral (por ejemplo, ±30%), suele indicar inflación de prompts, un bucle de llamadas o una sesión anómala que requiere investigación.
-
Tendencias de consumo por proveedor/modelo (series temporales)
Dos gráficos de series temporales (de 1 semana) muestran las tendencias de consumo de tokens y costos por modelo. Los picos de tokens suelen ser señales de seguridad: inyección de prompts que infla el contexto, bucles infinitos de llamadas a herramientas o expansión de sesiones no detectada. Al codificarse por colores según el modelo, los cambios aparecen como variaciones en la composición cromática para una identificación rápida.
-
Mayor consumo por sesión y por host/Pod (gráficos de barras)
-
La disposición de gráficos de barras de 2×2 responde a "¿quién gasta el dinero?" desde las perspectivas de sesión y host (o Pod):
Top tokens by session / Top cost by session: Muestra los tokens totales y los costos por sesión durante la última semana, ordenados de forma descendente. La distribución de costos suele seguir una distribución de cola larga: unas pocas sesiones concentran la mayor parte del consumo.
Top tokens by host / Top cost by host: Agrega tokens y costos por host o Pod para el análisis de costos y la localización de riesgos en despliegues de múltiples instancias. Combinado con la propiedad de los activos, esto asigna el consumo a los responsables y ayuda a identificar usuarios de riesgo o sesiones descontroladas.
-
-
Tabla de detalles de tokens por modelo (desglose de costos)
La tabla de detalles (relativa a 1 semana) enumera lo siguiente para cada modelo:
totalTokens,inputTokens,outputTokens,cacheReadTokensycacheWriteTokens, junto con sus correspondientestotalCost,inputCost,outputCost,cacheReadCostycacheWriteCost. Admite ordenamiento y filtrado, lo que permite responder directamente "qué modelo gastó más dinero y cuál fue el desglose de entrada/salida". La proporción deinputTokensaoutputTokensrefleja el patrón de interacción del agente: una proporción alta de entrada sugiere prompts o contexto redundantes, mientras que una proporción alta de salida puede indicar que el modelo genera una gran cantidad de contenido no válido. El porcentaje decacheReadTokensmuestra directamente la ventaja de la estrategia de caché: cuanto mayor sea el porcentaje, menor será el monto facturado realmente, lo que proporciona una base cuantitativa para el prompt engineering y el ajuste de la caché.
-
-
Panel de análisis de comportamiento
El panel de análisis de comportamiento registra y clasifica el comportamiento operativo de OpenClaw por sesión, respondiendo a: "¿Qué hizo el agente durante la ventana de tiempo actual?".
-
Estadísticas de sesión
Las tarjetas de conteo desglosan las llamadas a herramientas por tipo de comportamiento: ejecución de comandos, procesos en segundo plano, solicitudes web, herramientas de comunicación y E/S de archivos. Las excepciones de llamadas se listan por separado para evaluar la estabilidad.
La tabla de estadísticas de sesión registra los conteos de llamadas por tipo de comportamiento dentro de cada sesión, ordenados por última hora de actividad. Las sesiones inusualmente activas (por ejemplo, 1,925 llamadas a herramientas frente a los conteos bajos típicos) se resaltan para su revisión prioritaria.
-
Estadísticas de volumen de llamadas a herramientas y análisis de errores
Las llamadas a herramientas son el único canal de interacción externa del agente. La línea de tiempo de llamadas a herramientas muestra la frecuencia de llamadas a lo largo del tiempo, codificada por colores según el tipo de herramienta; los picos son el primer punto de entrada para la solución de problemas. El gráfico de tendencia de tasa de errores comparte el eje temporal; la diferencia de tiempo entre los picos de error y de volumen a menudo revela la verdadera fuente del problema.
El registro completo de llamadas a herramientas proporciona el error de protocolo, el estado de ejecución y el contenido devuelto para cada llamada, lo que le permite pasar rápidamente de una anomalía de tendencia a la llamada fallida específica para localizar la causa raíz.
-
Interacciones externas
Las interacciones externas registran todas las acciones salientes iniciadas por el agente durante su operación, incluidas llamadas a API, acceso web, envío de mensajes y envío de correos electrónicos. Los datos se presentan categorizados por sesión, nombre de herramienta y tipo de interacción.
Para un agente de IA, las interacciones externas son necesarias para completar tareas, pero también representan una fuente potencial de riesgo. Un registro completo del comportamiento de interacción externa ayuda a los equipos a comprender los límites reales de capacidad y los hábitos de uso del agente. Por otro lado, proporciona un contexto conductual completo cuando ocurren anomalías, lo que respalda el análisis de correlación y la investigación forense entre herramientas y sesiones.
-
-
Paso 3: Explorar datos con consultas personalizadas
Los paneles integrados son el punto de partida para descubrir problemas, no el final. Cuando un panel señala una sesión de alto riesgo, un pico anómalo o una alerta de métrica, necesita profundizar desde el resumen estadístico hasta el evento específico para reconstruir la cadena de comportamiento y confirmar la causa raíz.
Modelo de datos de registro para análisis personalizado
SLS crea previamente un índice para el análisis de auditoría, por lo que puede consultar datos directamente. Dos tipos de registro constituyen las fuentes de datos principales:
-
Registros de sesión: Registran el comportamiento empresarial completo del agente y son la base principal para la auditoría de seguridad y el análisis de costos. Estos son los registros ingeridos en Step 1: Log ingestion (session log example).
Ruta del campo
Tipo
Propósito
__tag__:__session_id__text
Identificador único de sesión. Campo clave para aislar y agregar datos por sesión.
typetext
Tipo de entrada:
session(metadatos de sesión),message(mensaje de conversación) ocompaction(resumen de compresión de contexto). Úselo para filtrar registros de conversación auditables.message.roletext
Rol del mensaje:
user(entrada del usuario),assistant(respuesta del modelo) otoolResult(retorno de herramienta). Úselo para identificar el sujeto de la acción.message.contenttext
Cuerpo del mensaje. Incluye entradas del usuario, salidas del modelo y parámetros/valores de retorno de herramientas. Admite detección de inyecciones, coincidencia de datos sensibles y búsqueda de texto completo.
message.providermessage.modeltext
Proveedor del modelo y nombre del modelo. Úselo para análisis de costos y estadísticas de comportamiento por modelo.
message.usage.totalTokensmessage.usage.cost.totallong / double
Uso de tokens y costo estimado. Úselo para detectar consumos anómalos y clasificar costos a nivel de sesión.
message.stopReasontext
Motivo de terminación de respuesta:
stop(fin normal),toolUse(se activó una llamada a herramienta; la siguiente entrada suele ser toolResult),error/aborted/timeout(terminación anómala). Campo clave para filtrar sesiones anómalas.message.toolNamemessage.isErrortext / bool
Nombre de la llamada a herramienta y estado de ejecución. Úselo con el rol
toolResultpara auditoría a nivel de herramienta.id,parentIdtext
ID de entrada e ID principal. Úselos para construir el árbol de conversación y reconstruir el orden de los mensajes. El
idde una entrada de tiposessiones el sessionId.timestamptext
Marca de tiempo del evento. Úsela para filtrar ventanas de tiempo, ordenar y definir alcances de alertas.
-
Registros de tiempo de ejecución: Registran el estado operativo de la puerta de enlace y varios subsistemas. Constituyen la base de datos para la solución de problemas y el análisis de salud del sistema.
NotaSeleccione la tarjeta OpenClaw-Runtime Log y siga las instrucciones en Step 1: Log ingestion (session log example) para completar la ingesta.
Ruta del campo
Tipo
Propósito
_meta.logLevelNametext
Nivel de registro (TRACE / DEBUG / INFO / WARN / ERROR / FATAL). Úselo para centrarse en ERROR y FATAL durante la solución de problemas.
_meta.pathtext
Ruta del archivo de código fuente y número de línea. Vincula con precisión a ubicaciones de código para el análisis de seguimiento de pila.
Clave numérica
"0"object (JSON)
Contexto estructurado. Generalmente contiene un campo
subsystem(comogateway,channels,telegramoplugins).Clave numérica
"1"y claves subsiguientestext
Cuerpo del mensaje de registro y contenido del seguimiento de pila. Admite búsqueda de texto completo y coincidencia de palabras clave.
Profundización a nivel de sesión
Escenario típico: El panel de auditoría marca una sesión de alto riesgo. El equipo de seguridad necesita reconstruir su interacción completa para confirmar la amenaza.
En un despliegue de múltiples instancias, todos los registros se escriben centralmente en un LogStore de SLS. Aísle por ID de sesión para aclarar "quién activó qué solicitudes, qué herramientas se llamaron y cómo respondió el modelo".
Inicie sesión en la consola de Log Service. En Projects, seleccione el Project de destino.
En Log Storage, vaya al LogStore de destino y haga clic en Search & Analyze para explorar los datos. Utilice la consulta
* and __tag__:__session_id__:<Session_Id>para filtrar, reemplazando<Session_Id>con el ID de sesión real.Después de filtrar la sesión, en la sección Raw Logs, busque el registro objetivo en la pestaña Raw Data y haga clic en el icono
 para abrir la vista contextual del registro. Esto reconstruye la cadena de comportamiento completa dentro de esa sesión en su orden original: la entrada del usuario, la inference del modelo, las solicitudes de llamada a herramientas y los resultados de ejecución de herramientas se muestran claramente en secuencia. Esto es crucial para la auditoría, ya que identifica secuencias de llamadas anómalas (como la lectura de un archivo sensible seguida de una operación saliente) y proporciona el contexto completo para reproducir y preservar evidencia de incidentes de seguridad.
Solución de problemas de tiempo de ejecución: búsqueda por palabras clave y análisis de agregación
Escenario típico: Una alerta del panel de métricas de tiempo de ejecución indica un aumento repentino en la tasa de errores. Necesita localizar rápidamente el módulo defectuoso y la causa raíz a partir de un volumen masivo de registros de tiempo de ejecución.
SLS admite una combinación de búsqueda de texto completo y búsqueda de campos estructurados que, junto con el filtrado por rango de tiempo, le permite reducir progresivamente el alcance de la investigación. Una ruta típica de solución de problemas implica dos pasos: primero, reducir el alcance; luego, cuantificar la distribución.
Paso 1: Filtrar progresivamente para aislar el problema
Filtrar por nivel de registro: Utilice la consulta
_meta.logLevelName: ERROR or _meta.logLevelName: WARN or _meta.logLevelName: FATALpara filtrar todos los registros de error y advertencia, centrando la atención en eventos anómalos.Profundizar por subsistema: Agregue una condición de campo a la consulta de registro de errores, como
0.subsystem: plugins. La declaración de análisis completa sería(_meta.logLevelName: ERROR or _meta.logLevelName: WARN or _meta.logLevelName: FATAL) and 0.subsystem: plugins. Esto reduce el alcance a un subsistema específico. Estos dos pasos de filtrado pueden localizar rápidamente los registros de errores relevantes.
Paso 2: Usar agregación SQL para cuantificar la distribución global
Mientras que el filtrado por palabras clave identifica eventos individuales, el análisis de agregación SQL eleva esto a una vista estadística global. Por ejemplo, agrupar por el campo subsystem con la declaración de análisis _meta.logLevelName: ERROR or _meta.logLevelName: WARN or _meta.logLevelName: FATAL | select "0.subsystem" as subsystem, count(1) as c group by subsystem presenta visualmente la distribución de errores en todos los subsistemas. Esto le ayuda a identificar rápidamente anomalías concentradas y le orienta en la dirección correcta para una investigación más profunda.
Paso 4: Correlacionar datos de múltiples fuentes
En la práctica, las fuentes de datos de observability siguen un patrón colaborativo fijo de reducción progresiva y corroboración:
Métricas OTLP → Registros de aplicación (contexto de error) → Registros de auditoría de sesión (cadena de comportamiento completa). Descubra una anomalía en las métricas OTLP (latencia, uso de tokens o pico en la tasa de errores), localice los detalles del error en los registros de la aplicación para la ventana de tiempo (tiempo de espera de webhook, fallo de autenticación o error de puerta de enlace), luego profundice en los registros de auditoría de sesión y reconstruya la secuencia completa de llamadas a herramientas, el contenido de interacción del modelo y el consumo de costos de la sesión, confirme la causa raíz y preserve la evidencia de auditoría.