PolarDB for MySQL 8.0 proporciona la función de consulta paralela elástica (ePQ). Esta función se habilita automáticamente cuando el volumen de datos de la consulta supera el umbral especificado, lo que reduce significativamente el tiempo de ejecución de las consultas.
Introducción
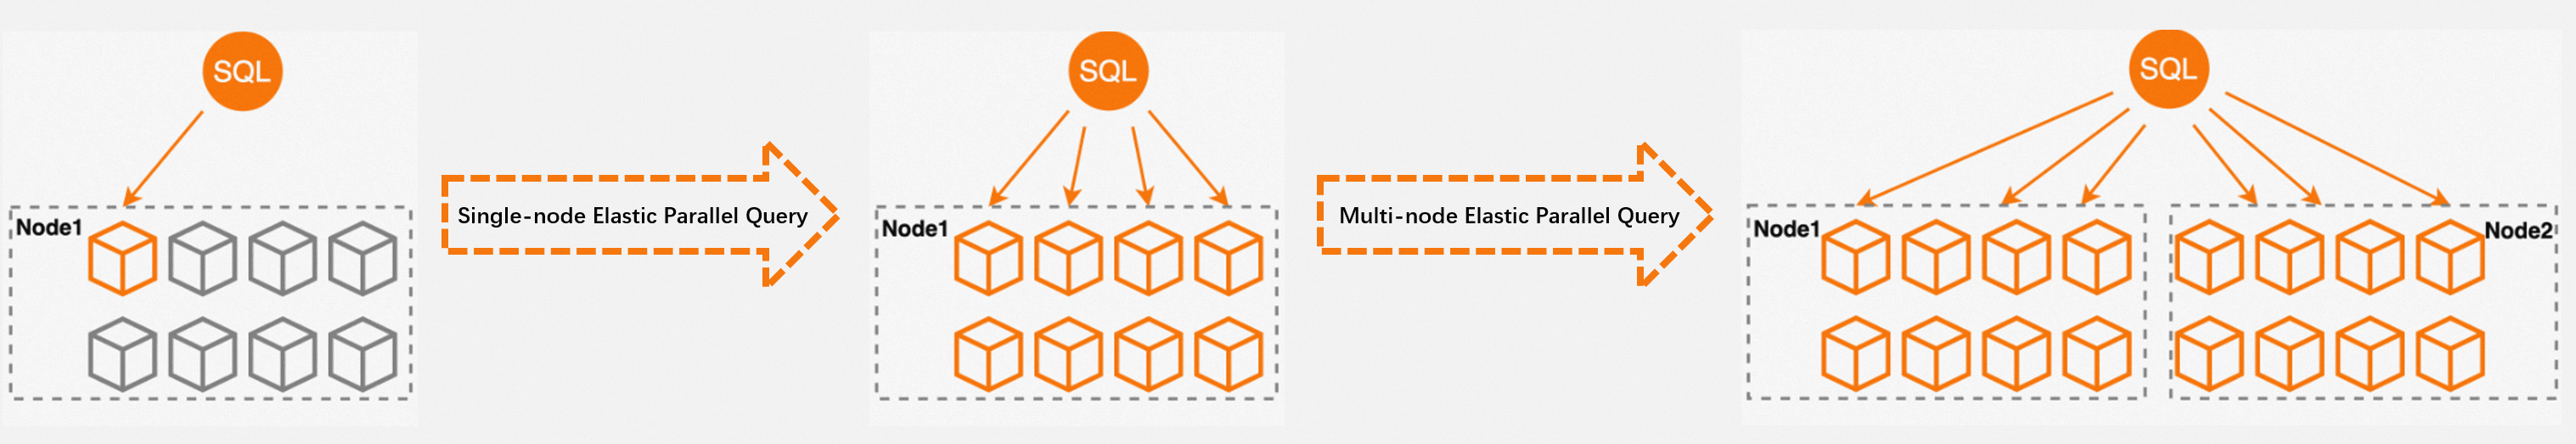
La función ePQ admite dos motores paralelos: la consulta paralela elástica de nodo único y la consulta paralela elástica multinodo. La consulta paralela elástica de nodo único equivale a la función original de consulta paralela. Por su parte, la consulta paralela elástica multinodo admite la programación adaptativa entre los nodos de un clúster.
PolarDB for MySQL 8.0.1 solo admite la consulta paralela elástica de nodo único. Los datos de la consulta se fragmentan en distintos hilos dentro de la capa de almacenamiento. Estos hilos se ejecutan en paralelo y devuelven los resultados al hilo líder. Después, el hilo líder combina los resultados y devuelve el resultado final a los usuarios. Este proceso mejora la eficiencia de las consultas.
PolarDB for MySQL 8.0.2 admite tanto la consulta paralela elástica de nodo único como la multinodo. La variante multinodo mejora de forma significativa las capacidades de aceleración lineal e implementa el cómputo paralelo distribuido en varios nodos. La optimización basada en costos permite que los planes de ejecución sean flexibles y se ejecuten en paralelo. Esto resuelve los posibles cuellos de botella del hilo líder y los desequilibrios de carga de los workers que ocurren en las consultas paralelas elásticas de nodo único. También supera las limitaciones de CPU, memoria y E/S de un solo nodo. Las vistas de recursos multinodo y la programación adaptativa de las tareas de cómputo paralelo mejoran considerablemente las capacidades de procesamiento. Además, reducen la latencia de las consultas, equilibran la carga de recursos de los nodos y optimizan el uso general de los recursos del clúster.
La función ePQ resuelve el problema de una utilización baja y desigual de los recursos de CPU en las instancias de usuario basadas en la nube. Para lograrlo, aprovecha por completo las capacidades de procesamiento paralelo de las CPU multinúcleo dentro del clúster. A continuación se muestra el proceso en un clúster de PolarDB for MySQL de 8 núcleos y 32 GB (especificaciones dedicadas).
Requisitos previos
El clúster de PolarDB for MySQL debe cumplir con a continuación requisitos:
-
Consulta paralela elástica de nodo único:
Motor de base de datos: 8.0.1, con una versión de revisión 8.0.1.0.5 o posterior.
Edición de la base de datos: Enterprise Edition .
-
Consulta paralela elástica de nodo único:
Motor de base de datos: 8.0.2, con una versión de revisión 8.0.2.1.4.1 o posterior.
Edición de la base de datos: Enterprise Edition.
-
Consulta paralela elástica multinodo:
Motor de base de datos: 8.0.2, con una versión de revisión 8.0.2.2.6 o posterior.
Edición de la base de datos: Enterprise Edition.
Para obtener información sobre cómo consultar la versión de un clúster, consulte Query the engine version.
Escenarios
La función ePQ es compatible con la mayoría de las instrucciones SELECT, como las consultas en tablas grandes, las consultas multitabla que usan instrucciones JOIN y las consultas sobre grandes volúmenes de datos. Sin embargo, no ofrece beneficios significativos en consultas cortas. Sus diversos métodos de paralelismo la hacen adecuada para los siguientes escenarios:
-
Consultas analíticas sobre grandes volúmenes de datos
Cuando se procesan volúmenes medianos o grandes de datos, las instrucciones SQL de las consultas analíticas suelen ser complejas y consumir mucho tiempo. Habilite la función ePQ para reducir el tiempo de respuesta de manera lineal.
-
Desequilibrio en la carga de recursos
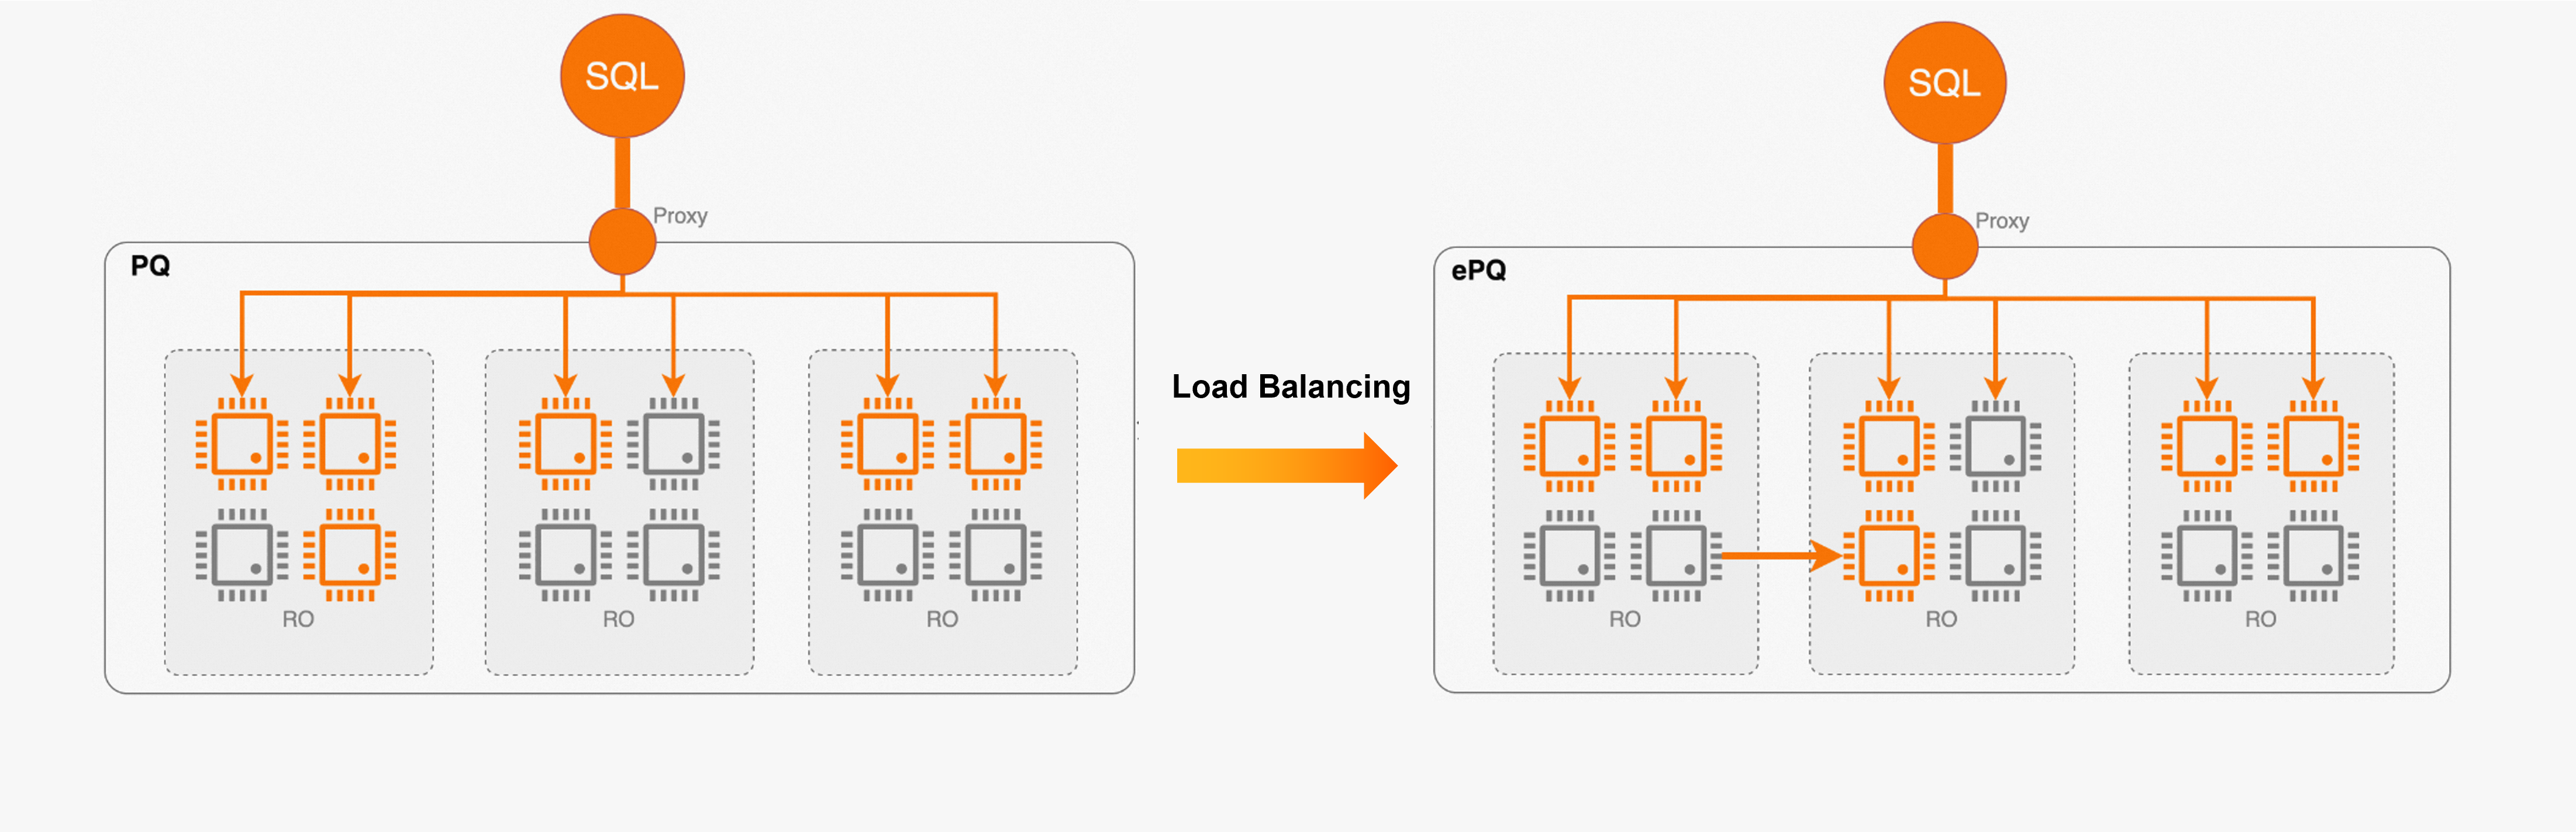
Las capacidades de balanceo de carga de PolarProxy ayudan a garantizar que se creen cantidades similares de conexiones para los nodos de un clúster. No obstante, debido a la complejidad de cómputo de las consultas y a las diferencias en el uso de recursos, este balanceo basado en conexiones no evita por completo el desequilibrio de carga entre nodos. Al igual que en otras bases de datos distribuidas, los nodos saturados afectan negativamente a PolarDB:
Si un nodo de solo lectura saturado provoca consultas lentas, es posible que el nodo principal no pueda purgar los registros undo, lo que genera un crecimiento excesivo del disco.
Si un nodo de solo lectura saturado ralentiza las operaciones de aplicación de redo, el nodo principal podría no vaciar los datos, lo que reduce el rendimiento del throughput de escritura.
La función ePQ introduce vistas globales de recursos y una programación adaptativa de tareas basada en dichas vistas. Con base en los valores de resource usage y data affinity de cada nodo, algunas o todas las tareas de consulta se programan hacia nodos con recursos disponibles. De esta forma, se garantiza el grado de paralelismo (DOP) deseado y se equilibra el uso de recursos dentro del clúster.
-
Cómputo elástico
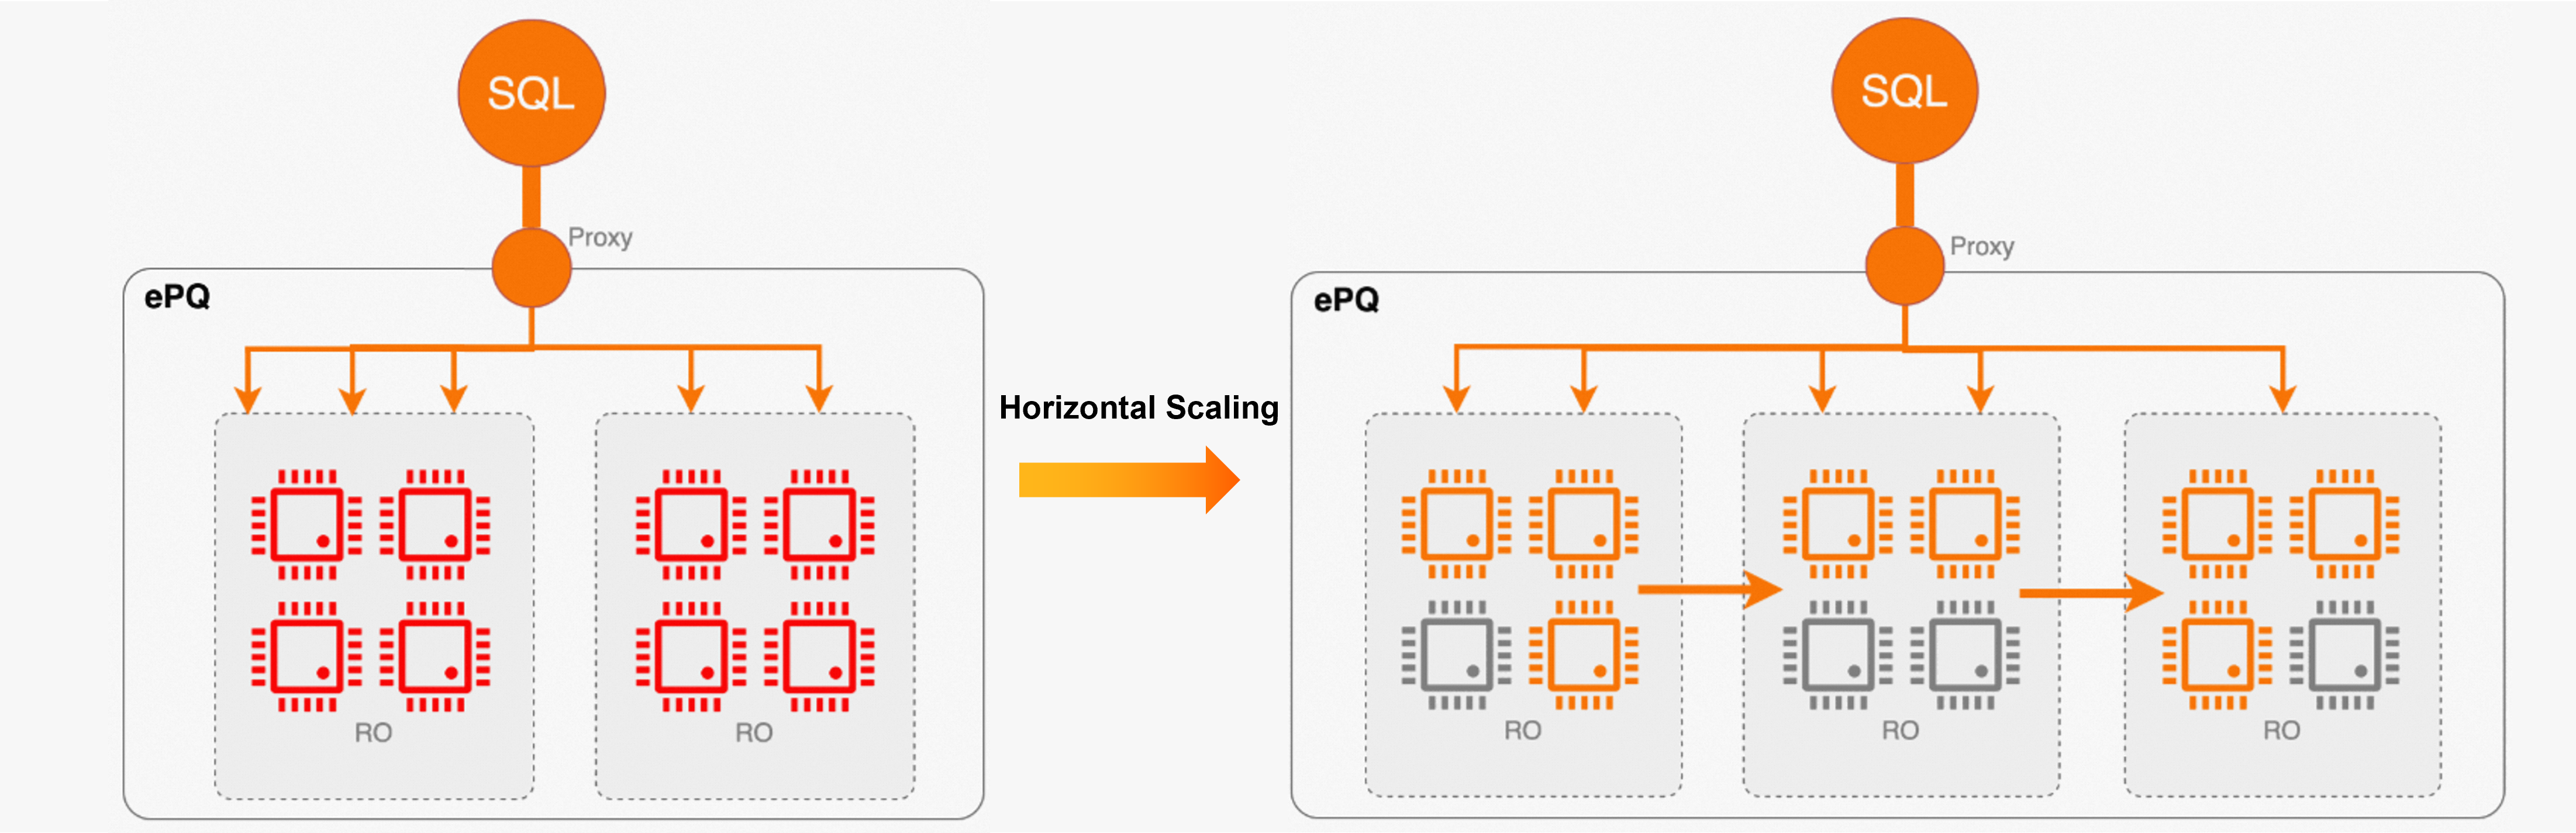
La elasticidad es una de las capacidades principales de PolarDB. El escalado automático proporciona una elasticidad adecuada para consultas cortas. Sin embargo, no resulta útil para consultas analíticas complejas, ya que agregar nodos no acelera una sola consulta en escenarios de gran escala. Cuando se habilita la función ePQ en un clúster, los nodos recién escalados se agregan automáticamente para compartir recursos de cómputo y mejorar la elasticidad.
-
Combinación de servicios en línea y fuera de línea
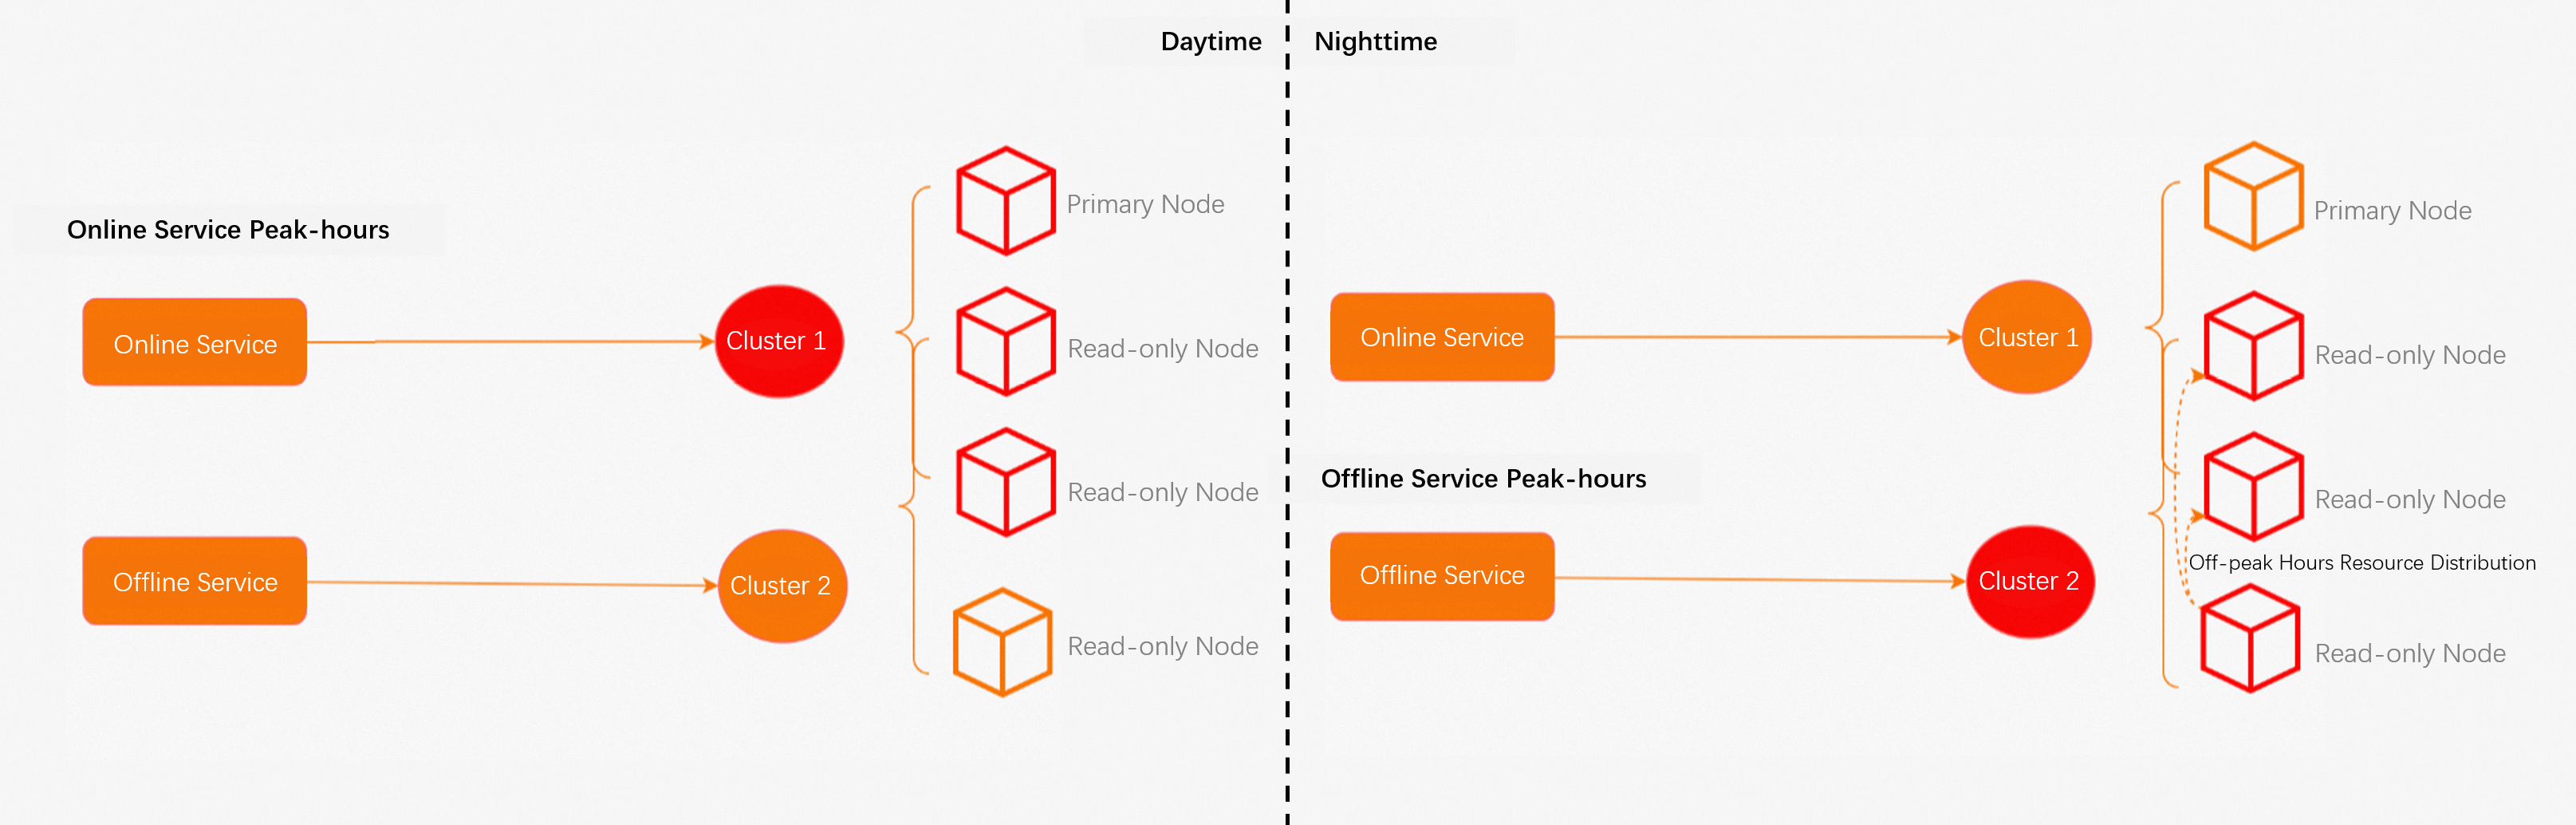
El método de aislamiento más eficaz consiste en dirigir el servicio transaccional en línea y el servicio analítico fuera de línea a distintos conjuntos de nodos. Sin embargo, esto incrementa los costos. En la mayoría de los casos, ambos servicios tienen horas pico diferentes. Una alternativa más económica es compartir los recursos del clúster entre el servicio transaccional en línea y el servicio analítico fuera de línea, y enrutar cada uno a distintos endpoints del clúster. Una vez habilitada la función ePQ, los recursos inactivos se asignan al servicio analítico fuera de línea durante las horas de menor demanda del servicio transaccional en línea, lo que reduce costos y mejora la eficiencia.
Notas de uso
Para obtener información sobre cómo usar la función ePQ, consulte Get started.
Métricas de rendimiento
A continuación se describe una prueba que utiliza 100 GB de datos generados con TPC Benchmark H (TPC-H) para evaluar el rendimiento de un clúster de PolarDB for MySQL 8.0. Durante la prueba, el clúster de PolarDB cuenta con cuatro nodos de 32 núcleos de CPU y 256 GB de memoria (Dedicated). Para la consulta paralela elástica de nodo único, el parámetro max_parallel_degree se establece en 32 y en 0. Compare los datos de rendimiento entre la consulta secuencial, la consulta paralela elástica de nodo único con un DOP de 32 y la consulta paralela elástica de cuatro nodos con un DOP de 128. Para obtener más información, consulte Parallel query performance.
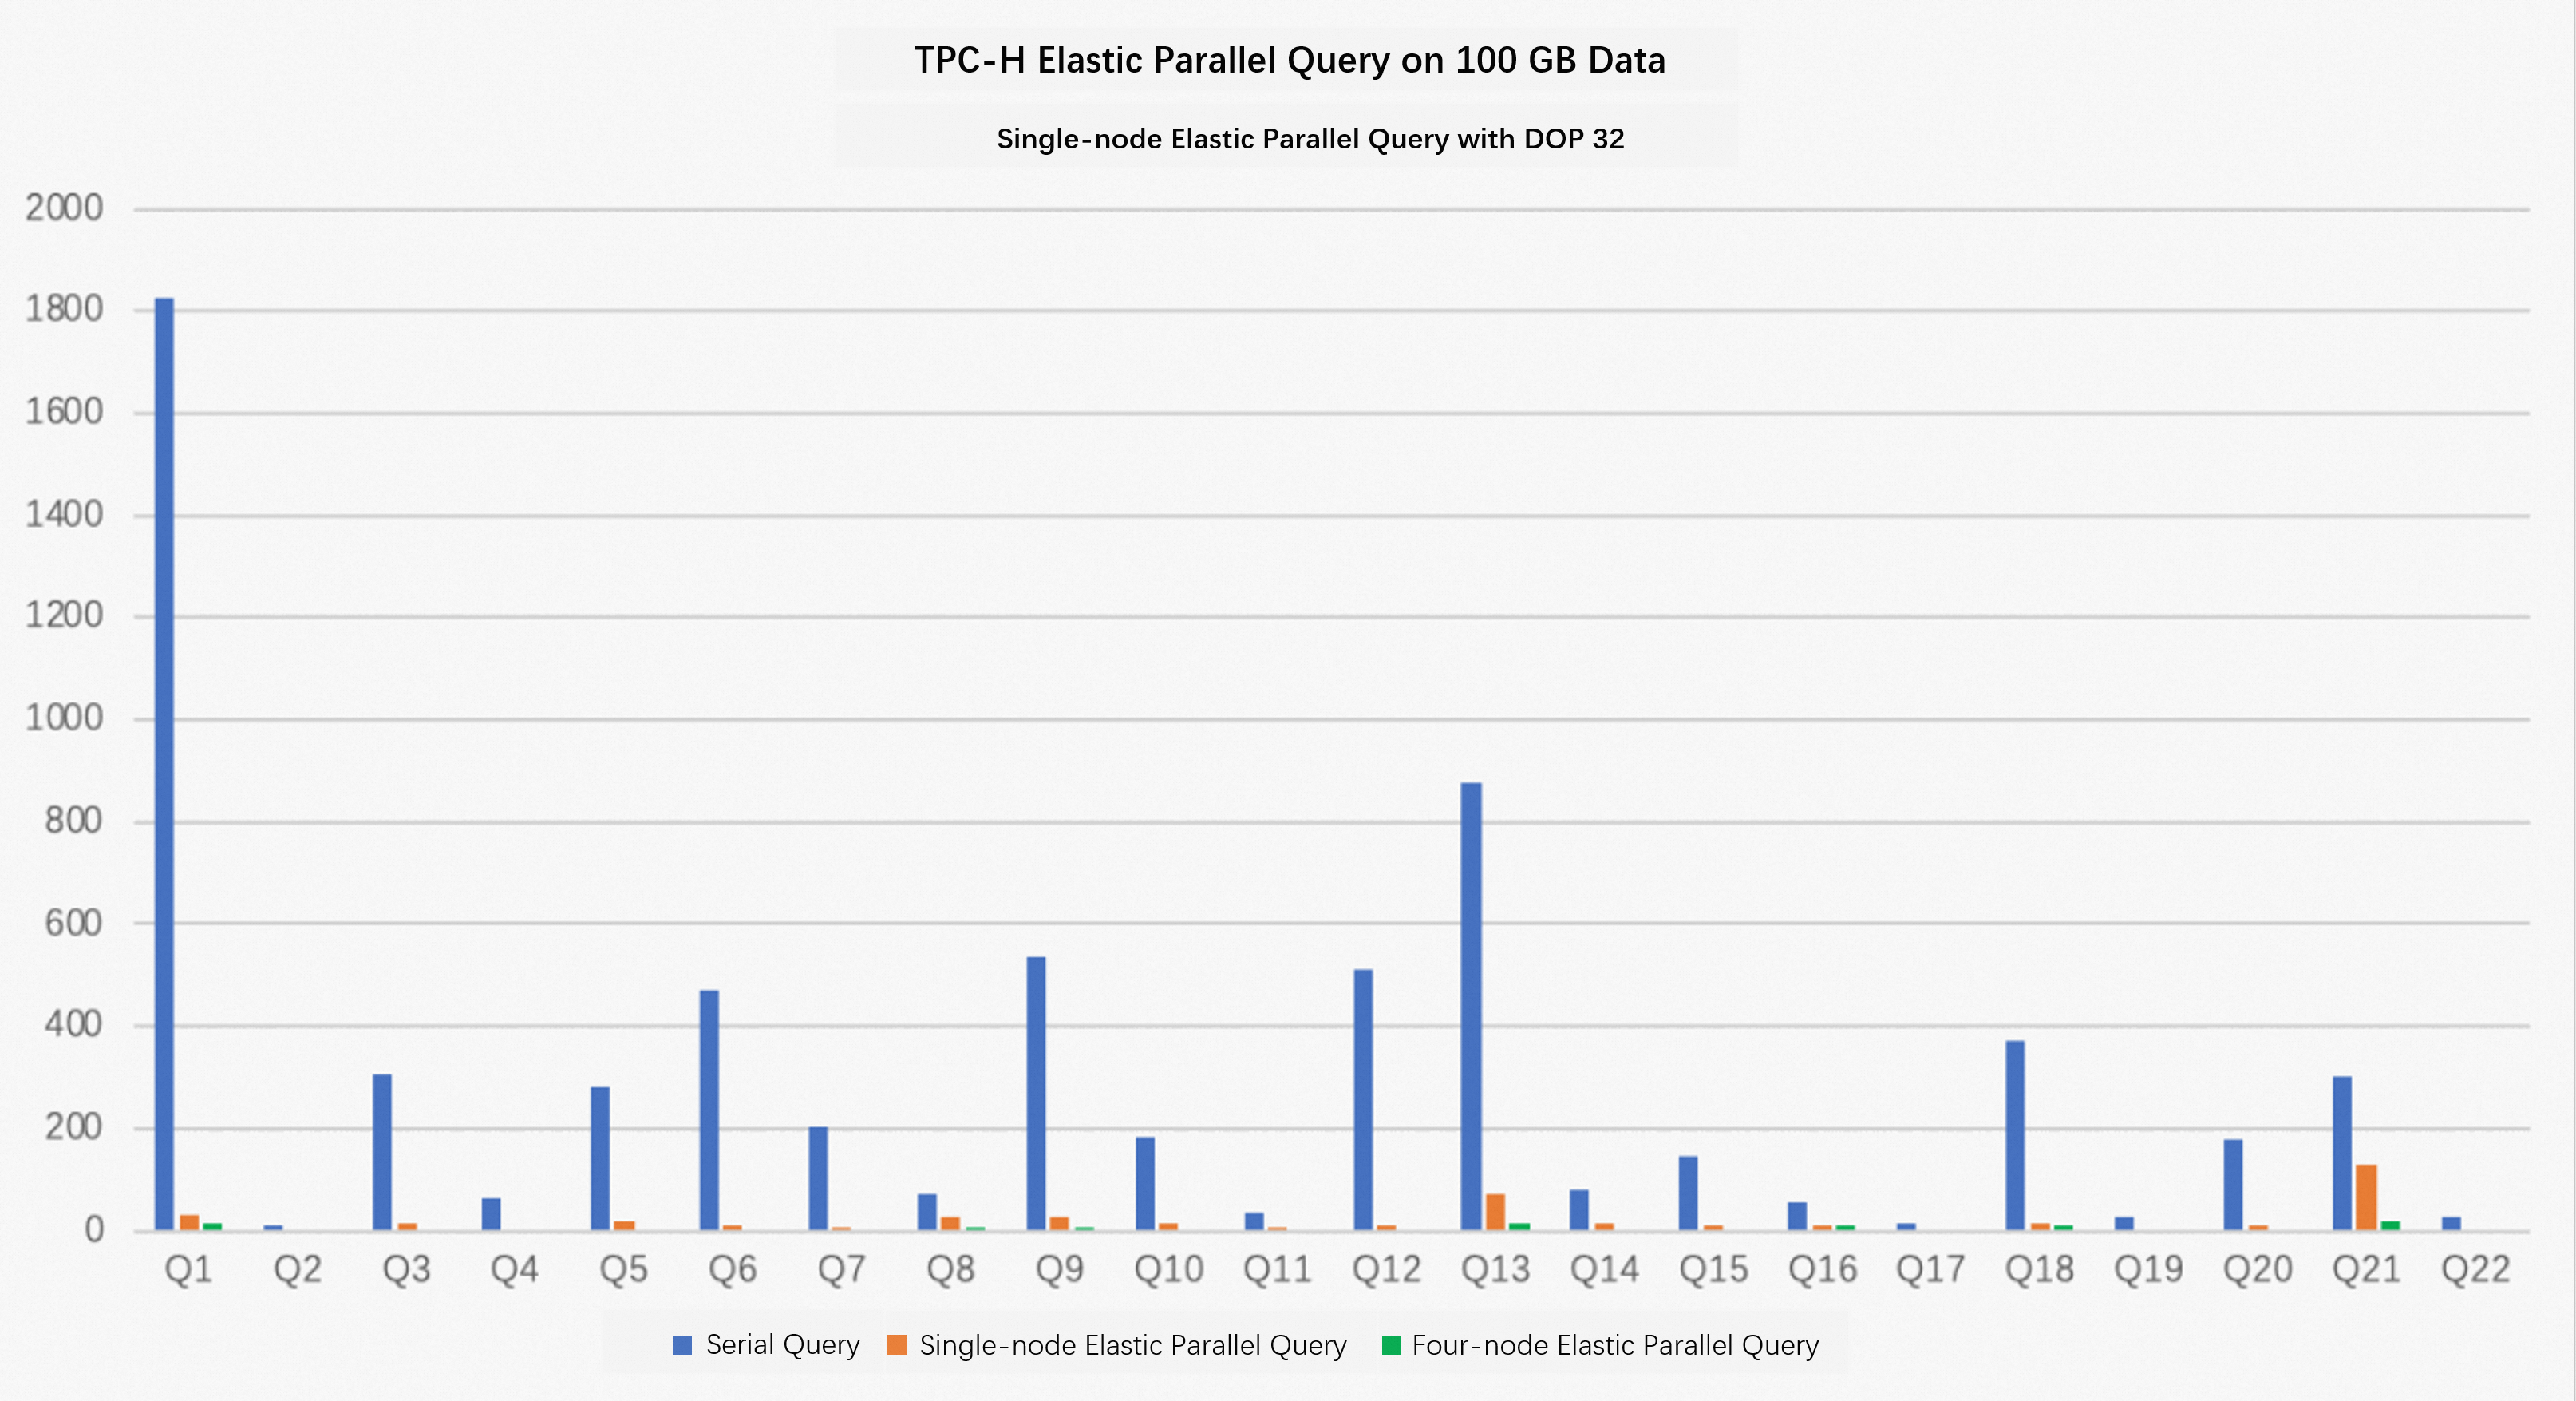
Los resultados anteriores muestran que el 100 % de las consultas SQL en TPC-H se aceleraron. La velocidad de consulta aumentó 17 veces en promedio y hasta 56 veces como máximo.
When multi-node elastic parallel query is enabled, the query speed is 59 times faster on average and 159 times faster at maximum.
La implementación de TPC-H en este tema se basa en las pruebas de referencia de TPC-H. Estos resultados no se pueden comparar con los resultados oficiales publicados de TPC-H, ya que las pruebas no cumplen por completo con todos los requisitos de dicho estándar.
Consulte los planes de ejecución de la consulta paralela elástica
Para obtener información sobre cómo ejecutar la instrucción EXPLAIN y consultar la información de la consulta paralela elástica en los planes de ejecución, consulte Use EXPLAIN to view parallel query plans.
Términos
-
Escaneo paralelo
En un escaneo paralelo, los workers leen los datos de una tabla simultáneamente. Cada worker genera un resultado parcial y lo devuelve al hilo líder. Este último recopila los resultados mediante el nodo gather y envía el resultado final al cliente.
-
Uniones paralelas en varias tablas
Si la función ePQ está habilitada, la operación de unión multitabla se delega a los workers para su procesamiento en paralelo. El optimizador de PolarDB selecciona la tabla óptima para el escaneo paralelo, pero no aplica este escaneo a las demás tablas. Cada worker genera un resultado parcial y lo devuelve al hilo líder. Luego, el hilo líder recopila los resultados mediante el nodo gather y devuelve el resultado final al cliente.
-
Ordenamiento paralelo
El optimizador de PolarDB delega la operación ORDER BY a todos los workers para realizar un ordenamiento paralelo. Cada worker genera un resultado parcial y lo devuelve al hilo líder. Este recopila, combina y ordena todos los resultados parciales mediante el nodo gather merge, y devuelve el resultado final ordenado al cliente.
-
Agrupación paralela
El optimizador de PolarDB delega la operación GROUP BY a los workers para su procesamiento en paralelo. Cada worker ejecuta la operación GROUP BY sobre una parte de los datos, genera un resultado parcial y lo devuelve al hilo líder. El hilo líder recopila los resultados de todos los workers mediante el nodo gather. Posteriormente, el optimizador de PolarDB determina si debe volver a ejecutar la operación GROUP BY en el hilo líder según el plan de consulta. Por ejemplo, si se usa un escaneo de índice disperso (loose index scan) para ejecutar una instrucción GROUP BY, el hilo líder no repite la operación. Si no se utiliza este tipo de escaneo, el hilo líder ejecuta la operación GROUP BY y devuelve el resultado final al cliente.
-
Agregación paralela
Si la función ePQ está habilitada, la función de agregación se envía a todos los workers para realizar una agregación paralela. El optimizador decide si aplica una ejecución secuencial, una agregación de una fase o una agregación de dos fases según el costo.
Agregación de una fase: el optimizador distribuye la operación de agregación entre los workers. Cada worker contiene todos los datos de los grupos, por lo que no se requiere una segunda fase de cómputo. Así, cada worker calcula directamente los resultados finales de agregación de sus grupos y evita que el hilo líder ejecute una segunda agregación.
Agregación de dos fases: en la primera fase, cada worker involucrado en la consulta paralela elástica ejecuta la agregación. En la segunda fase, el nodo gather o gather merge devuelve los resultados generados por cada worker al hilo líder. Después, el hilo líder agrega los resultados de todos los workers para generar el resultado final.
Agregación shuffle de dos fases: en la primera fase, cada worker de la consulta paralela elástica ejecuta la agregación. En la segunda fase, el nodo repartition distribuye el resultado de cada worker a varios workers según las columnas agrupadas. Los workers completan el cómputo de agregación final en paralelo. Por último, los resultados de agregación se consolidan en el hilo líder.
El optimizador de PolarDB determina el método de agregación específico con base en el costo.
-
Función de ventana paralela
El optimizador de PolarDB realiza el cómputo y distribuye las funciones de ventana entre los workers para su ejecución en paralelo según los costos. Cada worker procesa una parte de los datos. El método de distribución depende de la clave de la cláusula PARTITION BY en las funciones de ventana. Si estas no incluyen dicha cláusula, el cómputo se ejecuta de forma secuencial. Cuando el procesamiento paralelo es viable en una etapa posterior, las tareas subsiguientes se distribuyen entre varios workers según el costo para maximizar el paralelismo.
-
Compatibilidad con subconsultas
En una consulta paralela elástica, puede utilizar una de a continuación directivas para ejecutar subconsultas:
-
Ejecución secuencial en el hilo líder
Si las subconsultas no admiten procesamiento en paralelo, se ejecutan de forma secuencial dentro del hilo líder. Por ejemplo, esto ocurre cuando dos tablas se unen mediante una cláusula JOIN que hace referencia a funciones definidas por el usuario (UDF).
-
Ejecución paralela en el hilo líder (se utiliza otro grupo de workers)
Una vez generado el plan de consulta paralela elástica, si el plan de ejecución del hilo líder incluye subconsultas compatibles con el procesamiento paralelo, estas no se pueden ejecutar por adelantado ni en paralelo bajo la directiva de acceso compartido. Por ejemplo, si las subconsultas contienen funciones de ventana, no se ejecutan en paralelo mediante el acceso compartido.
-
Acceso compartido
Después de generar el plan de consulta paralela elástica, si los planes de ejecución de los workers hacen referencia a subconsultas que admiten procesamiento en paralelo, el optimizador de PolarDB ejecuta dichas subconsultas por adelantado. De esta manera, los workers acceden directamente a los resultados de las subconsultas.
-
Delegación
Una vez generado el plan de consulta paralela elástica, si los planes de ejecución de los workers hacen referencia a subconsultas correlacionadas, los propios workers ejecutan dichas subconsultas.
-