Conozca cómo habilitar, configurar y controlar ePQ para PolarDB for MySQL. Esta guía incluye los umbrales de ejecución paralela, la sintaxis de hint y los límites conocidos.
Antes de empezar
-
Confirme que su clúster sea compatible con la consulta paralela elástica.
-
Consulta paralela elástica de un solo nodo:
Motor de base de datos: 8.0.1 con una versión de revisión 8.0.1.0.5 o posterior.
Edición de la base de datos: Enterprise Edition .
-
Consulta paralela elástica de un solo nodo:
Motor de base de datos: 8.0.2 con una versión de revisión 8.0.2.1.4.1 o posterior.
Edición de la base de datos: Enterprise Edition.
-
Consulta paralela elástica multinodo:
Motor de base de datos: 8.0.2 con una versión de revisión 8.0.2.2.6 o posterior.
Edición de la base de datos: Enterprise Edition.
-
Revise Limits and compatibility issues antes de habilitar la consulta paralela.
Los nodos de solo lectura y los nodos RW admiten la consulta paralela. Sin embargo, esta función está deshabilitada de forma predeterminada en los nodos RW. Para habilitarla en dichos nodos, Adaptively adjust the degree of parallelism.
Habilitar o deshabilitar la consulta paralela
Habilitar
Vaya a . En la página Basic Information del clúster, busque la sección Database Connection. Seleccione el endpoint de destino y haga clic en Configure. En el cuadro de diálogo Edit Endpoint Configuration, enable la consulta paralela y configure el Degree of Parallelism.
Inicie sesión en la consola de PolarDB. En el panel de navegación izquierdo, haga clic en Clusters. Seleccione la región donde se encuentra el clúster y luego haga clic en el ID del clúster para ir a la página de detalles.
En la página Basic Information del clúster, busque la sección Database Connection. Seleccione el endpoint de destino y haga clic en Configure.
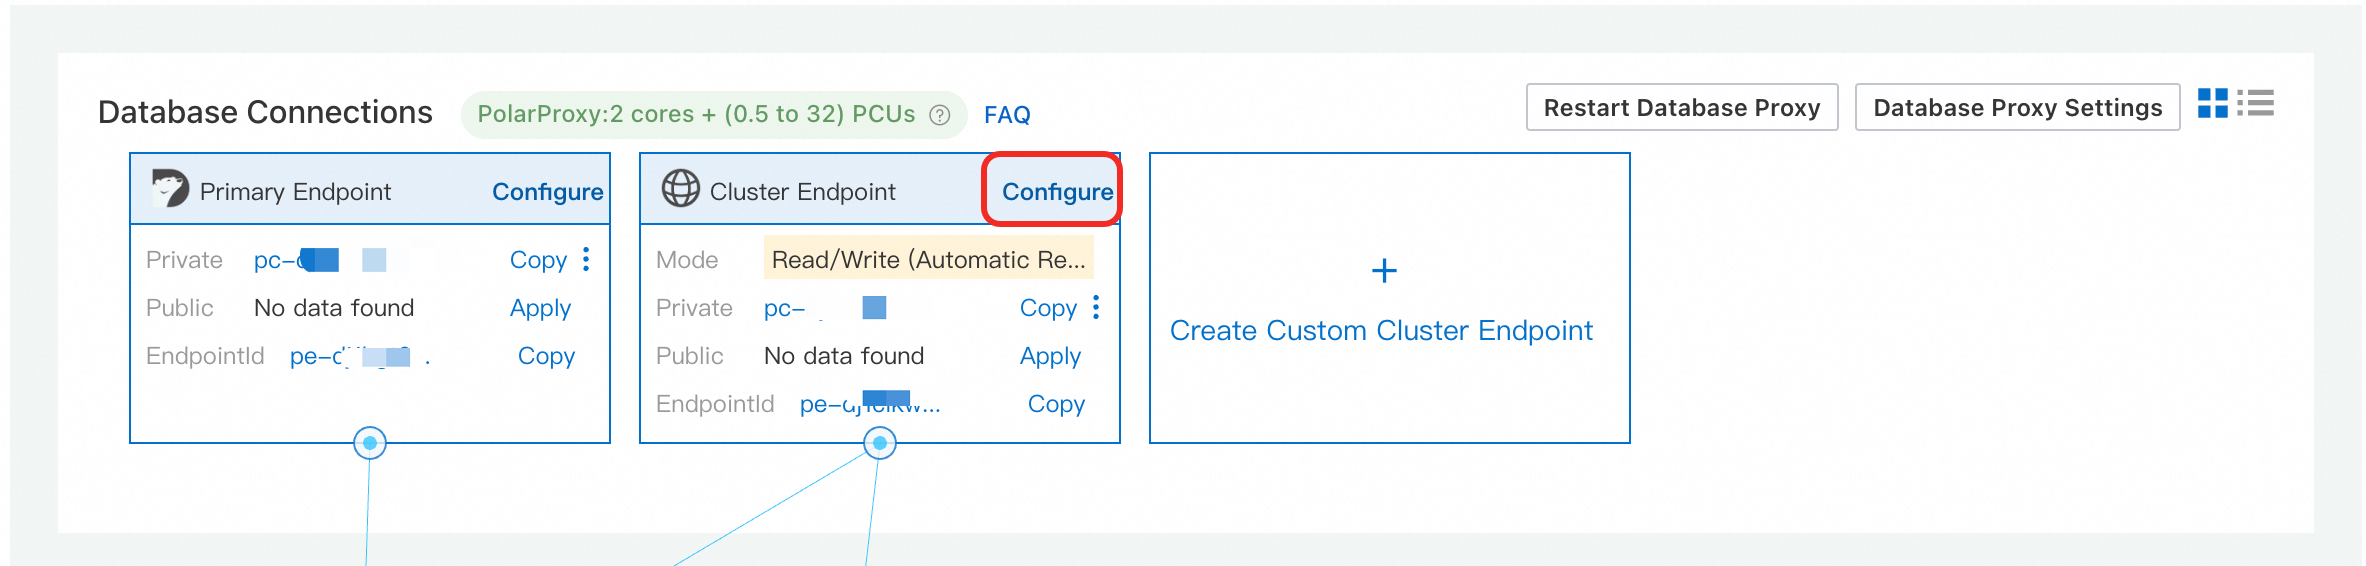
En el cuadro de diálogo Edit Endpoint Configuration, enable la consulta paralela y configure el Degree of Parallelism. Los demás parámetros del endpoint se documentan en Configure a database proxy.
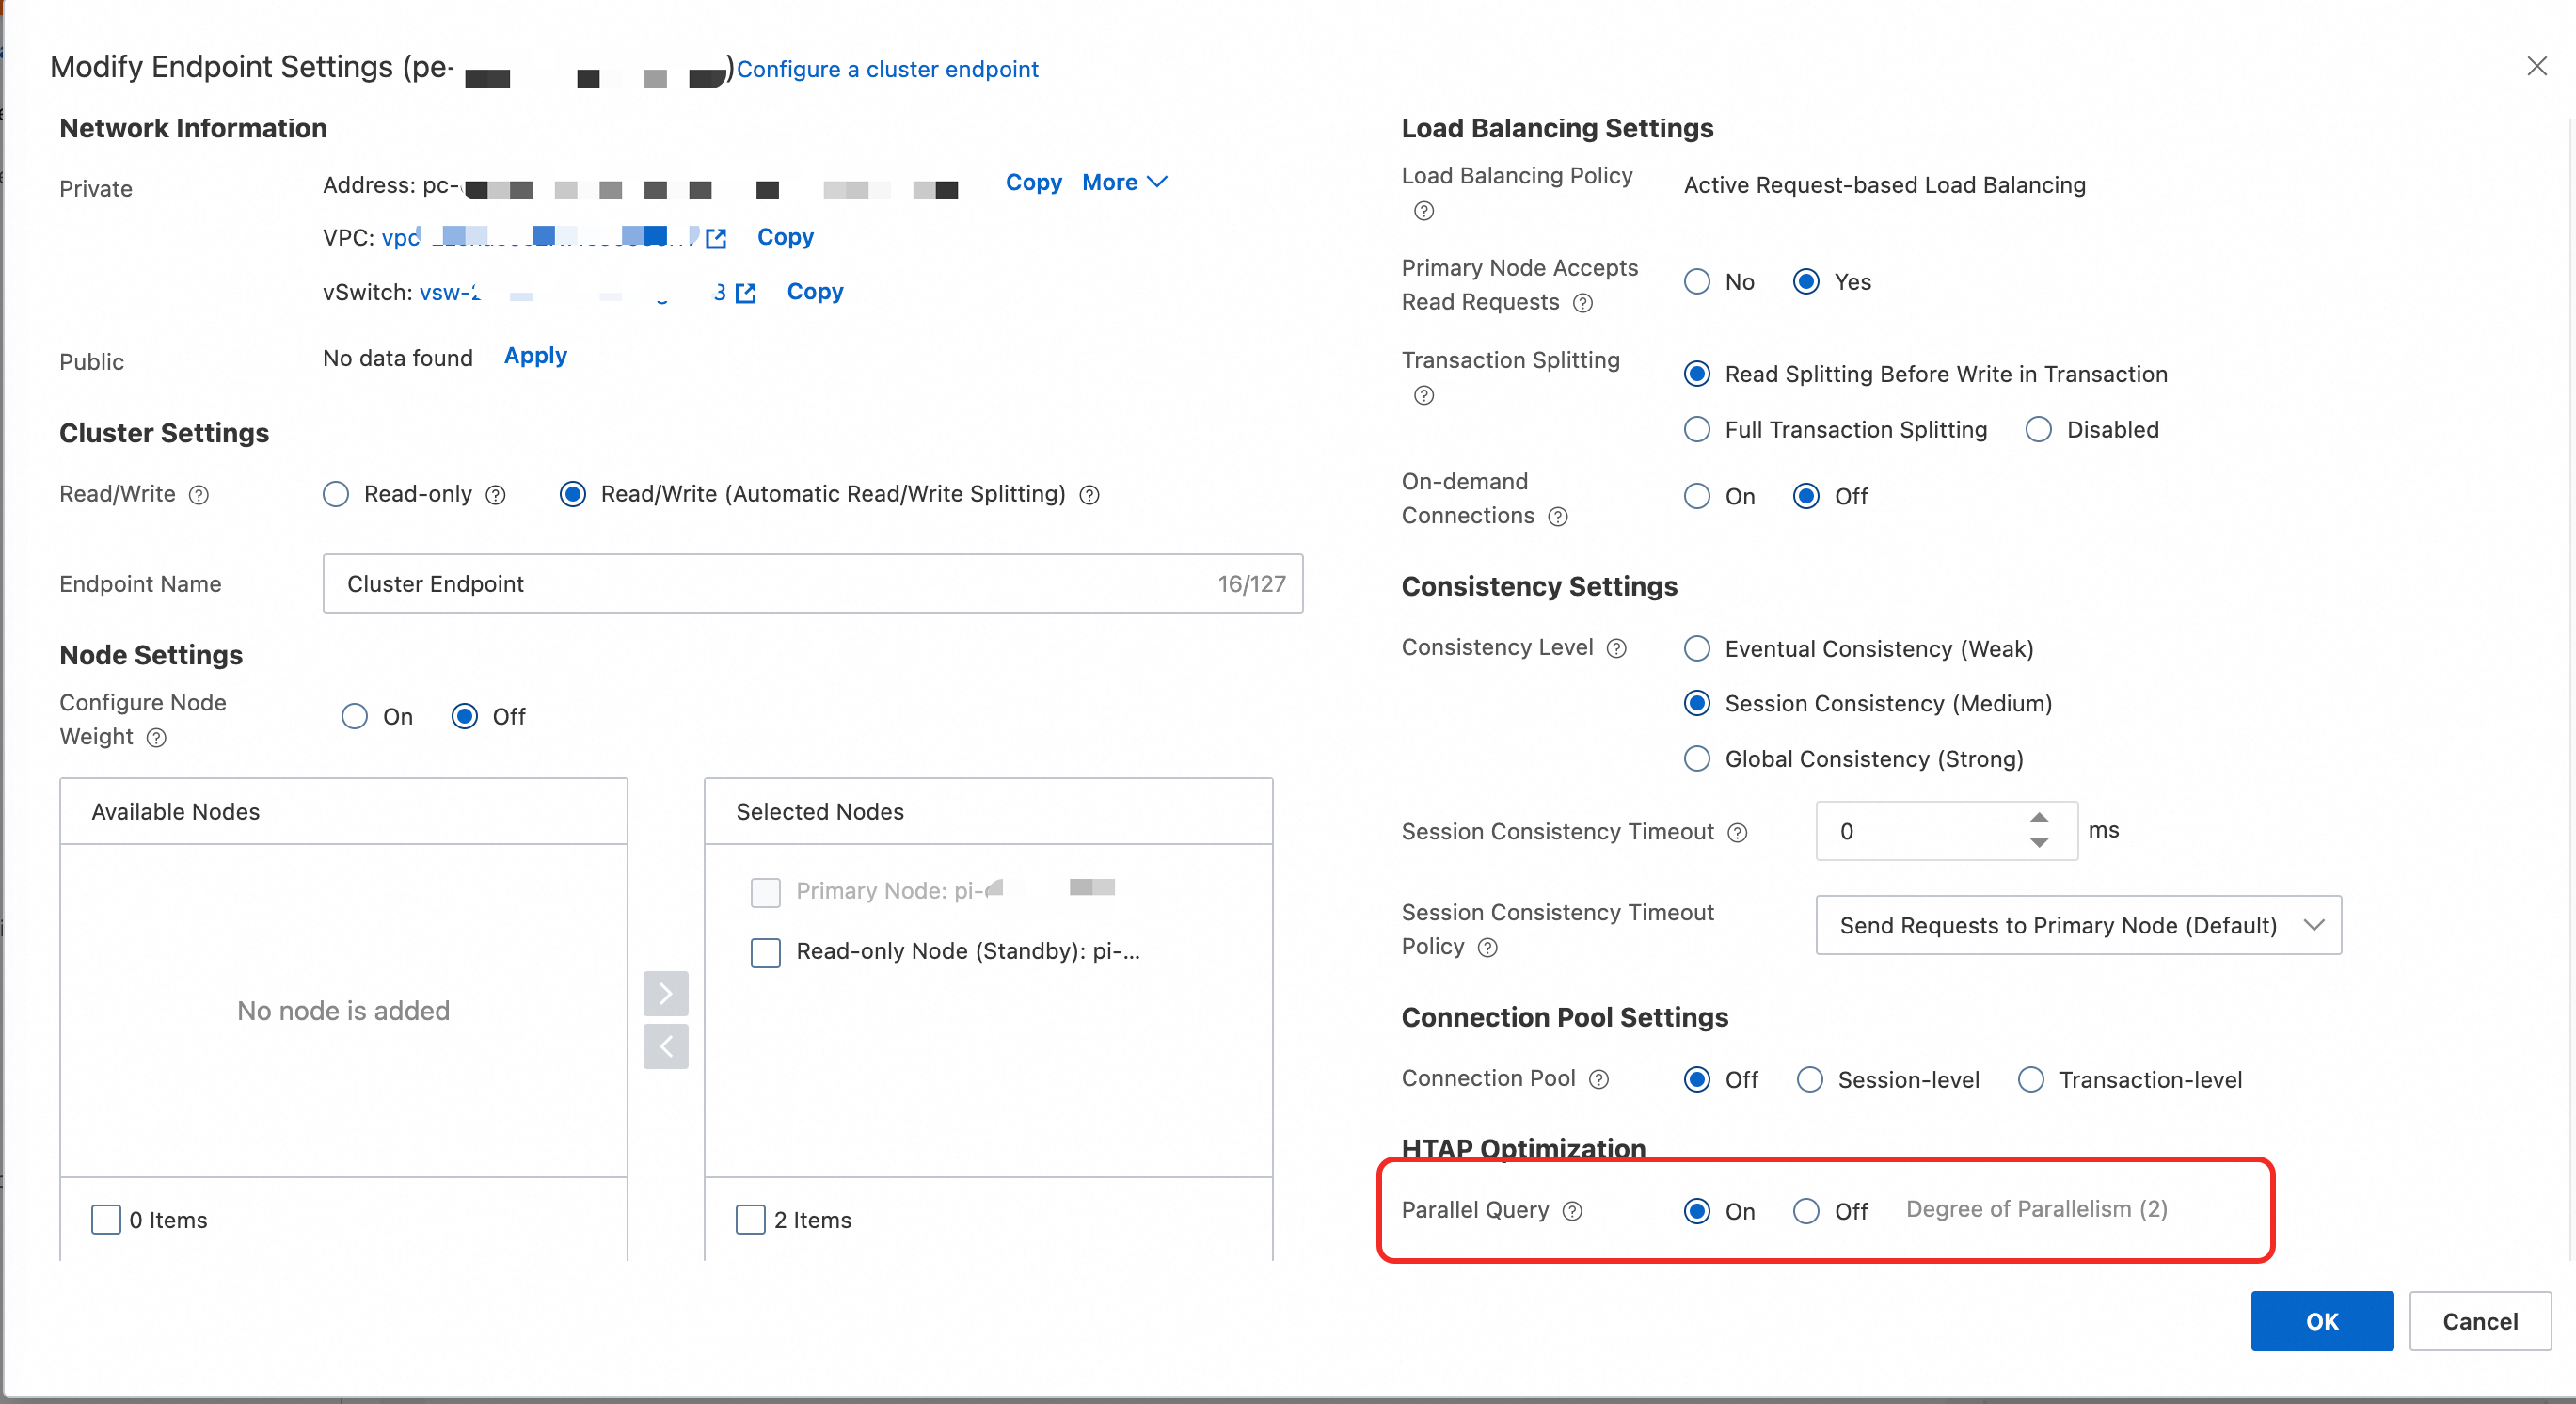
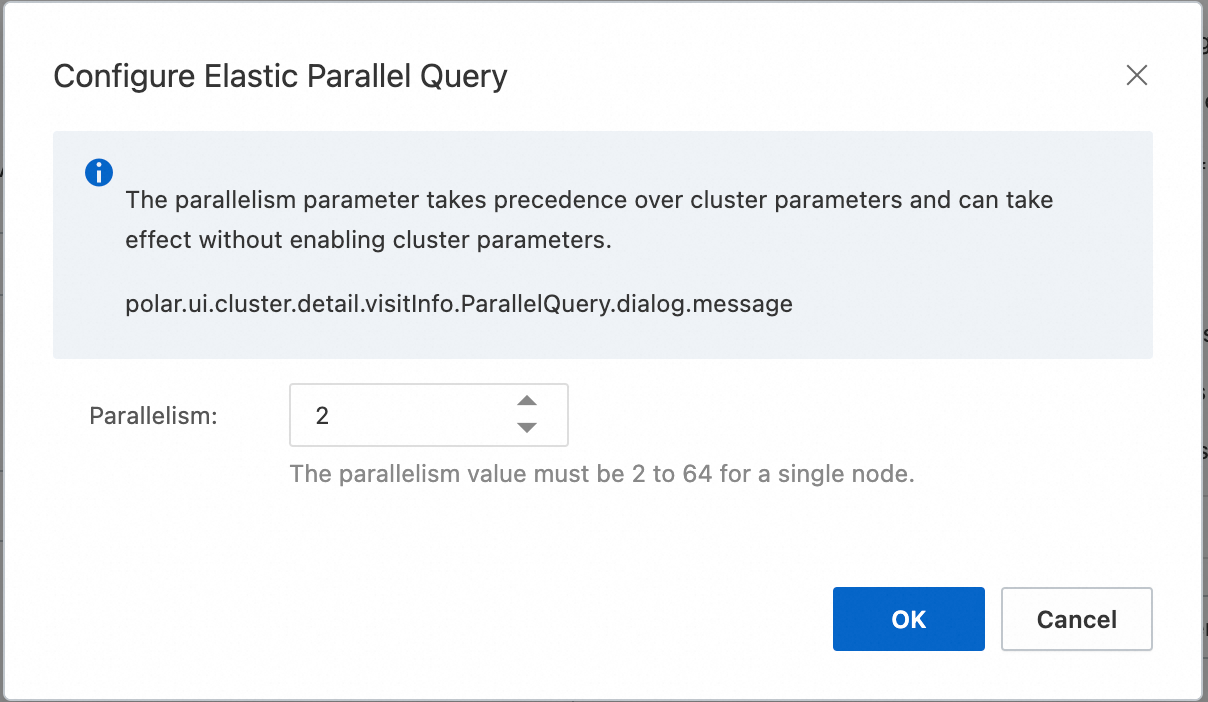
Configuraciones recomendadas y notas:
El Degree of Parallelism indica el número máximo de subprocesos de trabajo que una sola consulta puede usar en un nodo de cómputo. El total de subprocesos por consulta equivale al Degree of Parallelism multiplicado por el número de nodos.
Aumente el grado de paralelismo de manera gradual. No supere la cuarta parte de la cantidad de núcleos de CPU. Comience con 2. Después de un día, incremente el valor si la carga de la CPU se mantiene baja; deténgase si aumenta.
La habilitación de la consulta paralela solo surte efecto en las conexiones nuevas.
-
La configuración de la consola y los parámetros del clúster interactúan de la siguiente manera:
El parámetro
loose_max_parallel_degreeaplica a todos los nodos y conexiones del clúster. Por su parte, los ajustes de la consola solo aplican al endpoint configurado.Si se configuran tanto el ajuste de la consola como
loose_max_parallel_degree, el ajuste de la consola tiene prioridad. Use la consola para habilitar la parallel query.Si la parallel query no está habilitada en la consola, pero
loose_max_parallel_degreees mayor que 0, la consulta paralela de un solo nodo se habilita de forma predeterminada.
NotaEl parámetro
loose_max_parallel_degreeestablece el número máximo de subprocesos de trabajo para la ejecución paralela de una sola consulta. Parameter description.
Deshabilitar
Vaya a . En la página Basic Information del clúster, busque la sección Database Connection. Seleccione el endpoint de destino y haga clic en Configure. En el cuadro de diálogo Edit Endpoint Configuration, disable la consulta paralela.
Inicie sesión en la consola de PolarDB. En el panel de navegación izquierdo, haga clic en Clusters. Seleccione la región donde se encuentra el clúster y luego haga clic en el ID del clúster para ir a la página de detalles.
En la página Basic Information del clúster, busque la sección Database Connection. Seleccione el endpoint de destino y haga clic en Configure.
En el cuadro de diálogo Edit Endpoint Configuration, disable la consulta paralela.
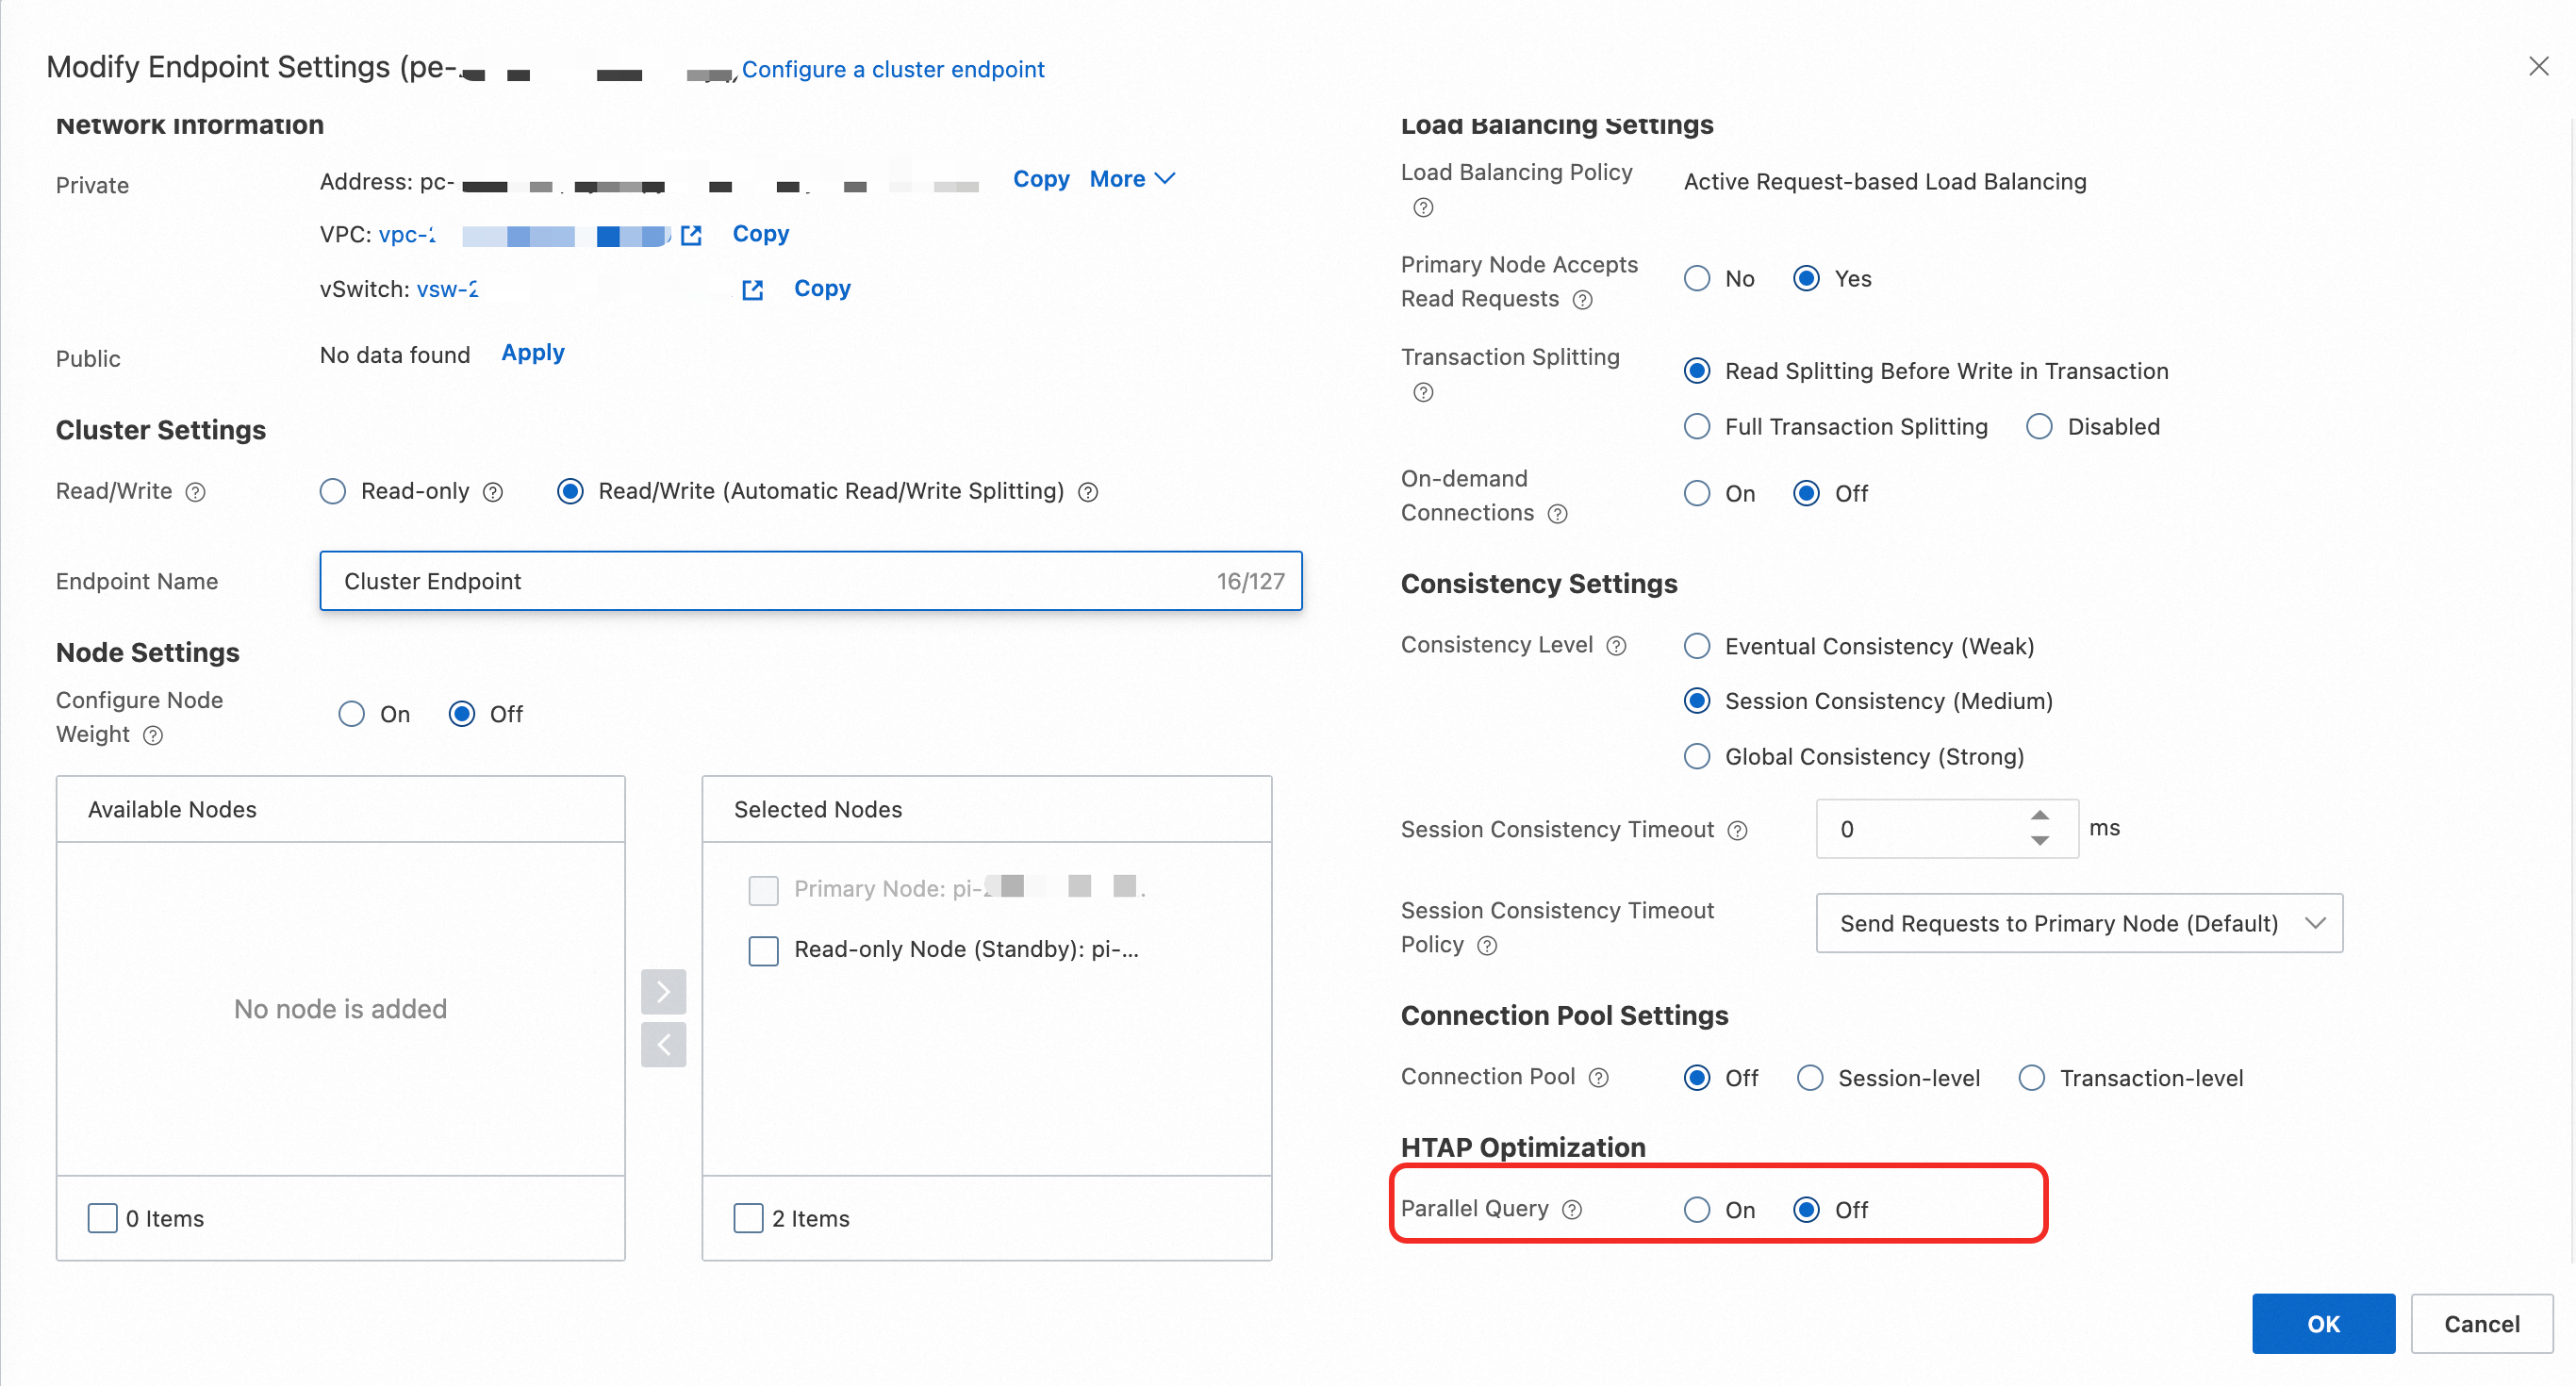
Nota:
Deshabilitar la consulta paralela solo surte efecto en las conexiones nuevas.
-
Después de deshabilitar la consulta paralela en la consola, compruebe que
loose_max_parallel_degreetambién esté establecido en 0.NotaEl parámetro
loose_max_parallel_degreeestablece el número máximo de subprocesos de trabajo para la ejecución paralela de una sola consulta. Parameter description.
Configurar la consulta paralela
PolarDB ofrece varias políticas de control para la consulta paralela, las cuales se resumen a continuación. La lista completa está disponible en Configure parallel resource control policies.
|
Tipo |
Descripción |
|
Umbrales de ejecución paralela del optimizador |
PolarDB proporciona dos umbrales. El optimizador considera un plan paralelo cuando una consulta supera cualquiera de ellos.
|
|
Umbrales de escalado paralelo multinodo |
PolarDB proporciona dos umbrales para el escalado paralelo multinodo. El sistema escala horizontalmente cuando se supera cualquiera de ellos.
|
Controlar la consulta paralela con hints
Los hints controlan la ejecución paralela a nivel de instrucción. Esto le permite anular el comportamiento predeterminado, establecer el grado de paralelismo y especificar qué tablas se van a paralelizar. Por ejemplo, use un hint para acelerar una consulta lenta específica. La sintaxis completa se documenta en Parallel query hint syntax.
Límites y problemas de compatibilidad
Límites
La ejecución paralela de PolarDB presenta las siguientes limitaciones:
Las consultas en tablas que no son
InnoDBno se pueden ejecutar en paralelo.Las consultas que usan un índice de texto completo no se pueden ejecutar en paralelo.
Las expresiones que contienen
Proceduresalmacenados deben ejecutarse en el nodo líder.Si una tabla se explora mediante
Index Merge, la exploración de la tabla no se puede paralelizar.Las instrucciones de consulta dentro de transacciones con nivel de aislamiento serializable no se pueden ejecutar en paralelo.
Si el nivel de aislamiento es
Repeatable-read, la parte de consulta de las instruccionesINSERT ... SELECT/REPLACE ... SELECTdentro de una transacción no se puede ejecutar en paralelo.
Compatibilidad
-
La cantidad de mensajes de error podría cambiar
Si una consulta devuelve un error durante la ejecución secuencial, la cantidad total de mensajes de error podría diferir durante la ejecución paralela.
-
Problemas de precisión
La ejecución paralela podría almacenar más resultados intermedios de punto flotante. Esto puede causar diferencias menores de precisión en el resultado final.
-
**El paquete de red o el resultado intermedio supera
max_allowed_packet**La ejecución paralela podría generar resultados intermedios más grandes. Si la longitud de un paquete de red o de un resultado intermedio supera
max_allowed_packet, podría producirse un error. Aumente el parámetromax_allowed_packetpara resolverlo. Set cluster parameters and node parameters. -
Diferencias en el orden del conjunto de resultados
Una instrucción
SELECT ... LIMIT nsin la cláusulaORDER BYpodría devolver filas en un orden distinto durante la ejecución paralela. Esto ocurre porque varios trabajadores finalizan a velocidades diferentes. -
El recuento de bloqueos de fila podría aumentar
Durante la ejecución paralela de
SELECT ... FROM ... FOR SHARE, InnoDB bloquea cada fila a la que se accede. Por ello, el recuento de bloqueos de fila podría ser mayor que en la ejecución secuencial.