La evaluación de la importancia de características en Random Forest es un método para analizar la contribución de cada característica a los resultados de predicción en un modelo de random forest. Este proceso determina la importancia de las características al calcular la disminución media de impureza para cada característica en todos los árboles de decisión, o bien mediante la importancia por permutación. De esta forma, se identifican las características con mayor impacto en el rendimiento del modelo.
Configuración del componente
Método 1: Interfaz gráfica
En Machine Learning Designer, agregue el componente Random Forest Feature Importance Evaluation a su pipeline y configure sus parámetros en el panel derecho:
|
Pestaña |
Parámetro |
Descripción |
|
Field Settings |
Feature Columns |
Columnas de características que se usarán de la tabla de entrada. Este parámetro es opcional. De forma predeterminada, se seleccionan todas las columnas excepto la de etiqueta. |
|
Target Column |
Obligatorio. |
|
|
Parameter Settings |
Parallel Computing Cores |
Número de núcleos para procesamiento paralelo. |
|
Memory Size per Core |
Tamaño de memoria por núcleo, en MB. |
Método 2: Comando PAI
Configure el componente Random Forest Feature Importance Evaluation al ejecutar un comando PAI en el componente SQL Script. Para obtener más información, consulte Scenario 4: Execute PAI commands in the SQL Script component.
pai -name feature_importance -project algo_public
    -DinputTableName=pai_dense_10_10
    -DmodelName=xlab_m_random_forests_1_20318_v0
    -DoutputTableName=erkang_test_dev.pai_temp_2252_20319_1
    -DlabelColName=y
    -DfeatureColNames="pdays,previous,emp_var_rate,cons_price_idx,cons_conf_idx,euribor3m,nr_employed,age,campaign,poutcome"
-Dlifecycle=28 ;|
Parámetro |
Obligatorio |
Predeterminado |
Descripción |
|
inputTableName |
Sí |
Ninguna |
Nombre de la tabla de entrada. |
|
outputTableName |
Sí |
Ninguna |
Nombre de la tabla de salida. |
|
labelColName |
Sí |
Ninguna |
Nombre de la columna de etiqueta en la tabla de entrada. |
|
modelName |
Sí |
Ninguna |
Nombre del modelo de entrada. |
|
featureColNames |
No |
Todas las columnas excepto la columna de etiqueta |
Columnas de características que se usarán de la tabla de entrada. |
|
inputTablePartitions |
No |
Toda la tabla |
Particiones que se usarán de la tabla de entrada. |
|
lifecycle |
No |
No especificado |
Ciclo de vida de la tabla de salida. |
|
coreNum |
No |
Calculado automáticamente |
Número de núcleos. |
|
memSizePerCore |
No |
Calculado automáticamente |
Tamaño de memoria por núcleo, en MB. |
Ejemplo
-
Use una sentencia SQL para generar los datos de entrenamiento.
Este ejemplo crea una tabla llamada
pai_dense_10_10al seleccionar columnas específicas y las primeras 10 filas de la tablabank_data. Cree una tabla según sus necesidades comerciales reales.drop table if exists pai_dense_10_10; create table pai_dense_10_10 as select age,campaign,pdays, previous, poutcome, emp_var_rate, cons_price_idx, cons_conf_idx, euribor3m, nr_employed, y from bank_data limit 10; -
Construya el pipeline. Para obtener más información, consulte Custom pipelines.
Establezca
ycomo columna de etiqueta y las demás columnas como columnas de características. En el parámetro Columns Forced to Convert, seleccioneageycampaignpara procesarlas como características enumeradas. Use los valores predeterminados para el resto de los parámetros.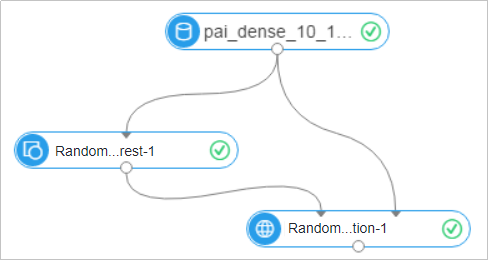
-
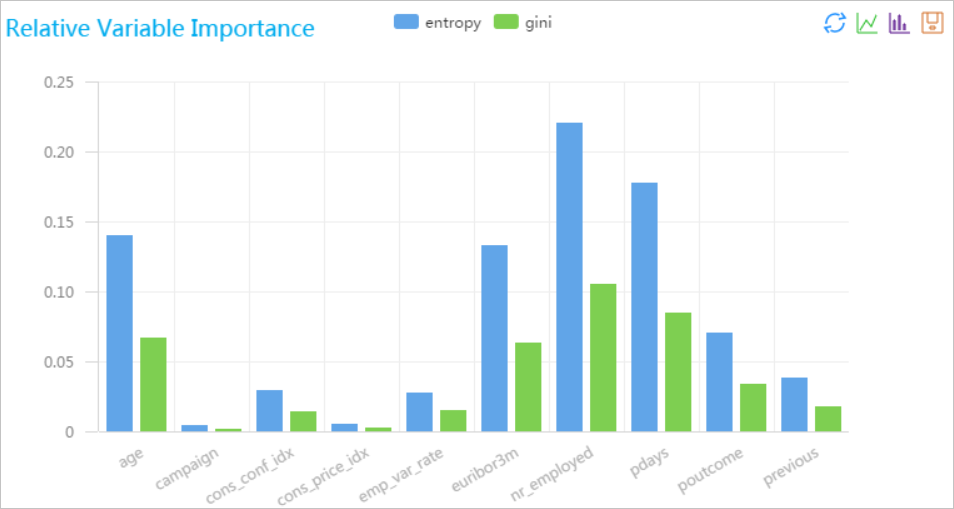
Ejecute el pipeline y consulte los resultados. La siguiente salida muestra los valores de importancia de características generados por el componente Random Forest Feature Importance Evaluation.
colname                gini                        entropy
age                    0.06625000000000003          0.13978726292803723
campaign               0.00175000000000003          0.00434851554559677
cons_conf_idx          0.01399999999999999          0.0290840949701885
cons_price_idx         0.002                        0.00498044991346125
emp_var_rate           0.01470000000000003          0.0267863068026093
euribor3m              0.06300000000000003          0.132193634884603
nr_employed            0.10499999999999998          0.220322724807673
pdays                  0.0845                       0.177503292343975
poutcome               0.03360000000000001          0.070503271938455
previous               0.01770000000000004          0.038103810058015
Una vez finalizada la ejecución, haga clic con el botón derecho en el componente Random Forest Feature Importance Evaluation y seleccione View Analytics Report.