PS-SMART combina Parameter Server (PS) con Scalable Multiple Additive Regression Tree (SMART) para entrenar modelos de regresión en conjuntos de datos con miles de millones de muestras y cientos de miles de funciones.
Limitaciones
Los datos de entrada deben cumplir los siguientes requisitos:
La columna objetivo debe ser numérica. Convierta los tipos STRING en las tablas de MaxCompute antes del entrenamiento.
Para datos en formato clave-valor, los ID de función deben ser enteros positivos y los valores de función deben ser números reales. Utilice un componente de serialización para los ID de función STRING o realice ingeniería de funciones (discretización) para cadenas categóricas.
Los conjuntos de datos con cientos de miles de funciones consumen recursos significativos y se ejecutan lentamente. Considere usar algoritmos GBDT en su lugar, ya que funcionan directamente con funciones continuas. Aplique codificación one-hot a las funciones categóricas para filtrar las de baja frecuencia, pero evite discretizar las funciones continuas.
El algoritmo introduce aleatoriedad mediante el muestreo de datos (data_sample_ratio), el muestreo de funciones (fea_sample_ratio), la aproximación de histogramas y la fusión de bocetos. Las estructuras de árbol pueden diferir entre los trabajadores distribuidos, pero el rendimiento del modelo permanece similar. Los resultados pueden variar entre ejecuciones incluso con datos y parámetros idénticos.
Aumente el número de núcleos de cómputo para acelerar el entrenamiento. Este comienza solo después de asignar todos los recursos, por lo que solicitar más recursos incrementa el tiempo de espera cuando el clúster está ocupado.
Configuración
Interfaz visual
Agregue el componente PS-SMART Regression al lienzo de Designer y configure los parámetros en el panel derecho.
|
Tipo de parámetro |
Parámetro |
Descripción |
|
Configuración de campos |
Es formato disperso |
Separa los pares clave-valor en formato disperso con espacios. Separa las claves y los valores con dos puntos (:). Ejemplo: 1:0.3 3:0.9. |
|
Seleccionar columnas de funciones |
Columnas de funciones de la tabla de entrada para el entrenamiento. Para formato denso, seleccione solo columnas BIGINT o DOUBLE. Para formato disperso clave-valor con claves y valores numéricos, seleccione solo columnas STRING. |
|
|
Seleccionar columna de etiqueta |
Columna de etiqueta de la tabla de entrada. Admite tipos STRING y numéricos. Internamente se convierte solo a tipos numéricos, como 0 y 1 para clasificación binaria. |
|
|
Seleccionar columna de ponderación |
Columna para ponderar cada fila de muestra. Admite solo tipos numéricos. |
|
|
Configuración de parámetros |
Tipo de función objetivo |
Tipos disponibles:
|
|
Índice de distribución Tweedie |
Disponible solo cuando el tipo de función objetivo es Tweedie regression. Especifica el índice de la relación entre la varianza y la media de la distribución Tweedie. |
|
|
Tipo de métrica de evaluación |
Tipos disponibles:
|
|
|
Número de árboles |
Número total de árboles por construir. Debe ser un entero positivo. El tiempo de entrenamiento aumenta proporcionalmente con este valor. |
|
|
Profundidad máxima del árbol |
Predeterminado: 5 (máximo 32 nodos hoja). |
|
|
Proporción de muestreo de datos |
Fracción de datos de entrenamiento muestreados para construir cada árbol. El muestreo acelera el entrenamiento al construir aprendices débiles sobre un subconjunto de datos. |
|
|
Proporción de muestreo de funciones |
Fracción de funciones muestreadas para construir cada árbol. El muestreo acelera el entrenamiento al construir aprendices débiles sobre un subconjunto de funciones. |
|
|
Coeficiente de penalización L1 |
Controla el tamaño de los nodos hoja. Valores mayores producen una distribución más uniforme. Auméntelo para reducir el sobreajuste. |
|
|
Coeficiente de penalización L2 |
Controla el tamaño de los nodos hoja. Valores mayores producen una distribución más uniforme. Auméntelo para reducir el sobreajuste. |
|
|
Tasa de aprendizaje |
Rango: (0.1). |
|
|
Precisión aproximada del boceto |
Umbral de cuantil para la división al construir un boceto. Valores menores producen más cubos. Utilice el valor predeterminado 0.03. |
|
|
Cambio mínimo de pérdida en división |
Cambio mínimo de pérdida requerido para dividir un nodo. Valores mayores producen divisiones más conservadoras. |
|
|
Número de funciones |
Número total de funciones o ID máximo de función. Si no se especifica, el sistema calcula este valor automáticamente mediante la ejecución de una tarea SQL. |
|
|
Sesgo global |
Valor de predicción inicial para todas las muestras. |
|
|
Semilla del generador de números aleatorios |
Semilla para el generador de números aleatorios. Debe ser un entero. |
|
|
Tipo de importancia de función |
Tipos disponibles:
|
|
|
Ajuste de ejecución |
Número de núcleos |
Asignado por el sistema de forma predeterminada. |
|
Memoria por núcleo (MB) |
Memoria por núcleo en MB. Asignada por el sistema de forma predeterminada. |
Comandos PAI
También puede configurar el componente PS-SMART Regression ejecutando comandos PAI desde el componente de script SQL. Para obtener más información, consulte SQL Script.
# Train the model.
PAI -name ps_smart
    -project algo_public
    -DinputTableName="smart_regression_input"
    -DmodelName="xlab_m_pai_ps_smart_bi_545859_v0"
    -DoutputTableName="pai_temp_24515_545859_2"
    -DoutputImportanceTableName="pai_temp_24515_545859_3"
    -DlabelColName="label"
    -DfeatureColNames="features"
    -DenableSparse="true"
    -Dobjective="reg:linear"
    -Dmetric="rmse"
    -DfeatureImportanceType="gain"
    -DtreeCount="5"
    -DmaxDepth="5"
    -Dshrinkage="0.3"
    -Dl2="1.0"
    -Dl1="0"
    -Dlifecycle="3"
    -DsketchEps="0.03"
    -DsampleRatio="1.0"
    -DfeatureRatio="1.0"
    -DbaseScore="0.5"
    -DminSplitLoss="0"
# Make predictions.
PAI -name prediction
    -project algo_public
    -DinputTableName="smart_regression_input";
    -DmodelName="xlab_m_pai_ps_smart_bi_545859_v0"
    -DoutputTableName="pai_temp_24515_545860_1"
    -DfeatureColNames="features"
    -DappendColNames="label,features"
    -DenableSparse="true"
-Dlifecycle="28"|
Tipo de parámetro |
Parámetro |
Obligatorio |
Predeterminado |
Descripción |
|
Parámetros de datos |
featureColNames |
Sí |
Ninguna |
Columnas de funciones de la tabla de entrada para el entrenamiento. Para formato denso, seleccione solo columnas BIGINT o DOUBLE. Para formato disperso clave-valor con claves y valores numéricos, seleccione solo columnas STRING. |
|
labelColName |
Sí |
Ninguna |
Columna de etiqueta de la tabla de entrada. Admite tipos STRING y numéricos. Internamente se convierte solo a tipos numéricos, como 0 y 1 para clasificación binaria. |
|
|
weightCol |
No |
Ninguna |
Columna para ponderar cada fila de muestra. Admite solo tipos numéricos. |
|
|
enableSparse |
No |
false |
Indica si los datos están en formato disperso. Valores válidos: {true,false}. Separa los pares clave-valor con espacios. Separa las claves y los valores con dos puntos (:). Ejemplo: 1:0.3 3:0.9. |
|
|
inputTableName |
Sí |
Ninguna |
Nombre de la tabla de entrada. |
|
|
modelName |
Sí |
Ninguna |
Nombre del modelo de salida. |
|
|
outputImportanceTableName |
No |
Ninguna |
Nombre de la tabla de salida que contiene la información de importancia de las funciones. |
|
|
inputTablePartitions |
No |
Ninguna |
Formato: ds=1/pt=1. |
|
|
outputTableName |
No |
Ninguna |
Tabla de salida en MaxCompute, en formato binario. |
|
|
lifecycle |
No |
3 |
Ciclo de vida de la tabla de salida en días. |
|
|
Parámetros del algoritmo |
objective |
Sí |
reg:linear |
Tipo de función objetivo. Tipos disponibles:
|
|
metric |
No |
Ninguna |
Métrica de evaluación para el conjunto de datos de entrenamiento. La salida se escribe en el archivo stdout en el área del coordinador Logview. Tipos disponibles:
|
|
|
treeCount |
No |
1 |
Número de árboles. El tiempo de entrenamiento aumenta proporcionalmente con este valor. |
|
|
maxDepth |
No |
5 |
Profundidad máxima de un árbol. Rango: 1 a 20. |
|
|
sampleRatio |
No |
1.0 |
Proporción de muestreo de datos. Rango: (0.1]. Un valor de 1.0 indica que no hay muestreo. |
|
|
featureRatio |
No |
1.0 |
Proporción de muestreo de funciones. Rango: (0.1]. Un valor de 1.0 indica que no hay muestreo. |
|
|
l1 |
No |
0 |
Coeficiente de penalización L1. Valores mayores producen una distribución de nodos hoja más uniforme. Auméntelo para reducir el sobreajuste. |
|
|
l2 |
No |
1.0 |
Coeficiente de penalización L2. Valores mayores producen una distribución de nodos hoja más uniforme. Auméntelo para reducir el sobreajuste. |
|
|
shrinkage |
No |
0.3 |
Tasa de aprendizaje. Rango: (0.1). |
|
|
sketchEps |
No |
0.03 |
Umbral de cuantil para la división al construir un boceto. El número de cubos es O(1.0/sketchEps). Valores menores producen más cubos. Utilice el valor predeterminado. Rango: (0.1). |
|
|
minSplitLoss |
No |
0 |
Cambio mínimo de pérdida requerido para dividir un nodo. Valores mayores producen divisiones más conservadoras. |
|
|
featureNum |
No |
Ninguna |
Número total de funciones o ID máximo de función. Si este parámetro no se especifica al estimar el uso de recursos, el sistema calcula el valor automáticamente mediante la ejecución de una tarea SQL. |
|
|
baseScore |
No |
0.5 |
Valor de predicción inicial para todas las muestras. |
|
|
randSeed |
No |
Ninguna |
Semilla para el generador de números aleatorios. Debe ser un entero. |
|
|
featureImportanceType |
No |
gain |
Método para calcular la importancia de las funciones. Métodos disponibles:
|
|
|
tweedieVarPower |
No |
1.5 |
Índice de la relación entre la varianza y la media de la distribución Tweedie. |
|
|
Parámetros de ajuste |
coreNum |
No |
Asignado por el sistema |
Número de núcleos. Valores mayores aceleran el algoritmo. |
|
No |
Asignado por el sistema |
Memoria por núcleo en MB. |
Ejemplo
-
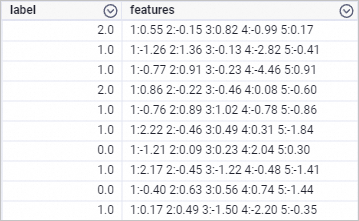
Utilice ODPS SQL node para ejecutar la siguiente sentencia SQL y generar datos de entrada. Este ejemplo utiliza formato clave-valor.
drop table if exists smart_regression_input;
create table smart_regression_input as
select
*
from
(
select 2.0 as label, '1:0.55 2:-0.15 3:0.82 4:-0.99 5:0.17' as features
    union all
select 1.0 as label, '1:-1.26 2:1.36 3:-0.13 4:-2.82 5:-0.41' as features
    union all
select 1.0 as label, '1:-0.77 2:0.91 3:-0.23 4:-4.46 5:0.91' as features
    union all
select 2.0 as label, '1:0.86 2:-0.22 3:-0.46 4:0.08 5:-0.60' as features
    union all
select 1.0 as label, '1:-0.76 2:0.89 3:1.02 4:-0.78 5:-0.86' as features
    union all
select 1.0 as label, '1:2.22 2:-0.46 3:0.49 4:0.31 5:-1.84' as features
    union all
select 0.0 as label, '1:-1.21 2:0.09 3:0.23 4:2.04 5:0.30' as features
    union all
select 1.0 as label, '1:2.17 2:-0.45 3:-1.22 4:-0.48 5:-1.41' as features
    union all
select 0.0 as label, '1:-0.40 2:0.63 3:0.56 4:0.74 5:-1.44' as features
    union all
select 1.0 as label, '1:0.17 2:0.49 3:-1.50 4:-2.20 5:-0.35' as features
) tmp;
Los datos generados se muestran a continuación.
-
Construya el siguiente flujo de trabajo y ejecute los componentes. Para obtener más información, consulte Algorithm modeling.
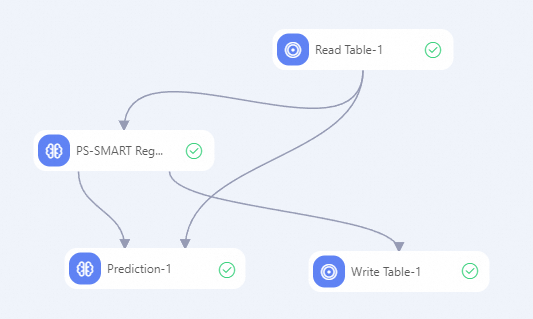
En la lista de componentes a la izquierda del lienzo de Designer, busque los componentes Read Table, PS-SMART Regression, Prediction y Write Table, y arrástrelos al lienzo.
-
Configure los parámetros de los componentes.
Haga clic en el componente Read Table-1 en el lienzo. En la pestaña Select Table del panel derecho, establezca Table Name como smart_regression_input.
-
Haga clic en el componente PS-SMART Regression-1 en el lienzo. En el panel derecho, configure los parámetros como se muestra en la siguiente tabla. Utilice los valores predeterminados para los parámetros restantes.
Tipo de parámetro
Parámetro
Descripción
Configuración de campos
Es formato disperso
Seleccione la casilla de verificación Is sparse format.
Columnas de funciones
Seleccione la columna features.
Columna de etiqueta
Seleccione la columna label.
Configuración de parámetros
Tipo de función objetivo
Establézcalo en Linear regression.
Tipo de métrica de evaluación
Seleccione rooted mean square error.
Número de árboles
Establézcalo en 5.
-
Haga clic en el componente Prediction-1 en el lienzo. En el panel derecho, configure los parámetros como se muestra en la siguiente tabla. Utilice los valores predeterminados para los parámetros restantes.
Tipo de parámetro
Parámetro
Descripción
Configuración de campos
Columnas de funciones
Todas las columnas están seleccionadas de forma predeterminada. Las columnas adicionales no afectan los resultados de la predicción.
Columnas de paso directo
Seleccione la columna label.
Matriz dispersa
Seleccione la casilla de verificación Sparse matrix.
Separador clave-valor
Establézcalo en dos puntos (:).
Separador entre pares clave-valor
Establézcalo en un espacio.
Haga clic en el componente Write Table-1 en el lienzo. En el panel derecho, en la pestaña Select Table, establezca Table Name for Output como smart_regression_output.
Después de configurar los parámetros, haga clic en el botón de ejecución
 para ejecutar el flujo de trabajo.
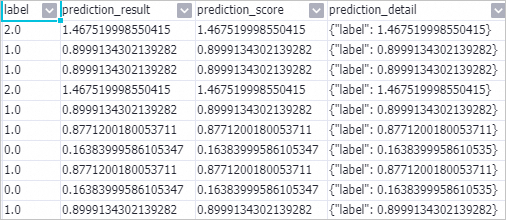
Haga clic con el botón derecho en el componente Prediction-1 y elija .
-
Para consultar la importancia de las funciones, haga clic con el botón derecho en el componente PS-SMART Regression-1 y seleccione en el menú contextual.
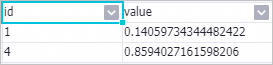
La columna id indica el número ordinal de la función de entrada. Dado que los datos de entrada en este ejemplo utilizan formato clave-valor, la columna id representa la clave en el par clave-valor. La tabla de importancia de funciones contiene solo dos funciones, lo que significa que solo estas dos se utilizaron durante la división del árbol. Otras funciones tienen una importancia de 0. La columna value indica el tipo de importancia de la función. El valor predeterminado es gain, que representa la ganancia de información total que la función aporta al modelo.
Despliegue del modelo
Para desplegar el modelo generado por el componente PS-SMART como un servicio en línea, agregue el componente General-purpose Model Export en sentido descendente al componente PS-SMART. Configure los parámetros del componente de la misma manera que otros componentes de la serie PS. Para obtener más información, consulte General-purpose Model Export.
Tras una ejecución exitosa, despliegue el servicio de modelo en la página PAI-EAS Model Online Service. Para obtener más información, consulte Deploy a service in the console.
Referencias
Para obtener más información sobre los componentes de Designer, consulte Designer overview.
Designer ofrece una variedad de componentes algorítmicos para diferentes escenarios. Para obtener más información, consulte Designer component overview.