Este tema describe el proceso completo para usar Data Lake Formation (DLF) como origen de datos y sincronizar datos vectoriales multimodales con Alibaba Cloud OpenSearch. También destaca las potentes capacidades de procesamiento de datos multimodales de OpenSearch: extrae automáticamente datos de texto, imagen y video desde DLF, vectoriza y analiza el contenido mediante modelos integrados o la AI Search Open Platform, y convierte los datos no estructurados en vectores estructurados que se sincronizan con OpenSearch. Esta solución es compatible con varios formatos de datos, como Paimon, Lance y Object Table. Además, ofrece opciones completas de configuración de índices vectoriales —como dimensiones de vectores, tipos de distancia y algoritmos de recuperación— que le permiten construir aplicaciones de recuperación multimodal de manera eficiente para casos de uso como búsqueda de imágenes, búsqueda semántica de texto y búsqueda de video.
Requisitos previos
Familiarícese con Data Lake Formation.
Configure un ID de catálogo de datos, una base de datos y una tabla de datos de DLF. Estos identificadores son obligatorios cuando configure la sincronización de datos.
Adición de un origen de datos de Data Lake Formation (DLF)
En la página Instance Details > Table Management, haga clic en Add Table:
-
Complete la información básica de la tabla y luego haga clic en Next:
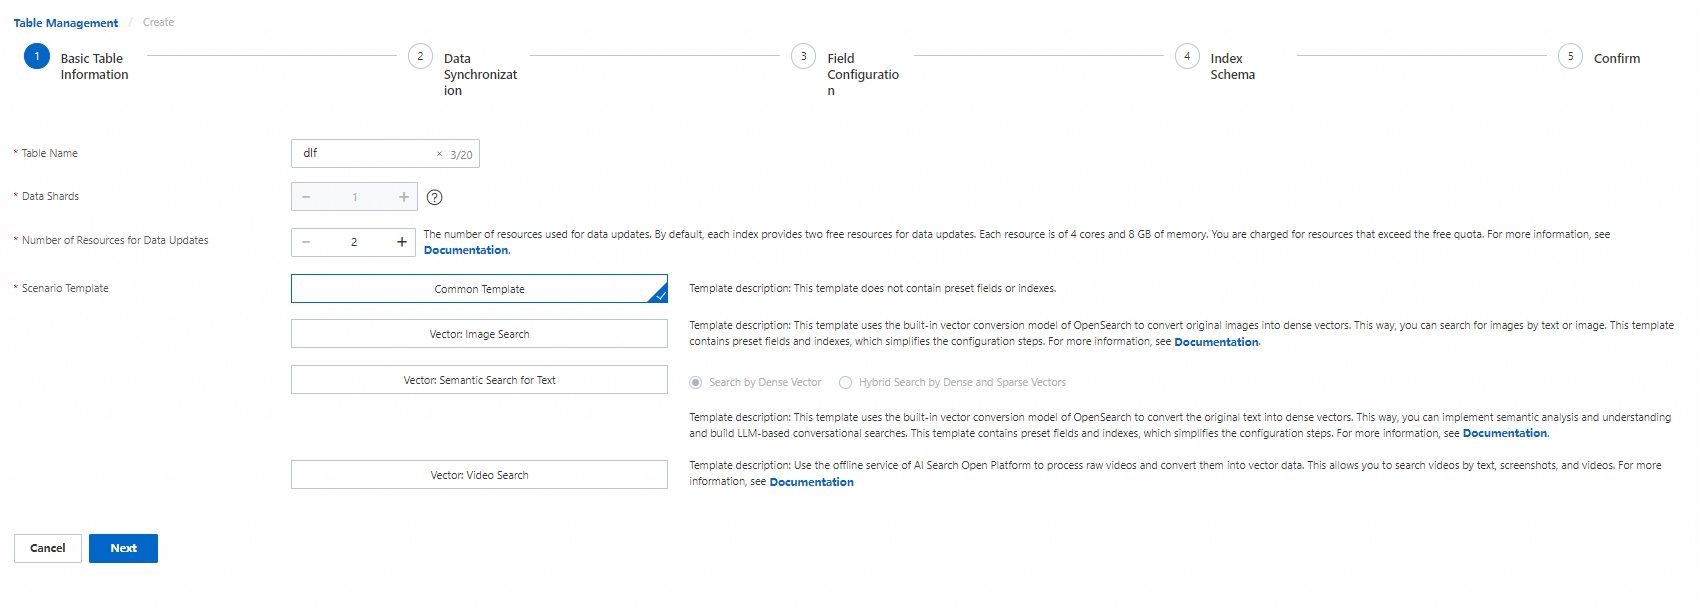 Notas de configuración:
Table Name: un nombre personalizado.
Data Shards: al establecer el número de shards, todas las tablas de índice deben tener la misma cantidad. Como alternativa, una sola tabla de índice puede tener un único shard mientras las demás comparten una cantidad idéntica.
Number of Resources for Data Updates: la cantidad de recursos que se usan para actualizar los datos. Cada índice proporciona dos recursos de actualización gratuitos con 4 núcleos y 8 GB de forma predeterminada. Los recursos que excedan la cuota gratuita generan cargos. Para más detalles, consulte Billing overview of OpenSearch Vector Search Edition
Scenario Template: OpenSearch Vector Search Edition incluye cuatro plantillas integradas: Common Template, Vector: Image Search, Vector: Text Semantic Template y Vector: Video Search (esta última plantilla no admite actualmente un lago de datos como origen de datos completo).
-
Para la sincronización de datos, configure el origen de datos. Una vez superada la validación, haga clic en Next:
Origen de datos completo: seleccione Data Lake Formation (DLF).
-
Formato de tabla: los formatos compatibles son Paimon, Lance y Object Table.
Paimon es un formato de tabla lakehouse que actualiza los datos en tiempo real, igual que una base de datos, y admite el procesamiento por lotes y en streaming.
Lance es un formato de tabla vectorial diseñado para IA que permite realizar búsquedas de similitud ultrarrápidas sobre vectores.
Object Table es un formato de tabla de metadatos que le permite usar SQL para consultar y localizar directamente diversos archivos almacenados en la nube.
Catálogo de datos: el ID del catálogo de datos de DLF al que desea acceder.
Base de datos: la base de datos dentro del catálogo de datos de destino a la que desea acceder.
-
Tabla de datos: la tabla de datos dentro de la base de datos de destino a la que desea acceder.
NotaEn las instancias existentes, debe actualizar la versión del motor antes de poder seleccionar el tipo Data Lake Formation (DLF).
Las plantillas Common Template y Vector: Image Search Template admiten los formatos Paimon, Lance y Object Table. La plantilla Vector: Text Semantic Search Template admite catálogos de datos de Paimon.
Las tablas de clave principal de Paimon admiten operaciones de inserción, eliminación, actualización y consulta. Las tablas de solo anexión de Paimon únicamente admiten escrituras y no permiten actualizaciones ni eliminaciones.
Ruta relativa: la ruta relativa a los archivos de la tabla de objetos cuando el formato de tabla es Object Table.
Formato de datos: cuando el formato de tabla es Object Table, debe seleccionar el formato de datos ha3 o JSON.
-
Etiqueta: una etiqueta de versión de datos. Si especifica una etiqueta, OpenSearch usa los datos de dicha etiqueta para la sincronización completa. Si no especifica ninguna, utiliza los datos más recientes de la tabla.
Paimon ofrece una función de etiquetas para conservar los metadatos y los archivos de datos de instantáneas específicas, lo que evita la pérdida de datos históricos por el vencimiento de las instantáneas. Las etiquetas se pueden crear automáticamente a partir de trabajos de escritura, generarse periódicamente según el tiempo de procesamiento o el tiempo de marca de agua, o bien crearse, eliminarse o revertirse de forma manual hacia una etiqueta específica. Al configurar una directiva de retención, usted controla la cantidad máxima de etiquetas o el periodo de retención para garantizar que los datos históricos sigan siendo consultables. Para más detalles, consulte Etiquetas de Paimon.
Lance emplea una función de etiquetas para marcar versiones específicas en el historial de un conjunto de datos, lo que facilita el seguimiento de su evolución. Esto resulta especialmente útil en canalizaciones de aprendizaje automático con actualizaciones frecuentes. Usted puede crear, actualizar, eliminar y listar etiquetas. Estas no generan versiones nuevas; existen como metadatos en un directorio independiente. Las versiones etiquetadas no se eliminan mediante "cleanup_old_versions": primero debe eliminar la etiqueta para que la versión correspondiente pueda quitarse. Para más detalles, consulte Etiquetas de Lance.
Validación del origen de datos: podrá continuar con el siguiente paso una vez superada la validación.
-
Para la configuración de columnas, haga clic en Next cuando termine:
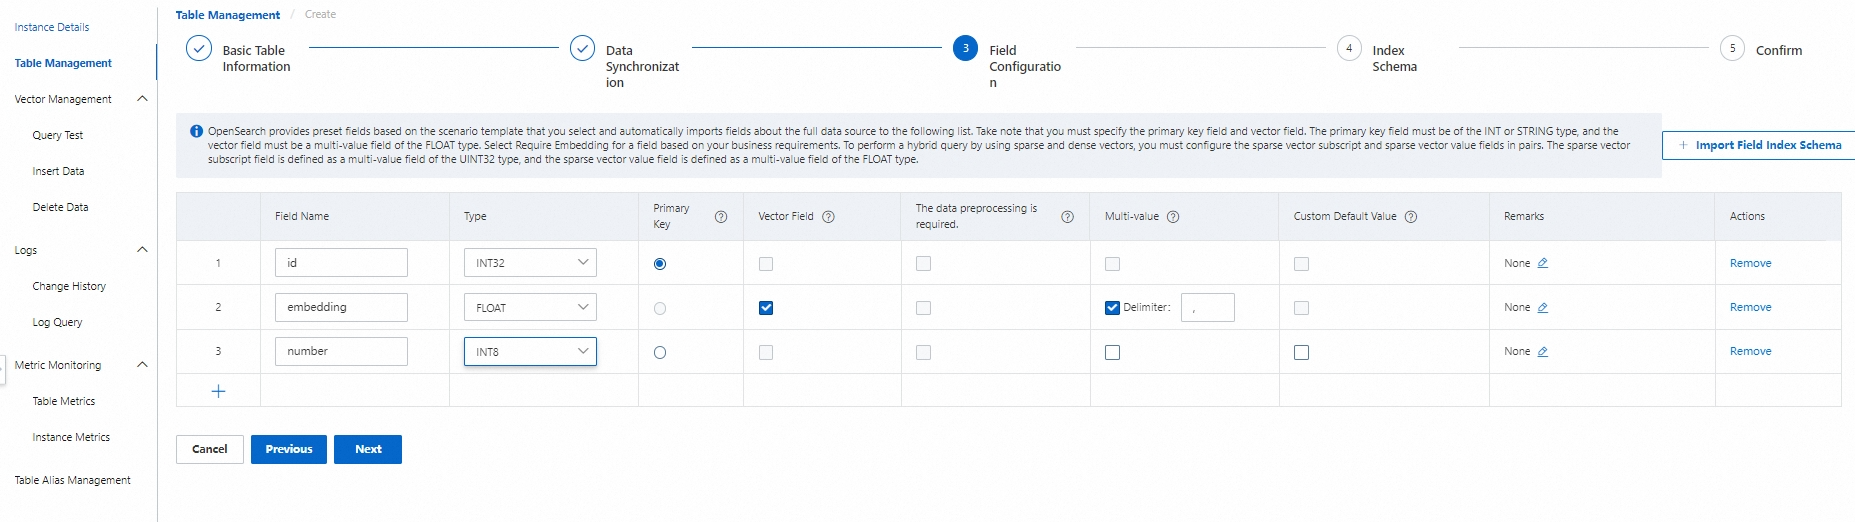
Las columnas obligatorias son la columna de clave principal y la columna de vectores. La columna de clave principal debe ser de tipo int o string, y debe seleccionar el botón de clave principal. La columna de vectores debe ser de tipo float, y debe seleccionar el botón de columna de vectores.
La columna de vectores tiene de forma predeterminada un tipo float multivalor.
-
Preprocesamiento de datos obligatorio: admite columnas de tipo String. Después de seleccionarlo, haga clic en Configure para llamar a un modelo que preprocese la columna.

Tipo de datos de texto
Tipo de datos: texto.
Plantilla de preprocesamiento: vectorización densa, vectorización densa + dispersa.
-
Lista de servicios:
Cuando selecciona una plantilla de preprocesamiento, aparece automáticamente la lista de servicios correspondiente, donde se muestran los tipos de modelo que utiliza la plantilla.
Orígenes de modelos disponibles:
Modelos integrados: una cantidad reducida de tipos y unidades de modelos que se pueden invocar de forma gratuita.
AI Search Open Platform: esta plataforma ofrece amplias capacidades de modelos y se cobra según el volumen de llamadas. Consulte Billing methods and billable items. Antes de utilizarla, debe activar un espacio de trabajo y una API Key en AI Search Open Platform.
Modelos personalizados: puede personalizar modelos según sus necesidades. En la página de Vector Search Edition, dentro de Models>Custom Models, ejecute la operación Create Model. Para más detalles, consulte Custom models.
Tipo de datos de imagen
Tipo de datos: imagen.
-
Origen de datos: OSS, codificación Base64 y DLF-Object Table.
OSS: debe proporcionar una ruta de OSS. Esto significa que las imágenes se almacenan en una carpeta de OSS y se importan directamente desde allí.
Codificación Base64: la imagen se codifica una vez y luego se almacena en una base de datos, o bien se transmite directamente mediante una API.
DLF-Object Table: una tabla con formato Object Table en el lago de datos. Debe proporcionar el catálogo de datos, la base de datos y la tabla de datos correspondientes.
Plantilla de preprocesamiento: vectorización de imágenes, análisis de contenido de imágenes, análisis de contenido de imágenes + vectorización de imágenes.
-
Lista de servicios:
Cuando selecciona una plantilla de preprocesamiento, aparece automáticamente la lista de servicios correspondiente, donde se muestran los tipos de modelo que utiliza la plantilla.
Orígenes de modelos disponibles:
Modelos integrados: una cantidad reducida de tipos y unidades de modelos que se pueden invocar de forma gratuita.
AI Search Open Platform: esta plataforma ofrece amplias capacidades de modelos y se cobra según el volumen de llamadas. Consulte Billing methods and billable items. Antes de utilizarla, debe activar un espacio de trabajo y una API Key en AI Search Open Platform.
Modelos personalizados: puede personalizar modelos según sus necesidades. En la página de Vector Search Edition, dentro de Models > Custom Models, ejecute la operación Create Model. Para más detalles, consulte Custom models.
Tipo de datos de video
Tipo de datos: video.
Origen de datos: OSS.
Plantilla de preprocesamiento: procesamiento de video.
-
Lista de servicios:
Cuando selecciona una plantilla de preprocesamiento, aparece automáticamente la lista de servicios correspondiente, donde se muestran los tipos de modelo que utiliza la plantilla.
Orígenes de modelos disponibles:
Modelos integrados: una cantidad reducida de tipos y unidades de modelos que se pueden invocar de forma gratuita.
AI Search Open Platform: esta plataforma ofrece amplias capacidades de modelos y se cobra según el volumen de llamadas. Consulte Billing methods and billable items. Antes de utilizarla, debe activar un espacio de trabajo y una API Key en AI Search Open Platform.
Modelos personalizados: puede personalizar modelos según sus necesidades. En la página de Vector Search Edition, dentro de Models > Custom Models, ejecute la operación Create Model. Para más detalles, consulte Custom models.
Cuando falta una columna o está vacía en los datos, el sistema rellena automáticamente un valor predeterminado: los tipos numéricos toman 0 y los tipos STRING toman una cadena vacía. Se admiten valores predeterminados personalizados.
-
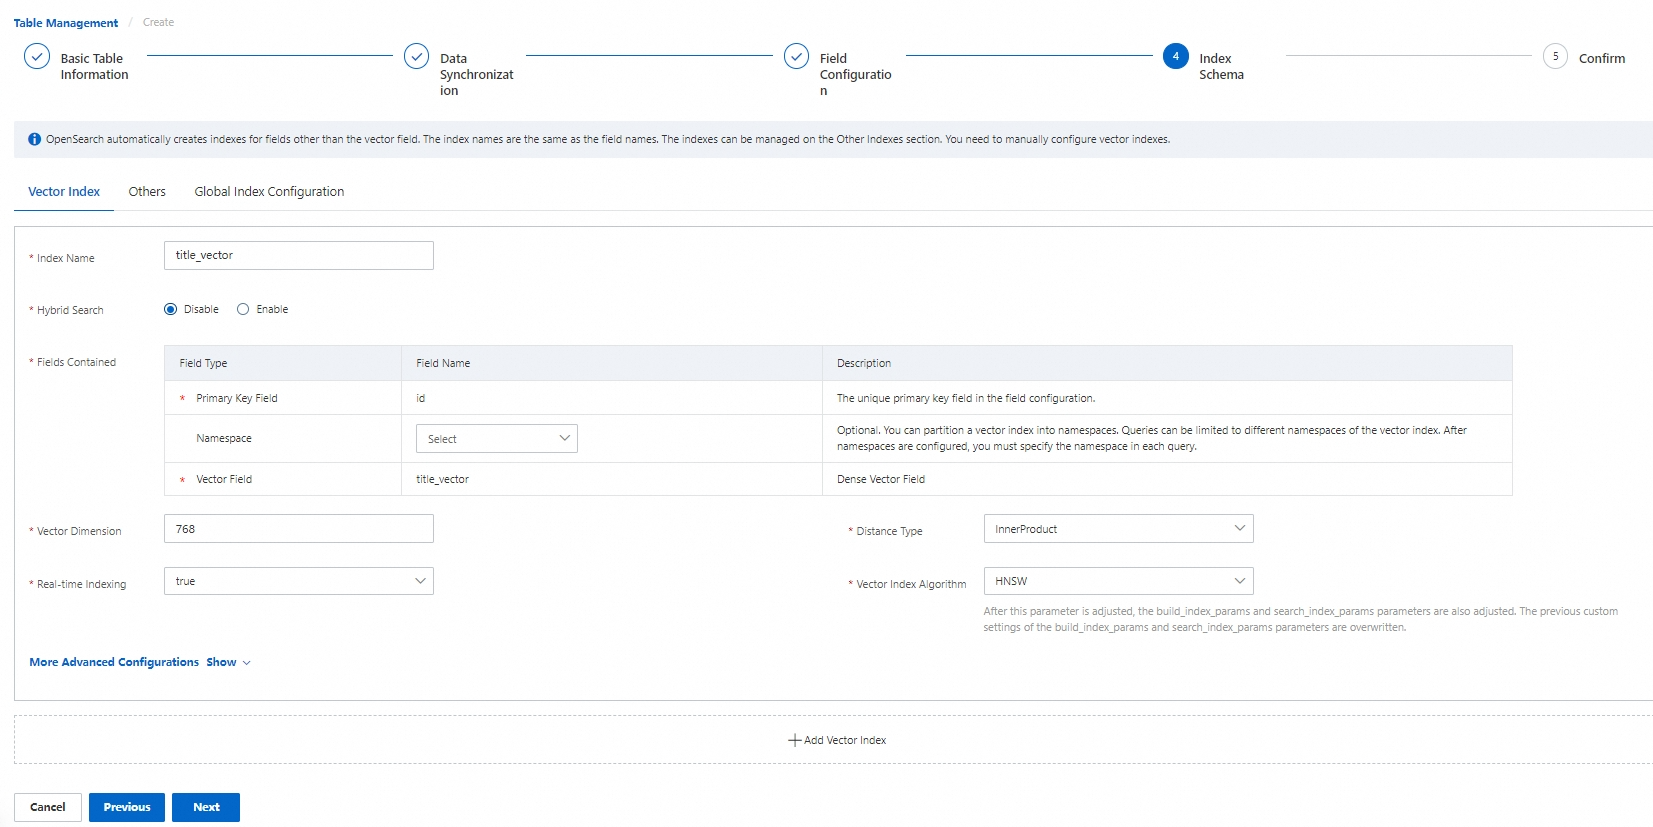
Para la configuración de la estructura de índices, haga clic en Next cuando termine:
-
Índice vectorial:
Dimensiones de vectores: selecciónelas según los vectores que genere el modelo.
Distance Type: selecciónelo según los vectores que genere el modelo. El sistema admite tres tipos de distancia: SquareEuclidean, InnerProduct y Cosine.
Algorithms: selecciónelo según los vectores que genere el modelo. El sistema admite los siguientes algoritmos de índices vectoriales: Liner, HNSW, QGraph, QC, DiskANN y CagraHnsw.
-
Índice en tiempo real: indica si los datos incrementales provenientes de la API necesitan construir un índice vectorial en tiempo real. El valor predeterminado es true.
Para otras configuraciones avanzadas, expándalas y configúrelas. Para ver la descripción de los parámetros, consulte General vector index configuration.
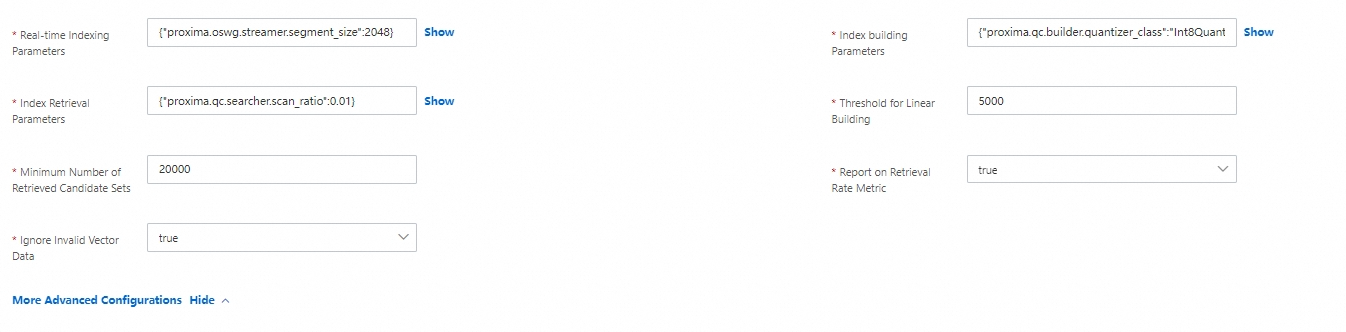
Otros tipos de índices: el sistema genera una columna pk y un índice de clave principal. De forma predeterminada, también genera un índice con el mismo nombre para las columnas restantes que no son de vectores.
Configuración global de índices: puede habilitar la limpieza automática de documentos vencidos. Una vez habilitada, un documento se elimina automáticamente cuando el tiempo actual menos el tiempo del documento supera el tiempo de vencimiento.
-
Para confirmar la creación, haga clic en Confirm Create. El sistema crea automáticamente la tabla configurada. Puede consultar el progreso de creación de la tabla en el historial de cambios:
Cuando el estado de la tabla sea In Use, podrá ejecutar pruebas de consulta en la página de pruebas de consulta.
Nota
Cuando se escriben datos nuevos en una tabla Paimon de DLF, OpenSearch activa automáticamente la construcción de índices en tiempo real a partir de esos datos. Si escribe datos manualmente mediante la API, podrían surgir problemas de consistencia, así que proceda con precaución.