OpenSearch Vector Search Edition admite varios algoritmos de índices vectoriales y métricas de distancia para diversos escenarios de recuperación.
Descripción general de la recuperación vectorial
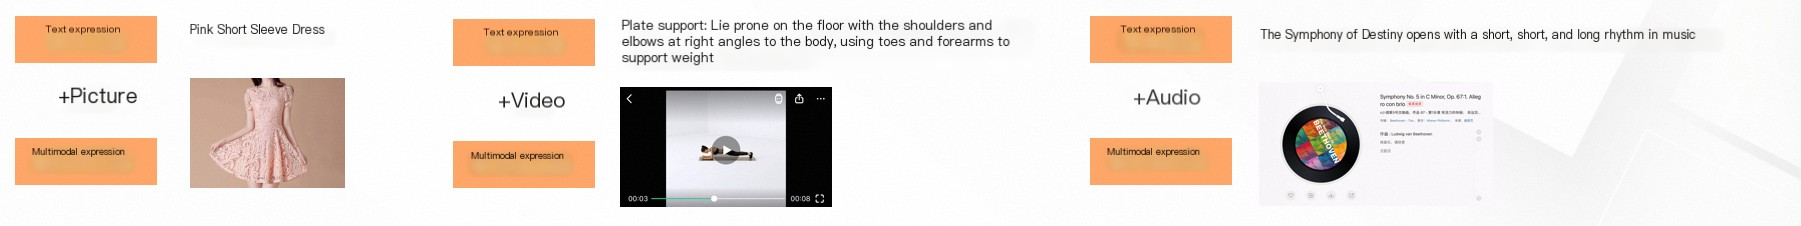
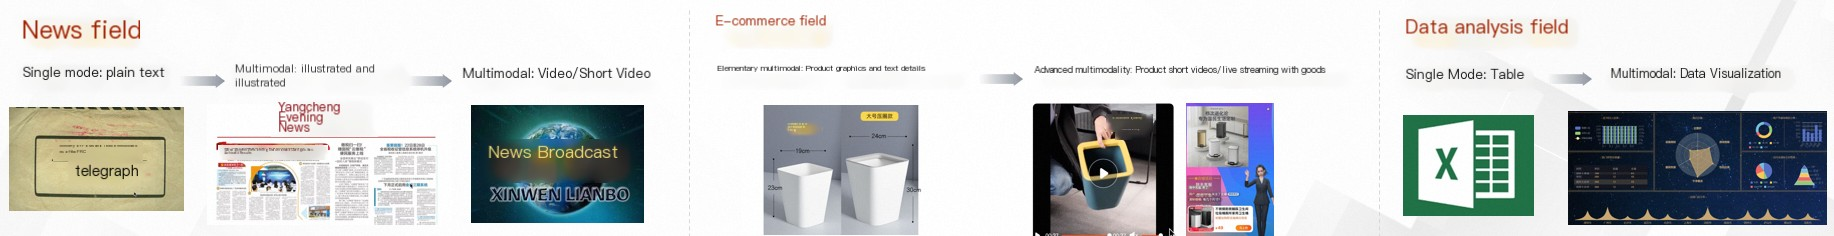
Los datos existen en varias modalidades además del texto, como imágenes, videos y audio. Multimodal data conveys details that text cannot, such as color, shape, motion, sound, and spatial relationships.
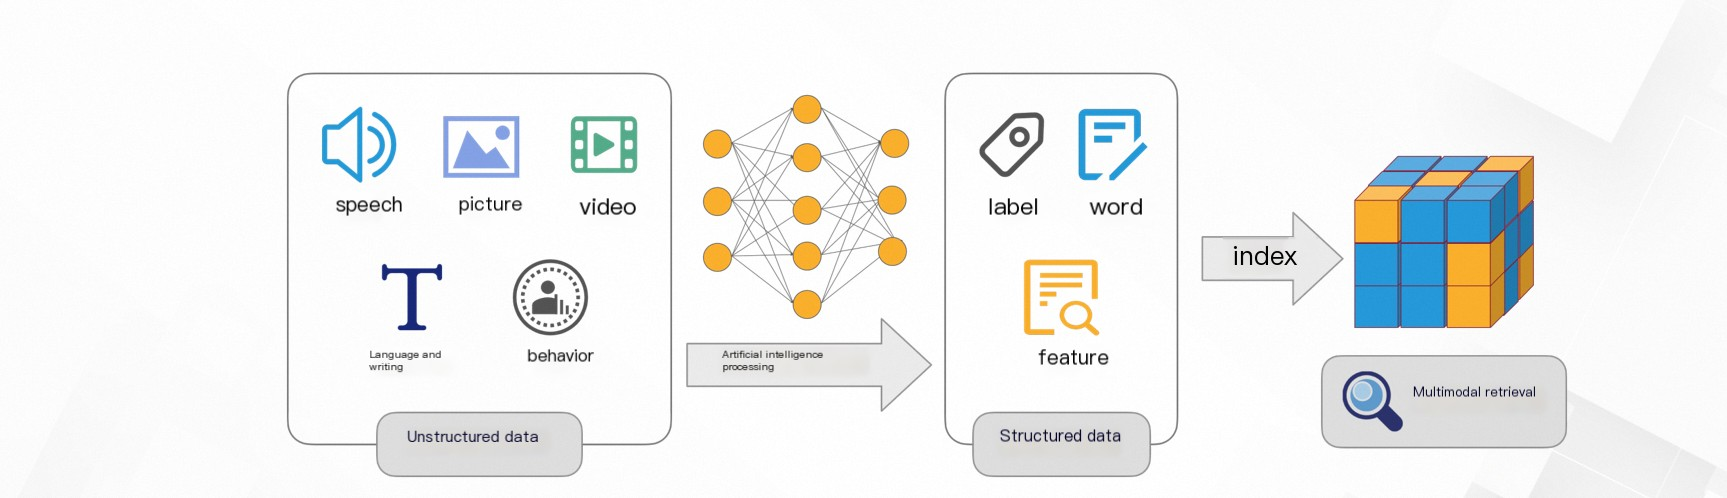
Los datos no estructurados del mundo físico se transforman en vectores multidimensionales que representan entidades y sus relaciones.
El sistema calcula las distancias entre los vectores; una distancia menor indica mayor similitud, y devuelve los resultados más similares.
Algoritmos
lineal
El algoritmo lineal calcula la distancia entre el vector de consulta y cada vector del conjunto de datos.
Escenario: Use este algoritmo si requiere una tasa de recuperación del 100 %.
Desventajas: Este algoritmo es ineficiente para conjuntos de datos grandes debido al alto consumo de CPU y memoria.
Agrupamiento
Agrupamiento cuantizado
Descripción general:
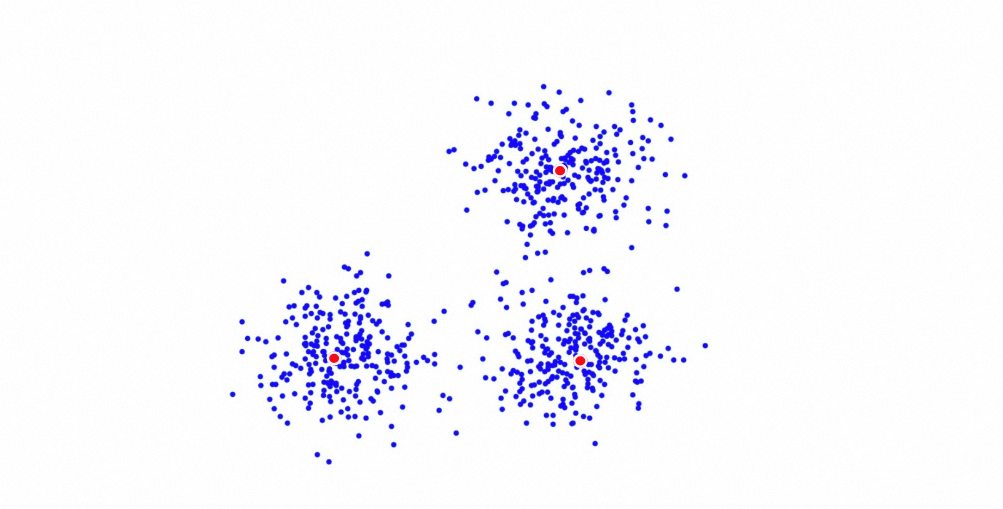
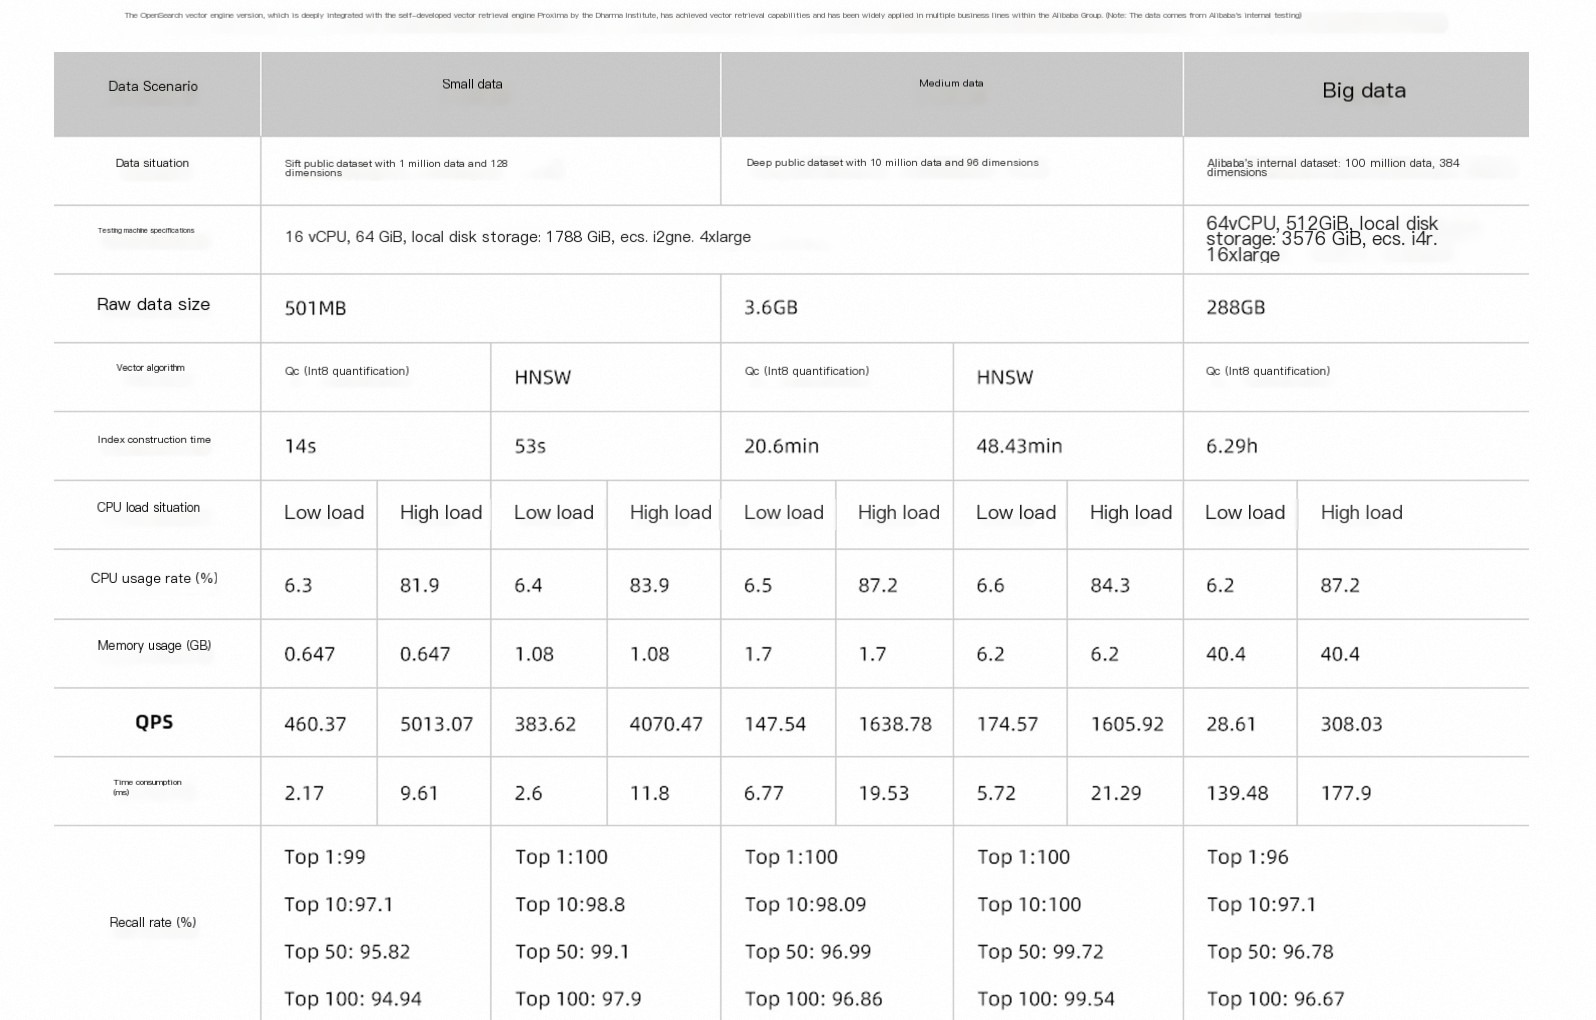
El agrupamiento cuantizado (QC) es un algoritmo de recuperación vectorial desarrollado por Alibaba basado en el agrupamiento k-means. Agrupa los vectores en n centroides y asigna cada documento a su centroide más cercano, lo que forma n listas invertidas. Durante la recuperación, la consulta selecciona los centroides más cercanos, examina sus listas invertidas y devuelve los k documentos más próximos.
QC admite la cuantización fp16 e int8 para reducir el tamaño del índice y mejorar el rendimiento, a cambio de una ligera disminución en la tasa de recuperación.
QC es adecuado para escenarios de datos en tiempo real o casos de uso de baja latencia acelerados por GPU.
Ajuste de parámetros:
Comparación de rendimiento:
HNSW
Descripción general:
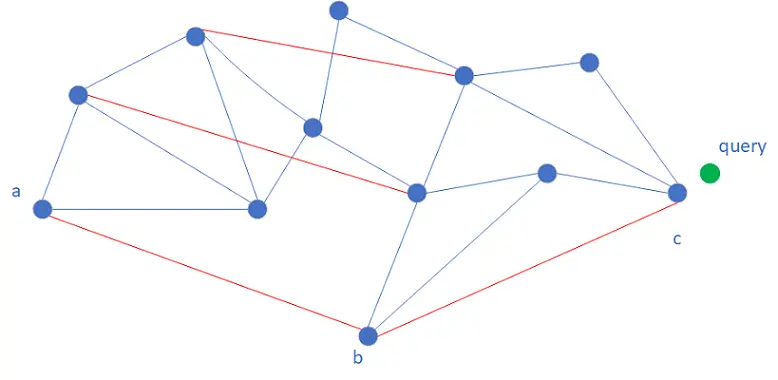
Hierarchical Navigable Small World (HNSW) es un algoritmo de recuperación vectorial basado en grafos de proximidad. Construye un grafo con aristas entre vectores cercanos. Durante la recuperación, la búsqueda comienza desde un nodo de entrada, recorre al vecino más cercano en cada paso e itera hasta la convergencia; es decir, cuando ningún vecino del nodo actual está más cerca de la consulta que la mejor coincidencia encontrada.
Para acelerar la convergencia, HNSW usa un grafo multicapa similar a una lista de saltos. La recuperación comienza en la capa superior y desciende. Cuando el recorrido converge en un nodo de la capa k, ese nodo se convierte en el punto de entrada para la capa k-1. Las capas superiores tienen nodos más dispersos, lo que permite tamaños de paso mayores y una iteración más rápida.
Ajuste de parámetros:
QGraph
Descripción general:
Quantized Graph (QGraph) es un algoritmo mejorado desarrollado por OpenSearch basado en HNSW. Cuantiza los datos sin procesar antes de compilar el índice de grafo, lo que reduce el tamaño del índice hasta una octava parte del de HNSW y logra un rendimiento varias veces superior mediante optimizaciones de instrucciones de CPU para cálculos enteros. La contrapartida es una menor tasa de recuperación debido a la reducción en la distintividad de los vectores, lo cual puede mitigarse al recuperar más resultados.
QGraph admite la cuantización int4, int8 e int16. Los anchos de bit menores reducen el uso de memoria y aumentan el rendimiento, pero disminuyen la tasa de recuperación. La cuantización int16 ofrece un rendimiento y una tasa de recuperación casi idénticos a los de los datos no cuantizados.
Ajuste de parámetros:
CAGRA
Descripción general:
CUDA ANN GRAph-based (CAGRA) es un algoritmo de grafo de proximidad optimizado para GPU NVIDIA, diseñado para escenarios de recuperación por lotes y alta concurrencia.
A diferencia de HNSW, CAGRA construye un grafo de proximidad de una sola capa optimizado para cómputo paralelo. Durante una consulta, selecciona iterativamente los nodos top-k de un conjunto de candidatos como puntos de partida y actualiza el conjunto con sus vecinos hasta alcanzar la convergencia.
CAGRA admite dos directivas de ejecución: single-CTA asigna una consulta a un bloque de hilos para lograr un alto throughput con lotes grandes, mientras que multi-CTA usa varios bloques de hilos por consulta para obtener una mejor recuperación con lotes pequeños, aunque con un throughput menor para lotes grandes. El sistema selecciona automáticamente la directiva óptima durante la ejecución.
Ajuste de parámetros:
DiskANN
Descripción general:
DiskANN es un algoritmo de búsqueda de vecinos más cercanos aproximados (ANN) basado en disco, diseñado para conjuntos de datos que superan la memoria disponible. Usa el algoritmo de grafo Vamana para mantener una indexación y recuperación de alto rendimiento mientras almacena los datos en disco.
El algoritmo DiskANN solo es compatible cuando la familia de nodos de datos es SSD.
Ajuste de parámetros:
CagraHnsw
Descripción general:
CagraHnsw es un algoritmo de recuperación vectorial desarrollado por OpenSearch que combina CAGRA y HNSW para la compilación rápida de índices en conjuntos de datos masivos.
CagraHnsw usa GPU para compilar índices (al igual que CAGRA) y los convierte a un formato compatible con HNSW para la recuperación basada en CPU. Esto combina la compilación rápida de índices en GPU con consultas rentables en CPU, lo que lo hace más económico que CAGRA para cargas de trabajo sin alta concurrencia sostenida.
Tipos de distancia vectorial
La recuperación vectorial calcula las distancias entre los vectores y devuelve los k resultados más similares. Una distancia menor indica mayor similitud.
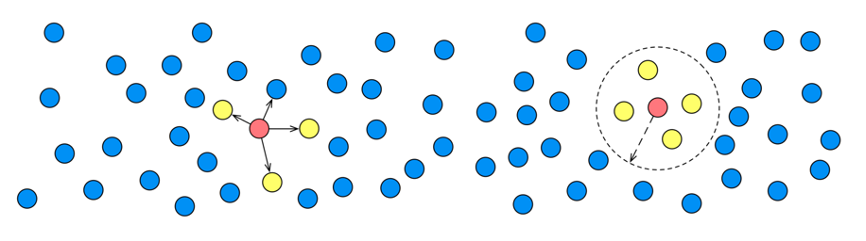
OpenSearch Vector Search Edition admite tres métricas de distancia: distancia euclidiana al cuadrado, producto interno y distancia coseno.
Distancia euclidiana al cuadrado (SquareEuclidean)
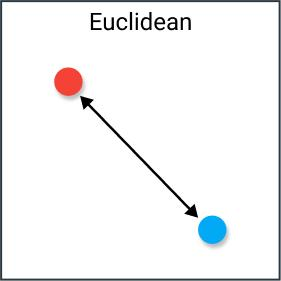
La distancia euclidiana mide la distancia en línea recta entre dos vectores al calcular la raíz cuadrada de la suma de las diferencias de coordenadas al cuadrado. Los valores menores indican mayor similitud.
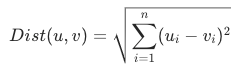
Distancia de producto interno (InnerProduct)
El producto interno (producto punto) multiplica los elementos correspondientes de dos vectores y suma los productos. Los valores mayores indican mayor similitud. Esta métrica es común en escenarios de búsqueda y recomendación donde el modelo subyacente usa puntuación de producto interno.
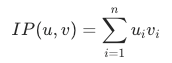
Distancia coseno
La distancia coseno mide el coseno del ángulo entre dos vectores. Los valores oscilan entre -1 y 1: 1 indica dirección idéntica (mayor similitud), 0 indica perpendicularidad y -1 indica direcciones opuestas. Esta métrica se usa comúnmente para la recuperación de similitud de texto.
