Este tema explica en qué consiste la función de predicción de categorías, sus principios básicos y su uso, para ayudarle a comprenderla y utilizarla rápidamente.
Resultados
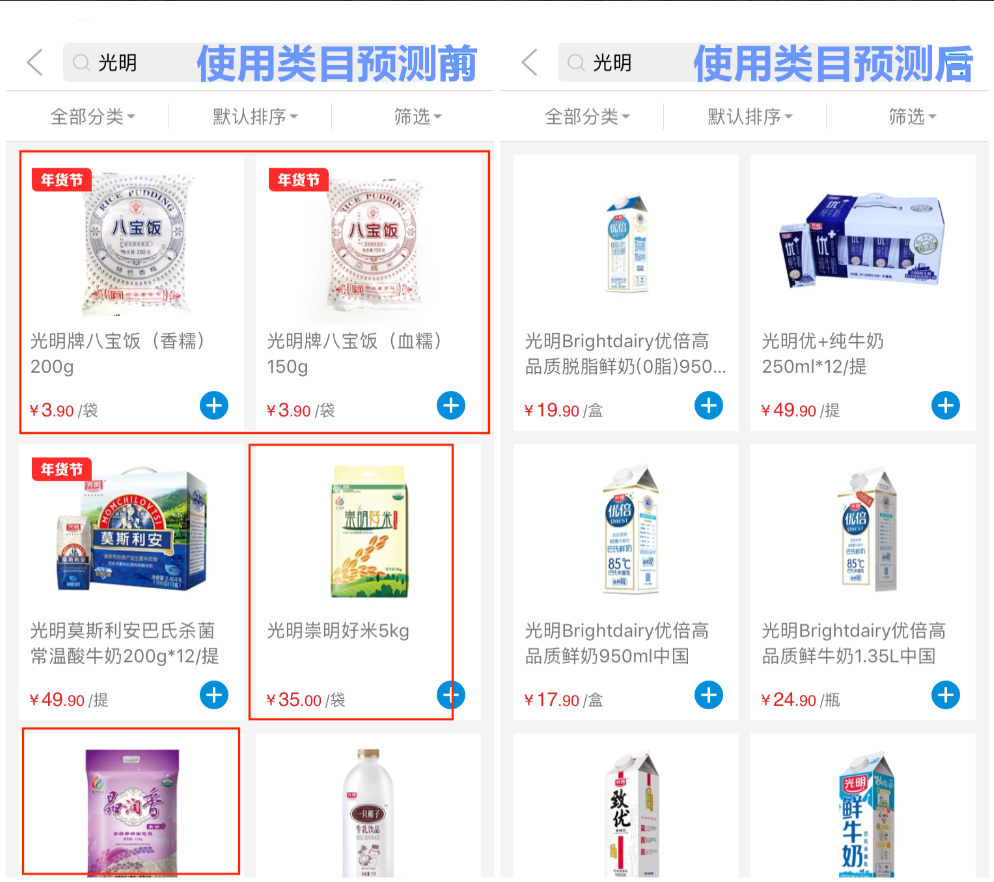
Concepto clave
La predicción de categorías clasifica los resultados al calcular la relevancia entre la consulta de búsqueda del usuario y las categorías de productos. Los productos pertenecientes a categorías con mayor relevancia obtienen puntuaciones de clasificación más altas y aparecen antes en los resultados de búsqueda.
Ejemplo:
Por ejemplo, un usuario busca "Bright" y obtiene un conjunto de productos. Algunos pertenecen a la categoría "Milk" y otros a la categoría "Rice". Según los datos históricos de comportamiento de búsqueda, entre los usuarios que buscan "Bright", una cantidad significativamente mayor hace clic en productos de la categoría "Milk" que en los de la categoría "Rice". Por lo tanto, el modelo de predicción de categorías determina que la categoría "Milk" es más relevante para "Bright" que la categoría "Rice". En consecuencia, al calcular la puntuación de clasificación de cada producto, aquellos en la categoría "Milk" obtienen una puntuación superior a los de la categoría "Rice"; esto eleva su posición en la clasificación y aumenta el valor comercial de la búsqueda.
Principios básicos de la predicción de categorías
El objetivo de la predicción de categorías es estimar la relevancia entre una consulta de búsqueda y una categoría. Para ello se requieren datos históricos de consultas, datos de comportamiento de clics e información de productos correspondiente a cada categoría. Específicamente, el sistema recopila consultas previas, las combina con los datos de comportamiento de clics posteriores a las búsquedas y las vincula con la información de productos de cada categoría para caracterizar los patrones de datos entre consultas y categorías.
El entrenamiento de un modelo requiere una fuente de datos. Al crear un modelo de predicción de categorías, primero debe asociarlo con una aplicación. Una vez asociada la aplicación, es necesario determinar los siguientes tres tipos de datos obligatorios para entrenar el modelo:
Todas las consultas realizadas en la aplicación. Debe agregar el parámetro raw_query a las solicitudes de búsqueda.
Datos de categorías y datos de productos. Estos campos se especifican desde la aplicación durante la preparación del entrenamiento del modelo. Como mínimo, debe especificar el campo de ID de categoría y el campo de título del producto en la aplicación.
Datos de comportamiento de clics de la aplicación. Cuanto más completos y de mayor calidad sean los datos de comportamiento reportados, más ricas serán las funciones del modelo y mejores los resultados.
La función de predicción de categorías de OpenSearch admite tanto el entrenamiento de modelos con datos de comportamiento como sin ellos.
El entrenamiento con datos de comportamiento aplica cuando ya se han cargado dichos datos. Antes de iniciar el entrenamiento, se realiza automáticamente una verificación de entrada para asegurar que la cantidad, la calidad y la integridad de los datos cumplan con los requisitos. El entrenamiento del modelo incluye los siguientes pasos:
Utilice consultas históricas e información de categorías para muestrear y generar datos de muestra, y emplee los datos de comportamiento para etiquetar dichos datos.
Realice operaciones como estadísticas de métricas y cálculos de funciones sobre los datos de comportamiento para generar funciones de comportamiento de clics.
Combine las consultas con los títulos de productos de cada categoría, tokenice las consultas y los títulos, y calcule las funciones semánticas entre el texto de la consulta y el texto del título del producto.
Si se cargaron datos de comportamiento de transacciones, realice estadísticas de métricas y cálculos de funciones sobre estos datos para generar funciones de transacción; de este modo, los productos con mejor desempeño en transacciones obtendrán una clasificación más alta.
Combine los datos de muestra generados anteriormente con las funciones de comportamiento, las funciones semánticas, las funciones de transacción y las etiquetas de los datos de muestra para formar los datos de entrenamiento, e introdúzcalos en el algoritmo para un entrenamiento iterativo.
Una vez completado el entrenamiento, obtendrá un modelo que describe la relevancia entre consultas y categorías en las muestras. Este modelo le permite predecir la relevancia entre una consulta y una categoría.
Al entrenar un modelo de predicción de categorías con la opción "behavioral data" seleccionada, se requiere que una consulta tenga más de un clic en una categoría bajo esa consulta dentro de los últimos 14 días.
El entrenamiento sin datos de comportamiento aplica a escenarios donde no se han cargado datos de comportamiento o estos son de baja calidad. Solo necesita especificar el campo de ID de categoría y el campo de título del producto en la aplicación para iniciar el entrenamiento del modelo. Al no contar con datos de comportamiento, no existe una base para etiquetar las muestras, por lo que se utiliza otro tipo de algoritmo para entrenar el modelo. Este calcula la relevancia semántica entre el texto de la consulta y el texto del título del producto basándose únicamente en los datos textuales de las consultas y los títulos de productos bajo las categorías después de la tokenización, y deriva la relevancia entre consultas y categorías.
Un modelo que utiliza datos de comportamiento supera en rendimiento a uno que no los usa. Cuanto más ricas sean las funciones de entrenamiento, de manera más integral caracterizará el modelo los patrones de datos entre consultas y categorías, y más precisas serán sus predicciones.
Independientemente de si el modelo utiliza datos de comportamiento o no, el proceso de entrenamiento ha pasado por extensa experimentación con datos de diferentes escenarios y un ajuste cuidadoso de parámetros para garantizar que los resultados cumplan con las expectativas.
Cómo usar la predicción de categorías
Requisitos previos
El entrenamiento del modelo requiere una fuente de datos, y debe asociar una aplicación antes de entrenar un modelo. Los datos de la aplicación, los datos de consultas de la aplicación y los datos de comportamiento de la aplicación constituyen la información necesaria para el modelo de predicción de categorías.
Si no ha cargado datos de comportamiento de clics, no desea utilizarlos para el entrenamiento, o aún no cumplen con las condiciones necesarias, puede entrenar el modelo sin datos de comportamiento de clics inicialmente. En este caso, el modelo de predicción de categorías necesita seleccionar datos para tres campos de la aplicación: Category ID, Commodity Title y Category Name. El ID de categoría y el título del producto son obligatorios, mientras que el nombre de la categoría es opcional. Una vez completado el entrenamiento del modelo, se generan resultados de predicción para una parte del modelo con fines de evaluación. El nombre de la categoría se utiliza en la página de evaluación de resultados para verificar si la relevancia entre consultas y categorías cumple con las expectativas; por ello, se recomienda proporcionar el campo de nombre de categoría durante el entrenamiento.
Si ya se cargaron datos de comportamiento de clics, además de seleccionar los campos mencionados, también puede elegir la opción de asociar datos de comportamiento durante el entrenamiento del modelo. Siempre que los datos de comportamiento cumplan con las condiciones de entrenamiento, se utilizarán para entrenar el modelo.
Procedimiento
Cree un modelo de predicción de categorías en una aplicación.
Aplique el modelo de predicción de categorías: primero, aplique el modelo en el análisis de consultas y luego habilítelo en la clasificación básica y en la clasificación empresarial.
Cree un análisis de consultas, configure la predicción de categorías y seleccione el modelo creado en el paso 1.
Habilite el modelo de predicción de categorías en las consultas: llame a la API de consultas mediante el SDK y pase el parámetro raw_query.
Para consultar el procedimiento detallado, consulte Use the category prediction feature.