La predicción de categorías utiliza un modelo entrenado para asociar una consulta de búsqueda con una categoría de producto y, posteriormente, prioriza los resultados de dicha categoría. Por ejemplo, una consulta como "tenis para correr" se asigna a "Deportes > Calzado", lo que posiciona el calzado deportivo por encima de resultados no relacionados. Una consulta como "mezclilla" se asigna a "Ropa > Pantalones", clasificando los jeans antes que los artículos para el hogar con temática de mezclilla.
Para habilitar la predicción de categorías, complete tres configuraciones: cree y entrene un modelo, configure una regla de análisis de consultas que haga referencia al modelo y agregue una expresión de ordenamiento que invoque a category_score.
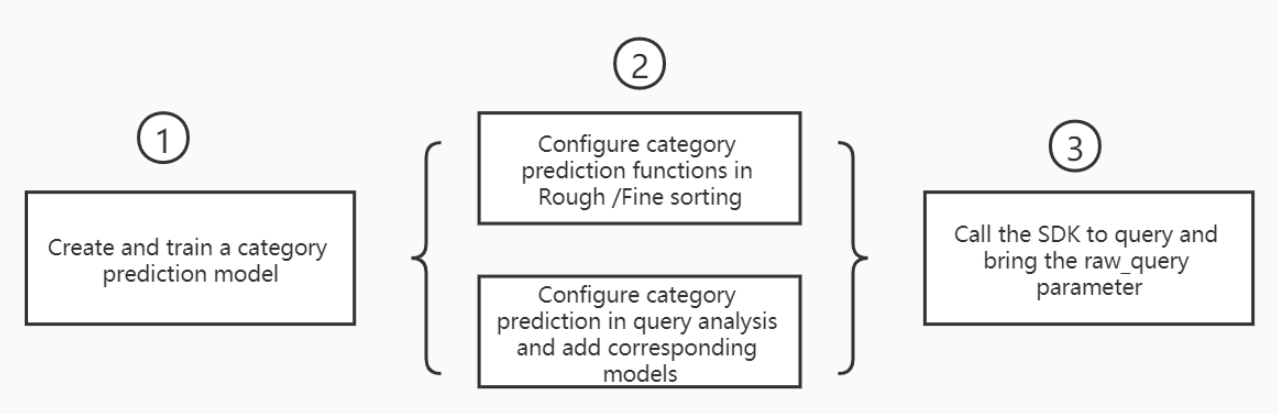
Requisitos previos
Antes de empezar, asegúrese de contar con lo siguiente:
Campos de ID de categoría, título del producto y nombre de categoría configurados como campos de atributo en el esquema de su aplicación.
(Si usa Commodity Data) Datos de documentos que contengan los campos de ID de categoría, título del producto y nombre de categoría.
(Si usa Behavior Data) Datos de comportamiento de clics recopilados mediante data collection.
Creación y entrenamiento de un modelo de predicción de categorías
-
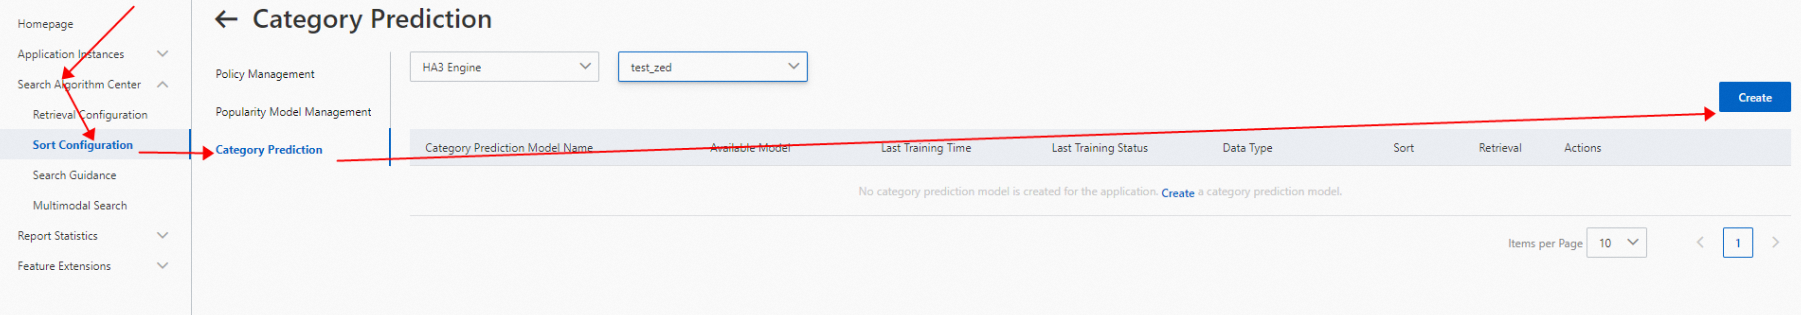
En el panel de navegación izquierdo, seleccione Search Algorithm Center > Sort Configuration. En el árbol de navegación, haga clic en Category Prediction Model y luego en Create.
-
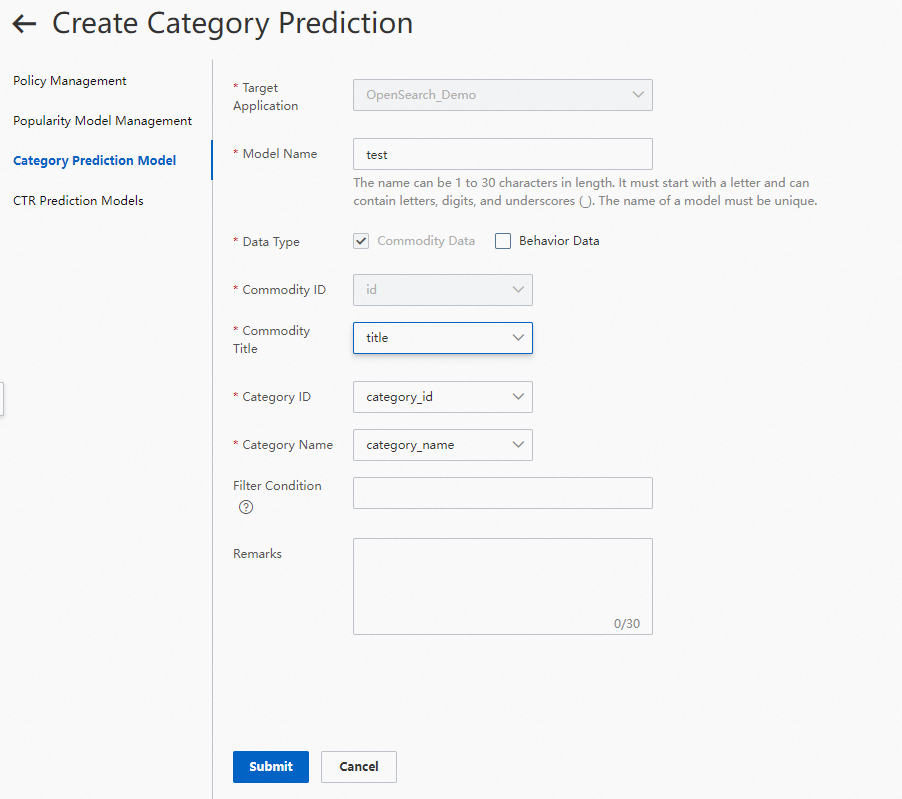
En la página Create Category Prediction, complete los detalles del modelo.
Field
Description
Required
Nombre del modelo
Un nombre para identificar el modelo
Sí
Data Type
Commodity Data: datos de documentos provenientes de su aplicación. Requiere los campos de ID de categoría, título del producto y nombre de categoría. Behavior Data: datos de comportamiento de clics recopilados.
Sí
Category ID
Campo que representa el ID de categoría en los documentos de su aplicación. Admite el tipo de datos INT. Debe ser un entero positivo; un valor no positivo provoca un error en el servidor.
Sí
Commodity Title
Campo que representa el título del producto. Admite los tipos de datos TEXT y LITERAL.
Sí
Category Name
Campo que representa el nombre de la categoría. Admite los tipos de datos TEXT y LITERAL.
Sí
Filter Condition
Condición para filtrar los datos de entrenamiento. Los nombres de los campos deben coincidir con los del esquema de la aplicación. Operadores compatibles:
<,>,<=,>=,=,!=. Separe varias condiciones con comas (,); todas las condiciones utilizan lógica AND. No se admite la lógica OR. Ejemplo:is_onsale > 0No
-
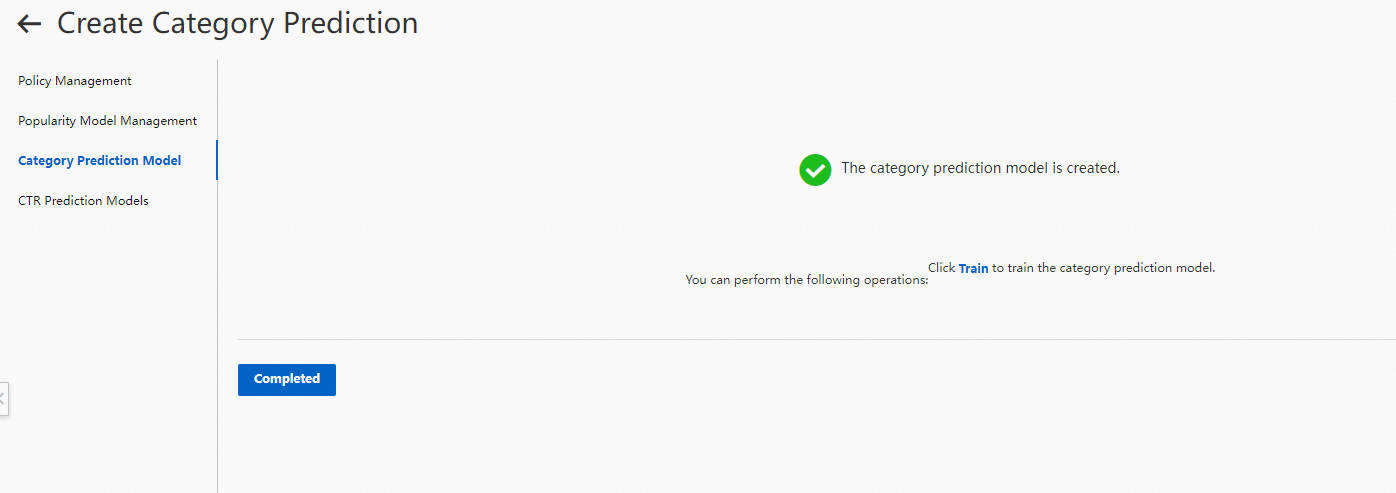
Haga clic en Completed para ir a la página de detalles del modelo.
-
En la página Category Prediction Model, el estado del modelo será Pending Training. Haga clic en Train en la columna Actions para iniciar el entrenamiento.
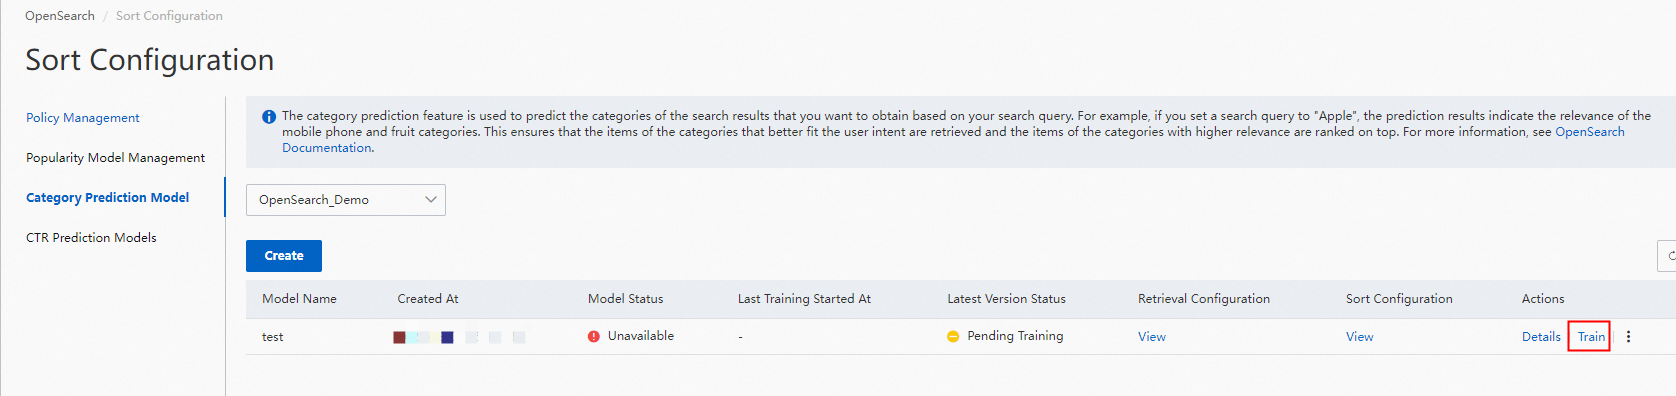
El modelo pasa por los siguientes estados:
State
Meaning
Pending Training
Modelo creado, entrenamiento no iniciado
Training
El modelo se está entrenando
Training Failed
El entrenamiento falló debido a un error en los datos
Not Applied
Entrenamiento completado, aún no se ha referenciado para recuperación u ordenamiento
Trained and Not Passed
Entrenamiento completado, pero el modelo no pasó la validación del entrenamiento
Si tiene dudas, envíe un ticket de soporte.
Configuración del análisis de consultas y las expresiones de ordenamiento
Creación de una regla de análisis de consultas
-
En el panel de navegación izquierdo, seleccione Search Algorithm Center > Retrieval Configuration. En el árbol de navegación, haga clic en Query Analysis Rule Configuration y luego en Create.

-
Configure la regla de análisis de consultas y guárdela.
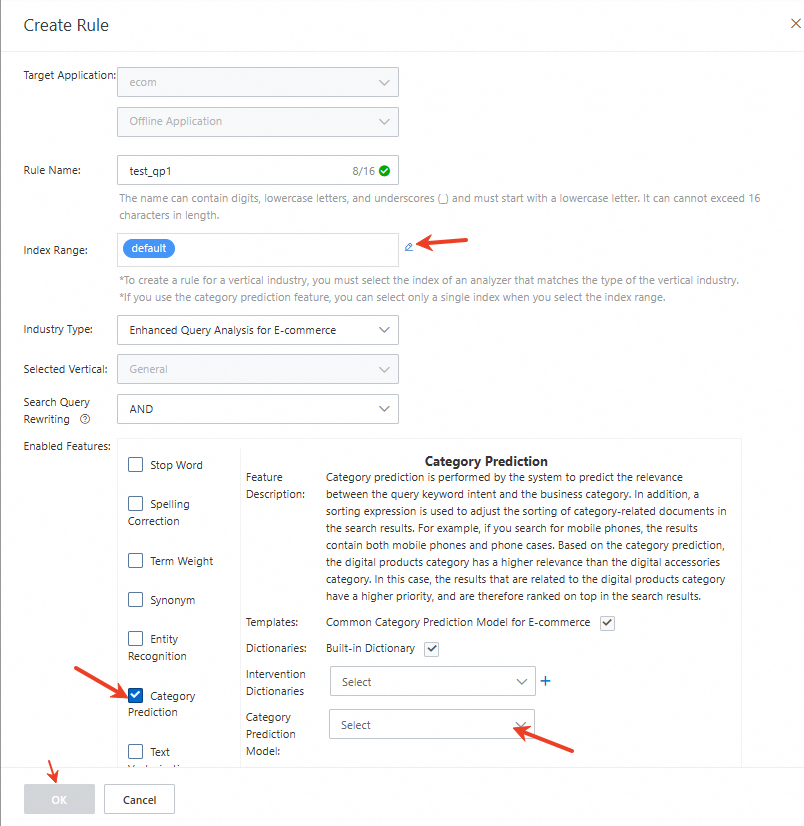
Aplicación del modelo al ordenamiento preliminar
El ordenamiento preliminar es la primera ronda de clasificación.
-
En el panel de navegación izquierdo, seleccione Search Algorithm Center > Sort Configuration. En la página Policy Management, haga clic en Create.
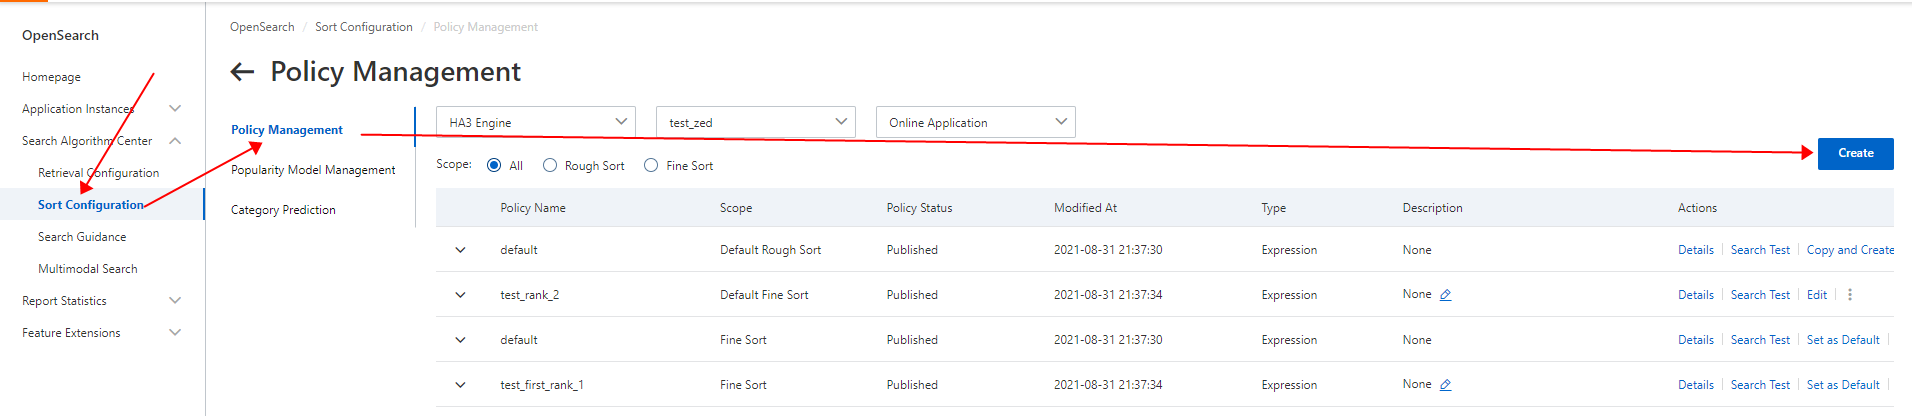
-
En la página Create Policy, introduzca un nombre para la política. Establezca Scope en Rough Sort y Type en Expression. La consola solo admite expresiones. Los complementos personalizados serán compatibles más adelante.

-
En el paso Sort Configuration, seleccione
category_score()en la lista desplegable Scoring Characteristics.
-
Seleccione un campo, establezca el peso y guarde la configuración.
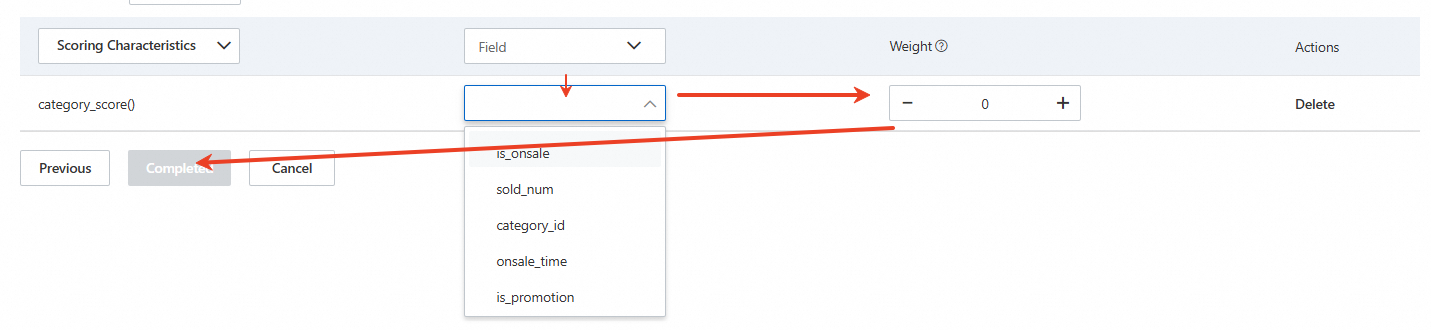
Aplicación del modelo al ordenamiento fino
El ordenamiento fino es la segunda ronda de clasificación.
-
En la página Create Policy, introduzca un nombre para la política. Establezca Scope en Fine Sort y Type en Expression. La consola solo admite expresiones. Los complementos personalizados serán compatibles más adelante.

-
En el paso Sort Configuration, seleccione
category_score(cate_id_field)en la lista desplegable Built-in Functions.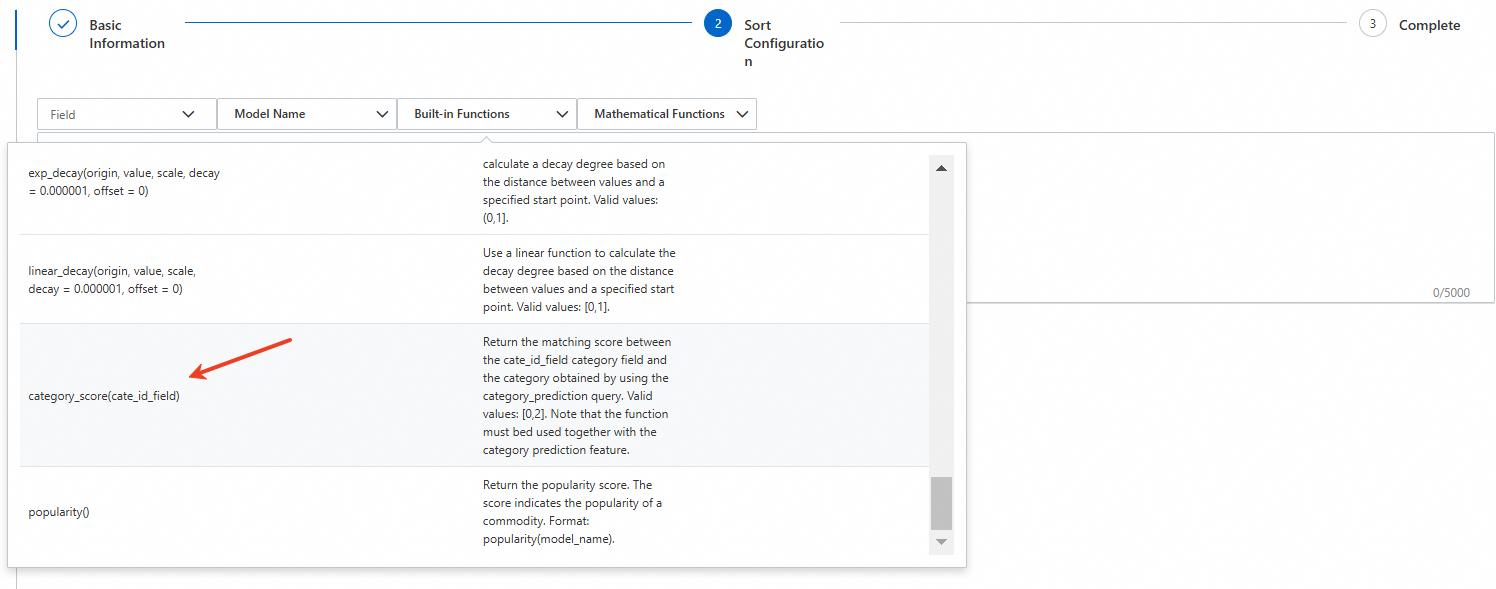
-
Reemplace
cate_id_fieldcon el ID de categoría de su modelo y guarde la configuración.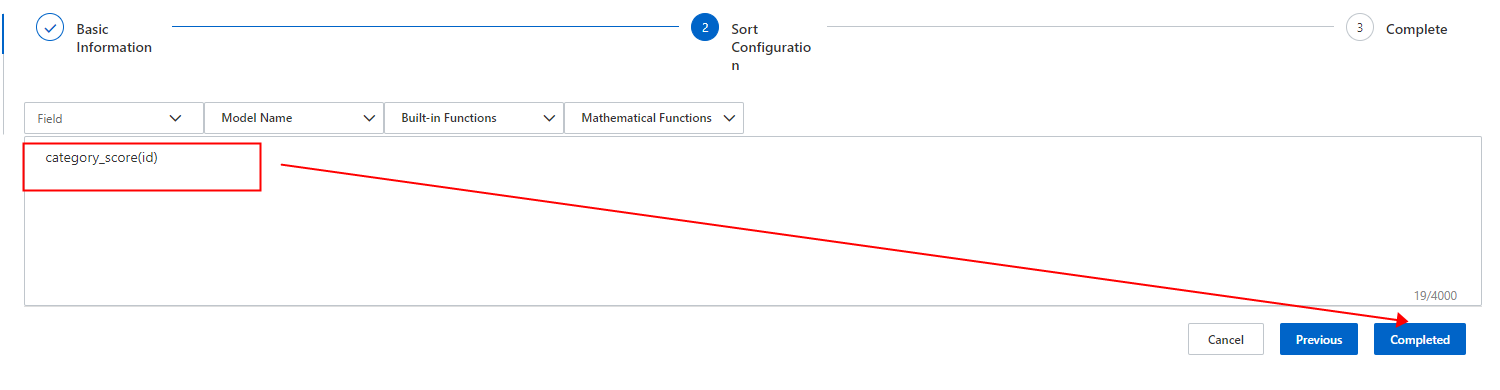
Compruebe el estado del modelo después de que la política de ordenamiento lo referencie.
-
Ejecute una prueba de búsqueda en la aplicación. Establezca el parámetro
raw_querycon una consulta de búsqueda para probar los resultados de la predicción de categorías.
Activación de la predicción de categorías en llamadas de API y SDK
La predicción de categorías ordena los resultados de búsqueda únicamente cuando el parámetro raw_query está presente y su valor coincide con la consulta de búsqueda en el índice.
Establezca raw_query con la consulta de búsqueda introducida por el usuario:
raw_query=<search_query>Al llamar mediante API: codifique el valor mediante
URL_ENCODE.Al llamar mediante SDK: no se requiere codificación.
Cuándo entra en vigor la predicción de categorías
La siguiente tabla muestra cuándo se aplica la predicción de categorías según la configuración del índice y el valor de raw_query.
|
Index configuration |
|
|
Category prediction applies? |
|
Deshabilitado |
Sí |
— |
No |
|
Deshabilitado |
No |
— |
No |
|
Habilitado |
No |
— |
No |
|
Habilitado |
Sí |
No |
No |
|
Habilitado |
Sí |
Sí |
Sí |
Comportamiento con múltiples índices: Si una solicitud abarca varios índices, la predicción de categorías se aplica a cada índice individualmente según las reglas anteriores.
# index3 prediction takes effect (query matches raw_query for index3 only)
query=index2:'index_query' AND index3:'search_query'&raw_query=search_query

# index2 prediction takes effect preferentially;
# if index2 config doesn't apply, index3 takes effect
query=index2:'search_query' AND index3:'search_query'&raw_query=search_query
Límites
Se pueden crear hasta cinco modelos de predicción de categorías por aplicación.
Los campos de datos utilizados para entrenar el modelo deben incluirse en los índices donde se aplique la regla de análisis de consultas.
Antes de crear un modelo, configure el ID de categoría y los campos relacionados como campos de atributo.
Si una regla de análisis de consultas hace referencia a un modelo de predicción de categorías y la solicitud contiene el parámetro
category_prediction, se produce un error.Para que la predicción de categorías surta efecto, deben configurarse estos tres elementos: una regla de análisis de consultas que referencie el modelo, una expresión de ordenamiento que contenga la función
category_scorey el parámetroraw_queryen la solicitud.Operaciones de API relacionadas: Algorithms
Solución de problemas de fallos en el entrenamiento del modelo
Si el entrenamiento de su modelo de predicción de categorías falla, siga estos pasos para solucionar el problema:
Revise el informe de anomalías: En la página de detalles del modelo, consulte Latest Version Status. Si el estado indica un error de datos, abra Anomaly Report para identificar la causa del fallo.
Verifique el nivel de integridad: Consulte Completeness Level y las Upgrade Conditions correspondientes. Ajuste sus datos según las condiciones de actualización para mejorar el nivel de integridad.
Lógica de datos T-1: El entrenamiento del modelo utiliza datos estadísticos del día anterior (T-1). Cuando un modelo recién creado se entrena por primera vez, el proceso puede fallar con el error "Training field does not exist" porque no hay datos disponibles del día previo. Espere hasta el día siguiente, cuando los datos estén listos, y vuelva a entrenar el modelo.
Requisito de volumen de datos: El entrenamiento requiere que el número de consultas únicas del día más reciente supere las 100. El conteo de consultas únicas se refiere al número de solicitudes de búsqueda exitosas que incluyen el parámetro
raw_query.Formato de condición de filtro: Si se configuran condiciones de filtro, los nombres de los campos deben coincidir con los campos del esquema de la aplicación. Las condiciones múltiples usan lógica AND y deben separarse con comas (
,). Un formato incorrecto puede provocar fallos en el entrenamiento. Ejemplo:is_onsale > 0.
Uso avanzado
Combinación con reconocimiento de entidades nombradas (NER)
Si configura NER junto con la predicción de categorías en una regla de análisis de consultas, se recuperarán más documentos. Los resultados de NER también se utilizan para la recuperación. Si ningún documento coincide con las categorías predichas, se ignoran selectivamente palabras de la consulta de búsqueda para ampliar los resultados; estos resultados más amplios se convierten en la salida final de la predicción de categorías. Para obtener más información, consulte Reconocimiento de entidades nombradas.
Intervención en los resultados de predicción
La intervención le permite anular las predicciones del modelo entrenado, de forma similar a la intervención en el análisis de consultas. Para obtener más información, consulte Intervention dictionaries for category prediction.