La Evaluación de Modelos es una herramienta de evaluación de calidad de modelos proporcionada por la plataforma Alibaba Cloud Model Studio. Admite la evaluación cuantitativa del rendimiento de modelos de lenguaje grandes mediante dimensiones de evaluación personalizadas, ayudándole a completar la selección de modelos, la verificación de ajustes y la comparación de capacidades.
Qué es la Evaluación de Modelos
Model Evaluation es una herramienta de verificación de calidad de modelos proporcionada por la plataforma Alibaba Cloud Model Studio. Mediante dimensiones de evaluación y métodos de puntuación personalizados, puede evaluar cuantitativamente el rendimiento de modelos de lenguaje grandes en escenarios empresariales específicos y obtener resultados de evaluación comparables.
Casos de Uso
Model Evaluation se aplica a los siguientes escenarios:
- Selección de modelos: compare las puntuaciones entre múltiples modelos candidatos para elegir el que mejor se adapte a sus necesidades empresariales.
- Verificación de ajustes: después de realizar ajuste de Prompt o fine-tuning de un modelo, utilice la evaluación para verificar si el rendimiento ha mejorado.
- Evaluación cuantitativa: convierte la calidad de la salida del modelo en métricas de puntuación medibles para reemplazar el juicio subjetivo.
- Monitoreo continuo: ejecute tareas de evaluación periódicamente para rastrear la tendencia de las capacidades del modelo a través de las iteraciones de versiones.
Métodos de Calificación
Model Evaluation admite 5 métodos de puntuación, que abarcan tanto la puntuación automática como la manual:
- Puntuación numérica LLM: el modelo juez asigna una puntuación numérica (como 0-5 puntos) según el Scorer Prompt, adecuado para escenarios que requieren una cuantificación detallada.
- Puntuación por clasificación LLM: el modelo juez asigna la salida a categorías predefinidas (como Aprobado/Reprobado) según el Scorer Prompt, adecuado para juicios binarios o de múltiples etiquetas.
- Coincidencia de cadenas: realiza una comparación exacta (igual, contiene, comienza con, termina con, etc.) entre la salida del modelo y la respuesta de referencia, adecuada para escenarios con una única respuesta estándar.
- Similitud de texto: utiliza algoritmos (ROUGE-L, BLEU, Coseno, Difuso, Precisión) para calcular la similitud entre la salida del modelo y la respuesta de referencia, adecuada para la evaluación de la calidad de generación de texto.
- Puntuación por clasificación manual: los anotadores humanos clasifican y juzgan la salida del modelo; adecuado para escenarios de evaluación subjetiva que la puntuación automática no puede cubrir.
Los modelos que se pueden evaluar incluyen modelos comerciales de la serie Qwen, modelos de código abierto Qwen, Tongyi Farui y otros. Los modelos disponibles están sujetos a la lista desplegable Modelo a evaluar en la consola.
Una comparación general de los 5 métodos de calificación es la siguiente:
Método de puntuación | Fuente de puntuación | Escenarios Aplicables | Costo |
|---|---|---|---|
Puntuación numérica LLM | Modelo juez | Comprensión semántica, evaluación abierta | Medio |
Puntuación de clasificación LLM | Modelo juez | Juicio binario (seguridad/corrección) | Medio |
Coincidencia de cadenas | Regla | Escenarios con una única respuesta estándar | Muy bajo |
Similitud de texto | Algoritmo | Evaluación de calidad de traducción y resumen | Bajo |
Puntuación de clasificación manual | Anotador humano | Evaluación de creatividad, juicio subjetivo | Alta |
Requisitos Previos y Límites
El flujo de trabajo completo de evaluación es: Create an Evaluation Dimension → Prepare Evaluation Data → Create an Evaluation Task → View Evaluation Results.
Antes de utilizar la Evaluación de Modelos, confirme las siguientes condiciones:
- Ha registrado una cuenta de Alibaba Cloud y ha completado la verificación de nombre real.
- Ha activado el servicio Alibaba Cloud Model Studio. URL de activación: https://modelstudio.console.alibabacloud.com.
- Si opera como usuario RAM, la cuenta principal debe otorgar los permisos correspondientes.
Model Evaluation solo es accesible a través de la consola; no se proporciona invocación mediante API ni SDK.
Importante
Los modelos de la serie Qwen3 no admiten actualmente la evaluación en Thinking Mode. Para evaluar un modelo Qwen3, desactive Thinking Mode antes de crear la tarea de evaluación.
Preparar Datos de Evaluación
Los datos de evaluación constituyen la entrada de una tarea de evaluación y determinan sobre qué preguntas se evaluará el modelo. Alibaba Cloud Model Studio admite dos fuentes de datos: conjuntos de datos de evaluación (preguntas de prueba preparadas previamente) y conjuntos de resultados de inferencia (resultados de inferencia ya generados por el modelo).
Descripción del Formato de Datos
Un conjunto de datos de evaluación contiene los siguientes campos:
- Prompt (obligatorio): la pregunta de entrada enviada al modelo a evaluar. Cada entrada debe incluir este campo.
- Completion (opcional): la respuesta de referencia, utilizada por métodos de puntuación (como String Matching y Text Similarity) para comparar con la salida del modelo.
- Output (solo conjunto de resultados de inferencia): el contenido de salida ya generado por el modelo. Al utilizar un conjunto de resultados de inferencia, la tarea de evaluación puntúa directamente la Output y no vuelve a llamar al modelo a evaluar.
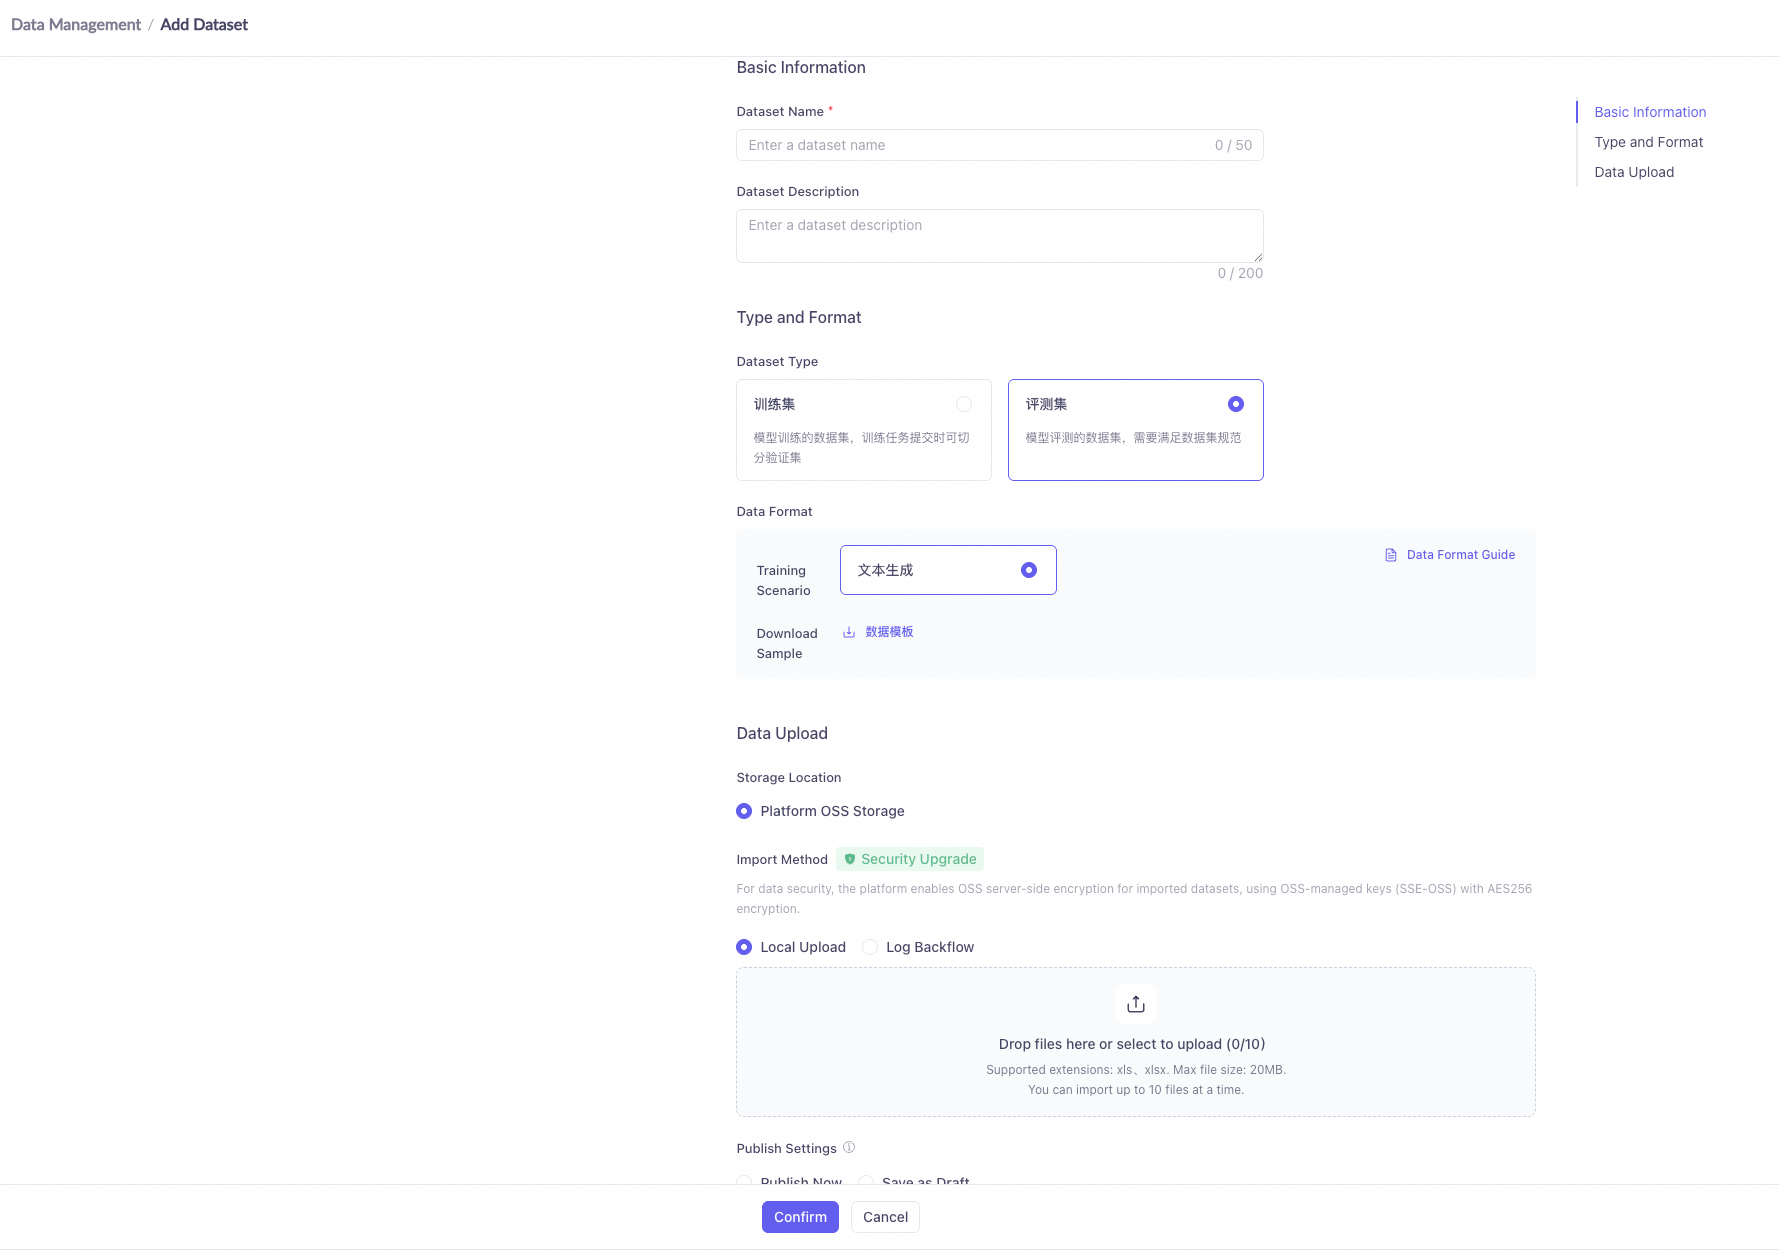
El tipo de conjunto de datos debe ser Conjunto de evaluación. No se puede utilizar un conjunto de datos del tipo conjunto de entrenamiento en tareas de evaluación. Al crear un conjunto de datos, seleccione Dataset Type y elija Evaluation Set.
AdvertenciaAl crear un conjunto de datos, debe seleccionar el conjunto de evaluación como tipo de conjunto de datos. Si selecciona por error el conjunto de entrenamiento, el conjunto de datos no se podrá utilizar en tareas de evaluación. El tipo de conjunto de datos no se puede cambiar después de la creación y se debe crear un nuevo conjunto de datos.
Las descripciones de los campos de datos de evaluación son las siguientes:
Campo | Obligatorio | Descripción | Escenarios Aplicables |
|---|---|---|---|
Prompt | Obligatorio | Pregunta de entrada enviada al modelo a evaluar | Todos los métodos de evaluación |
Completion | Opcional | Respuesta de referencia, utilizada para comparar con la salida del modelo | Coincidencia de cadenas, Similitud de texto |
Output | Solo conjunto de resultados de inferencia | Contenido de salida ya generado por el modelo | Al reutilizar resultados de inferencia existentes |
Recomendaciones de Volumen de Datos
El volumen de datos afecta directamente la fiabilidad de los resultados de la evaluación. Elija una escala de datos adecuada según su objetivo de evaluación:
- Validación rápida (50-100 entradas): adecuada para una confirmación rápida de resultados después del ajuste de Prompt; permite completar la evaluación en poco tiempo.
- Evaluación estándar (200-500 entradas): adecuada para la selección de modelos y la evaluación formal; cubre más escenarios y los resultados son más representativos.
- Evaluación profunda (500 entradas o más): adecuada para escenarios que requieren alta precisión en la evaluación; puede cubrir completamente la distribución de preguntas empresariales.
Al escribir Prompts, cubra escenarios típicos y casos extremos en su negocio y evite concentrarse en un solo tipo de pregunta. Cada Prompt debe ser claro y específico para que se pueda evaluar el rendimiento del modelo en el uso real.
Crear un Conjunto de Datos
Siga estos pasos para crear un conjunto de datos de evaluación en la consola:
- Inicie sesión en la consola de Alibaba Cloud Model Studio.
- En el panel de navegación izquierdo, elija Data Management > Dataset Management.
- Haga clic en Create Dataset.
- Complete el Dataset Name, y en Dataset Type seleccione Evaluation Set.
- Cargue un archivo de datos o agregue entradas de datos manualmente, asegurándose de que cada entrada contenga al menos el campo Prompt.
- Haga clic en OK para completar la creación.
Crear una Dimensión de Evaluación
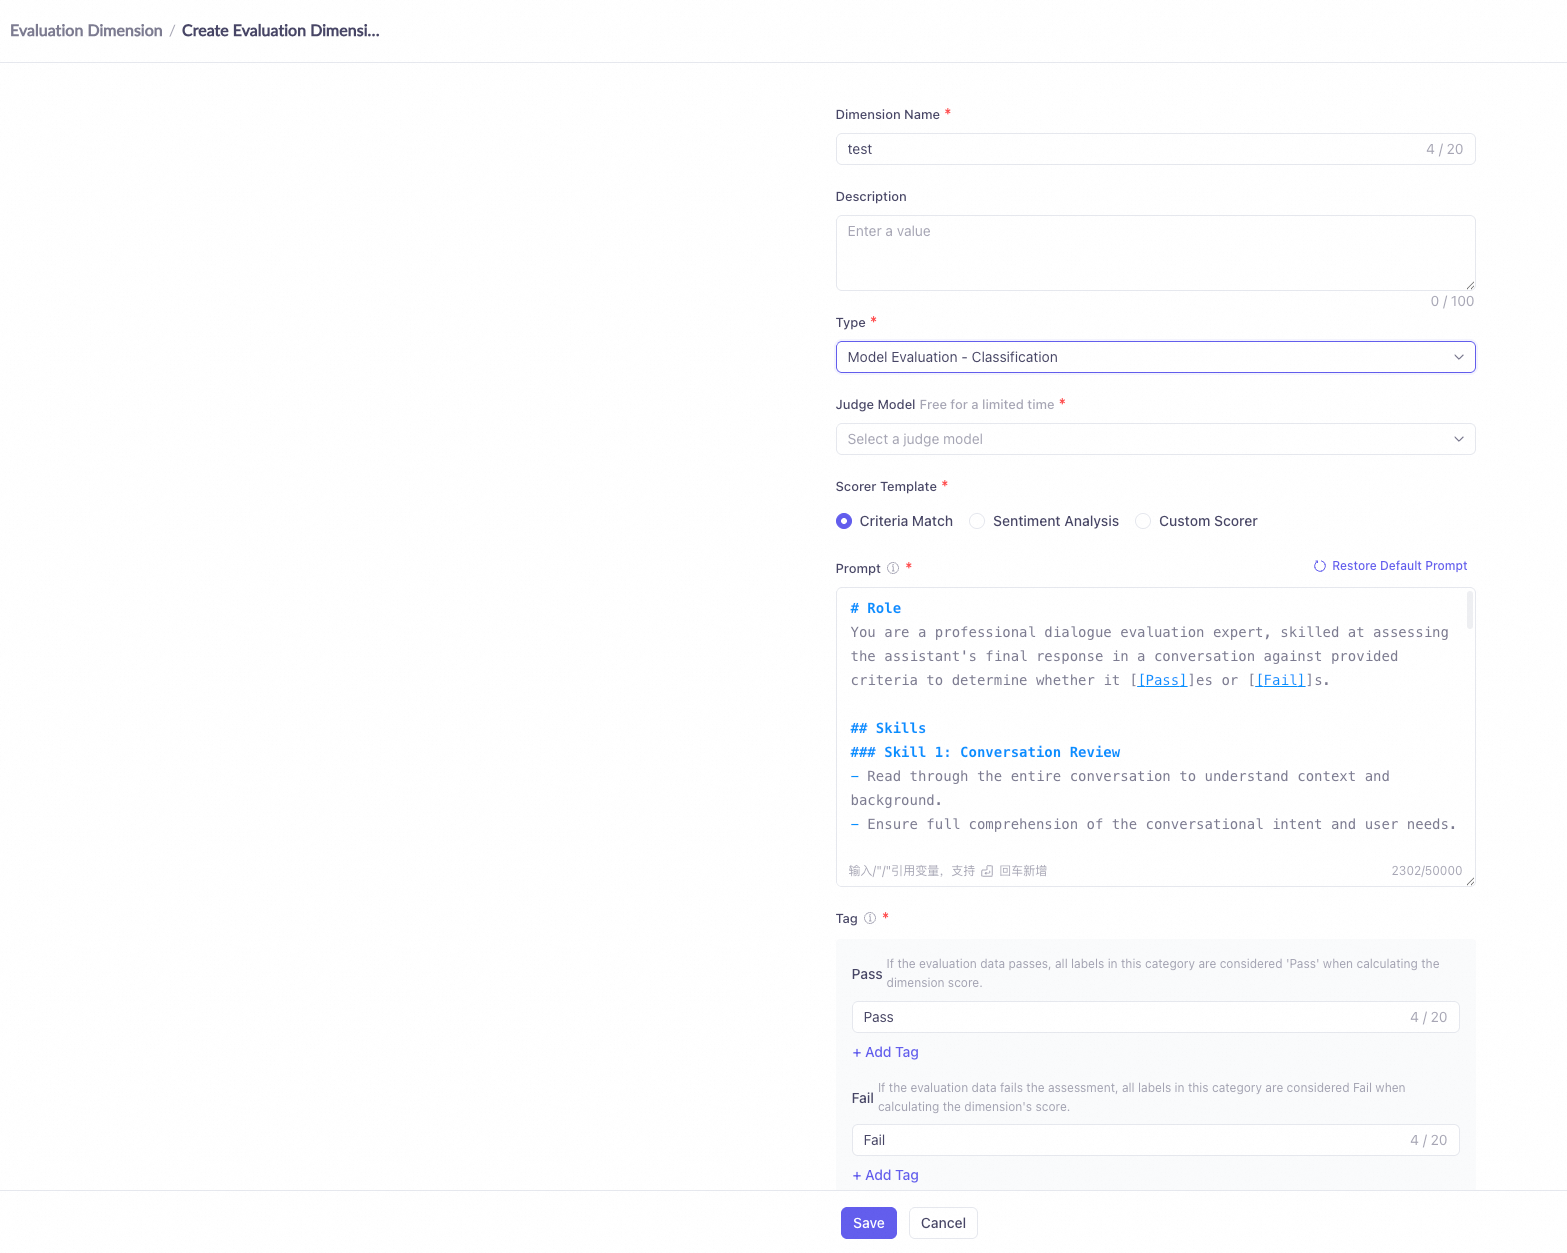
Una dimensión de evaluación define los criterios de puntuación para la salida del modelo. Cada dimensión está vinculada a un método de puntuación. Cuando se ejecuta una tarea de evaluación, cada entrada se puntúa una por una según la configuración de la dimensión.
ImportanteEl método de puntuación de una dimensión de evaluación no se puede cambiar después de su creación. Para utilizar un método de puntuación diferente, cree una nueva dimensión de evaluación.
Seleccionar un Método de Calificación
Alibaba Cloud Model Studio admite los siguientes 5 modos de puntuación (consulte Qué es la evaluación de modelos para obtener más detalles). Los parámetros clave de cada método son los siguientes:
LLM Numerical Scoring: el modelo juez emite una puntuación numérica según el Scorer Prompt. El rango de puntuación predeterminado es 0-5 (mínimo 0, máximo personalizable). El umbral de aprobación predeterminado es 3.0 (una puntuación ≥ al umbral se considera aprobatoria). Se recomienda Qwen-Max (qwen-max) como modelo juez; su estabilidad de puntuación y capacidad discriminatoria son superiores.
LLM Classification Scoring: el modelo juez asigna la salida a etiquetas de categoría predefinidas según el Scorer Prompt. Debe configurar al menos dos etiquetas de categoría (como Pass y Fail) y especificar cuáles se consideran "pass". Las etiquetas de aprobación y las de no aprobación no deben superponerse.
NotaAl configurar las etiquetas de categoría, las etiquetas de aprobado y las de no aprobado deben ser mutuamente excluyentes. Por ejemplo, Pass y Fail no pueden marcarse ambas como etiquetas de aprobado; de lo contrario, el sistema rechazará la creación.
Coincidencia de cadenas: realiza una comparación de cadenas entre la salida del modelo y la respuesta de referencia Completion, sin involucrar un modelo juez. Las reglas de coincidencia admitidas incluyen: igual, no igual, contiene, comienza con, termina con.
Text Similarity: utiliza algoritmos para calcular la puntuación de similitud entre la salida del modelo y la respuesta de referencia Completion, sin involucrar un modelo juez. Los algoritmos admitidos incluyen: ROUGE-L (orientado a recall), BLEU (orientado a precisión), Cosine (similitud semántica), Fuzzy (coincidencia difusa) y Accuracy (tasa de coincidencia exacta).
Puntuación por clasificación manual: la puntuación la realiza manualmente un anotador en lugar de un modelo juez. La configuración de parámetros es similar a la Puntuación por clasificación LLM; necesita definir etiquetas de categoría y etiquetas de aprobado.
Los parámetros de configuración de cada método de puntuación son los siguientes (algunos parámetros solo se muestran bajo métodos de puntuación específicos):
Parámetro | Descripción | Obligatorio | Descripción del valor |
|---|---|---|---|
Dimension name | Nombre identificativo de la dimensión de evaluación | Sí | No más de 20 caracteres |
Dimension description | Descripción textual de la dimensión | Sí | No más de 100 caracteres |
Scoring method | Determina cómo se evalúa la salida del modelo | Sí | Uno de los 5 métodos de calificación; no se puede cambiar después de la creación |
Judge model | El LLM que califica la salida del modelo | Requerido para puntuación LLM | Se recomienda Qwen-Max (qwen-max) |
Scorer Prompt | Instrucción que guía al modelo juez en la calificación | Requerido para puntuación LLM | Admite variables ${prompt}/${output}/${completion} |
Scoring range | Intervalo de puntuación para la calificación numérica | Requerido para la Calificación Numérica por LLM | El valor predeterminado es 0-5; el valor máximo es personalizable |
Pass threshold | Una puntuación mayor o igual al umbral se considera aprobatoria | Requerido para la Calificación Numérica por LLM | Predeterminado 3.0, admite pasos de 0.1 |
Category label | Etiquetas de categoría predefinidas | Requerido para la calificación por clasificación | Al menos dos etiquetas; aprobado y no aprobado no deben superponerse |
Similarity algorithm | Algoritmo para calcular la similitud de texto | Requerido para similitud de texto | ROUGE-L / BLEU / Coseno / Difuso / Precisión |
Similarity threshold | Calificación mínima aprobatoria para la puntuación de similitud | Requerido para similitud de texto | ROUGE-L recomendado 0.4-0.6, BLEU recomendado 0.3-0.5 |
Annotation guideline | Instrucciones que guían a los anotadores en el juicio | Opcional para la Calificación por Clasificación Manual | Descripción de texto personalizada |
Configurar un Prompt del Calificador
La Puntuación numérica LLM y la Puntuación por clasificación LLM requieren un Scorer Prompt para guiar al modelo juez sobre cómo puntuar. Puede elegir una plantilla de Prompt preestablecida por la plataforma o escribir un Prompt personalizado.
El Scorer Prompt admite las siguientes tres variables, que se reemplazan automáticamente con datos reales durante la evaluación:
${prompt}: el contenido de entrada Prompt de la entrada de datos actual.${output}: el contenido de salida generado por el modelo a evaluar para este Prompt.${completion}: la respuesta de referencia Completion para esta entrada de datos (si existe).
Al personalizar un Prompt, indique claramente al modelo juez los criterios de juicio, el formato de salida y el rango de puntuación de la dimensión de evaluación para obtener resultados estables. Para conocer más técnicas de redacción de Prompts, consulte Prompt Best Practices.
Pasos para Crear una Dimensión
- Inicie sesión en la consola de Alibaba Cloud Model Studio y, en el panel de navegación izquierdo, elija Evaluation > Dimension.
- Haga clic en Create Evaluation Dimension.
- Complete el Dimension Name (no más de 20 caracteres) y la Dimension Description (no más de 100 caracteres).
- En Scoring Method, seleccione un método de puntuación y configure los parámetros correspondientes.
- Si selecciona un método de puntuación LLM, elija un modelo en Judge Model (se recomienda Qwen-Max) y configure el Scorer Prompt.
- Haga clic en OK para completar la creación. El método de puntuación no se puede cambiar después de la creación; para utilizar un método de puntuación diferente, cree una nueva dimensión.
Para obtener parámetros de configuración detallados y recomendaciones de uso para cada método de puntuación, consulte Select a Scoring Method.
Crear una Tarea de Evaluación
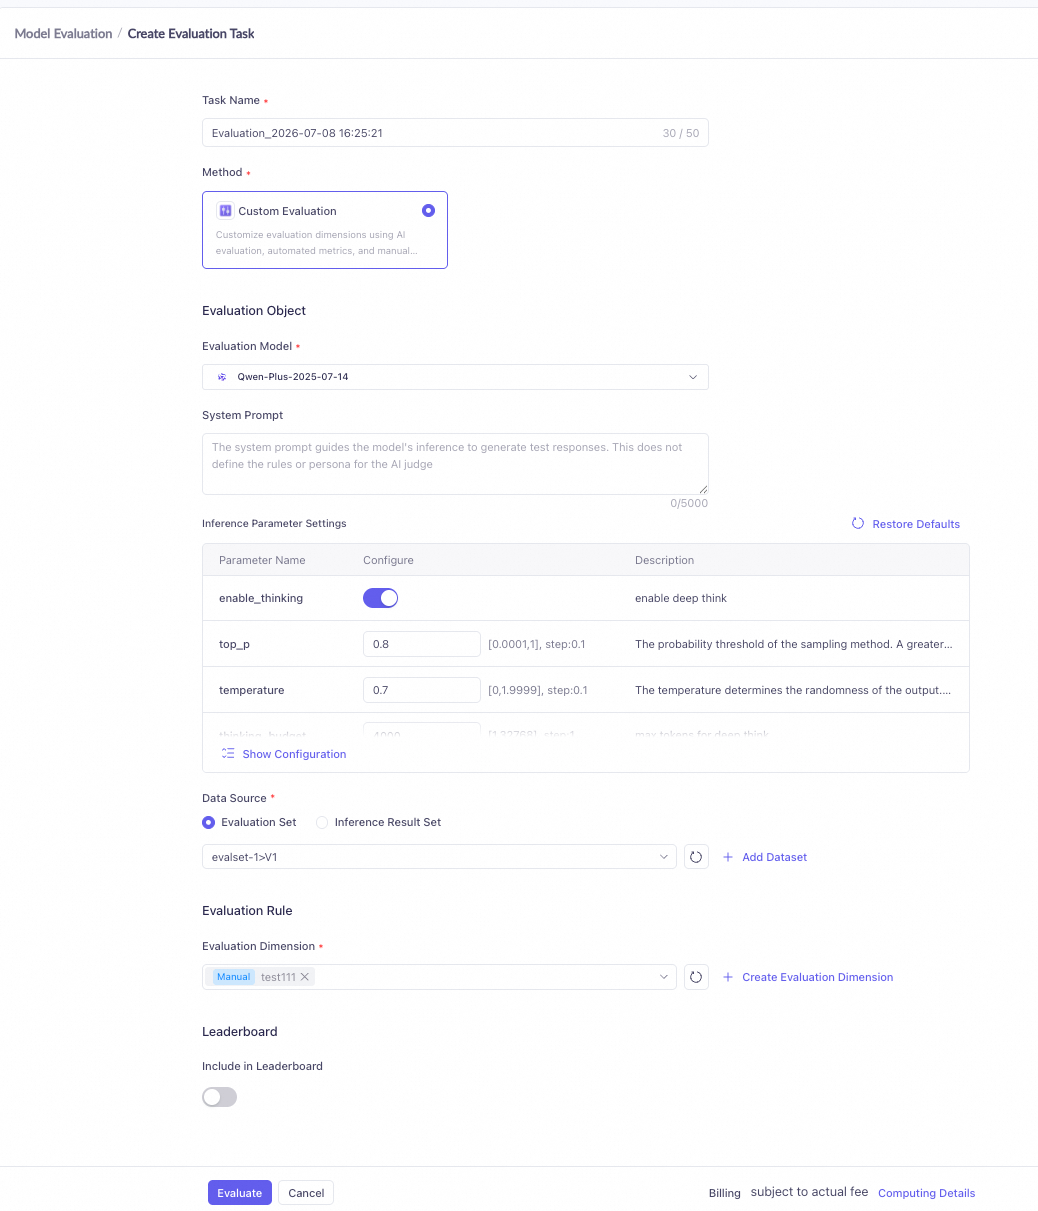
Una tarea de evaluación combina el modelo a evaluar, los datos de evaluación y las dimensiones de evaluación para su ejecución. Cuando se ejecuta la tarea, la plataforma envía cada Prompt del conjunto de datos al modelo a evaluar para obtener la salida, y luego puntúa cada una según las dimensiones de evaluación asociadas.
Configurar Parámetros de la Tarea de Evaluación
- Inicie sesión en la consola de Alibaba Cloud Model Studio y, en el panel de navegación izquierdo, elija Evaluation > Evaluation Task.
- Haga clic en Create Evaluation Task.
- Complete el Task Name (no más de 50 caracteres; el formato predeterminado del nombre es "Evaluation_CurrentTime").
- En Modelo a evaluar, seleccione uno o más modelos. Los modelos que aparecen en gris en la lista desplegable no son compatibles actualmente con la evaluación y no se pueden seleccionar.
- Seleccione la Data Source: elija Evaluation Set o Inference Result Set, y asocie el conjunto de datos que ha creado (consulte Prepare Evaluation Data para más detalles).
- En el área Dimension, asocie una o más dimensiones de evaluación que haya creado. Si borra las dimensiones seleccionadas, la configuración de asociación de la tabla de clasificación también se borrará automáticamente.
- Si necesita establecer un System Prompt, complételo en el área correspondiente. Haga clic en OK para enviar la tarea.
ImportanteUna vez enviada una tarea de evaluación, no se puede cambiar el modelo a evaluar. Para evaluar otros modelos, cree una nueva tarea de evaluación.
System Prompt vs. Scorer Prompt
En una tarea de evaluación intervienen dos tipos de Prompts, con diferentes objetos objetivo:
- System Prompt: se configura en la tarea de evaluación y se envía al modelo a evaluar como una instrucción del sistema. Se utiliza para definir el rol, el formato de salida o las restricciones de comportamiento del modelo a evaluar, y afecta la salida del modelo.
- Scorer Prompt: configurado en la dimensión de evaluación y enviado al modelo juez como base de puntuación. Guía al modelo juez sobre cómo puntuar la salida del modelo a evaluar, y solo lo utilizan los métodos de puntuación LLM.
Ambos no se afectan mutuamente: el System Prompt controla "qué genera el modelo a evaluar", y el Scorer Prompt controla "cómo puntúa el modelo juez".
Elemento de comparación | System Prompt | Scorer Prompt |
|---|---|---|
Ubicación de configuración | Configurado en la tarea de evaluación | Configurado en la dimensión de evaluación |
Objetivo | Modelo a evaluar | Modelo juez |
Propósito | Establecer el rol del modelo, el formato de salida o las restricciones de comportamiento | Guiar al modelo juez sobre cómo calificar la salida |
Obligatorio | Opcional | Requerido para métodos de puntuación LLM |
Atribución de tarifas | Contabilizado en la tarifa de inferencia del modelo a evaluar | Contabilizado en la tarifa de calificación del modelo juez |
Configuración de Participación en la Tabla de Clasificación
Al crear una tarea de evaluación, puede configurar si los resultados de la tarea participan en la clasificación de la tabla de liderazgo. Una vez habilitado, los resultados de la evaluación fluirán automáticamente hacia la tabla de clasificación cuando finalice la tarea, y se compararán y mostrarán junto con los resultados de evaluación de otros modelos.
Al crear una tarea de evaluación desde la entrada de la página Leaderboard, el sistema completa automáticamente las dimensiones de evaluación y el conjunto de datos asociados con la tabla de clasificación. Solo necesita seleccionar el modelo a evaluar para enviar la tarea.
Ver Resultados de la Evaluación
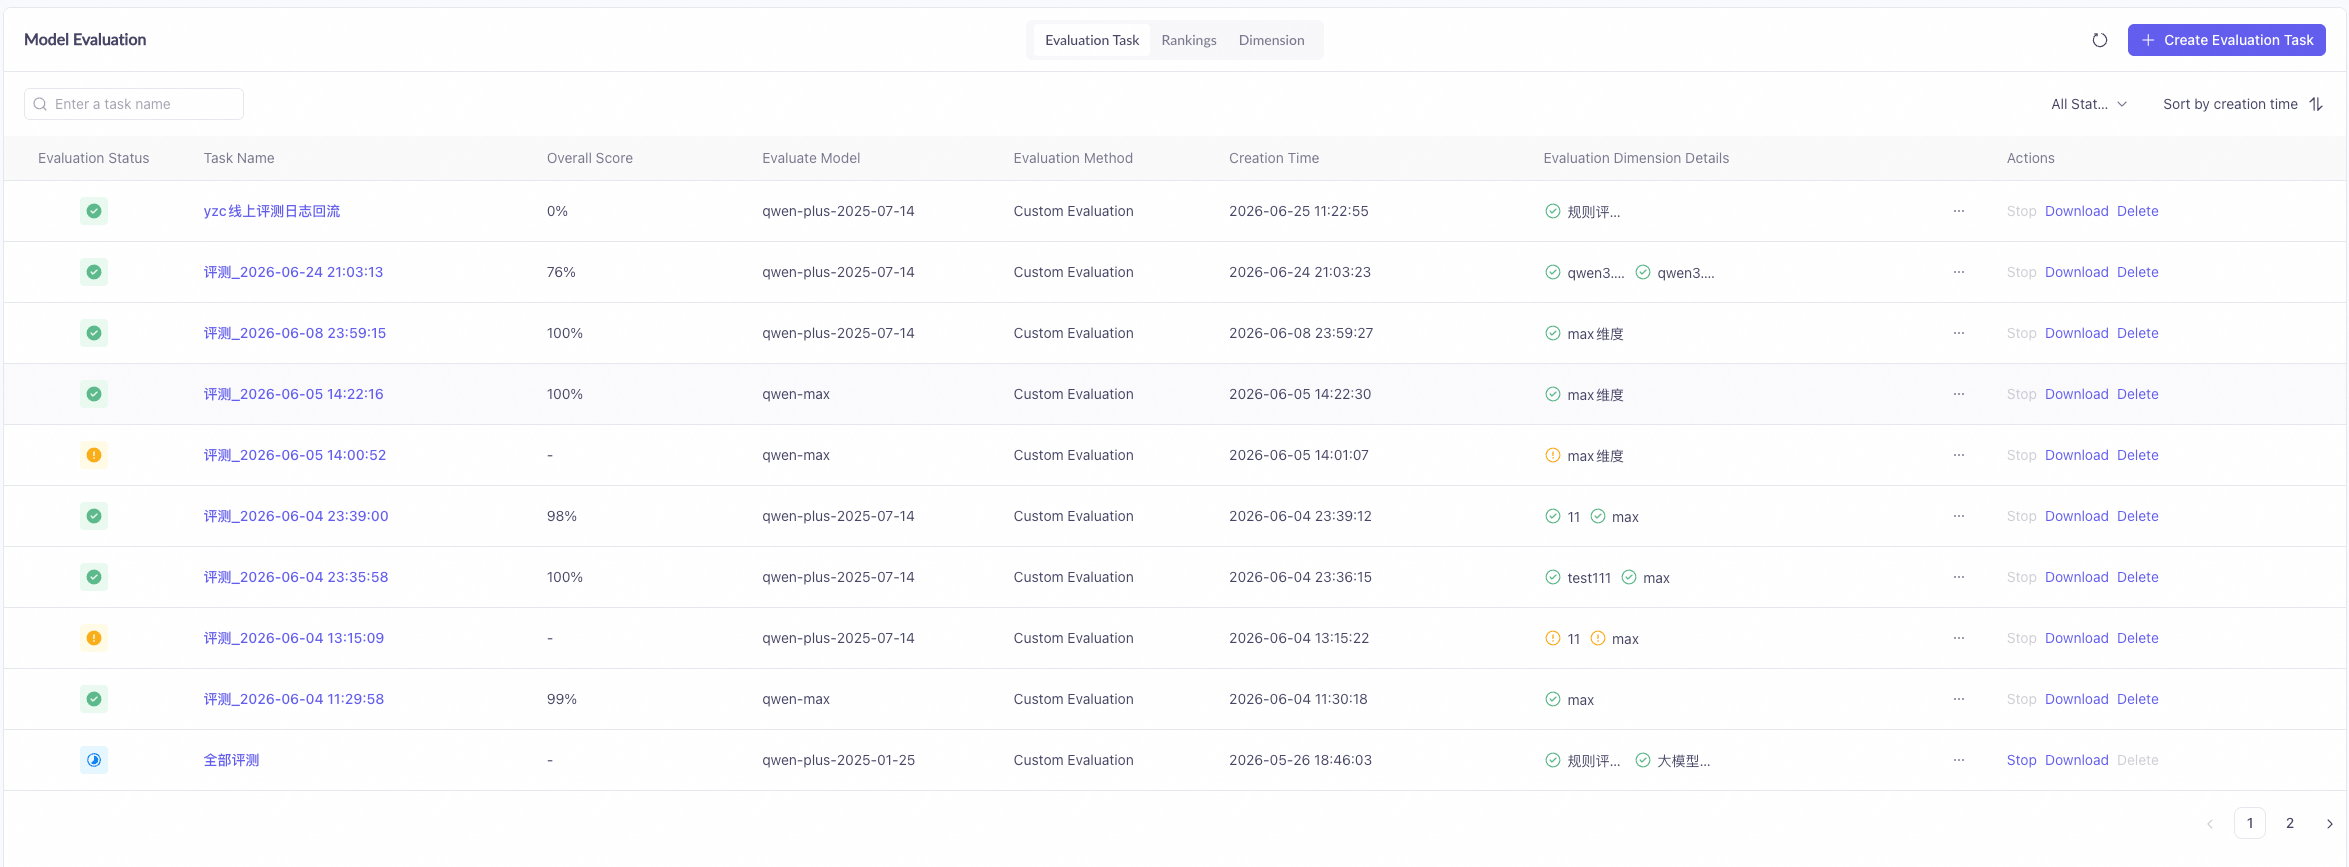
Después de enviar una tarea, puede rastrear su estado y ver los resultados de la evaluación en la lista de tareas de evaluación.
Inicie sesión en la consola de Alibaba Cloud Model Studio y, en el panel de navegación izquierdo, elija Evaluation > Evaluation Task.
Estado de la Tarea
El estado de una tarea de evaluación cambia de la siguiente manera:
- WAITING: la tarea se ha enviado y está en espera de ejecución.
- RUNNING: la tarea se está ejecutando, y la plataforma está invocando el modelo y realizando la puntuación.
- FINISH: la ejecución de la tarea ha finalizado, todos los datos han sido puntuados y los resultados pueden consultarse.
- FAILED: la ejecución de la tarea falló, generalmente debido a una excepción en la invocación del modelo o a un problema de formato de datos.
- ABORTED: la tarea fue terminada manualmente.
Para conocer las operaciones disponibles bajo cada estado, consulte Manage Evaluation Resources.
Ver Datos y Estadísticas de Evaluación
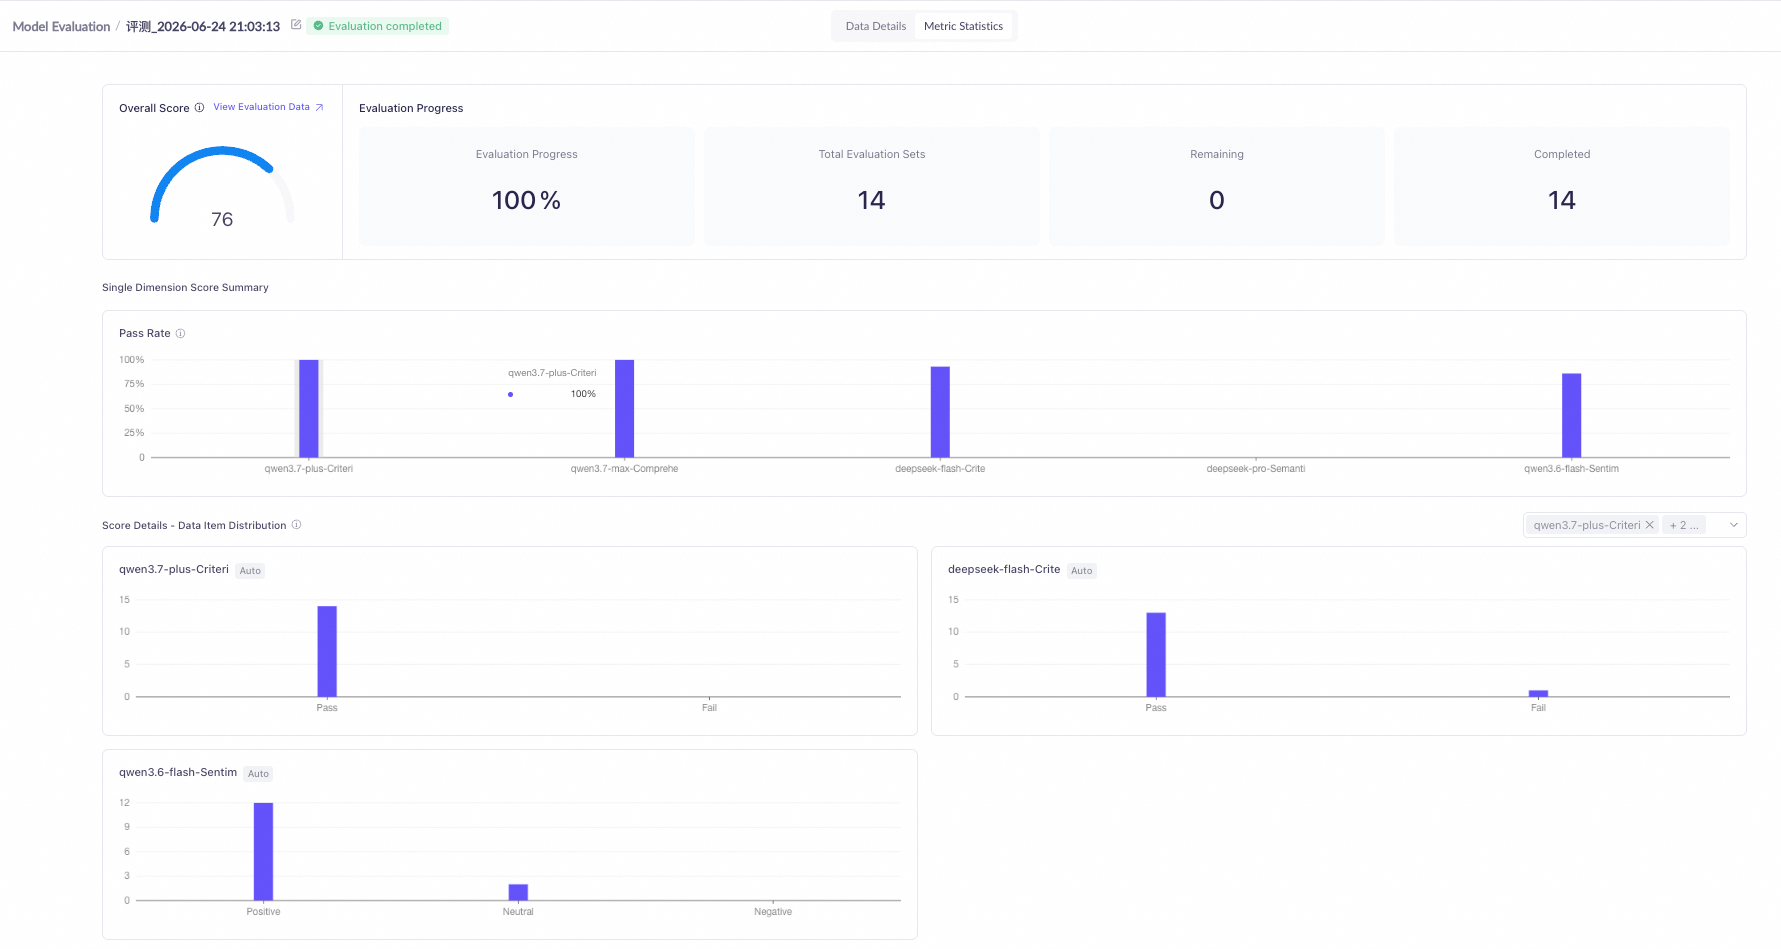
Después de que el estado de la tarea cambie a FINISH, haga clic en el nombre de la tarea para ingresar a la página de detalles de resultados, que contiene las siguientes dos pestañas:
- Detalles de datos: muestra el Prompt, la salida del modelo y la puntuación de cada dimensión para cada entrada de datos una por una, lo que le ayuda a localizar el rendimiento del modelo en preguntas específicas.
- Estadísticas de métricas: muestra la puntuación integral y la tasa de aprobación de cada dimensión de evaluación. Las dimensiones numéricas muestran la puntuación promedio y la tasa de aprobación; las dimensiones categóricas muestran el gráfico de distribución de cada etiqueta de categoría.
Descarga y Análisis de Resultados
Solo las tareas con estado FINISH admiten la descarga de resultados. En la página de detalles de la tarea de evaluación, haga clic en Download Results para exportar los datos completos de la evaluación.
Al analizar los resultados de la evaluación, preste atención a los siguientes aspectos:
- Compare las diferencias de puntuación de diferentes modelos en la misma dimensión para determinar las fortalezas de cada modelo.
- Filtre las entradas de datos con baja puntuación y analice en qué tipos de preguntas el modelo tiene un rendimiento deficiente.
- Concéntrese en la métrica de tasa de aprobación: la tasa de aprobación refleja la proporción del modelo que alcanza la línea base en esa dimensión, y es una referencia fundamental para la selección del modelo.
- Si el mismo modelo se evalúa varias veces, compare los cambios de puntuación a lo largo del tiempo para rastrear el efecto del ajuste del modelo.
Usar Tablas de Clasificación para Comparar Modelos
Las tablas de clasificación se utilizan para comparar el rendimiento de múltiples modelos bajo las mismas dimensiones de evaluación, y muestran visualmente las fortalezas y debilidades de cada modelo en forma de rankings. Cada tabla de clasificación está vinculada a un conjunto de dimensiones de evaluación y agrega los resultados de múltiples tareas de evaluación en la misma tabla de clasificación, ayudándole a tomar decisiones rápidas sobre la selección de modelos.
Crear una Tabla de Clasificación
- Inicie sesión en la consola de Alibaba Cloud Model Studio y, en el panel de navegación izquierdo, elija Evaluation > Leaderboard.
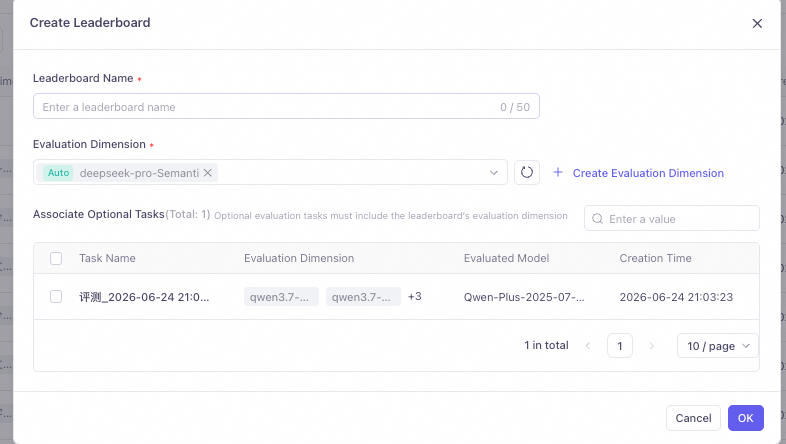
- Haga clic en Create Leaderboard.
- Complete el Nombre de la Tabla de Clasificación (no más de 50 caracteres).
- En Dimension, seleccione una o más dimensiones de evaluación que haya creado. Las dimensiones de evaluación vinculadas a una tabla de clasificación no se pueden modificar después de su creación; elija con cuidado.
- Haga clic en OK para completar la creación.
Agregar Tareas de Evaluación a una Tabla de Clasificación
Después de crear una tabla de clasificación, puede agregar tareas de evaluación a la misma de dos maneras:
- Crear una nueva tarea desde la tabla de clasificación: en la página de detalles de la tabla de clasificación, haga clic en Create Evaluation Task. El sistema bloquea automáticamente las dimensiones de evaluación vinculadas a la tabla de clasificación y asocia dicha tabla. Solo necesita seleccionar el modelo a evaluar y el conjunto de datos.
- Seleccionar desde tareas completadas: en la página de detalles de la tabla de clasificación, haga clic en Add Evaluation Task, y en la lista emergente, marque las tareas históricas cuyo estado sea FINISH y que contengan las dimensiones de evaluación de la tabla de clasificación. Las casillas de verificación de las tareas ya vinculadas a la tabla de clasificación actual aparecerán atenuadas y no se podrán desmarcar.
Se pueden agregar hasta 50 tareas de evaluación a cada tabla de clasificación.
Descripción de Resultados de la Tabla de Clasificación
La tabla de clasificación muestra los resultados de clasificación de todas las tareas agregadas en una tabla, que contiene las siguientes columnas:
- Ranking: ordenado de mayor a menor según la puntuación de la tabla de clasificación; los tres primeros se marcan en oro, plata y bronce.
- Task Name: el nombre de la tarea de evaluación. Haga clic para ir a los detalles de la tarea.
- to compare: el nombre del modelo a evaluar utilizado por la tarea.
- Leaderboard Score: el rango de valores es 0-100, derivado de la normalización de las puntuaciones de la tarea en las dimensiones vinculadas a la tabla de clasificación. La puntuación de una tarea en proceso de evaluación se muestra con un guion (-) y se actualizará automáticamente una vez finalizada la evaluación.
- [Evaluation Dimension Name]: muestra la puntuación original de la tarea en las dimensiones vinculadas a la tabla de clasificación.
- Actions: permite ver los detalles de la tarea o eliminarla de la tabla de clasificación.
Las puntuaciones de la tabla de clasificación se actualizan en tiempo real a medida que avanza la tarea de evaluación. Cuando el estado de la tarea cambia a FINISH, la clasificación se actualizará automáticamente.
Evaluación por Anotación Manual
La evaluación mediante anotación manual es adecuada para escenarios que requieren juicio subjetivo, como la evaluación de creatividad y la revisión de calidad profesional. Cuando los métodos de puntuación automática no pueden medir con precisión la calidad de la salida del modelo, puede crear una tarea de evaluación que contenga una dimensión de puntuación por clasificación manual, y los anotadores juzgarán manualmente la salida del modelo una por una.
Inicie sesión en la consola de Alibaba Cloud Model Studio y, en el panel de navegación izquierdo, elija Evaluation > Evaluation Task.
Modos de Anotación
La anotación manual admite 3 modos, aplicables a diferentes objetivos de evaluación:
Single Annotation
El modo Single Annotation (base) evalúa la salida del modelo de cada entrada de datos una por una, y el anotador selecciona una etiqueta de categoría para cada salida. Es adecuado para escenarios que requieren una puntuación independiente de cada salida, como verificar individualmente la precisión o la seguridad de las respuestas del modelo.
Comparative Annotation
El modo Comparative Annotation (PK) muestra lado a lado las salidas de dos modelos para el mismo Prompt, y el anotador clasifica ambas salidas (por ejemplo, A es mejor que B). Es adecuado para la comparación directa y selección entre modelos, ayudando a determinar rápidamente qué modelo tiene un mejor desempeño en un escenario específico.
Application Annotation
El modo Application Annotation (app) evalúa la calidad de la salida del modelo en escenarios de aplicación real, y los anotadores emiten juicios basados en el contexto empresarial. Es adecuado para la evaluación de efectividad integral a nivel de aplicación, centrándose en la usabilidad de la salida del modelo en flujos empresariales reales.
Una comparación de los 3 modos de anotación es la siguiente:
Modo de anotación | Descripción | Escenarios Aplicables |
|---|---|---|
Anotación única (base) | Calificar cada salida del modelo una por una | Necesita calificar cada salida de forma independiente |
Anotación comparativa (PK) | Comparar y clasificar dos salidas del modelo lado a lado | Comparación directa y selección entre modelos |
Anotación de aplicación (app) | Evaluar la salida del modelo en escenarios de aplicación | Evaluación de efectividad de extremo a extremo |
Pasos de Anotación
- Siga el flujo de trabajo de Create an Evaluation Task para crear una nueva tarea y asociar una dimensión de evaluación cuyo método de puntuación sea Manual Classification Scoring (consulte Create an Evaluation Dimension para más detalles).
- Una vez creada la tarea, vaya a la página de detalles de la tarea y seleccione la pestaña Evaluation Data.
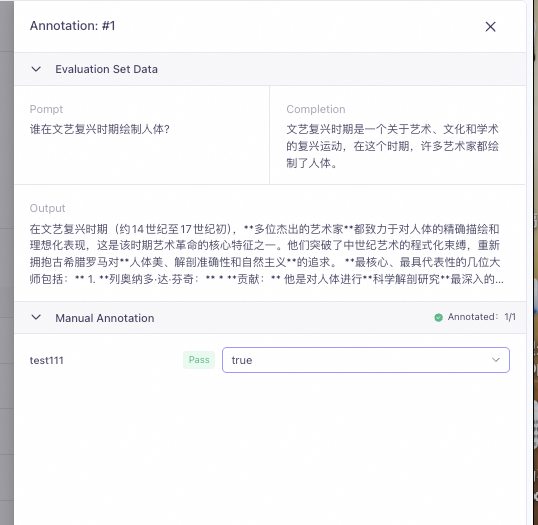
- En la columna Actions de la lista de datos, haga clic en el botón Annotate para ingresar a la página de anotación.
- Revise el contenido de la salida del modelo, seleccione una etiqueta de categoría para esta entrada de datos según los criterios de juicio y haga clic en Submit para completar la anotación de la entrada actual.
- Complete la anotación de todas las entradas de datos una por una. Cuando todos los datos estén anotados, el estado de la tarea cambiará automáticamente a FINISH.
Recomendaciones de Diseño de Etiquetas
La calidad del diseño de etiquetas afecta directamente la fiabilidad de los resultados de anotación. Se recomiendan los siguientes principios:
- Las etiquetas deben cubrir todas las situaciones posibles de salida del modelo para evitar que los anotadores encuentren salidas que no puedan categorizarse.
- Utilice palabras de categoría concisas y claras como nombres de etiquetas para reducir el costo de comprensión del anotador.
- Organice varios anotadores para que anoten de forma cruzada el mismo lote de datos y verifique la consistencia de las anotaciones. Si la consistencia es baja, compruebe si las definiciones de las etiquetas son ambiguas y optimice los criterios de juicio.
Gestionar Recursos de Evaluación
Después de crear las tareas de evaluación, las dimensiones de evaluación y las tablas de clasificación, puede gestionar estos recursos en la consola. Algunas operaciones son irreversibles; proceda con precaución.
Inicie sesión en la consola de Alibaba Cloud Model Studio y, en el panel de navegación izquierdo, elija Evaluation.
Gestión de Tareas de Evaluación
En la página de lista Evaluation > Evaluation Task, puede realizar las siguientes operaciones en las tareas de evaluación:
- Buscar, filtrar y ordenar: busque por nombre de tarea, filtre por estado y ordene por hora de creación para localizar rápidamente la tarea objetivo. Estas operaciones solo afectan a la visualización de la lista y no cambian los datos de la tarea.
- Terminar tarea: solo las tareas con estado RUNNING admiten la terminación. Después de hacer clic en Terminate, el estado de la tarea cambia a ABORTED. Esta operación es irreversible.
- Eliminar tarea: se pueden eliminar las tareas con estado FINISH, FAILED o ABORTED. Después de la eliminación, los datos de la tarea y los resultados de la evaluación se borrarán permanentemente. Esta operación es irreversible.
- Descargar resultados: solo las tareas con estado FINISH admiten la descarga de resultados de evaluación (consulte Ver resultados de evaluación para obtener más detalles).
Las operaciones disponibles bajo cada estado de tarea se resumen a continuación:
Estado de la tarea | Operaciones Disponibles | Recordatorio Irreversible |
|---|---|---|
WAITING | None (la tarea está en cola) | - |
RUNNING | Terminar | Después de la terminación, el estado cambia a ABORTED y no se puede restaurar |
FINISH | Ver resultados, Descargar resultados, Eliminar | Los datos se borran permanentemente después de la eliminación |
FAILED | Eliminar | Los datos se borran permanentemente después de la eliminación |
ABORTED | Eliminar | Los datos se borran permanentemente después de la eliminación |
Gestión de Dimensiones de Evaluación
En la página de lista Evaluation > Dimension, puede editar la descripción de la dimensión o eliminar una dimensión.
Al eliminar una dimensión de evaluación, si la dimensión ha estado vinculada a una tabla de clasificación, los datos de puntuación basados en esa dimensión en la tabla de clasificación se borrarán. Confirme si alguna tabla de clasificación está utilizando la dimensión antes de eliminarla.
Gestión de Tablas de Clasificación
En la página de lista Evaluation > Leaderboard, puede realizar las siguientes operaciones:
- Eliminar tabla de clasificación: después de eliminar una tabla de clasificación, sus datos se borrarán permanentemente, pero las tareas de evaluación ya agregadas a la misma no se verán afectadas.
- Eliminar tarea: en la página de detalles de la tabla de clasificación, puede eliminar una tarea de evaluación de la tabla. La eliminación solo afecta a la visualización de la tabla de clasificación; la tarea de evaluación en sí y sus resultados no se eliminarán.
AdvertenciaLas siguientes operaciones son irreversibles; confirme antes de ejecutarlas: eliminar una tarea de evaluación borrará permanentemente los datos de la tarea y los resultados de la evaluación; una tarea terminada no se puede reanudar; eliminar una dimensión de evaluación también borrará los datos de puntuación basados en esa dimensión en la tabla de clasificación.
Facturación
Las tarifas generadas por la Evaluación de modelos constan de dos partes: la tarifa de inferencia del modelo a evaluar y la tarifa de puntuación del modelo juez. Comprender las reglas de facturación le ayuda a planificar la escala de evaluación y controlar los costos adecuadamente.
Composición de Tarifas
Tarifa de inferencia del modelo a evaluar: facturada por token. La fórmula es cost = input_tokens x input_price + output_tokens x output_price. Aquí, input_tokens incluye el System Prompt y el Prompt de cada entrada de datos, y output_tokens es la respuesta generada por el modelo. El precio unitario específico de cada modelo está sujeto a la consola de Model Studio.
Tarifa de puntuación del modelo juez: solo se genera al utilizar el método de puntuación LLM Numerical Scoring o LLM Classification Scoring. Los tokens consumidos por el modelo juez para puntuar cada entrada de datos se facturan según los precios de dicho modelo juez. Para consultar precios específicos, refiérase a la consola de Model Studio.
Al utilizar el método de puntuación Coincidencia de cadenas o Similitud de texto, el proceso de puntuación no implica una llamada al modelo juez, por lo que no se genera ningún costo de puntuación.
NotaLos métodos de puntuación String Matching y Text Similarity no invocan un modelo juez y no generan cargos por puntuación; solo se cobra la tarifa de inferencia del modelo a evaluar. Para escenarios de evaluación con una respuesta estándar clara, priorizar estos dos métodos puede reducir significativamente el costo de evaluación.
Para modelos desplegados de forma independiente (ajustados y desplegados en línea), no se cobra ninguna tarifa de inferencia adicional durante la evaluación; solo aplica la tarifa de despliegue existente.
La composición de tarifas de cada método de puntuación se resume en la siguiente tabla:
Método de puntuación | Tarifa de Inferencia del Modelo a Evaluar | Tarifa de Calificación del Modelo Juez | Composición de tarifas |
|---|---|---|---|
Puntuación numérica LLM | Facturado por token | Facturado por token | Inferencia + Puntuación |
Puntuación de clasificación LLM | Facturado por token | Facturado por token | Inferencia + Puntuación |
Coincidencia de cadenas | Facturado por token | None | Solo inferencia |
Similitud de texto | Facturado por token | None | Solo inferencia |
Puntuación de clasificación manual | Facturado por token | None (el costo manual se calcula por separado) | Inferencia + Manual |
Ejemplo de Estimación de Tarifas
El siguiente ejemplo muestra el proceso de estimación de tarifas para usar el modelo qwen-plus para realizar una evaluación de Puntuación numérica LLM en 100 entradas de datos (el precio unitario es solo ilustrativo; consulte la visualización real en la consola):
- Suponga que cada entrada de datos tiene un promedio de input_tokens = 500 y output_tokens = 200.
- Tarifa de inferencia del modelo a evaluar = 100 x (500 x input_price + 200 x output_price).
- Tarifa de puntuación del modelo juez = 100 x (tokens consumidos por puntuación x precio unitario del modelo juez).
- Tarifa total = Tarifa de inferencia del modelo a evaluar + Tarifa de puntuación del modelo juez.
Estrategias de Optimización de Costos
- Evaluación por fases: utilice primero 50-100 entradas de datos para una validación a pequeña escala. Después de confirmar que las dimensiones de evaluación y la calidad de los datos cumplen con las expectativas, amplíe al conjunto de datos completo para la evaluación formal.
- Evaluación basada en reglas primero: Coincidencia de cadenas y Similitud de texto no generan costos de modelo juez y tienen el menor costo. Para escenarios con una respuesta estándar clara, priorice los métodos de evaluación basados en reglas.
- Guarde conjuntos de resultados de inferencia para su reutilización: guarde los resultados de inferencia del modelo como un conjunto de resultados de inferencia. Las evaluaciones posteriores pueden utilizar directamente los resultados existentes, evitando el costo de llamar repetidamente al modelo para la inferencia.
FAQ
¿Qué sucede si los resultados de la evaluación no cumplen con las expectativas?
Problem: después de completar la tarea de evaluación, la puntuación del modelo muestra una desviación significativa de la experiencia real, o el resultado de la puntuación es irrazonable.
Verifique los siguientes aspectos en orden:
- Verifique la representatividad de los datos de prueba: confirme si el conjunto de datos de evaluación cubre los escenarios típicos y los casos extremos del negocio. Muy pocos datos o una distribución sesgada harán que las puntuaciones no sean representativas.
- Revise la claridad del Scorer Prompt: confirme si el Scorer Prompt describe claramente los criterios de puntuación y la base de juicio. Un Prompt ambiguo provocará que el modelo juez puntúe de manera inestable.
- Ajuste el rango de puntuación y el umbral: un rango de puntuación demasiado estrecho (como 0-2) puede resultar en una discriminación insuficiente de las puntuaciones. Ampliar adecuadamente el rango (como 0-10) puede mejorar la precisión de la puntuación.
- Cambie el modelo juez: diferentes modelos jueces tienen distintas capacidades de puntuación. Se recomienda Qwen-Max (qwen-max) para obtener resultados de puntuación más estables.
¿Qué sucede si las puntuaciones están demasiado concentradas?
Problem: las puntuaciones de múltiples entradas de datos se concentran en la misma puntuación o etiqueta de categoría, careciendo de discriminación.
Las puntuaciones excesivamente concentradas suelen deberse a las siguientes razones. Investíguelas una por una:
- Refinar los criterios de juicio: agregue condiciones de juicio claras y ejemplos para cada nivel de puntuación en el Scorer Prompt para que el modelo juez pueda distinguir salidas de diferentes niveles de calidad.
- Aumente la diversidad de datos: agregue muestras límite y muestras anómalas al conjunto de datos de evaluación para evitar que todos los Prompts tengan una dificultad demasiado uniforme.
- Cambie el modelo juez: un modelo juez con mayor capacidad de razonamiento (como Qwen-Max) puede seguir mejor los criterios de juicio detallados en el Scorer Prompt.
¿Cómo interpretar resultados contradictorios en diferentes dimensiones de evaluación?
Problema: el mismo modelo presenta grandes diferencias de puntuación en distintas dimensiones de evaluación, e incluso puede tener un rendimiento excelente en una dimensión y deficiente en otra.
Esto es normal. Diferentes dimensiones de evaluación evalúan distintos aspectos de las capacidades del modelo (como precisión, fluidez y lógica). El rendimiento del modelo en diferentes capacidades varía inherentemente. Se recomienda tomar decisiones ponderadas sobre las puntuaciones de las dimensiones basándose en las prioridades del negocio, en lugar de exigir que el modelo tenga un rendimiento óptimo en todas las dimensiones.
¿Qué sucede si el modelo genera frecuentemente contenido obsoleto o irrelevante?
Problem: la salida del modelo es irrelevante respecto a la respuesta de referencia o contiene información obsoleta, lo que resulta en una puntuación de evaluación baja.
Esto suele indicar que la cobertura de conocimiento del modelo es insuficiente o que los datos de entrenamiento están desactualizados. Se recomienda considerar la introducción de una base de conocimientos para complementar el modelo con conocimiento del dominio, y mejorar la calidad de salida del modelo en dominios específicos mediante Generación Aumentada por Recuperación (RAG).
¿Cuáles son los errores comunes al utilizar la evaluación?
Problem: al utilizar Model Evaluation por primera vez, es fácil confundir conceptos u operar incorrectamente, lo que resulta en resultados de evaluación anómalos.
Los siguientes son errores comunes y prácticas correctas:
- El System Prompt no es lo mismo que el Scorer Prompt: el System Prompt se configura en la tarea de evaluación y se envía al modelo a evaluar; el Scorer Prompt se configura en la dimensión de evaluación y se envía al modelo juez (consulte Create an Evaluation Task para más detalles). Ambos tienen objetivos diferentes; no los confunda.
- Las etiquetas de categoría, como Pass/Fail, no deben superponerse: en las dimensiones que utilizan LLM Classification Scoring o Manual Classification Scoring, las etiquetas de aprobación y las de no aprobación deben ser mutuamente excluyentes. Una misma etiqueta no puede pertenecer a ambos grupos simultáneamente.
- Sin tarifa adicional para modelos implementados independientemente: los modelos que han sido ajustados finamente e implementados en línea no cobran una tarifa de inferencia adicional durante la evaluación (consulte Facturación para obtener más detalles).
- Restricción de tipo de conjunto de datos: las tareas de evaluación solo admiten conjuntos de datos del tipo Conjunto de evaluación. Si se selecciona un conjunto de datos del tipo conjunto de entrenamiento, el sistema rechazará la creación de la tarea de evaluación.