Este tema utiliza el modelo Qwen como ejemplo para guiarlo a través del ciclo de vida completo de la implementación de modelos en Alibaba Cloud Model Studio mediante llamadas API (HTTP), incluyendo la implementación, consulta, inferencia, eliminación y solución de problemas de permisos.
Requisitos previos
- Ha leído la Descripción general del despliegue dedicado y está familiarizado con los modelos compatibles y los pasos básicos de despliegue.
- Obtener una clave de API y exportar la clave de API como una variable de entorno.
1. Desplegar el modelo
El siguiente comando utiliza el modelo personalizado ajustado qwen3-8b-ft-202511132025-0260 para crear un servicio dedicado denominado qwen3-8b-ft-202511132025-0260.
Para obtener el ID del modelo personalizado, vaya a la página de Consola de Model Studio - ajuste fino de modelos. Haga clic en el Task NameNombre de la tarea del modelo que want desea desplegar, haga clic en OutputsSalidas y luego haga clic en el nombre azul del modelo. Esto abre la página de My ModelsMis modelos, donde puede encontrar el ID del modelo en la sección de información básica.
Utilice el ID del modelo como entrada para el parámetro model_name para desplegar el modelo mediante la API.
Rendimiento aprovisionado (PTU)
NotaDespués de ejecutar el comando de despliegue, la facturación comienza tan pronto como el servicio se despliega correctamente, incluso si no lo utiliza. Antes de continuar, le recomendamos revisar las reglas de facturación del servicio.
El método de facturación por rendimiento aprovisionado cobra según la duración de uso. Este método es adecuado para escenarios que requieren un rendimiento estable, alta concurrencia, baja latencia y tráfico predecible. En este modo, la plataforma aprovisiona tanto el rendimiento/concurrencia como la velocidad de generación, los cuales no puede ajustar.
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments" \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "name": "my_qwen_flash",
    "model_name": "qwen-flash-2025-07-28",
    "plan": "ptu",
    "ptu_capacity": {
        "input_tpm": 10000,
	"output_tpm": 1000
    }
}'
Unidad de modelo
Nota
- Después de ejecutar el comando de despliegue, la facturación comienza tan pronto como el servicio se despliega correctamente, incluso si no lo utiliza. Antes de continuar, le recomendamos revisar las reglas de facturación del servicio.
- Los recursos de cómputo para el plan de unidades de modelo pospago se asignan por orden de llegada. Si la compra no se realiza con éxito, se emitirá un reembolso completo.
El método de facturación por unidades de modelo le cobra según la duración de uso. Este método de facturación es ideal para tareas de inferencia a gran escala después del ajuste fino del modelo, ofreciendo recursos dedicados con ajustes flexibles de rendimiento y costo. Puede personalizar tanto el rendimiento/concurrencia como la velocidad de generación.
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments" \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "name": "my_qwen_plus",
    "model_name": "qwen-plus-2025-12-01",
    "plan": "mu",
    "deploy_spec": "MU1",
    "enable_thinking": true,
    "capacity": 4,
    "max_context_length": 10000,
    "rpm_limit": 500,
    "tpm_limit": 1000
}'
El modo de despliegue de unidades de modelo admite las siguientes configuraciones adicionales:
Elemento de configuración | Detalles de configuración |
Nombre del servicio | Nombre personalizado para el servicio de despliegue. |
Seleccionar modelo | Seleccione el modelo a desplegar, incluidos los modelos integrados de la plataforma y los modelos ajustados. |
Tipo de unidad de modelo | Seleccione la especificación de implementación. Las diferentes especificaciones corresponden a distintas capacidades de cómputo y rendimiento. |
Recuento de réplicas de despliegue | Establezca el número inicial de réplicas de implementación, lo cual afecta la capacidad de concurrencia del servicio. |
Plantilla de despliegue | Seleccione una plantilla de implementación (como "single-node deployment"). Las diferentes plantillas corresponden a distintos esquemas de configuración de recursos. Disponible solo bajo el modo de facturación por unidad de modelo. |
Configurar modo de inferencia del modelo | Para algunos modelos implementados en modo Unidad de Modelo, puede configurar el modo de inferencia, la longitud máxima del contexto y más.
|
Longitud máxima de contexto | El modo de implementación de Unidad de Modelo de algunos modelos admite esta configuración. La longitud máxima del contexto depende del tipo de modelo. |
Limitación de tasa del servicio | El modo de implementación de Unidad de Modelo de algunos modelos admite esta configuración. Puede limitar las RPM y los TPM de las invocaciones del modelo. |
Para aprender a configurar estos ajustes mediante la API, consulte Crear una tarea de despliegue de modelos mediante una API.
Uso de tokens
Con la facturación por uso de tokens, se le cobra según el uso de tokens. Este método es adecuado para escenarios sensibles a los costos donde los requisitos de concurrencia y latencia no son críticos. Este modo ofrece la mejor ventaja de precio; la plataforma aprovisiona el rendimiento/concurrencia y la velocidad de generación, los cuales no puede ajustar.
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments" \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "model_name": "qwen3-8b-ft-202511132025-0260",
    "plan": "lora",
    "capacity": 1,
    "name": "qwen3-8b-ft"
}'
El parámetro
capacityes obligatorio pero actualmente no tiene efecto. Para solicitar escalado, vaya a la consola de Dedicated DeploymentDespliegue dedicado y envíe un formulario.
CLI de dashscope
Llamada a través de la línea de comandos dashscope.
export DASHSCOPE_API_KEY="your-api-key"
# Replace {WorkspaceId} with your workspace ID, ap-southeast-1 with your region (e.g., us-east-1, eu-central-1)
export DASHSCOPE_HTTP_BASE_URL="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1"
# List deployed dedicated services
dashscope deployments list

# Create a dedicated service (--plan required)
# plan options: ptu (PTU reserved resources) / mu (model unit) / lora (LoRA deployment)
dashscope deployments create -m qwen2.5-7b-instruct -s tst -c 1 --plan ptu
-mespecifica el nombre del modelo,-sespecifica el sufijo del servicio,-cespecifica la capacidad de despliegue.
ImportanteEl asistente interactivo SDK Expert puede realizar las mismas tareas de desarrollo y solución de problemas mediante lenguaje natural; consulte
DashScope SDK Expert.Para la tabla completa de regiones, consulte Resumen de URL base.
En caso de éxito, el comando devuelve el siguiente resultado (utilizando un despliegue LoRA como ejemplo):
{
    "request_id": "83b173ab-2b2f-41aa-8c57-b173e8be934e",
    "output":
    {
        "deployed_model": "qwen3-8b-ft-202511132025-0260",
        "gmt_create": "2025-11-20T20:06:46.405",
        "gmt_modified": "2025-11-20T20:06:46.405",
        "status": "PENDING",
        "model_name": "qwen3-8b-ft-202511132025-0260",
        "base_model": "qwen3-8b",
        "workspace_id": "llm-8v*****",
        "charge_type": "post_paid",
        "creator": "16542*****",
        "modifier": "16542*****",
        "plan": "***"
    }
}
Donde deployed_model es el ID único del servicio dedicado.
2. Consultar el estado del servicio
Ejecute el siguiente comando para consultar los detalles de un servicio dedicado específico:
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments/qwen3-8b-ft-202511132025-0260" \
    --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
    --header 'Content-Type: application/json'
En caso de éxito, el comando devuelve el siguiente resultado:
{
    "request_id": "ca36952d-9136-426e-ab08-68a97ad72719",
    "output":
    {
        "deployed_model": "qwen3-8b-ft-202511132025-0260",
        "gmt_create": "2025-11-20T20:32:08",
        "gmt_modified": "2025-11-20T20:42:25",
        "status": "RUNNING",
        "model_name": "qwen3-8b-ft-202511132025-0260",
        "base_model": "qwen3-8b",
        "base_capacity": 2,
        "capacity": 2,
        "ready_capacity": 2,
        "workspace_id": "llm-8v53etv3hwb8orx1",
        "charge_type": "post_paid",
        "creator": "1654290265984853",
        "modifier": "1654290265984853",
        "plan": "mu",
        "model_unit_spec": "MU1"
    }
}
Cuando el estado del servicio es RUNNING, el despliegue del servicio ha finalizado.
3. Realizar solicitudes de inferencia
NotaSi es la primera vez que utiliza el SDK de DashScope, consulte Instalar el SDK.
Asegúrese de que el espacio de trabajo de la API Key coincida con el espacio de trabajo de despliegue del modelo.
Al llamar a un servicio dedicado desplegado, el parámetro model debe establecerse en el code del modelo devuelto tras un despliegue exitoso. Obténgalo desde la consola de Dedicated DeploymentDespliegue dedicado.
import os
import dashscope

messages = [
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": "Who are you?"},
]
dashscope.base_http_api_url = 'https://dashscope-intl.aliyuncs.com/api/v1'
response = dashscope.Generation.call(
    # If you have not configured environment variables, replace the next line with your Bailian API Key: api_key="sk-xxx",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    model="qwen3-max-xxx-xxx",  # Please replace with the code returned after the model is successfully deployed
    messages=messages,
    result_format="message",
    enable_thinking=False,
)
print(response)
import os
from openai import OpenAI

client = OpenAI(
    # If you have not configured environment variables, replace the next line with your Bailian API Key: api_key="sk-xxx",
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)

completion = client.chat.completions.create(
    model="qwen3-max-xxx-xxx",  # Please replace with the code returned after the model is successfully deployed
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Who are you?"},
    ],
    extra_body={"enable_thinking": False},
)
print(completion)
Alineación de parámetros de inferencia
Los valores predeterminados de los parámetros del motor de inferencia de Model Studio pueden diferir de los de su marco de inferencia local. Para alinearse con los valores predeterminados de vLLM, consulte la tabla a continuación al llamar a la API; si utiliza SGLang u otros marcos, consulte la documentación correspondiente.
Nombre del parámetro | Valor recomendado (coincide con los valores predeterminados de vLLM) |
|---|---|
temperature | Rango: [0, 2). Establezca en 1.0 para coincidir con el valor predeterminado de vLLM. |
top_p | Rango: (0, 1.0]. Establezca en 1.0 para coincidir con el valor predeterminado de vLLM. |
top_k | Establezca en None o un valor mayor que 100 para desactivar el muestreo top_k (solo se aplica top_p). Establecer en 99 aproxima el valor predeterminado de vLLM de 0 (muestreo completo). |
presence_penalty | Rango: [-2.0, 2.0]. Establezca en 0 para coincidir con el valor predeterminado de vLLM. |
repetition_penalty (DashScope protocol) | Aumentar repetition_penalty reduce la repetición en el texto generado. Un valor de 1.0 significa que no hay penalización. Rango: mayor que 0. Establezca en 1.0 para coincidir con el valor predeterminado de vLLM. |
4. Eliminar el servicio dedicado
AdvertenciaEjecutar el comando de eliminación pone inmediatamente el servicio de despliegue fuera de línea. Esta acción es irreversible y tiene los siguientes efectos:
- Ya no puede invocar el modelo.
- La facturación del servicio se detiene.
Si ya no necesita un servicio dedicado, puede eliminarlo utilizando el siguiente comando:
curl --request DELETE 'https://dashscope-intl.aliyuncs.com/api/v1/deployments/qwen3-8b-ft-202511132025-0260' \
    --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
    --header 'Content-Type: application/json'
En caso de éxito, el comando devuelve el siguiente resultado:
{
    "request_id": "8f726017-6042-420e-a465-0d366a3aba59",
    "output":
    {
        "deployed_model": "qwen3-8b-ft-202511132025-0260",
        "gmt_create": "2025-11-20T20:32:08",
        "gmt_modified": "2025-11-27T16:35:31.591",
        "status": "DELETING",
        "model_name": "qwen3-8b-ft-202511132025-0260",
        "base_model": "qwen3-8b",
        "base_capacity": 2,
        "capacity": 2,
        "ready_capacity": 2,
        "workspace_id": "llm-8v53etv3hwb8orx1",
        "charge_type": "post_paid",
        "creator": "1654290265984853",
        "modifier": "1654290265984853",
        "plan": "mu",
        "model_unit_spec": "MU1"
    }
}
Después de eliminar el servicio, ya no podrá consultar su estado utilizando el método descrito en 2. Consultar el estado del servicio.
Solución de problemas de permisos
Si encuentra errores de permisos durante el despliegue del modelo, existen dos rutas de solución de problemas dependiendo del método de despliegue:
Despliegue desde la consola
-
Si se muestra "Falta permiso para este módulo", asegúrese de que su cuenta tenga el permiso Despliegue de modelos - Operación en la página de gestión de permisos del espacio de negocio.
Si no puede operar con normalidad, póngase en contacto con su organización o administrador de TI para agregar los permisos relevantes o verificar los problemas de permisos en su nombre.
-
Si se reporta el error "el espacio de negocio xx no tiene permiso para desplegar el modelo xx" durante el despliegue, vaya a la página de Gestión de espacios de negocio de Model Studio para agregar el permiso de despliegue del modelo correspondiente para el espacio de negocio correspondiente.
Error de llamada a la API:
Workspace xxx does not have deployment privilege for model xxxx.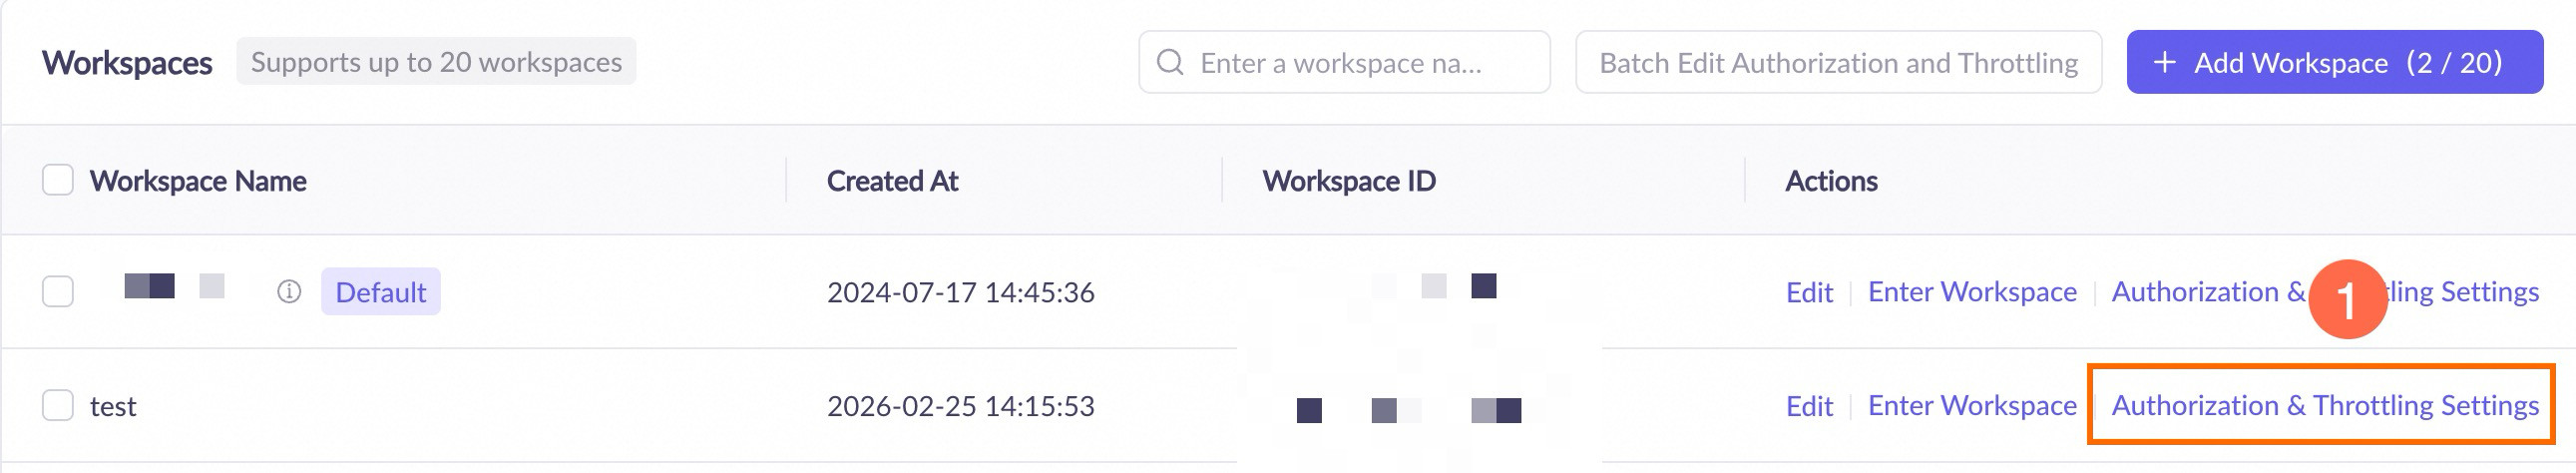
Si se le indica que tiene permisos insuficientes, póngase en contacto con su organización o administrador de TI para agregar los permisos relevantes o realizar la operación en su nombre.
Despliegue de API
Al desplegar un modelo mediante una API, asegúrese de lo siguiente:
-
El Espacio de trabajo de la API Key debe tener permiso para gestionar el modelo. Vaya a la página de Gestión de espacios de negocio en Model Studio y verifique la configuración de permisos de despliegue de modelos para el espacio de trabajo correspondiente.
Error de llamada a la API:
Workspace xxx does not have deployment privilege for model xxxx.En la columna Acciones del espacio de trabajo correspondiente, haga clic en Model Permission and Flow Control Settings.
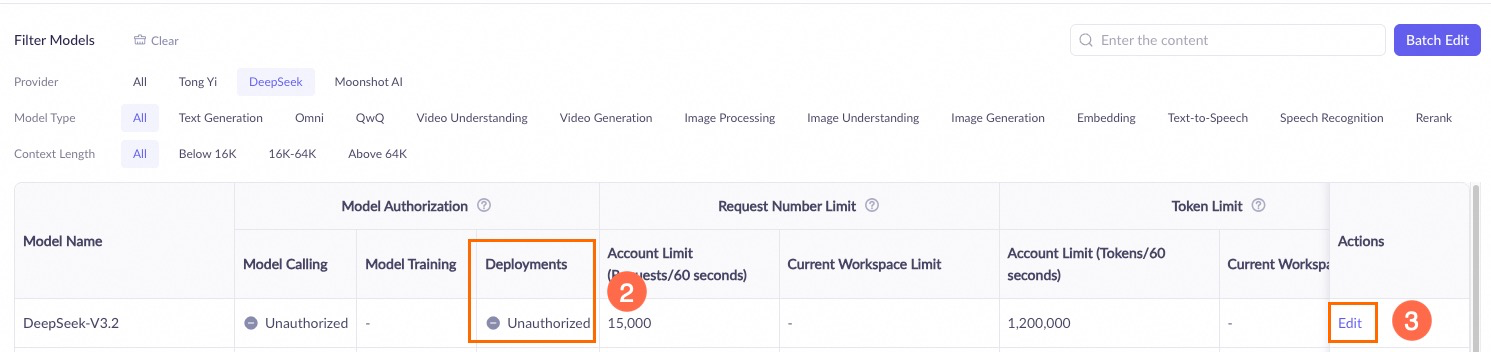
En la Lista de modelos, busque el modelo objetivo y verifique el estado de autorización en la columna Despliegue de modelos. Si muestra No autorizado, haga clic en Edit en la columna Actions para otorgar el permiso.
Si se le indica que tiene permisos insuficientes, póngase en contacto con su organización o administrador de TI para agregar los permisos relevantes o realizar la operación en su nombre.
-
El asistente de Cuenta propietaria que posee la API Key tiene los permisos necesarios en el Espacio de trabajo. Vaya a la consola de Model Studio, haga clic en el espacio de trabajo en la esquina inferior izquierda, cambie al espacio de trabajo correcto y luego haga clic en
 para verificar la configuración de permisos de despliegue del modelo.
Error de llamada a la API:
Workspace access denied.En el panel de navegación izquierdo, haga clic en Permission Management y confirme que la lista de usuarios incluye la cuenta propietaria de la API Key (con tipo cuenta principal).
Si se le indica que tiene permisos insuficientes, póngase en contacto con su organización o administrador de TI para agregar los permisos relevantes o realizar la operación en su nombre.
Referencia de API
Para obtener detalles sobre las llamadas a la API, consulte Detalles de la API.