Para admitir la arquitectura integrada de almacenamiento y procesamiento completo e incremental, las tablas Delta proporcionan un formato de datos unificado. Estas tablas son compatibles con todas las funciones de las tablas estándar de MaxCompute y resultan adecuadas para nuevos escenarios que implican procesamiento incremental, como consultas de viaje en el tiempo y operaciones UPSERT. Este tema describe el formato de datos de las tablas Delta.
Propiedades clave de las tablas Delta
Solo se admiten tablas Delta con clave principal. Para crear una tabla Delta con clave principal mediante una sentencia CREATE TABLE, configure las siguientes propiedades clave en la sentencia: primary key y tblproperties ("transactional"="true").
primary key: Al configurar esta propiedad, puede importar datos en modo UPSERT de manera eficiente. Tras ejecutar una consulta basada en instantáneas o la operación compaction, varias filas de registros con la misma clave principal se fusionan en una sola fila de datos y solo se conserva el estado más reciente.
tblproperties ("transactional"="true"): La propiedad transactional indica las características de transacción de atomicidad, consistencia, aislamiento y durabilidad (ACID) para garantizar el aislamiento de instantáneas y el control sobre operaciones de lectura y escritura simultáneas. Se agrega un campo de propiedad transaccional a cada fila de datos escrita en la tabla. Por ejemplo, se añade el campo de marca de tiempo a cada fila para obtener los registros de la versión de datos requerida en time travel queries.
También puede configurar otras propiedades importantes de la tabla. Por ejemplo, configure la propiedad write.bucket.num para especificar el grado de paralelismo de escritura y la propiedad acid.data.retain.hours para definir el rango de tiempo efectivo de consulta de datos históricos. Para obtener más información sobre las propiedades de la tabla, consulte Parameters for Delta tables.
Formatos de archivo compatibles con las tablas Delta
Las tablas Delta admiten varios formatos de archivo, lo que garantiza una alta eficiencia en escenarios de lectura y escritura completa, así como en escenarios de lectura y escritura incremental en tiempo casi real. Los formatos compatibles incluyen archivos base y archivos delta.
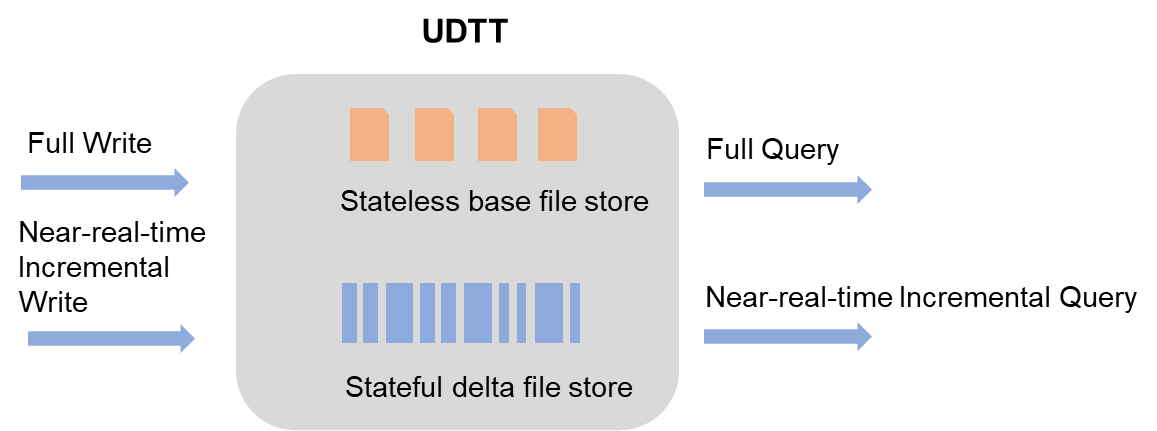
Descripción de los archivos base y los archivos delta:
Archivo delta: tipo de archivo generado cada vez que se confirma una transacción y se escriben datos en modo UPDATE o DELETE. Este archivo almacena el estado histórico intermedio de cada fila de datos para cumplir con los requisitos de lectura y escritura incremental en tiempo casi real. También se genera un archivo delta cada vez que se ejecuta la operación clustering. Los archivos delta utilizan almacenamiento orientado a columnas y compresión.
Archivo base: tipo de archivo generado después de ejecutar la operación compaction en los archivos delta. En un archivo base, se elimina el estado histórico intermedio y solo se conserva una fila de datos para los registros con la misma clave principal. Los archivos base utilizan almacenamiento orientado a columnas y compresión para admitir consultas eficientes de datos completos.
Al consultar datos en una tabla Transaction Table 2.0, tenga en cuenta los siguientes puntos:
MaxCompute busca el archivo base más reciente cada vez que se ejecuta una consulta basada en instantáneas. Luego, busca todos los archivos delta en los que se han escrito datos después de generar el archivo base y fusiona los datos de dichos archivos. Por lo tanto, el modo de consulta es Merge On Read (MOR). Para obtener más información, consulte Time travel queries and incremental queries.
Todos los archivos de datos se ordenan según el valor de la columna de clave principal. Esto mejora la eficiencia de fusión y ayuda a optimizar las consultas de omisión de datos. Los archivos de datos utilizan almacenamiento orientado a columnas y compresión, lo que reduce la cantidad de datos almacenados, ahorra costos y mejora la eficiencia de E/S.
Buckets
Para mejorar aún más la eficiencia de lectura y escritura, las tablas Delta permiten dividir los datos para su almacenamiento según la columna de índice de bucket. De forma predeterminada, la columna de índice de bucket reutiliza los datos de la columna de clave principal. Configure la propiedad write.bucket.num para especificar el número de buckets en los que se escribirán los datos. De este modo, los datos escritos en la misma tabla o partición se dividen según el valor de la columna de clave principal. Los registros con la misma clave principal se almacenan en el mismo bucket.
Near-real-time incremental import admite una alta concurrencia mediante el escalado horizontal del número de buckets. Por lo tanto, evalúe y especifique un número razonable de buckets según el tráfico de escritura de datos y el tamaño total de almacenamiento de los datos de la tabla. Si el número de buckets es excesivamente grande, pueden generarse demasiados archivos pequeños, lo que afecta la eficiencia de lectura y escritura de datos y la estabilidad del almacenamiento. Si el número de buckets es demasiado pequeño, es posible que no se cumplan los requisitos de importación en tiempo casi real con alto tráfico y alta velocidad.
Esta función también ayuda a mejorar la eficiencia de las consultas de datos. Si la condición de filtro se aplica a la columna de índice de bucket, se puede realizar una poda de buckets de manera eficiente para reducir la cantidad de datos consultados. Si la columna clave en la cláusula GROUP BY o en la operación JOIN coincide con la columna de índice de bucket, puede ejecutar directamente operaciones de unión local o GROUP BY. Esto ayuda a reducir la redistribución de datos, ahorrar recursos de cómputo y mejorar el rendimiento de las consultas.
Las operaciones de gestión de optimización de datos, como la agrupación y la compactación de archivos pequeños, pueden ejecutarse en paralelo según los buckets para mejorar la eficiencia de ejecución y acortar el tiempo de procesamiento.
Tipos de registro
Solo se pueden escribir y almacenar registros de datos de los tipos UPSERT y DELETE. El tipo UPSERT contiene dos semánticas implícitas: INSERT y UPDATE. Si un registro no existe previamente, el tipo de registro es INSERT. Si el registro ya existe, el tipo de registro es UPDATE.