Las tablas Delta en MaxCompute admiten la importación de datos casi en tiempo real, a nivel de minuto. Cuando el volumen de escritura es alto, se generan muchos archivos incrementales pequeños y se acumulan estados intermedios redundantes por las operaciones UPDATE y DELETE. Para resolver esto automáticamente, MaxCompute ejecuta tres servicios en segundo plano: Clustering, Compaction y recuperación de datos.
Cómo funciona
Cada servicio aborda una capa distinta del problema de organización de datos:
|
Service |
What it resolves |
Trigger |
|
Clustering |
Acumulación de DeltaFiles pequeños que incrementan los costos de almacenamiento, la carga de E/S y la frecuencia de actualización de metadatos |
Automático, según el estado del sistema |
|
Compaction |
Registros intermedios redundantes de operaciones UPDATE y DELETE que inflan el almacenamiento y ralentizan las consultas de instantánea completa |
Frecuencia determinada por las necesidades del negocio y las características de los datos |
|
Recuperación de datos |
Versiones históricas de datos que se acumulan más allá de su vida útil |
Automática según la política de retención; manual mediante |
Los tres servicios interactúan con Meta Service, que garantiza la seguridad transaccional en todas las operaciones: detecta conflictos, coordina las actualizaciones de metadatos y recupera los archivos antiguos.
Clustering
El Storage Service interno de MaxCompute ejecuta Clustering. Este proceso fusiona DeltaFiles pequeños sin modificar ningún estado intermedio histórico, por lo que no se elimina el historial intermedio de ningún registro.
Cómo funciona Clustering
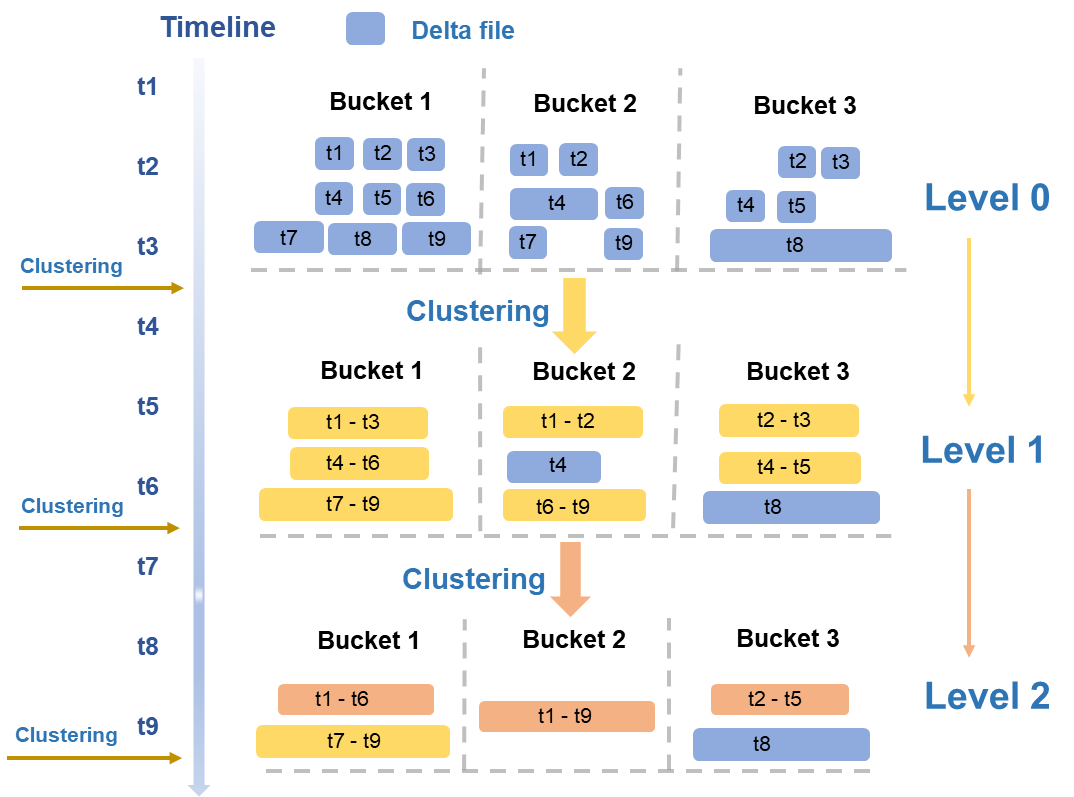
Clustering utiliza una estrategia de fusión jerárquica basada en patrones típicos de lectura y escritura. Los archivos se evalúan periódicamente en varias dimensiones (tamaño y cantidad) y se fusionan entre niveles:
Del nivel 0 al nivel 1: Los DeltaFiles más pequeños de las escrituras iniciales (azules en la figura) se fusionan en DeltaFiles de tamaño mediano (amarillos).
Del nivel 1 al nivel 2: Cuando los DeltaFiles medianos alcanzan una escala suficiente, se activa una fusión de nivel superior para generar archivos más grandes y optimizados (naranjas).
Tras la fusión, disminuyen los costos de almacenamiento, se reduce la carga de E/S y baja la frecuencia de actualización de metadatos. Esto resuelve directamente los problemas de acumulación de archivos pequeños que surgen durante escrituras incrementales de alto volumen.
Controles de amplificación de lectura y escritura
Cada operación de Clustering lee y escribe datos como mínimo una vez, lo cual consume recursos de cómputo y E/S. Tres mecanismos limitan la amplificación innecesaria:
Aislamiento de archivos grandes: Se excluyen de la fusión los archivos que superan un umbral de tamaño (como el archivo T8 en Bucket3 en la figura).
Límite de intervalo temporal: No se fusionan archivos con un intervalo de tiempo amplio. Esto evita que Time Travel y las consultas incrementales lean grandes volúmenes de datos históricos fuera del rango de consulta.
Activación automática: El motor de MaxCompute evalúa el estado del sistema y activa Clustering automáticamente. No se requiere intervención manual.
Concurrencia y seguridad transaccional
Dado que los datos se particionan y almacenan por BucketIndex, Clustering se ejecuta concurrentemente a nivel de bucket, lo que reduce significativamente el tiempo total de ejecución.
Después de cada ejecución, Clustering envía información sobre los archivos de datos nuevos y antiguos a Meta Service. Este servicio detecta conflictos de transacción, coordina la actualización fluida de metadatos para los archivos nuevos y antiguos, y recupera los archivos de datos obsoletos.
Compaction
Las tablas Delta admiten operaciones UPDATE y DELETE, pero estas no modifican los registros en su lugar. En cambio, cada operación escribe un nuevo registro que marca el estado anterior del registro viejo. Con el tiempo, esto produce:
Redundancia de datos: Se acumulan registros intermedios, lo que aumenta los costos de almacenamiento y cómputo.
Menor eficiencia en consultas: Las consultas de instantánea completa deben procesar más registros para determinar el estado actual.
Compaction fusiona BaseFiles y DeltaFiles seleccionados, combina todos los registros con la misma clave primaria y conserva solo el estado más reciente. El resultado es un nuevo BaseFile que contiene únicamente datos INSERT; se eliminan todos los estados intermedios de UPDATE y DELETE.
Cómo funciona Compaction
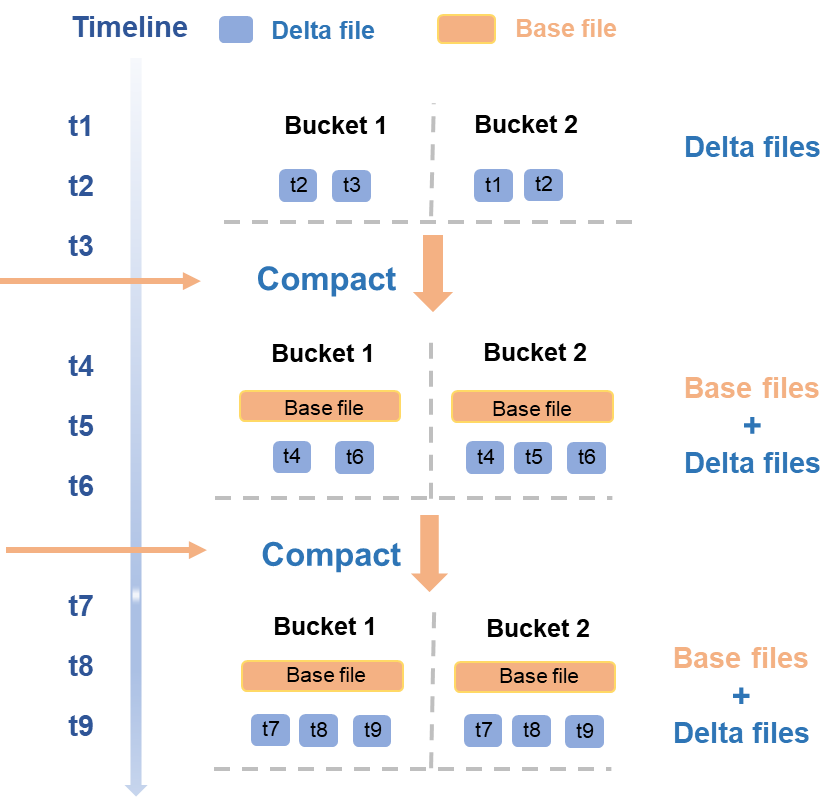
Compaction se ejecuta concurrentemente a nivel de bucket y sigue una línea temporal de operaciones activadas:
De t1 a t3, se escribe un nuevo lote de DeltaFiles. Esto activa una Compaction que fusiona esos DeltaFiles en un nuevo BaseFile para cada bucket.
En t4 y t6, se escribe otro lote de DeltaFiles. La siguiente Compaction fusiona el BaseFile existente con los nuevos DeltaFiles para producir un BaseFile actualizado.
Al igual que Clustering, Compaction interactúa con Meta Service después de cada ejecución: Meta Service detecta conflictos de transacción, actualiza atómicamente los metadatos de los archivos nuevos y antiguos, y recupera los archivos de datos obsoletos.
Elección de la frecuencia de Compaction
Compaction reduce los costos de almacenamiento y cómputo al eliminar estados intermedios de registros, lo que acelera directamente las consultas de instantánea completa. Sin embargo, ejecutarlo frecuentemente tiene costos:
Cada ejecución requiere recursos significativos de cómputo y E/S.
El nuevo BaseFile requiere almacenamiento adicional.
Los DeltaFiles históricos necesarios para Time Travel no pueden eliminarse de inmediato, por lo que siguen generando costos de almacenamiento hasta que expire el periodo de retención.
Establezca la frecuencia de Compaction según la intensidad de operaciones UPDATE y DELETE en su carga de trabajo:
|
Workload pattern |
Recommended approach |
|
Operaciones UPDATE/DELETE frecuentes con alta demanda de velocidad en consultas de instantánea completa |
Aumente la frecuencia de Compaction |
|
Tasa baja de UPDATE/DELETE o consultas de instantánea completa poco frecuentes |
Ejecute Compaction con menor frecuencia para reducir el consumo de recursos |
Recuperación de datos
Las tablas Delta conservan versiones históricas de datos para admitir Time Travel y consultas incrementales. La recuperación de datos elimina las versiones que ya no son necesarias.
Recomendado: configure una política de retención
Configure el periodo de retención de datos mediante la propiedad de tabla acid.data.retain.hours. Los datos históricos anteriores a este valor se recuperan automáticamente. Después de la recuperación, esa versión ya no puede consultarse mediante Time Travel. Los datos recuperados consisten principalmente en registros de operaciones y archivos de datos.
Si una tabla Delta recibe continuamente nuevos DeltaFiles, no se puede eliminar ningún DeltaFile, ya que otros podrían tener dependencias de estado sobre ellos. Tras una operación COMPACTION o InsertOverwrite, los archivos generados posteriormente ya no dependen de los DeltaFiles anteriores y pueden recuperarse una vez que expire el periodo de consulta de Time Travel.
Opcional: forzar limpieza anticipada
En escenarios especiales, utilice el comando PURGE para activar manualmente una limpieza forzada de datos históricos.
Salvaguarda automática
Si Compaction no se ejecuta durante un periodo prolongado, los datos históricos pueden crecer sin límite, lo que eventualmente bloquea la recuperación. Para evitarlo, el motor de MaxCompute ejecuta periódicamente una Compaction automática sobre BaseFiles o DeltaFiles cuya antigüedad supere el periodo de retención configurado para Time Travel. Esto garantiza que el mecanismo de recuperación siga funcionando correctamente.