Las tablas delta admiten escritura y almacenamiento incremental de datos. MaxCompute ofrece una sintaxis SQL especializada para consultas incrementales, diseñada para pipelines de procesamiento incremental en tiempo casi real. Una consulta incremental lee únicamente los delta files dentro de un rango de versiones especificado, los combina y devuelve el resultado sin leer los archivos base generados por compaction o clustering.
Funcionamiento
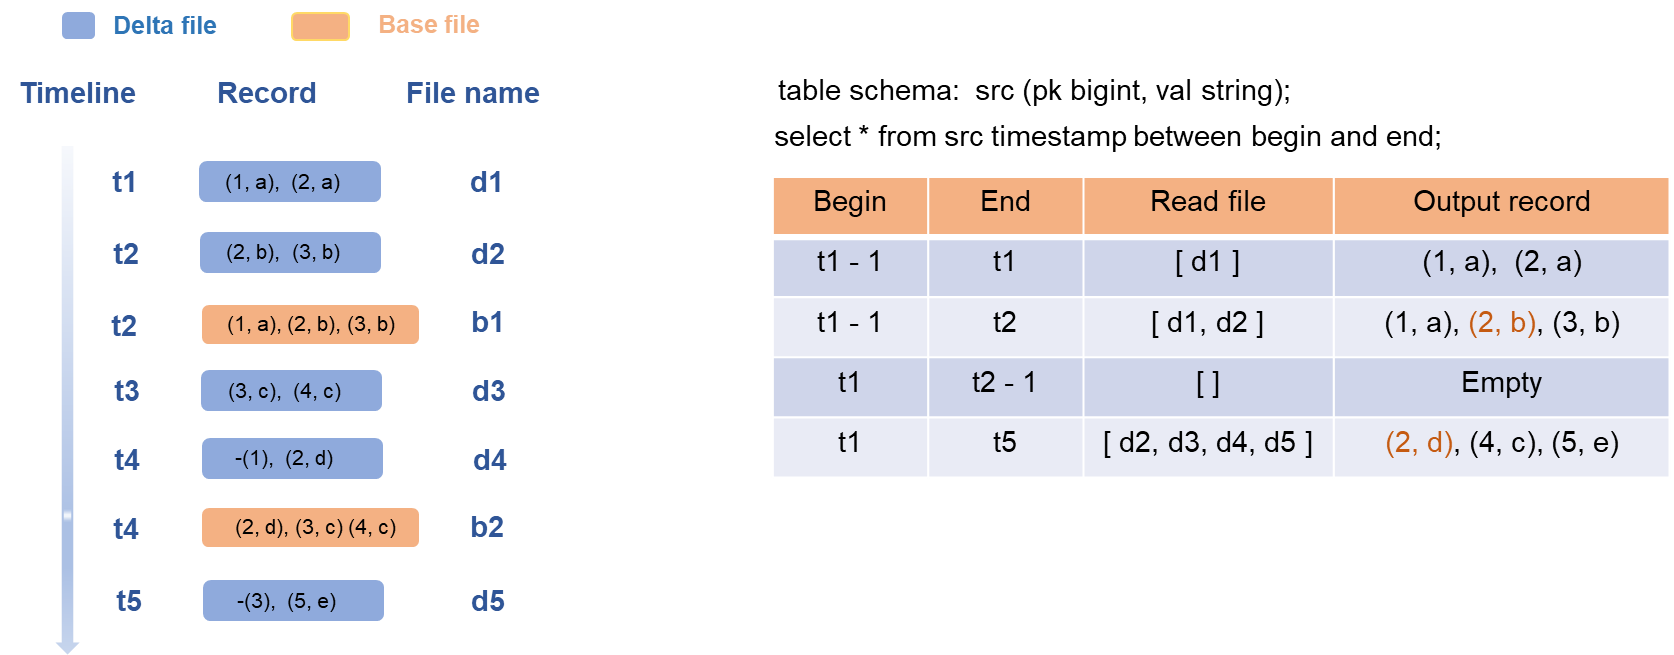
El diagrama ilustra una consulta incremental sobre una tabla transaccional llamada src con dos columnas: pk y val.
Cronología de cambios en los datos:
Se ejecutan cinco transacciones de escritura entre los momentos t1 y t5, lo que genera cinco archivos delta.
La compactación se ejecuta en t2 y t4, y produce dos archivos base: b1 y b2.
Al enviar una instrucción SQL de consulta incremental, MaxCompute realiza lo siguiente:
Analiza el rango de versiones especificado (valores
BeginyEnd).Localiza todos los archivos delta cuyas marcas de tiempo se encuentran dentro de dicho rango.
Combina los datos de esos archivos delta conforme a la directiva de combinación indicada.
Devuelve el resultado combinado como salida de la consulta.
Motivo de la exclusión de archivos base: La compactación y el clustering reorganizan los registros existentes para optimizar el almacenamiento, pero no agregan nuevos registros lógicos. Incluir archivos base duplicaría datos ya capturados en archivos delta anteriores. MaxCompute excluye los archivos base por diseño para garantizar que los resultados incrementales reflejen únicamente escrituras nuevas.
Semántica del rango de versiones
El rango de versiones se define mediante los valores Begin y End. Cada valor identifica una versión temporal específica en el historial de transacciones de la tabla.
|
|
|
Delta files read |
Result |
|
t1-1 |
t1 |
d1 |
Registros del archivo delta d1 |
|
t2 |
sin especificar |
d1, d2 |
Registros de los archivos delta d1 y d2 |
|
t1 |
t2-1 |
Ninguna |
Vacío: no hubo transacciones de escritura en el intervalo (t1, t2) |
Limitaciones
Exclusión de archivos base: Los registros reorganizados por compactación o clustering no aparecen en los resultados de consultas incrementales. Dado que estas operaciones no generan nuevos registros lógicos, excluir sus archivos de salida no omite ningún dato nuevo.
Resultados vacíos en rangos sin actividad: Si el rango especificado cae completamente entre dos puntos de compactación sin transacciones de escritura, la consulta devuelve filas vacías.