La codificación de diccionario comprime las columnas de baja cardinalidad. Para ello, reemplaza los valores de cadena repetidos por códigos numéricos compactos. Esto reduce el almacenamiento y acelera las consultas GROUP BY y FILTER.
Funcionamiento
Hologres codifica los datos sin procesar de las columnas como valores NUMERIC y mantiene un esquema de codificación correspondiente. Durante la lectura, se decodifican los datos al vuelo mediante ese esquema.
Este enfoque resulta más eficaz en columnas TEXT donde los valores se repiten con frecuencia, por ejemplo, campos de estado, etiquetas de categoría o códigos de región. Cuando la tasa de recurrencia de una columna alcanza el 90 % o más, la codificación reduce significativamente el almacenamiento y agiliza las comparaciones de cadenas. El costo es una pequeña sobrecarga de decodificación.
En columnas con una tasa de recurrencia baja (donde aproximadamente la mitad de los valores son únicos) o en columnas que se usan en operaciones join, la sobrecarga de codificación y decodificación supera la ventaja obtenida. Evite habilitar la codificación de diccionario en estas columnas.
Si se establece auto y la tasa de recurrencia de una columna se mantiene por debajo del 90 %, Hologres no habilita la codificación. En este caso, la columna se almacena sin asignación de diccionario.
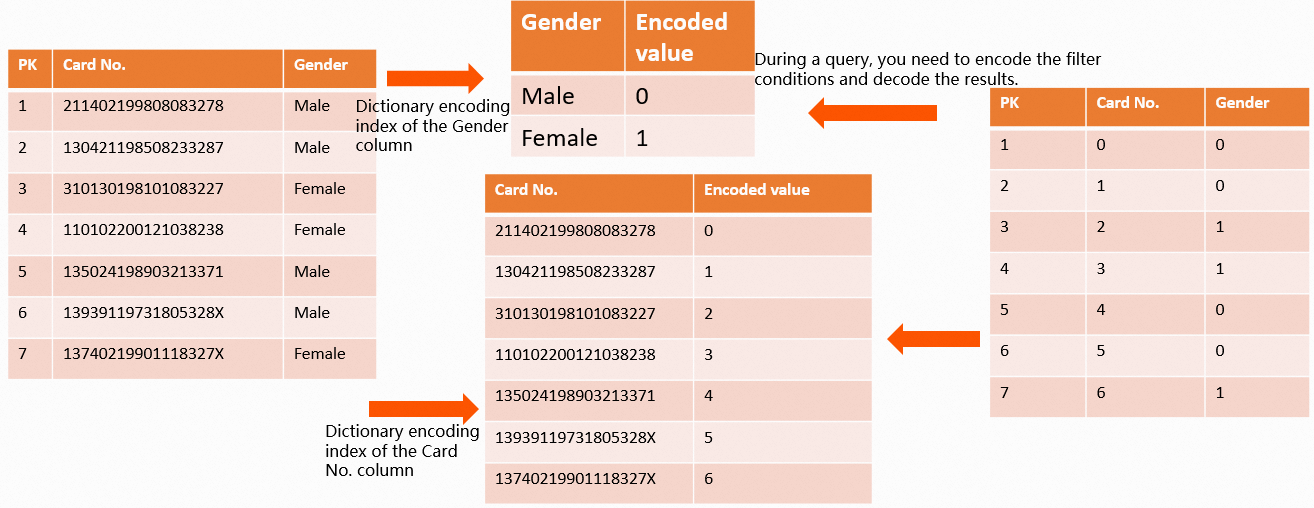
Configure la codificación de diccionario
La codificación de diccionario se aplica por columna mediante la propiedad de tabla dictionary_encoding_columns. Existen dos formas de sintaxis disponibles según su versión de Hologres.
Hologres V2.1 y versiones posteriores: cláusula WITH
CREATE TABLE <table_name> (...) WITH (dictionary_encoding_columns = '[<columnName>{:[on|off|auto]}[,...]]');Todas las versiones de Hologres: instrucción CALL
CREATE TABLE <table_name> (...);
CALL set_table_property('table_name', 'dictionary_encoding_columns', '[<columnName>{:[on|off|auto]}[,...]]');
La propiedad dictionary_encoding_columns acepta una lista de nombres de columna separados por comas. Cada nombre puede incluir un valor opcional:
|
Valor |
Comportamiento |
|
|
Habilita la codificación de diccionario para la columna. |
|
|
Deshabilita la codificación de diccionario para la columna. |
|
|
Hologres evalúa la tasa de recurrencia de la columna durante la escritura. Si la tasa alcanza el 90 % o más, se habilita la codificación; de lo contrario, la columna se almacena sin codificación. |
Comportamiento predeterminado por versión:
Hologres V0.8 y versiones anteriores: la codificación de diccionario se habilita para todas las columnas TEXT.
Hologres V0.9 y versiones posteriores: todas las columnas TEXT tienen el valor
autode forma predeterminada. La codificación se activa solo cuando la tasa de recurrencia alcanza el 90 % o más.
Para modifique las asignaciones de diccionario después de crear una tabla, use ALTER TABLE o update_table_property. Los cambios surten efecto de forma asíncrona, ya que las asignaciones se construyen o eliminan en segundo contexto.
Tipos de almacenamiento compatible
La codificación de diccionario solo es compatible con tablas que usan almacenamiento por columnas o almacenamiento híbrido de filas y columnas. Las columnas especificadas por dictionary_encoding_columns pueden ser nulas.
Prácticas recomendadas
**Use auto como valor predeterminado.** Así evita tanto la penalización de almacenamiento por oportunidades de codificación desaprovechadas como la sobrecarga de decodificación por codificaciones innecesarias. Deshabilitar por completo la codificación de diccionario aumenta el consumo de almacenamiento.
Enfoque la codificación en columnas TEXT de alta recurrencia. Este método ofrece la mayor ventaja en columnas como códigos de estado, etiquetas de categoría e identificadores de región. Se trata de campos con pocos valores distintos que se repiten en muchas filas.
Evite codificar datos JSON almacenados como TEXT. Los valores JSON rara vez se repiten de forma exacta, por lo que la codificación añade sobrecarga sin reducir el almacenamiento.
No codifique todas las columnas. Aplicar la codificación de diccionario a todas las columnas genera una sobrecarga innecesaria de codificación y decodificación. Esto incluye columnas de alta cardinalidad o columnas de unión. Dicha sobrecarga puede ralentizar las consultas en lugar de acelerarlas.
Ejemplos
Hologres V2.1 y versiones posteriores:
CREATE TABLE tbl (
    a int NOT NULL,
    b text NOT NULL,
    c text NOT NULL
)
WITH (
    dictionary_encoding_columns = 'a:on,b:off,c:auto'
);

-- Modify dictionary mappings for all columns.
ALTER TABLE tbl SET (dictionary_encoding_columns = 'a:off');
Todas las versiones de Hologres:
-- Create a table and set dictionary mappings.
BEGIN;
CREATE TABLE tbl (
    a int NOT NULL,
    b text NOT NULL,
    c text NOT NULL
);
CALL set_table_property('tbl', 'dictionary_encoding_columns', 'a:on,b:off,c:auto');
COMMIT;

-- Modify dictionary mappings for all columns.
-- Columns b and c are TEXT columns, so they retain dictionary mappings by default.
CALL set_table_property('tbl', 'dictionary_encoding_columns', 'a:off');

-- Modify dictionary mappings for a single column only.
CALL update_table_property('tbl', 'dictionary_encoding_columns', 'c:off');
ALTER TABLEyset_table_propertyaplican los cambios a todas las columnas. Para actualice una sola columna sin afectar a las demás, useupdate_table_property.