Elegir las propiedades de tabla adecuadas en Hologres según sus patrones de consulta reduce la cantidad de datos escaneados, el número de archivos accedidos y las operaciones de E/S. Esto se traduce en una menor latencia y un mayor número de consultas por segundo (QPS). Esta guía relaciona seis escenarios comunes de consulta con la configuración óptima de formato de almacenamiento, clave principal, clave de distribución, clave de clúster, particionamiento e índice de mapa de bits para cada caso.
Elegir un formato de almacenamiento
Hologres admite tres formatos de almacenamiento: orientado a filas, orientado a columnas e híbrido de filas y columnas. Para obtener detalles sobre cada formato, consulte Set up data orientation.
Utilice el siguiente árbol de decisión para seleccionar un formato. Si su carga de trabajo aún no está bien definida, comience con el almacenamiento híbrido de filas y columnas, ya que equilibra las ventajas y desventajas en la más amplia variedad de patrones de consulta.
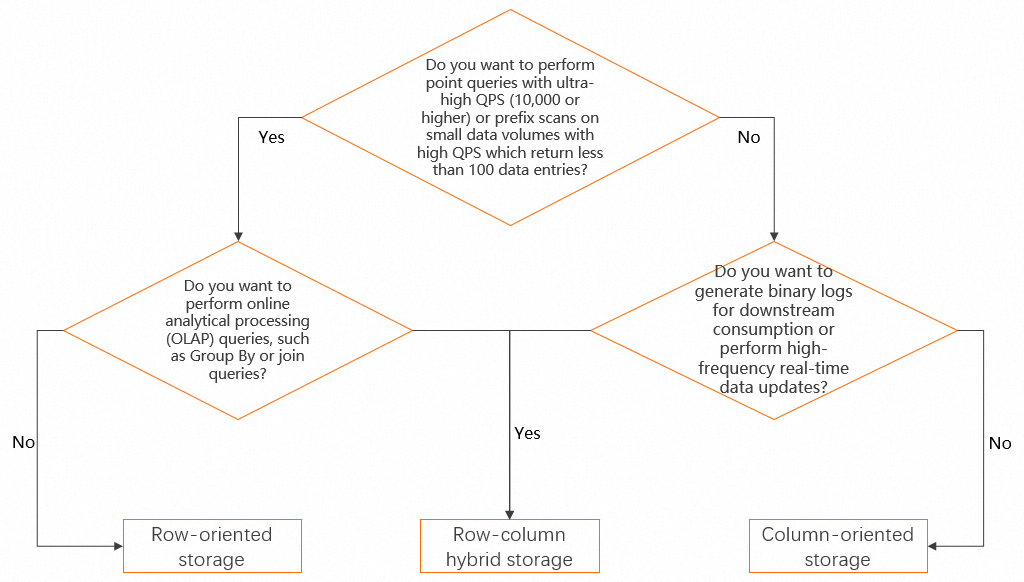
Referencia rápida de propiedades
Cada propiedad de tabla se enfoca en una capa específica de la ejecución de consultas. Comprender la función de cada una le ayudará a elegir la combinación adecuada para su escenario.
|
Propiedad |
Función |
Ideal para |
|
Clave principal |
Habilita Fixed Plan para búsquedas directas de filas |
Consultas puntuales con QPS ultraalto |
|
Clave de distribución |
Ubica filas con el mismo valor de clave en el mismo shard; reduce la redistribución entre shards |
Consultas de agregación; consultas JOIN |
|
Clave de clúster |
Ordena físicamente las filas por clave dentro de cada archivo; reduce la E/S en escaneos por rango o igualdad |
Escaneos por prefijo; consultas con filtro de valor único |
|
|
Ordena los datos dentro de cada archivo según esta columna; reduce los archivos escaneados en predicados de rango |
Consultas con filtros basados en tiempo |
|
Particionamiento |
Elimina particiones completas antes del escaneo |
Tablas grandes con patrones de acceso basados en tiempo |
|
Índice de mapa de bits |
Asigna cada valor distinto a las filas coincidentes; acota los escaneos en filtros de valor único |
Consultas con filtro de valor único |
Configurar propiedades de tabla según el escenario de consulta
Una vez definido el formato de almacenamiento, alinee las propiedades restantes de la tabla con sus patrones de consulta. Cada escenario descrito a continuación detalla la configuración recomendada, explica el mecanismo subyacente y muestra los resultados de rendimiento medidos.
Los ejemplos de esta sección utilizan una instancia de Hologres de 64 unidades de cómputo (CU) y el conjunto de datos TPC-H de 100 GB. El conjunto de datos contiene dos tablas: la tabla Orders (dondeo_orderkeyidentifica de forma única un pedido) y la tabla Lineitem (dondel_orderkeyyl_linenumberidentifican conjuntamente una línea de pedido). Estas pruebas se basan en la metodología de evaluación comparativa TPC-H, pero no cumplen todos sus requisitos; por lo tanto, los resultados no pueden compararse con los publicados oficialmente por TPC-H. Si su tabla atiende múltiples patrones de consulta con diferentes campos de filtro o JOIN, configure las propiedades según la consulta más frecuente o la más sensible al rendimiento.
Escenario 1: Consultas puntuales con QPS ultraalto
Patrón de consulta
Se requiere ejecutar decenas de miles de consultas puntuales por segundo sobre la tabla Orders. Es posible especificar el campo o_orderkey para localizar una fila de datos.
SELECT * FROM orders WHERE o_orderkey = ?;Configuración
Establezca el campo de filtro como clave principal. Hologres genera un Fixed Plan para búsquedas por clave principal, lo que evita la ruta general de planificación de consultas y reduce significativamente la sobrecarga de ejecución. Para más detalles, consulte Accelerate SQL execution with Fixed Plan.
Cómo funciona
Fixed Plan omite los pasos de optimización de consultas innecesarios para búsquedas de una sola fila y enruta las solicitudes directamente a la fila destino. Sin una clave principal, el motor recurre a un escaneo completo del shard.
Resultados de rendimiento (500 consultas simultáneas, tabla orientada a filas o híbrida de filas y columnas)
|
Configuración |
QPS promedio |
Latencia promedio |
|
Con clave principal configurada |
~104,000 |
~4 ms |
|
Sin clave principal |
~16,000 |
~30 ms |
Para consultar la sentencia DDL, véase Scenario 1 DDL.
Escenario 2: Escaneos por prefijo en conjuntos pequeños con alto QPS
Patrón de consulta
Se necesitan procesar decenas de miles de QPS mediante consultas basadas en un campo de la clave principal, donde el conjunto de datos devuelto contiene varias o decenas de registros.
SELECT * FROM lineitem WHERE l_orderkey = ?;Esta consulta recupera todas las líneas de un pedido, lo que constituye un escaneo por prefijo sobre una clave principal compuesta.
Configuración
Aplique las siguientes tres configuraciones:
Orden de la clave principal: coloque el campo de filtro en primer lugar dentro de la clave principal compuesta. Utilice
(l_orderkey, l_linenumber), no(l_linenumber, l_orderkey). Esto permite que Hologres evalúe el predicado de igualdad contra la clave principal sin escanear filas no relacionadas.Clave de distribución: establezca el campo de filtro como clave de distribución (
l_orderkey). Los datos de cada pedido se almacenan en un solo shard, por lo que la consulta accede exactamente a un shard en lugar de a todos.Clave de clúster (solo para almacenamiento orientado a columnas o híbrido): defina el campo de filtro como clave de clúster (
l_orderkey). Dentro de cada archivo, las filas se ordenan según esta clave, lo que reduce la E/S al escanear un rango contiguo.
Con estas propiedades configuradas, habilite Fixed Plan para escaneos por prefijo estableciendo el parámetro Grand Unified Configuration (GUC) hg_experimental_enable_fixed_dispatcher_for_scan en on. Para más detalles, consulte Accelerate SQL execution with Fixed Plan.
Cómo funciona
La combinación de un orden correcto en la clave principal, una clave de distribución con ubicación conjunta y una clave de clúster garantiza que todas las filas coincidentes estén en un mismo shard, físicamente adyacentes en el almacenamiento y direccionadas directamente por Fixed Plan.
Resultados de rendimiento (tabla orientada a filas o híbrida de filas y columnas)
|
Configuración |
Consultas simultáneas |
QPS promedio |
Latencia promedio |
|
Tres propiedades configuradas |
500 |
~37,000 |
~13 ms |
|
Propiedades no configuradas |
1 |
~60 |
~16 ms |
Para consultar la sentencia DDL, véase Scenario 2 DDL.
Escenario 3: Consultas con condiciones de filtro basadas en tiempo
Patrón de consulta
-- Original query
SELECT
    l_returnflag,
    l_linestatus,
    sum(l_quantity) AS sum_qty,
    sum(l_extendedprice) AS sum_base_price,
    sum(l_extendedprice * (1 - l_discount)) AS sum_disc_price,
    sum(l_extendedprice * (1 - l_discount) * (1 + l_tax)) AS sum_charge,
    avg(l_quantity) AS avg_qty,
    avg(l_extendedprice) AS avg_price,
    avg(l_discount) AS avg_disc,
    count(*) AS count_order
FROM
    lineitem
WHERE
    l_shipdate <= date '1998-12-01' - interval '120' day
GROUP BY
    l_returnflag,
    l_linestatus
ORDER BY
    l_returnflag,
    l_linestatus;

-- Modified query used in the performance test (narrowed time range to highlight the effect)
SELECT ... FROM lineitem
WHERE
    l_year='1992'               -- filters to a single partition
    AND l_shipdate <= date '1992-12-01'
...;
Configuración
Particionar por tiempo: agregue una columna
l_yeary utilícela como clave de partición para dividir la tabla por año. Decida si debe particionar la tabla o solo configurar la propiedadevent_time_columnsegún el volumen de datos y los requisitos del negocio. Revise los límites y notas de uso en CREATE PARTITION TABLE antes de crear particiones.event_time_column: establezcal_shipdatecomoevent_time_column(clave de segmento). Esto asegura que los datos dentro de los archivos del shard se ordenen según la propiedadevent_time_column, lo que reduce el número de archivos a escanear. Para más detalles, consulte Event Time Column (Segment Key).
Cómo funciona
El particionamiento elimina particiones completas antes de que la consulta lea cualquier archivo. Posteriormente, event_time_column descarta archivos individuales dentro de la partición restante al ordenar los datos de cada archivo según la columna configurada.
Resultados de rendimiento (tabla orientada a columnas)
|
Configuración |
Archivos escaneados |
|
Partición + |
80 archivos en 1 partición |
|
Sin partición; |
320 archivos |
EjecuteEXPLAIN ANALYZEpara inspeccionar los recuentos reales de escaneo. El parámetroPartitions selectedindica cuántas particiones se accedieron; el parámetrodopmuestra cuántos archivos se escanearon.
Para consultar la sentencia DDL, véase Scenario 3 DDL.
Escenario 4: Consultas con filtros de valor único no temporal
Patrón de consulta
SELECT
    ...
FROM
    lineitem
WHERE
    l_shipmode IN ('FOB', 'AIR');
Configuración
Clave de clúster: establezca
l_shipmodecomo clave de clúster. Las filas con el mismo valor del_shipmodese almacenan consecutivamente en cada archivo, de modo que el motor lee un bloque contiguo más pequeño en lugar de filas dispersas.Índice de mapa de bits: configure
l_shipmodecomo columna de mapa de bits. Este índice asigna cada valor distinto a las filas que lo contienen, lo que permite al motor saltar directamente a las filas coincidentes sin leer datos no relacionados.
Cómo funciona
La clave de clúster reduce la E/S al agrupar físicamente las filas coincidentes. El índice de mapa de bits acota aún más el escaneo filtrando a nivel de bloque antes de leer cualquier dato de fila.
Resultados de rendimiento (tabla orientada a columnas)
|
Configuración |
Filas leídas |
Duración de la consulta |
|
Clave de clúster + índice de mapa de bits configurados |
170 millones |
0.71 s |
|
Ninguno configurado |
600 millones (tabla completa) |
2.41 s |
Verifique el número de filas leídas mediante el parámetroread_rowsen los registros de consultas lentas. Consulte Get and analyze slow query logs . Para confirmar que se aplica el índice de mapa de bits, busque la palabra claveBitmap Filteren el plan de ejecución.
Para consultar la sentencia DDL, véase Scenario 4 DDL.
Escenario 5: Consultas de agregación en un solo campo
Patrón de consulta
SELECT
    l_suppkey,
    sum(l_extendedprice * (1 - l_discount))
FROM
    lineitem
GROUP BY
    l_suppkey;
Configuración
Establezca el campo de GROUP BY (l_suppkey) como clave de distribución. Cuando los datos ya están distribuidos según la clave de agregación, cada shard calcula su agregación local de forma independiente, sin necesidad de mover datos entre shards.
Cómo funciona
Sin una clave de distribución coincidente, el motor redistribuye todas las filas hacia un conjunto de shards reductores antes de agregar. Una clave de distribución coincidente evita que se transfiera una gran cantidad de datos entre shards.
Resultados de rendimiento (tabla orientada a columnas)
|
Configuración |
Datos redistribuidos |
Duración de ejecución |
|
|
~0.21 GB |
2.30 s |
|
Otro campo como clave de distribución |
~8.16 GB |
3.68 s |
Verifique el volumen de datos redistribuidos mediante el parámetro shuffle_bytes en los registros de consultas lentas. Consulte Get and analyze slow query logs .
Para consultar la sentencia DDL, véase Scenario 5 DDL.
Escenario 6: Consultas JOIN entre múltiples tablas
Patrón de consulta
SELECT
    o_orderpriority,
    count(*) AS order_count
FROM
    orders
WHERE
    o_orderdate >= date '1996-07-01'
    AND o_orderdate < date '1996-07-01' + interval '3' month
    AND EXISTS (
        SELECT
            *
        FROM
            lineitem
        WHERE
            l_orderkey = o_orderkey    -- join condition
            AND l_commitdate < l_receiptdate)
GROUP BY
    o_orderpriority
ORDER BY
    o_orderpriority;
Configuración
Establezca los campos JOIN como claves de distribución en ambas tablas:
Lineitem:
l_orderkeycomo clave de distribuciónOrders:
o_orderkeycomo clave de distribución
Cuando ambas tablas se distribuyen con la misma clave, las filas coincidentes de cada tabla ya se encuentran ubicadas conjuntamente en el mismo shard. El JOIN se ejecuta localmente sin redistribuir ninguna tabla a través de la red.
Cómo funciona
Si las tablas se distribuyen con claves diferentes, es necesario redistribuir una gran cantidad de datos entre shards para ejecutar el JOIN. Alinear las claves de distribución con los campos JOIN evita esta transferencia masiva de datos y convierte una operación limitada por la red en una operación local.
Resultados de rendimiento (ambas tablas orientadas a columnas)
|
Configuración |
Datos redistribuidos |
Duración de ejecución |
|
Campos JOIN como claves de distribución en ambas tablas |
~0.45 GB |
2.19 s |
|
Claves de distribución no alineadas con campos JOIN |
~6.31 GB |
5.55 s |
Verifique el volumen de datos redistribuidos mediante el parámetro shuffle_bytes en los registros de consultas lentas. Consulte Obtener y analizar registros de consultas lentas .
Para consultar las sentencias DDL, véase Scenario 6 DDL.
(Opcional) Asignar tablas a grupos de tablas
Si su instancia de Hologres tiene más de 256 núcleos y atiende diversas cargas de trabajo, configure varios grupos de tablas y asigne cada tabla al grupo correspondiente durante su creación. Esto aísla el uso de recursos entre cargas de trabajo. Para más detalles, consulte Best practices for table group setup.
Apéndice: Sentencias DDL
DDL del escenario 1
-- Create the Orders table with a primary key.
-- To create the table without a primary key, remove PRIMARY KEY from the O_ORDERKEY column.
DROP TABLE IF EXISTS orders;
BEGIN;
CREATE TABLE orders(
    O_ORDERKEY       BIGINT         NOT NULL PRIMARY KEY
    ,O_CUSTKEY       INT            NOT NULL
    ,O_ORDERSTATUS   TEXT           NOT NULL
    ,O_TOTALPRICE    DECIMAL(15,2)  NOT NULL
    ,O_ORDERDATE     TIMESTAMPTZ    NOT NULL
    ,O_ORDERPRIORITY TEXT           NOT NULL
    ,O_CLERK         TEXT           NOT NULL
    ,O_SHIPPRIORITY  INT            NOT NULL
    ,O_COMMENT       TEXT           NOT NULL
);
CALL SET_TABLE_PROPERTY('orders', 'orientation', 'row');
CALL SET_TABLE_PROPERTY('orders', 'clustering_key', 'o_orderkey');
CALL SET_TABLE_PROPERTY('orders', 'distribution_key', 'o_orderkey');
COMMIT;
DDL del escenario 2
-- Create the Lineitem table with properties configured for prefix scan optimization.
DROP TABLE IF EXISTS lineitem;
BEGIN;
CREATE TABLE lineitem
(
    L_ORDERKEY      BIGINT      NOT NULL,
    L_PARTKEY       INT         NOT NULL,
    L_SUPPKEY       INT         NOT NULL,
    L_LINENUMBER    INT         NOT NULL,
    L_QUANTITY      DECIMAL(15,2) NOT NULL,
    L_EXTENDEDPRICE DECIMAL(15,2) NOT NULL,
    L_DISCOUNT      DECIMAL(15,2) NOT NULL,
    L_TAX           DECIMAL(15,2) NOT NULL,
    L_RETURNFLAG    TEXT        NOT NULL,
    L_LINESTATUS    TEXT        NOT NULL,
    L_SHIPDATE      TIMESTAMPTZ NOT NULL,
    L_COMMITDATE    TIMESTAMPTZ NOT NULL,
    L_RECEIPTDATE   TIMESTAMPTZ NOT NULL,
    L_SHIPINSTRUCT  TEXT        NOT NULL,
    L_SHIPMODE      TEXT        NOT NULL,
    L_COMMENT       TEXT        NOT NULL,
    PRIMARY KEY (L_ORDERKEY,L_LINENUMBER)
);
CALL set_table_property('lineitem', 'orientation', 'row');
-- CALL set_table_property('lineitem', 'clustering_key', 'L_ORDERKEY,L_SHIPDATE');
CALL set_table_property('lineitem', 'distribution_key', 'L_ORDERKEY');
COMMIT;
DDL del escenario 3
-- Create a partitioned Lineitem table partitioned by year.
-- The non-partitioned version uses the same DDL as Scenario 2.
DROP TABLE IF EXISTS lineitem;
BEGIN;
CREATE TABLE lineitem
(
    L_ORDERKEY      BIGINT      NOT NULL,
    L_PARTKEY       INT         NOT NULL,
    L_SUPPKEY       INT         NOT NULL,
    L_LINENUMBER    INT         NOT NULL,
    L_QUANTITY      DECIMAL(15,2) NOT NULL,
    L_EXTENDEDPRICE DECIMAL(15,2) NOT NULL,
    L_DISCOUNT      DECIMAL(15,2) NOT NULL,
    L_TAX           DECIMAL(15,2) NOT NULL,
    L_RETURNFLAG    TEXT        NOT NULL,
    L_LINESTATUS    TEXT        NOT NULL,
    L_SHIPDATE      TIMESTAMPTZ NOT NULL,
    L_COMMITDATE    TIMESTAMPTZ NOT NULL,
    L_RECEIPTDATE   TIMESTAMPTZ NOT NULL,
    L_SHIPINSTRUCT  TEXT        NOT NULL,
    L_SHIPMODE      TEXT        NOT NULL,
    L_COMMENT       TEXT        NOT NULL,
    L_YEAR          TEXT        NOT NULL,
    PRIMARY KEY (L_ORDERKEY,L_LINENUMBER,L_YEAR)
)
PARTITION BY LIST (L_YEAR);
CALL set_table_property('lineitem', 'clustering_key', 'L_ORDERKEY,L_SHIPDATE');
CALL set_table_property('lineitem', 'segment_key', 'L_SHIPDATE');
CALL set_table_property('lineitem', 'distribution_key', 'L_ORDERKEY');
COMMIT;
DDL del escenario 4
-- Create the Lineitem table without clustering key or bitmap index (baseline).
-- For the optimized version, add the clustering key and bitmap_columns properties as shown in the comments.
DROP TABLE IF EXISTS lineitem;
BEGIN;
CREATE TABLE lineitem
(
    L_ORDERKEY      BIGINT      NOT NULL,
    L_PARTKEY       INT         NOT NULL,
    L_SUPPKEY       INT         NOT NULL,
    L_LINENUMBER    INT         NOT NULL,
    L_QUANTITY      DECIMAL(15,2) NOT NULL,
    L_EXTENDEDPRICE DECIMAL(15,2) NOT NULL,
    L_DISCOUNT      DECIMAL(15,2) NOT NULL,
    L_TAX           DECIMAL(15,2) NOT NULL,
    L_RETURNFLAG    TEXT        NOT NULL,
    L_LINESTATUS    TEXT        NOT NULL,
    L_SHIPDATE      TIMESTAMPTZ NOT NULL,
    L_COMMITDATE    TIMESTAMPTZ NOT NULL,
    L_RECEIPTDATE   TIMESTAMPTZ NOT NULL,
    L_SHIPINSTRUCT  TEXT        NOT NULL,
    L_SHIPMODE      TEXT        NOT NULL,
    L_COMMENT       TEXT        NOT NULL,
    PRIMARY KEY (L_ORDERKEY,L_LINENUMBER)
);
CALL set_table_property('lineitem', 'segment_key', 'L_SHIPDATE');
CALL set_table_property('lineitem', 'distribution_key', 'L_ORDERKEY');
CALL set_table_property('lineitem', 'bitmap_columns', 'l_orderkey,l_partkey,l_suppkey,l_linenumber,l_returnflag,l_linestatus,l_shipinstruct,l_comment');
COMMIT;
DDL del escenario 5
-- Create the Lineitem table with the GROUP BY field configured as the distribution key.
DROP TABLE IF EXISTS lineitem;
BEGIN;
CREATE TABLE lineitem
(
    L_ORDERKEY      BIGINT      NOT NULL,
    L_PARTKEY       INT         NOT NULL,
    L_SUPPKEY       INT         NOT NULL,
    L_LINENUMBER    INT         NOT NULL,
    L_QUANTITY      DECIMAL(15,2) NOT NULL,
    L_EXTENDEDPRICE DECIMAL(15,2) NOT NULL,
    L_DISCOUNT      DECIMAL(15,2) NOT NULL,
    L_TAX           DECIMAL(15,2) NOT NULL,
    L_RETURNFLAG    TEXT        NOT NULL,
    L_LINESTATUS    TEXT        NOT NULL,
    L_SHIPDATE      TIMESTAMPTZ NOT NULL,
    L_COMMITDATE    TIMESTAMPTZ NOT NULL,
    L_RECEIPTDATE   TIMESTAMPTZ NOT NULL,
    L_SHIPINSTRUCT  TEXT        NOT NULL,
    L_SHIPMODE      TEXT        NOT NULL,
    L_COMMENT       TEXT        NOT NULL,
    PRIMARY KEY (L_ORDERKEY,L_LINENUMBER,L_SUPPKEY)
);
CALL set_table_property('lineitem', 'segment_key', 'L_COMMITDATE');
CALL set_table_property('lineitem', 'clustering_key', 'L_ORDERKEY,L_SHIPDATE');
CALL set_table_property('lineitem', 'distribution_key', 'L_SUPPKEY');
COMMIT;
DDL del escenario 6
DROP TABLE IF EXISTS LINEITEM;

BEGIN;
CREATE TABLE LINEITEM
(
    L_ORDERKEY      BIGINT      NOT NULL,
    L_PARTKEY       INT         NOT NULL,
    L_SUPPKEY       INT         NOT NULL,
    L_LINENUMBER    INT         NOT NULL,
    L_QUANTITY      DECIMAL(15,2) NOT NULL,
    L_EXTENDEDPRICE DECIMAL(15,2) NOT NULL,
    L_DISCOUNT      DECIMAL(15,2) NOT NULL,
    L_TAX           DECIMAL(15,2) NOT NULL,
    L_RETURNFLAG    TEXT        NOT NULL,
    L_LINESTATUS    TEXT        NOT NULL,
    L_SHIPDATE      TIMESTAMPTZ NOT NULL,
    L_COMMITDATE    TIMESTAMPTZ NOT NULL,
    L_RECEIPTDATE   TIMESTAMPTZ NOT NULL,
    L_SHIPINSTRUCT  TEXT        NOT NULL,
    L_SHIPMODE      TEXT        NOT NULL,
    L_COMMENT       TEXT        NOT NULL,
    PRIMARY KEY (L_ORDERKEY,L_LINENUMBER)
);
CALL set_table_property('LINEITEM', 'clustering_key', 'L_SHIPDATE,L_ORDERKEY');
CALL set_table_property('LINEITEM', 'segment_key', 'L_SHIPDATE');
CALL set_table_property('LINEITEM', 'distribution_key', 'L_ORDERKEY');
CALL set_table_property('LINEITEM', 'bitmap_columns', 'L_ORDERKEY,L_PARTKEY,L_SUPPKEY,L_LINENUMBER,L_RETURNFLAG,L_LINESTATUS,L_SHIPINSTRUCT,L_SHIPMODE,L_COMMENT');
CALL set_table_property('LINEITEM', 'dictionary_encoding_columns', 'L_RETURNFLAG,L_LINESTATUS,L_SHIPINSTRUCT,L_SHIPMODE,L_COMMENT');
COMMIT;

DROP TABLE IF EXISTS ORDERS;

BEGIN;
CREATE TABLE ORDERS
(
    O_ORDERKEY      BIGINT      NOT NULL PRIMARY KEY,
    O_CUSTKEY       INT         NOT NULL,
    O_ORDERSTATUS   TEXT        NOT NULL,
    O_TOTALPRICE    DECIMAL(15,2) NOT NULL,
    O_ORDERDATE     timestamptz NOT NULL,
    O_ORDERPRIORITY TEXT        NOT NULL,
    O_CLERK         TEXT        NOT NULL,
    O_SHIPPRIORITY  INT         NOT NULL,
    O_COMMENT       TEXT        NOT NULL
);
CALL set_table_property('ORDERS', 'segment_key', 'O_ORDERDATE');
CALL set_table_property('ORDERS', 'distribution_key', 'O_ORDERKEY');
CALL set_table_property('ORDERS', 'bitmap_columns', 'O_ORDERKEY,O_CUSTKEY,O_ORDERSTATUS,O_ORDERPRIORITY,O_CLERK,O_SHIPPRIORITY,O_COMMENT');
CALL set_table_property('ORDERS', 'dictionary_encoding_columns', 'O_ORDERSTATUS,O_ORDERPRIORITY,O_CLERK,O_COMMENT');
COMMIT;
Referencias
Para consultar las sentencias de lenguaje de definición de datos (DDL) aplicables a tablas internas de Hologres, véase: