Este tema describe los parámetros clave para el desarrollo en SQL y proporciona explicaciones junto con ejemplos de uso.
table.exec.sink.keyed-shuffle
Para resolver problemas de desorden al escribir datos en una tabla con clave primaria, utilice el parámetro table.exec.sink.keyed-shuffle para ejecutar un hash shuffle. Esta operación garantiza que los registros con la misma clave primaria se enruten a la misma instancia del operador, lo cual mitiga los problemas de desorden.
Notas de uso
La operación de hash shuffle solo es efectiva si el operador ascendente garantiza el orden de los registros de actualización para la misma clave primaria. De lo contrario, esta operación no puede resolver el problema de desorden.
Si modifica el paralelismo de un operador en modo experto, las siguientes reglas de paralelismo no aplican.
Valores disponibles
AUTO (predeterminado): Si el paralelismo del sink no es 1 y difiere del paralelismo del operador ascendente, Flink ejecuta automáticamente un hash shuffle sobre la clave primaria cuando los datos fluyen hacia el sink.
FORCE: Si el paralelismo del sink no es 1, Flink fuerza un hash shuffle sobre la clave primaria cuando los datos fluyen hacia el sink.
NONE: Flink no ejecuta un hash shuffle basado en el paralelismo del sink y del operador ascendente.
Ejemplos
-
Establecer el parámetro en AUTO
-
Cree un trabajo de streaming SQL, copie el siguiente código SQL y deploy el trabajo. El código establece explícitamente el paralelismo del sink en 2.
CREATE TEMPORARY TABLE s1 (
  a INT,
  b INT,
  ts TIMESTAMP(3)
) WITH (
  'connector'='datagen',
  'rows-per-second'='1',
  'fields.ts.kind'='random','fields.ts.max-past'='5s',
  'fields.b.kind'='random','fields.b.min'='0','fields.b.max'='10'
);
CREATE TEMPORARY TABLE sink (
  a INT,
  b INT,
  ts TIMESTAMP(3),
  PRIMARY KEY (a) NOT ENFORCED
) WITH (
  'connector'='print',
   --You can directly specify the sink parallelism by using the sink.parallelism parameter.
  'sink.parallelism'='2'
);
INSERT INTO sink SELECT * FROM s1;
--You can also specify the sink parallelism by using dynamic table options.
--INSERT INTO sink /*+ OPTIONS('sink.parallelism' = '2') */ SELECT * FROM s1;
En la página Deployments, en la pestaña Configuration, dentro de la sección Resources, establezca Parallelism en 1. En la sección Parameters bajo Other Configuration, no configure el parámetro
table.exec.sink.keyed-shuffleo agregue explícitamentetable.exec.sink.keyed-shuffle: AUTO(ambos tienen el mismo efecto).-
Start el trabajo. En la pestaña Status, la conexión de datos desde el operador ascendente hasta el sink es HASH.
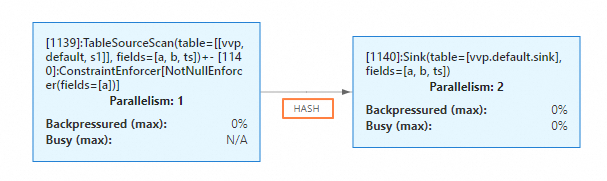
-
-
Establecer el parámetro en FORCE
-
Cree un trabajo de streaming SQL, copie el siguiente código SQL y deploy el trabajo. Este código no especifica explícitamente el paralelismo del sink.
CREATE TEMPORARY TABLE s1 (
  a INT,
  b INT,
  ts TIMESTAMP(3)
) WITH (
  'connector'='datagen',
  'rows-per-second'='1',
  'fields.ts.kind'='random','fields.ts.max-past'='5s',
  'fields.b.kind'='random','fields.b.min'='0','fields.b.max'='10'
);
CREATE TEMPORARY TABLE sink (
  a INT,
  b INT,
  ts TIMESTAMP(3),
  PRIMARY KEY (a) NOT ENFORCED
) WITH (
  'connector'='print'
);
INSERT INTO sink
SELECT * FROM s1;
En la sección Resources de la pestaña Configuration en la página Deployments, establezca Parallelism en 2. En la sección Parameters, agregue
table.exec.sink.keyed-shuffle: FORCEa Other Configuration.-
Después de start el trabajo, vaya a la pestaña Status. El paralelismo tanto del sink como del operador ascendente es 2, y la conexión de datos ha cambiado a HASH.
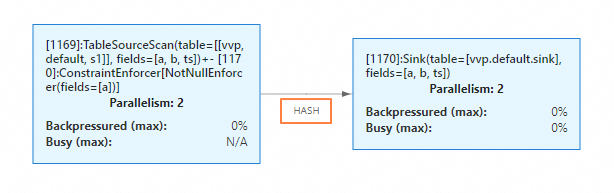
-
table.exec.mini-batch.size
Este parámetro controla el número máximo de registros que se pueden almacenar en búfer para una operación de micro-lote. Al alcanzar este número, se activa el cálculo y se emiten los datos. **Este parámetro solo surte efecto cuando se usa junto con table.exec.mini-batch.enabled y table.exec.mini-batch.allow-latency.** Para obtener más información sobre las optimizaciones de MiniBatch, consulte MiniBatch Aggregation y MiniBatch Regular Joins.
Notas de uso
Antes de iniciar un trabajo, si no establece explícitamente este parámetro en la sección Parameters, se utiliza la memoria administrada para almacenar datos en búfer en modo mini-batch. Cualquiera de las siguientes condiciones activa el cálculo final y la salida de datos:
Se recibe un mensaje de marca de agua del operador MiniBatchAssigner.
La memoria administrada está llena.
Antes de que comience un checkpoint.
El trabajo se detiene.
Valores disponibles
-1 (predeterminado): Indica que se utiliza la memoria administrada para almacenar datos en búfer.
Otros valores Long negativos: Igual que la configuración predeterminada.
Otros valores Long positivos: Indica que se utiliza la memoria heap para almacenar datos en búfer. Cuando el número de registros en búfer alcanza este valor (N), el sistema activa automáticamente la operación de salida.
Ejemplo
-
Cree un trabajo de streaming SQL, copie el siguiente código SQL y deploy el trabajo.
CREATE TEMPORARY TABLE s1 (
  a INT,
  b INT,
  ts TIMESTAMP(3),
  PRIMARY KEY (a) NOT ENFORCED,
  WATERMARK FOR ts AS ts - INTERVAL '1' SECOND
) WITH (
  'connector'='datagen',
  'rows-per-second'='1',
  'fields.ts.kind'='random',
  'fields.ts.max-past'='5s',
  'fields.b.kind'='random',
  'fields.b.min'='0',
  'fields.b.max'='10'
);
CREATE TEMPORARY TABLE sink (
  a INT,
  b BIGINT,
  PRIMARY KEY (a) NOT ENFORCED
) WITH (
  'connector'='print'
);
INSERT INTO sink SELECT a, sum(b) FROM s1 GROUP BY a;
En la pestaña Configuration de la página Deployments, en el campo Other Configuration de la sección Parameters, establezca los parámetros
table.exec.mini-batch.enabled: trueytable.exec.mini-batch.allow-latency: 2s, y no configuretable.exec.mini-batch.sizepara usar su valor predeterminado de -1.Start el trabajo. En la pestaña Status, la topología del trabajo incluye los operadores MiniBatchAssigner, LocalGroupAggregate y GlobalGroupAggregate.
table.exec.agg.mini-batch.output-identical-enabled
Cuando State TTL está habilitado, los nodos MinibatchGlobalAgg y MinibatchAgg no envían datos duplicados aguas abajo de forma predeterminada si el resultado de la agregación no cambia después de consumir los datos. Esto puede provocar que el estado de los nodos con estado aguas abajo caduque porque no reciben datos del nivel superior durante un período prolongado. Este parámetro controla si se deben seguir enviando datos duplicados aguas abajo cuando State TTL está habilitado y el resultado de la agregación permanece sin cambios. Configure este parámetro en true para que los nodos MinibatchGlobalAgg y MinibatchAgg envíen datos en este caso. Si el resultado de la agregación de su trabajo cambia con mayor frecuencia que el State TTL configurado, no necesita establecer manualmente este parámetro. Para obtener detalles sobre el problema de la comunidad, consulte FLINK-33936.
Notas de uso
Este parámetro solo es efectivo en VVR 8.0.8 y versiones posteriores. En versiones anteriores a VVR 8.0.8, el comportamiento equivale a establecer este parámetro en false.
Al cambiar el valor de false a true, la cantidad de datos enviados aguas abajo desde los operadores MinibatchGlobalAgg y MinibatchAgg puede aumentar, lo que ejerce mayor presión sobre los operadores descendentes.
Valores disponibles
false (predeterminado): Cuando state TTL está habilitado, los operadores MinibatchGlobalAgg y MinibatchAgg no emiten datos aguas abajo si el resultado de la agregación no cambia.
true: Cuando state TTL está habilitado, los operadores MinibatchGlobalAgg y MinibatchAgg siguen emitiendo registros actualizados (duplicados) aguas abajo incluso si el resultado de la agregación no cambia.
Ejemplo
-
Cree un trabajo de streaming SQL, copie el siguiente código SQL y deploy el trabajo.
create temporary table src(
    a int,
    b string
) with (
    'connector' = 'datagen',
    'rows-per-second' = '10',
    'fields.a.min' = '1',
    'fields.a.max' = '1',
    'fields.b.length' = '3'
);
create temporary table snk(
    a int,
    max_length_b bigint
) with (
    'connector' = 'blackhole'
);
insert into snk select a, max(CHAR_LENGTH(b)) from src group by a;
En la sección Other Configuration del área Parameters en la pestaña Configuration de la página Deployments, establezca los parámetros
table.exec.mini-batch.enabled: trueytable.exec.mini-batch.allow-latency: 2spara habilitar la optimización Minibatch Aggregate.-
Start el trabajo. En la pestaña Status, el trabajo incluye un operador MinibatchGlobalAggregate. Haga clic en el signo "+" del operador para ver que el operador GlobalGroupAggregate no envía datos aguas abajo cuando el resultado de la agregación no cambia.
El operador muestra RecordsIn como 19 y RecordsOut como 1, lo que significa que 19 registros de entrada produjeron solo 1 salida agregada.
Detenga el trabajo y agregue el parámetro
table.exec.agg.mini-batch.output-identical-enabled: truea Other Configuration en la sección Parameters de la página Configuration de la página Deployments.Start el trabajo. En la pestaña Status, puede ver que el trabajo incluye un operador MinibatchGlobalAggregate. Haga clic en el signo "+" del operador para observar que el operador GlobalGroupAggregate ahora envía datos aguas abajo incluso cuando el resultado de la agregación no cambia. Después de reiniciar el trabajo, la pestaña Status muestra que tanto RecordsIn como RecordsOut del operador GlobalGroupAggregate son 94. Esto indica que, con
table.exec.agg.mini-batch.output-identical-enabled: truehabilitado, el operador envía datos aguas abajo aunque el resultado de la agregación no cambie.
table.exec.async-lookup.key-ordered-enabled
Cuando utiliza una unión de tabla de dimensiones para el enriquecimiento de datos, habilitar el modo asíncrono suele mejorar el throughput. En una unión de tabla de dimensiones, el parámetro table.exec.async-lookup.output-mode y si la entrada es un flujo de actualización determinan el orden de salida de las operaciones de E/S asíncronas.
|
Modo de salida |
Flujo de actualización |
Flujo sin actualización |
|
ORDERED |
modo ordenado |
modo ordenado |
|
ALLOW_UNORDERED |
modo ordenado |
modo desordenado |
Como se muestra en la tabla, la combinación de un flujo de actualización y ALLOW_UNORDERED garantiza la corrección mediante el modo ordenado, pero sacrifica parte del throughput. Para optimizar este escenario, se introdujo el parámetro table.exec.async-lookup.key-ordered-enabled. Este equilibra la semántica de corrección de un flujo de actualización con el rendimiento de throughput de la E/S asíncrona. Los mensajes en un flujo que tienen la misma clave de actualización (que puede considerarse la clave primaria de un changelog) se procesan en el orden en que ingresan al operador.
Modo ordenado: Este modo conserva el orden del flujo. Los mensajes de resultado se emiten en el mismo orden en que se activaron las solicitudes asíncronas (el orden en que los mensajes ingresan al operador).
Modo desordenado: Los mensajes de resultado se emiten tan pronto como finaliza la solicitud asíncrona. El operador de E/S asíncrona cambia el orden de los mensajes en el flujo. Para obtener más información, consulte Asynchronous I/O | Apache Flink.
Casos de uso
Utilice esta optimización para conservar el orden de procesamiento por clave en una unión de tabla de dimensiones cuando el flujo tiene pocos mensajes con la misma clave de actualización a lo largo del tiempo.
En un flujo de Change Data Capture (CDC) con clave primaria, realiza el enriquecimiento de datos con una unión de tabla de dimensiones y escribe en un sink donde la clave primaria del sink coincide con la clave primaria de la fuente. La clave de unión para la tabla de dimensiones es diferente de la clave primaria, y la clave de unión del lado de la dimensión es la clave primaria. Esta optimización realiza un shuffle por la clave primaria de CDC, que se deriva como la clave de actualización. En comparación con la habilitación de la optimización SHUFFLE_HASH para el mismo escenario, evita generar un operador SinkMaterializer antes del sink con un paralelismo mayor. Esto evita posibles problemas de rendimiento de ese operador, especialmente el gran estado que puede acumularse durante ejecuciones largas. Para obtener información sobre SinkUpsertMaterializer, consulte Recommendations.
La clave de unión para la tabla de dimensiones es diferente de la clave primaria, la clave de unión del lado de la dimensión es la clave primaria y le sigue un operador rank. Esta optimización realiza un shuffle por la clave primaria de CDC, que se deriva como la clave de actualización. En comparación con la habilitación de la optimización SHUFFLE_HASH para el mismo escenario, evita que UpdateFastRank se degrade a RetractRank. Para obtener información sobre cómo optimizar RetractRank a UpdateFastRank, consulte TopN optimization techniques.
Notas de uso
Si el flujo no tiene clave de actualización, se utiliza toda la fila como clave.
El throughput disminuye si la misma clave de actualización se modifica frecuentemente en un período corto, ya que los registros para la misma clave de actualización se procesan en orden estricto.
En comparación con la unión de tabla de dimensiones asíncrona original, el modo Key-Ordered introduce estado con clave. Habilitar o deshabilitar este modo afecta la compatibilidad del estado.
Esta función solo surte efecto para VVR 8.0.10 y versiones posteriores cuando la entrada de la unión de tabla de dimensiones es un flujo de actualización y configura
table.exec.async-lookup.output-mode='ALLOW_UNORDERED'ytable.exec.async-lookup.key-ordered-enabled='true'.
Valores disponibles
false (predeterminado): Deshabilita el modo Key-Ordered.
true: Habilita el modo Key-Ordered.
Ejemplo
-
El siguiente ejemplo utiliza una unión de tabla de dimensiones Hologres asíncrona. Cree un trabajo de streaming SQL, copie el siguiente código SQL y deploy el trabajo.
Para obtener más información sobre el conector Hologres, consulte Hologres.
create TEMPORARY table bid_source(
  auction  BIGINT,
  bidder  BIGINT,
  price  BIGINT,
  channel  VARCHAR,
  url  VARCHAR,
  dateTime  TIMESTAMP(3),
  extra  VARCHAR,
  proc_time as proctime(),
  WATERMARK FOR dateTime AS dateTime - INTERVAL '4' SECOND
) with (
  'connector' = 'kafka',  -- A non-insert-only stream connector
  'topic' = 'user_behavior',
  'properties.bootstrap.servers' = 'localhost:9092',
  'properties.group.id' = 'testGroup',
  'scan.startup.mode' = 'earliest-offset',
  'format' = 'csv'
);
CREATE TEMPORARY TABLE users (
    user_id STRING PRIMARY KEY NOT ENFORCED, -- Define the primary key
    user_name VARCHAR(255) NOT NULL,
    age INT NOT NULL
) WITH (
    'connector' = 'hologres',    -- A connector that supports asynchronous lookup
    'async' = 'true',
    'dbname' = 'holo db name', --The name of your Hologres database
    'tablename' = 'schema_name.table_name', --The name of the Hologres table to receive data
    'username' = 'access id', --The AccessKey ID of your Alibaba Cloud account
    'password' = 'access key', --The AccessKey Secret of your Alibaba Cloud account
    'endpoint' = 'holo vpc endpoint', --The VPC endpoint of your Hologres instance
);
CREATE TEMPORARY TABLE bh (
    auction  BIGINT,
    age int
) WITH (
    'connector' = 'blackhole'
);
insert into bh
SELECT
    bid_source.auction,
    u.age
FROM bid_source
    JOIN users FOR SYSTEM_TIME AS OF bid_source.proc_time AS u
    ON bid_source.channel = u.user_id;
En la página Deployments, en la pestaña Configuration, en la sección Other Configuration del área Parameters, establezca los parámetros
table.exec.async-lookup.output-mode='ALLOW_UNORDERED'ytable.exec.async-lookup.key-ordered-enabled='true'.Start el trabajo. En la pestaña Status, puede ver que el atributo asíncrono del trabajo es KEY_ORDERED:true.
table.optimizer.window-join-enabled
Este parámetro controla si se habilitan las operaciones de window join. Cuando está habilitado, Flink optimiza el plan de ejecución correspondiente como un window join. Para ventanas pequeñas, esto reduce la sobrecarga de estado y mejora el rendimiento. En comparación con un regular join, un window join también puede evitar emitir mensajes de actualización a los operadores descendentes, lo cual es útil para casos de uso que requieren uniones con condiciones de ventana temporal pequeña.
Notas de uso
Un window join tiene limitaciones adicionales en la sintaxis SQL en comparación con un regular join, y no admite flujos de actualización.
Un window join tiene una latencia de salida mayor que un regular join. La latencia depende del tamaño de la ventana y de la rapidez con la que avanzan las marcas de agua de la fuente.
Cuando está habilitado, un window join de tiempo de evento descarta datos tardíos, mientras que un regular join no lo hace.
Después de cambiar este parámetro, no puede reanudar desde un checkpoint existente porque las estructuras de estado subyacentes de los dos métodos de ejecución son incompatibles.
Valores disponibles
false (predeterminado): Las sentencias para un window join se convierten a un regular join para su ejecución.
true: Habilita window join. Las sentencias correspondientes se convierten a un window join para su ejecución.
Ejemplo
-
Cree un trabajo de streaming SQL, copie el siguiente código SQL, establezca el parámetro
table.optimizer.window-join-enabledentruemediante una sentencia SET y luego ejecute el texto SQL para ver el plan de ejecución.SET 'table.optimizer.window-join-enabled' = 'true'; CREATE TEMPORARY TABLE LeftTable ( id VARCHAR, row_time TIMESTAMP_LTZ(3), num INT, WATERMARK FOR row_time as row_time - INTERVAL '5' SECONDS ) WITH ( 'connector'='datagen' ); CREATE TEMPORARY TABLE RightTable ( id VARCHAR, row_time TIMESTAMP_LTZ(3), num INT, WATERMARK FOR row_time as row_time - INTERVAL '10' SECONDS ) WITH ( 'connector'='datagen' ); EXPLAIN SELECT L.num as L_Num, L.id as L_Id, R.num as R_Num, R.id as R_Id, COALESCE(L.window_start, R.window_start) as window_start, COALESCE(L.window_end, R.window_end) as window_end FROM ( SELECT * FROM TABLE(TUMBLE(TABLE LeftTable, DESCRIPTOR(row_time), INTERVAL '5' MINUTES)) ) L JOIN ( SELECT * FROM TABLE(TUMBLE(TABLE RightTable, DESCRIPTOR(row_time), INTERVAL '5' MINUTES)) ) R ON L.num = R.num AND L.window_start = R.window_start AND L.window_end = R.window_end;La sección Optimized Execution Plan de la salida muestra que el plan contiene un operador WindowJoin.
== Optimized Execution Plan == Calc(select=[num AS L_Num, id AS L_Id, num0 AS R_Num, id0 AS R_Id, CASE(window_start IS NOT NULL, window_start, window_start0) AS window_start, CASE(window_end IS NOT NULL, window_end, window_end0) AS window_end]) +- WindowJoin(leftWindow=[TUMBLE(win_start=[window_start], win_end=[window_end], size=[5 min])], rightWindow=[TUMBLE(win_start=[window_start], win_end=[window_end], size=[5 min])], joinType=[InnerJoin], where=[(num = num0)], select=[id, num, window_start, window_end, id0, num0, window_start0, window_end0]) :- Exchange(distribution=[hash[num]]) : +- Calc(select=[id, num, window_start, window_end]) : +- WindowTableFunction(window=[TUMBLE(time_col=[row_time], size=[5 min])]) : +- WatermarkAssigner(rowtime=[row_time], watermark=[(row_time - 5000:INTERVAL SECOND)]) : +- TableSourceScan(table=[[vvp, default, LeftTable]], fields=[id, row_time, num]) +- Exchange(distribution=[hash[num]]) +- Calc(select=[id, num, window_start, window_end]) +- WindowTableFunction(window=[TUMBLE(time_col=[row_time], size=[5 min])]) +- WatermarkAssigner(rowtime=[row_time], watermark=[(row_time - 10000:INTERVAL SECOND)]) +- TableSourceScan(table=[[vvp, default, RightTable]], fields=[id, row_time, num]) -
Modifique la sentencia SET en el código SQL para establecer el parámetro
table.optimizer.window-join-enabledenfalseo elimine la sentencia SET, y luego ejecute el texto SQL para ver el plan de ejecución modificado.-- set to 'false' or remove this setting clause SET 'table.optimizer.window-join-enabled' = 'false'; CREATE TEMPORARY TABLE LeftTable ( id VARCHAR, row_time TIMESTAMP_LTZ(3), num INT, WATERMARK FOR row_time as row_time - INTERVAL '5' SECONDS ) WITH ( 'connector'='datagen' ); CREATE TEMPORARY TABLE RightTable ( id VARCHAR, row_time TIMESTAMP_LTZ(3), num INT, WATERMARK FOR row_time as row_time - INTERVAL '10' SECONDS ) WITH ( 'connector'='datagen' ); EXPLAIN SELECT L.num as L_Num, L.id as L_Id, R.num as R_Num, R.id as R_Id, COALESCE(L.window_start, R.window_start) as window_start, COALESCE(L.window_end, R.window_end) as window_end FROM ( SELECT * FROM TABLE(TUMBLE(TABLE LeftTable, DESCRIPTOR(row_time), INTERVAL '5' MINUTES)) ) L JOIN ( SELECT * FROM TABLE(TUMBLE(TABLE RightTable, DESCRIPTOR(row_time), INTERVAL '5' MINUTES)) ) R ON L.num = R.num AND L.window_start = R.window_start AND L.window_end = R.window_end;La sección Optimized Execution Plan de la salida ya no contiene un operador WindowJoin. La operación es ahora una unión regular.
== Optimized Execution Plan ==
Calc(select=[num AS L_Num, id AS L_Id, num0 AS R_Num, id0 AS R_Id, CASE(window_start IS NOT NULL, window_start, window_start0) AS window_start, CASE(window_end IS NOT NULL, window_end, window_end0) AS window_end])
+- Join(joinType=[InnerJoin], where=[((num = num0) AND (window_start = window_start0) AND (window_end = window_end0))], select=[id, num, window_start, window_end, id0, num0, window_start0, window_end0], leftInputSpec=[NoUniqueKey], rightInputSpec=[NoUniqueKey])
   :- Exchange(distribution=[hash[num, window_start, window_end]])
   :  +- Calc(select=[id, num, window_start, window_end])
   :     +- WindowTableFunction(window=[TUMBLE(time_col=[row_time], size=[5 min])])
   :        +- WatermarkAssigner(rowtime=[row_time], watermark=[(row_time - 5000:INTERVAL SECOND)])
   :           +- TableSourceScan(table=[[vvp, default, LeftTable]], fields=[id, row_time, num])
   +- Exchange(distribution=[hash[num, window_start, window_end]])
      +- Calc(select=[id, num, window_start, window_end])
         +- WindowTableFunction(window=[TUMBLE(time_col=[row_time], size=[5 min])])
            +- WatermarkAssigner(rowtime=[row_time], watermark=[(row_time - 10000:INTERVAL SECOND)])
               +- TableSourceScan(table=[[vvp, default, RightTable]], fields=[id, row_time, num])
Documentación relacionada
Why does data get stuck in the LocalGroupAggregate operator with no output?