Al utilizar Flink SQL para el procesamiento de datos en tiempo real, los eventos de changelog desordenados pueden corromper silenciosamente los resultados: se eliminan registros que deberían existir o las actualizaciones se aplican en un orden incorrecto. Este tema explica por qué ocurren estos eventos desordenados, cómo SinkUpsertMaterializer los corrige y cómo ajustar o evitar este operador cuando el rendimiento es crítico.
Conceptos clave
Tipos de changelog y stream
En bases de datos relacionales como MySQL, el registro binario (binlog) captura cada operación INSERT, UPDATE y DELETE. Flink SQL utiliza un mecanismo similar denominado changelog para rastrear cambios en los datos y habilitar el procesamiento incremental en pipelines de streaming.
Un stream de changelog se clasifica en una de dos categorías:
|
Tipo de stream |
Tipos de evento |
Descripción |
|
Stream de solo anexado |
Solo +I |
Contiene únicamente eventos INSERT. No incluye actualizaciones ni eliminaciones. También se conoce como stream sin actualizaciones. |
|
Stream de actualización |
+I, +U, -U, -D |
Contiene eventos de actualización o eliminación además de inserciones. Operadores como la agregación por grupo y la deduplicación generan este tipo de stream. |
No todos los operadores pueden consumir streams de actualización. Los operadores de agregación con ventana deslizante (over aggregation) y unión por intervalo (interval join) solo aceptan streams de solo anexado como entrada.
Tipos de eventos de changelog
Flink SQL utiliza cuatro tipos de eventos, basados en la enumeración RowKind de la API de Apache Flink:
|
Nombre corto |
Nombre completo |
Semántica |
|
|
INSERT |
Inserta una nueva fila. |
|
|
UPDATE_BEFORE |
Retracta el contenido anterior de una fila actualizada. Siempre se empareja con un evento |
|
|
UPDATE_AFTER |
Contiene el nuevo contenido de una fila actualizada. Siempre se empareja con un evento |
|
|
DELETE |
Elimina una fila. |
Flink mantiene UPDATE_BEFORE (-U) y UPDATE_AFTER (+U) como tipos de eventos separados en lugar de combinarlos en un evento UPDATE compuesto por dos razones:
Estructura uniforme: Ambos eventos comparten la misma estructura de fila y solo se diferencian por la propiedad
RowKind. Un tipo de evento compuesto requeriría estructuras heterogéneas o una alineación especial entre los eventos INSERT y DELETE.Redistribución distribuida: En pipelines paralelos, las operaciones de unión y agregación redistribuyen datos entre tareas. Los eventos UPDATE compuestos aún necesitarían dividirse en eventos separados durante la redistribución para mantener la corrección, por lo que mantenerlos separados desde el inicio simplifica el modelo.
Cómo ocurren los eventos desordenados
Considere el siguiente ejemplo, que se utiliza a lo largo de este tema para ilustrar el problema y su solución:
-- CDC source tables
CREATE TEMPORARY TABLE s1 (
  id    BIGINT,
  level BIGINT,
  PRIMARY KEY(id) NOT ENFORCED
) WITH (...);

CREATE TEMPORARY TABLE s2 (
  id   BIGINT,
  attr VARCHAR,
  PRIMARY KEY(id) NOT ENFORCED
) WITH (...);

-- Sink table
CREATE TEMPORARY TABLE t1 (
  id    BIGINT,
  level BIGINT,
  attr  VARCHAR,
  PRIMARY KEY(id) NOT ENFORCED
) WITH (...);

-- Join s1 and s2 and write the result to t1
INSERT INTO t1
SELECT s1.*, s2.attr
FROM s1 JOIN s2
ON s1.level = s2.id;
Cuando el registro (id=1, level=10) en la tabla s1 se inserta en el tiempo t0 y luego se actualiza a (id=1, level=20) en el tiempo t1, se producen tres eventos de changelog:
|
Evento |
Tipo |
|
|
INSERT |
|
|
UPDATE_BEFORE |
|
|
UPDATE_AFTER |
La clave primaria de s1 es id, pero la cláusula JOIN redistribuye los datos según la columna level. Con un paralelismo del operador Join de 2, estos tres eventos pueden dirigirse a dos tareas diferentes: una que maneja level=10 y otra que maneja level=20.
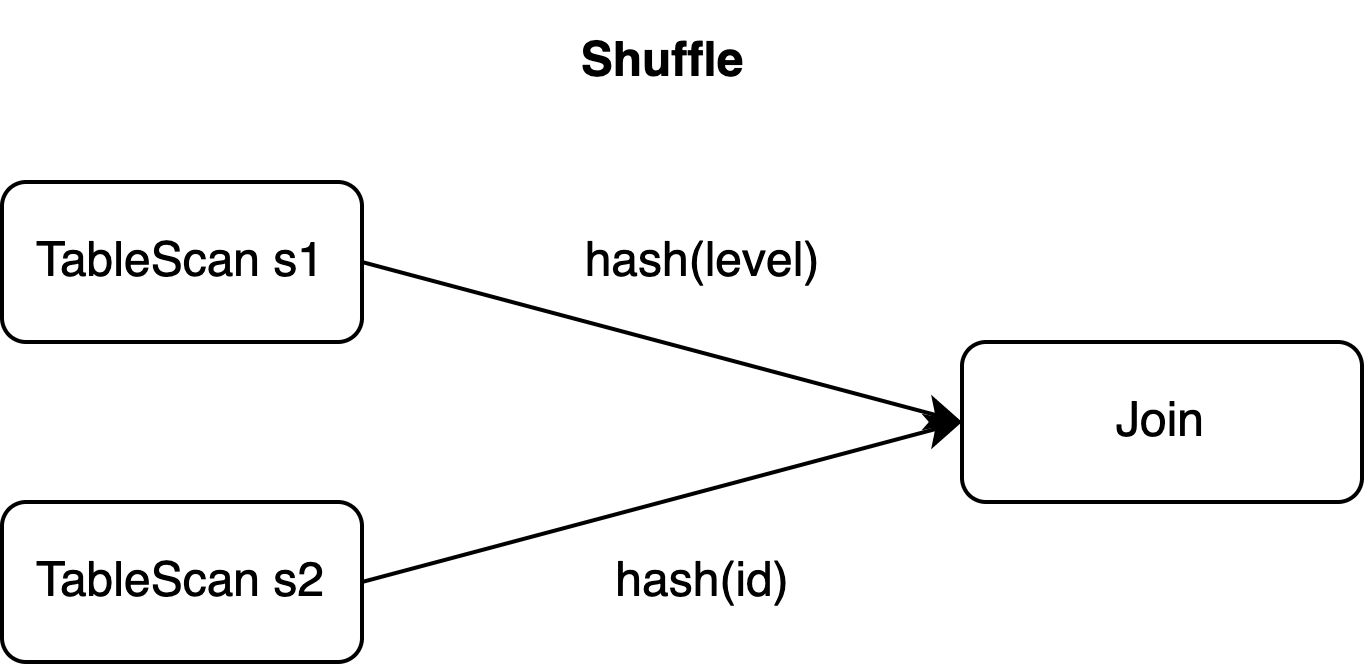
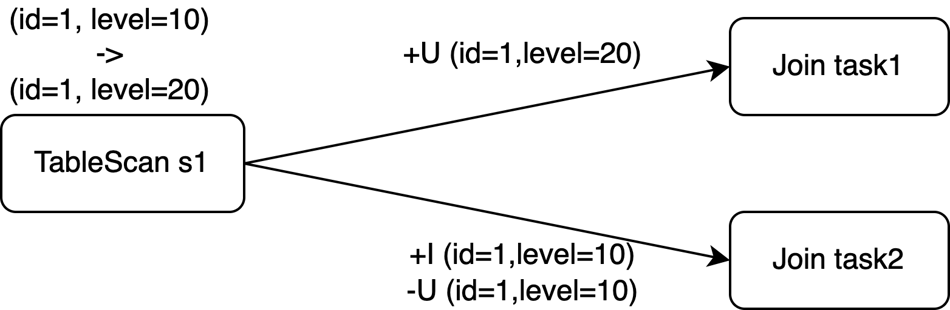
Dado que los eventos se procesan en paralelo, el operador Sink posterior puede recibirlos en cualquiera de los tres órdenes posibles:
|
Caso 1 (orden correcto) |
Caso 2 (desordenado) |
Caso 3 (desordenado) |
|
|
|
|
|
|
|
|
|
|
|
|
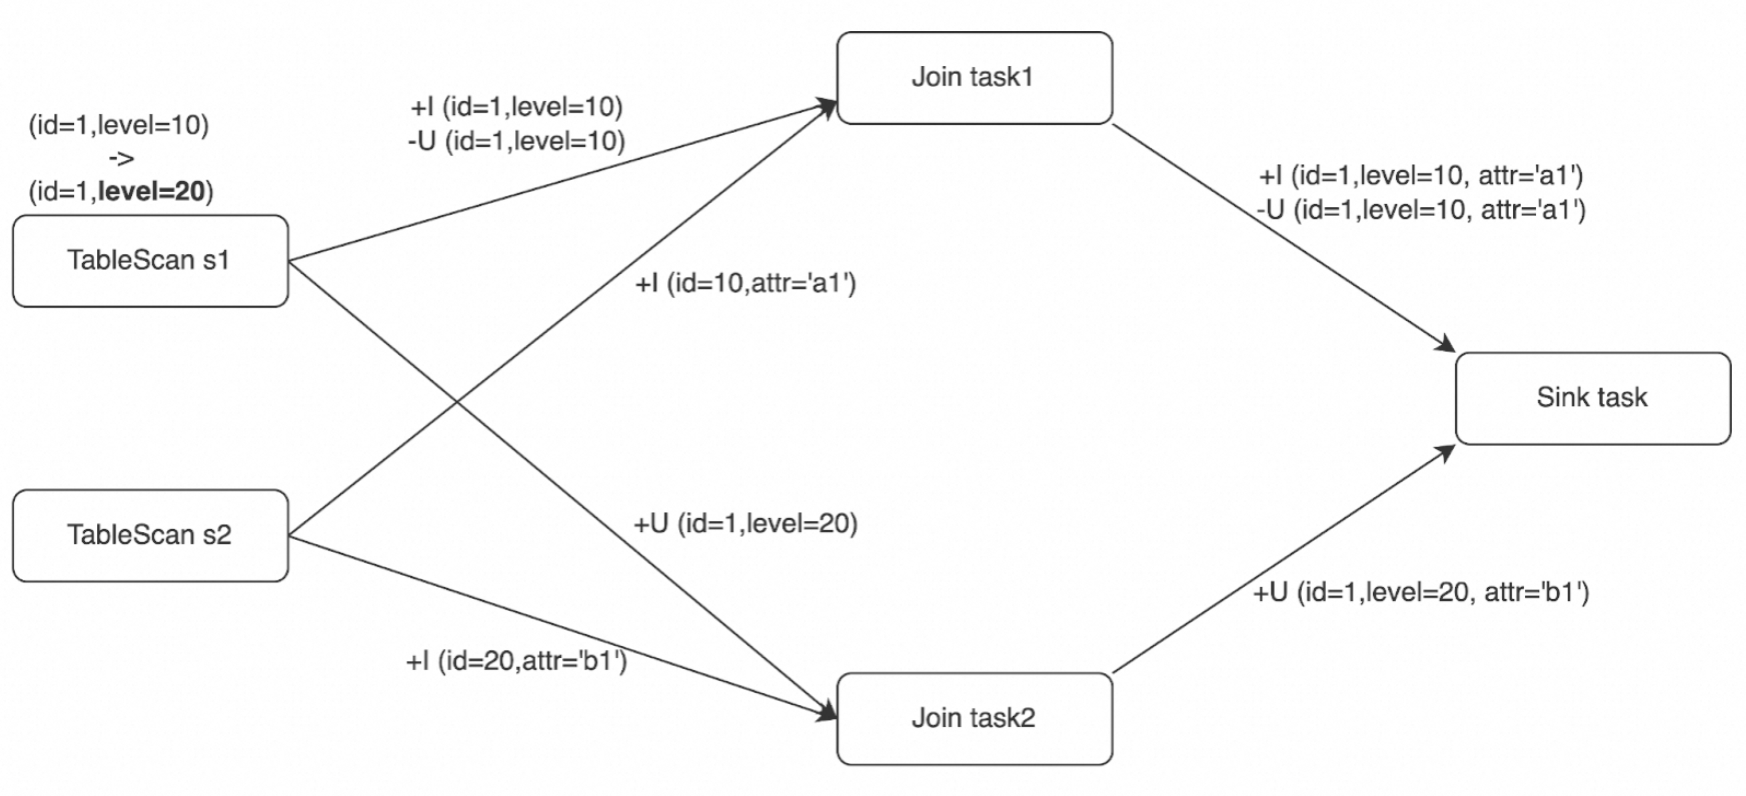
El Caso 1 procesa los eventos en la secuencia original, por lo que no hay problemas. En los Casos 2 y 3, la tabla destino tiene id como clave primaria. Si el almacenamiento externo realiza un upsert, el registro con id=1 termina eliminado, aunque el estado final esperado sea (id=1, level=20, attr='b1').
Los eventos desordenados solo ocurren cuando el paralelismo del operador Join es mayor que 1. Un par de eventos con la misma clave de upsert siempre se enrutan a la misma tarea, razón por la cual solo son posibles tres casos de ordenamiento en este escenario.
SinkUpsertMaterializer
Funcionamiento
SinkUpsertMaterializer es un operador intermedio que Flink inserta para resolver problemas de ordenamiento. Se introdujo para solucionar FLINK-20374.
Para comprender por qué se necesita SinkUpsertMaterializer, es útil entender las claves de upsert. Una upsert key es una columna (o conjunto de columnas) que preserva el orden de clasificación de una clave única a través de una operación SQL. Cuando existen claves de upsert, el operador posterior recibe los eventos de actualización en el orden correcto. Cuando una operación de redistribución de datos rompe el orden de la clave única —como hace el JOIN en level en este ejemplo— la clave de upsert queda vacía.
En este ejemplo, las filas de s1 se redistribuyen por level, por lo que la salida del Join contiene filas con el mismo valor de s1.id pero en un orden arbitrario. Las claves únicas son (s1.id), (s1.id, s1.level) y (s1.id, s2.id), pero la clave de upsert está vacía. Además, la clave primaria de la tabla destino (id) no coincide con la clave de upsert en la salida del Join. SinkUpsertMaterializer subsana esta discrepancia.
Los eventos de changelog desordenados siguen reglas específicas: para una clave de upsert específica (o para todas las columnas si la clave de upsert está vacía), los eventos ADD (+I y +U) siempre ocurren antes que los eventos RETRACT correspondientes (-D y -U). Un par de eventos de changelog con la misma clave de upsert son procesados por la misma tarea incluso cuando ocurre una redistribución de datos. Estas garantías de ordenamiento son las que utiliza SinkUpsertMaterializer para reconstruir los resultados correctos.
El operador funciona de la siguiente manera:
Mantiene una lista de valores
RowDataen el estado, indexada por la clave de upsert deducida (o por la fila completa si la clave de upsert está vacía).Ante un evento ADD (
+Io+U): agrega o actualiza la fila en el estado.Ante un evento RETRACT (
-Uo-D): elimina la fila del estado.Genera eventos de changelog correctos basados en la clave primaria de la tabla destino.
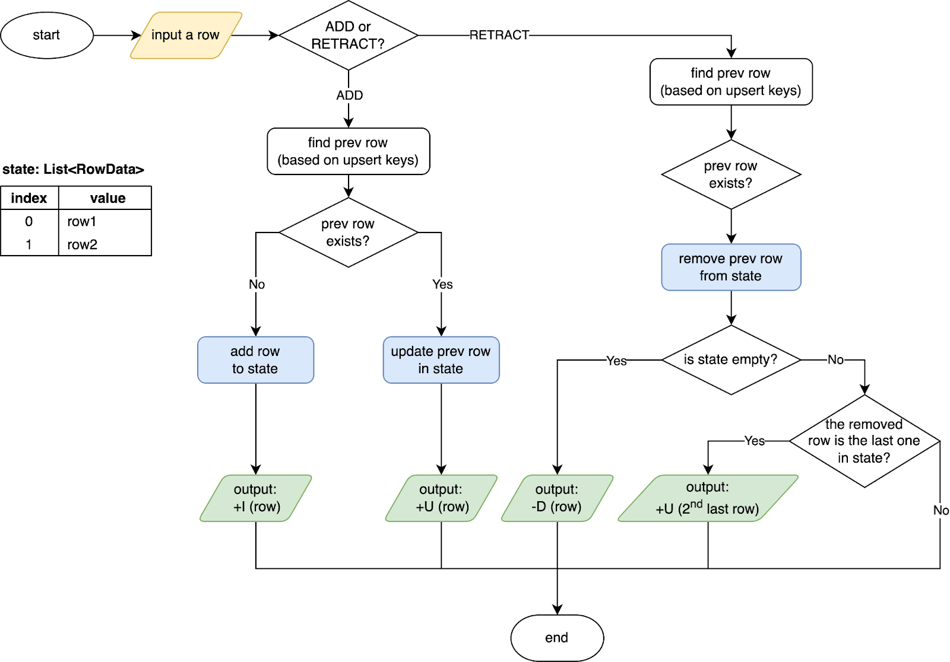
El siguiente diagrama muestra cómo SinkUpsertMaterializer maneja los Casos 2 y 3 del ejemplo anterior:
Caso 2: Cuando
-U (id=1, level=10, attr='a1')llega al final, SinkUpsertMaterializer elimina esa fila del estado y genera un evento UPDATE basado en la penúltima fila. El resultado final es(id=1, level=20, attr='b1').Caso 3: Cuando llega
+U (id=1, level=20, attr='b1'), el operador lo pasa al flujo posterior. Cuando-U (id=1, level=10, attr='a1')llega más tarde, el operador elimina la fila correspondiente del estado sin emitir un evento. El resultado final es nuevamente(id=1, level=20, attr='b1').
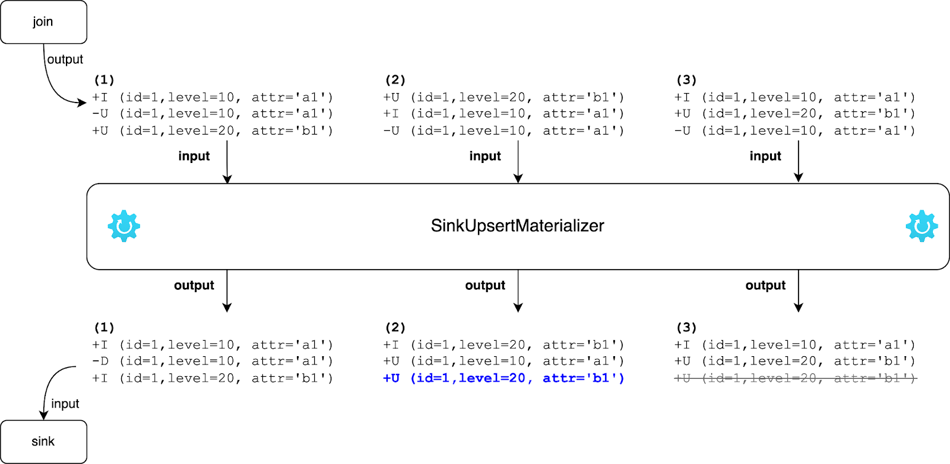
Para consultar el código fuente, véase SinkUpsertMaterializer (Flink release-1.17).
Cuándo se activa SinkUpsertMaterializer
Flink agrega el operador SinkUpsertMaterializer en los siguientes escenarios:
-
La tabla destino tiene una clave primaria, pero los datos entrantes no satisfacen la restricción UNIQUE. Las causas comunes incluyen:
Definir una clave primaria en la tabla destino cuando la tabla origen no tiene clave primaria.
Excluir la columna de clave primaria del origen al escribir en el destino, o mapear una columna que no es clave primaria del origen a la clave primaria del destino.
Reducir la precisión de una columna de clave primaria mediante conversión de tipos o agregación por grupo (por ejemplo, convertir de BIGINT a INT).
-
Transformar la columna de clave primaria, como concatenar varias columnas en una sola:
CREATE TABLE students (
  student_id   BIGINT NOT NULL,
  student_name STRING NOT NULL,
  course_id    BIGINT NOT NULL,
  score        DOUBLE NOT NULL,
  PRIMARY KEY(student_id) NOT ENFORCED
) WITH (...);

CREATE TABLE performance_report (
  student_info STRING NOT NULL PRIMARY KEY NOT ENFORCED,
  avg_score    DOUBLE NOT NULL
) WITH (...);

CREATE TEMPORARY VIEW v AS
SELECT student_id, student_name, AVG(score) AS avg_score
FROM students
GROUP BY student_id, student_name;

-- The concatenated result no longer satisfies the UNIQUE constraint
-- but is used as the primary key of the sink table.
INSERT INTO performance_report
SELECT
  CONCAT('id:', student_id, ',name:', student_name) AS student_info,
  avg_score
FROM v;
Una operación de redistribución de datos altera el orden de clasificación de una clave única antes de escribir en la tabla destino. Este es el escenario del ejemplo de unión anterior: el JOIN en
levelredistribuye las filas de s1, rompiendo el orden de clasificación de la clave primariaid.El parámetro
table.exec.sink.upsert-materializeestá establecido enforce.
Configuración de SinkUpsertMaterializer
Utilice el parámetro table.exec.sink.upsert-materialize para controlar cuándo Flink agrega el operador SinkUpsertMaterializer:
|
Valor |
Comportamiento |
|
|
Flink infiere si son posibles los eventos desordenados y agrega el operador si es necesario. |
|
|
Deshabilita el operador por completo. |
|
|
Siempre agrega el operador, incluso cuando no se define ninguna clave primaria en la tabla destino. |
Establecerautono garantiza que los eventos estén realmente desordenados. Por ejemplo, usar una cláusulaGROUPING SETSconCOALESCEpara convertir valores nulos puede impedir que el planificador SQL determine si la clave de upsert coincide con la clave primaria del destino. En ese caso, Flink agrega SinkUpsertMaterializer como medida preventiva. Si los resultados son correctos sin el operador, establezcatable.exec.sink.upsert-materializeennone.
Para obtener información sobre las operaciones de consulta compatibles en Realtime Compute for Apache Flink que usa Ververica Runtime (VVR) 6.0 o posterior, los operadores de ejecución correspondientes y la compatibilidad con streams de actualización, consulte Query execution.
Notas de rendimiento y operación
SinkUpsertMaterializer mantiene estado para cada fila que procesa. Esto aumenta el tamaño del estado y añade sobrecarga de E/S para lecturas y escrituras de estado, lo que reduce el throughput. Evite usar el operador cuando sea posible.
Cómo evitar activar SinkUpsertMaterializer
Haga que la clave de partición utilizada para deduplicación o agregación por grupo coincida con la clave primaria de la tabla destino.
Si un solo nivel de paralelismo se ajusta a su conjunto de datos y desea evitar eventos desordenados, establezca el paralelismo en 1 y deshabilite SinkUpsertMaterializer configurando
table.exec.sink.upsert-materializeennone.Si existe una cadena de operadores entre el operador Sink y un operador con estado anterior (como un operador de deduplicación o agregación por grupo), y no ocurrieron problemas de precisión de datos con versiones de VVR anteriores a la 6.0, migre el despliegue a VVR 6.0 o posterior. Establezca
table.exec.sink.upsert-materializeennoney mantenga las demás configuraciones sin cambios. Para conocer los pasos de migración, consulte Upgrade the engine version of deployments.
Cuándo debe usar SinkUpsertMaterializer
No escriba columnas producidas por funciones no deterministas (como
CURRENT_TIMESTAMPoNOW()) en la tabla destino. Cuando la clave de upsert no está disponible, SinkUpsertMaterializer compara filas completas, y los valores no deterministas impiden que las filas históricas se emparejen y eliminen, causando un crecimiento ilimitado del estado.Si el estado del operador crece lo suficiente como para afectar el rendimiento, aumente el paralelismo del despliegue. Consulte Configure resources for a deployment.
Problemas conocidos
SinkUpsertMaterializer puede causar un crecimiento ilimitado del estado en las siguientes situaciones:
-
Sin TTL de estado, TTL demasiado largo o TTL demasiado corto: Sin un tiempo de vida (TTL) configurado, el estado se acumula indefinidamente. Un TTL excesivamente corto también puede causar problemas: si el intervalo entre un evento DELETE y su evento ADD correspondiente excede el TTL configurado, Flink retiene la fila en el estado como datos sucios (véase FLINK-29225) y produce el siguiente mensaje de registro:
int index = findremoveFirst(values, row);
if (index == -1) {
    LOG.info(STATE_CLEARED_WARN_MSG);
    return;
}
Configure el TTL según sus requisitos empresariales. Consulte Configure a deployment. Realtime Compute for Apache Flink con VVR 8.0.7 o posterior admite la configuración de TTL por operador para reducir el consumo de recursos en despliegues con estados grandes. Consulte Configure the parallelism, chaining strategy, and TTL of an operator.
Columnas no deterministas sin clave de upsert: Si el stream de actualización que llega a SinkUpsertMaterializer no tiene una clave de upsert deducible e incluye columnas de funciones no deterministas, las filas históricas no pueden emparejarse por valor y nunca se eliminan, lo que provoca un crecimiento continuo del estado.
Pasos siguientes
Notas de versión — Mapeo de versiones del motor entre Realtime Compute for Apache Flink y Apache Flink
Query execution — Operaciones de consulta admitidas y soporte de streams de actualización para VVR 6.0 y posteriores
Configurar recursos para un despliegue — Aumentar el paralelismo para manejar estados grandes de SinkUpsertMaterializer