Utilice Data Transmission Service (DTS) para configurar un pipeline de datos continuo desde ApsaraDB RDS for PostgreSQL hacia AnalyticDB for PostgreSQL. DTS gestiona tanto la carga inicial completa como la captura continua de cambios incrementales (CDC) mediante replicación lógica, lo que mantiene sincronizada su base de datos analítica conforme cambian los datos de origen.
Requisitos previos
Antes de empezar, asegúrese de contar con lo siguiente:
Una instancia de AnalyticDB for PostgreSQL con almacenamiento disponible superior al tamaño total de los datos en la instancia de origen de RDS for PostgreSQL. Consulte Create an instance.
Una base de datos creada en la instancia de destino de AnalyticDB for PostgreSQL para recibir los datos sincronizados. Consulte la sección CREATE DATABASE en SQL syntax.
Una cuenta con privilegios en la instancia de origen de RDS for PostgreSQL que sea propietaria de la base de datos. Consulte Create an account y Create a database.
Una cuenta de base de datos en la instancia de destino de AnalyticDB for PostgreSQL con permisos de lectura y escritura. También puede utilizar una cuenta inicial o una cuenta con el permiso RDS_SUPERUSER. Consulte Create a database account y Manage users and permissions.
Facturación
|
Tipo de sincronización |
Costo |
|
Sincronización de esquemas y sincronización completa de datos |
Gratis |
|
Sincronización incremental de datos |
Con cargo. Consulte Descripción general de facturación. |
Operaciones SQL compatibles para la sincronización incremental
|
Tipo de operación |
Sentencias SQL |
|
DML |
INSERT, UPDATE, DELETE |
|
DDL |
CREATE TABLE, DROP TABLE, TRUNCATE TABLE (base de datos PostgreSQL autogestionada de origen versión 11+), CREATE INDEX ON TABLE y operaciones ALTER TABLE que incluyen RENAME TABLE, ADD COLUMN, ADD COLUMN DEFAULT, ALTER COLUMN TYPE, DROP COLUMN, ADD CONSTRAINT, ADD CONSTRAINT CHECK y ALTER COLUMN DROP DEFAULT |
Requisitos para la sincronización DDL:
La sincronización DDL solo está disponible para tareas creadas después del 1 de octubre de 2020.
Para tareas creadas antes del 12 de mayo de 2023, configure triggers y funciones en la base de datos de origen antes de configurar la tarea. Consulte Uso de triggers y funciones para implementar la migración DDL incremental en bases de datos PostgreSQL.
La sincronización DDL requiere una cuenta de base de datos con privilegios en la instancia de origen y una versión menor del motor 20210228 o posterior. Consulte Actualización de la versión menor del motor.
No es posible sincronizar datos de tipo BIT durante la sincronización incremental de datos.
Las siguientes operaciones DDL no se sincronizan:
Sentencias DDL que incluyen modificadores adicionales como CASCADE o RESTRICT
Sentencias DDL provenientes de sesiones que ejecutan
SET session_replication_role = replicaSentencias DDL invocadas mediante funciones
Sentencias DDL confirmadas en la misma transacción que sentencias DML
Sentencias DDL sobre objetos no incluidos en el alcance de la sincronización
Límites
Requisitos de tablas y esquemas
-
Las tablas deben tener una restricción PRIMARY KEY o UNIQUE con todos los campos únicos. De lo contrario, la base de datos de destino podría contener registros duplicados.
NotaSi crea una tabla de destino fuera de DTS (sin seleccionar Schema Synchronization en Synchronization Types), asegúrese de que la tabla de destino tenga las mismas restricciones PRIMARY KEY o NOT NULL UNIQUE que la tabla de origen.
Solo se pueden seleccionar tablas como objetos de sincronización; no se admiten vistas, funciones ni otros tipos de objetos.
Una tarea solo puede sincronizar datos de una base de datos. Para sincronizar varias bases de datos, cree una tarea independiente para cada una.
No se pueden sincronizar tablas con relaciones de herencia entre esquemas.
La tabla de destino no puede ser una tabla optimizada para anexión (AO).
DTS no sincroniza los siguientes tipos de datos: VARBIT, GEOMETRY, UUID, TSQUERY, TSVECTOR y TXID_SNAPSHOT.
Mapeo de columnas y diferencias de esquema
Si utiliza mapeo de columnas para una sincronización que no sea de tabla completa, o si los esquemas de las tablas de origen y destino difieren, se perderán los datos de las columnas que existen en el origen pero no en el destino.
Si cambia el nombre de tablas o columnas en la base de datos de destino mediante la función de mapeo de nombres de objetos, la sincronización de más de 5,000 tablas en una sola tarea provocará un error de solicitud. Para más de 5,000 tablas, configure varias tareas o sincronice bases de datos completas.
Requisitos de registros WAL
La base de datos de origen debe cumplir con los siguientes requisitos de registro de escritura anticipada (WAL):
Establezca
wal_levelenlogical.Para sincronización solo incremental: conserve los registros WAL durante más de 24 horas.
Para sincronización completa más incremental: conserve los registros WAL durante al menos 7 días. Una vez completada la sincronización completa, puede establecer el periodo de retención en más de 24 horas.
El incumplimiento de estos requisitos puede impedir que DTS obtenga los registros WAL, lo que provoca fallos en la tarea o, en casos excepcionales, inconsistencia o pérdida de datos.
Restricciones de ejecución
No ejecute sentencias DDL durante la sincronización de esquemas o la sincronización completa de datos. Hacerlo provocará el fallo de la tarea.
-
Si agrega una tabla a un esquema sincronizado o cambia el nombre de una tabla mediante RENAME, ejecute
ALTER TABLE schema.table REPLICA IDENTITY FULL;antes de escribir datos en la tabla. Esto evita inconsistencias en los datos. Realice esta operación en horarios de baja actividad para evitar bloqueos mutuos (deadlocks).NotaReemplace
schemaytablepor el nombre real del esquema y de la tabla. No elimine las tablas temporales que DTS crea en la base de datos de origen:
public.dts_pg_class,public.dts_pg_attribute,public.dts_pg_type,public.dts_pg_enum,public.dts_postgres_heartbeat,public.dts_ddl_command,public.dts_args_sessionypublic.aliyun_dts_instance. DTS elimina automáticamente estas tablas cuando se libera la instancia.Las transacciones de larga duración en la base de datos de origen pueden causar acumulación de registros WAL y agotar el espacio en disco.
Si la base de datos de origen experimenta una actualización de versión mayor mientras la tarea se está ejecutando, la tarea fallará y no se podrá recuperar. Vuelva a configurar la tarea.
Un solo cambio incremental de datos no debe exceder los 256 MB. Si esto ocurre, la tarea fallará y no se podrá recuperar. Vuelva a configurar la tarea.
Slots de replicación
DTS crea un slot de replicación con el prefijo dts_sync_ en la base de datos de origen. Este slot conserva los registros incrementales de los últimos 15 minutos.
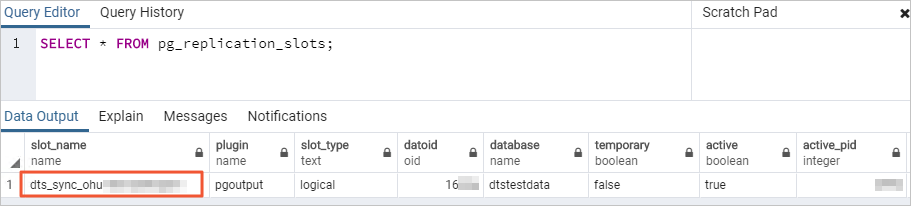
El slot de replicación se elimina automáticamente cuando se libera la instancia de DTS. Si cambia la contraseña de la base de datos de origen o elimina las direcciones IP de DTS de la lista blanca, el slot no se podrá eliminar automáticamente; deberá borrarlo manualmente para evitar acumulación.
Si la tarea se libera o falla, DTS elimina automáticamente el slot de replicación. Después de un cambio de rol primario/secundario en la base de datos PostgreSQL de origen, inicie sesión en la base de datos secundaria para eliminar manualmente el slot de replicación.
DTS también agrega una tabla de latidos llamada dts_postgres_heartbeat a la base de datos de origen para rastrear la latencia de sincronización.
Restricciones específicas del origen
ApsaraDB RDS for PostgreSQL:
No modifique el endpoint ni la zona de la instancia de origen de RDS for PostgreSQL mientras la tarea se esté ejecutando. Hacerlo provocará el fallo de la tarea.
Para realizar un cambio de rol primario/secundario en la instancia de origen, habilite primero la función Logical Replication Slot Failover. Consulte Logical Replication Slot Failover.
PostgreSQL autogestionado:
Establezca
max_wal_sendersymax_replication_slotsen valores superiores a la suma de los slots de replicación existentes y el número de instancias de DTS que se crearán.Un cambio de rol primario/secundario en una base de datos PostgreSQL autogestionada provoca el fallo de la tarea.
Google Cloud SQL for PostgreSQL:
-
Establezca el parámetro Database Account en una cuenta con el permiso
cloudsqlsuperuser. Al seleccionar objetos para sincronizar, seleccione únicamente aquellos que la cuenta tenga autorización para gestionar, o conceda a la cuenta el permiso OWNER sobre dichos objetos.NotaUna cuenta con el permiso
cloudsqlsuperuserno puede gestionar datos propiedad de otras cuentas con el mismo permiso.
Consistencia de datos
Evalúe el impacto en el rendimiento de las bases de datos de origen y destino antes de iniciar la tarea. Ejecute la tarea en horarios de baja actividad.
Durante la sincronización completa de datos, las operaciones INSERT concurrentes generan fragmentación de tablas en la base de datos de destino, por lo que el tablespace de destino podría ser mayor que el de origen al finalizar la sincronización completa.
Se produce inconsistencia de datos si se escriben datos en la base de datos de destino desde fuentes distintas a DTS durante la sincronización. Si utiliza Data Management (DMS) para realizar operaciones DDL en línea mientras otras fuentes escriben en el destino, podría producirse pérdida de datos.
Si utiliza exclusivamente DTS para escribir datos en el destino, use DMS para realizar operaciones DDL en línea sobre las tablas de origen durante la sincronización. Consulte Cambio de esquemas sin bloqueo de tablas.
Recuperación de tareas
Si una tarea de DTS falla, el soporte técnico de DTS intentará recuperarla en un plazo de 8 horas. Durante la recuperación, la tarea podría reiniciarse y sus parámetros (no los de la base de datos) podrían modificarse. Para obtener detalles sobre qué parámetros pueden cambiar, consulte la sección Modificación de parámetros de instancia en Modificación de parámetros de una instancia de DTS.
Configuración de una tarea de sincronización de datos
Paso 1: Ir a Tareas de sincronización de datos
Inicie sesión en la consola de Data Management (DMS).
En la barra de navegación superior, haga clic en Data + AI.
-
En el panel de navegación izquierdo, vaya a DTS (DTS) > Data Synchronization.
NotaLa navegación puede variar según el modo y el diseño de la consola DMS. Consulte Modo simple y Personalización del diseño y estilo de la consola DMS.
También puede ir directamente a la página de Tareas de sincronización de datos de la nueva consola DTS.
Paso 2: Crear una tarea
-
En el lado derecho de Data Synchronization Tasks, seleccione la región donde residirá la instancia de sincronización.
NotaEn la nueva consola DTS, seleccione la región en la barra de navegación superior.
Haga clic en Create Task.
-
(Opcional) Haga clic en New Configuration Page en la esquina superior derecha.
NotaOmita este paso si se muestra Back to Previous Version.
Utilice la nueva página de configuración, ya que algunos parámetros difieren entre versiones.
Paso 3: Configurar las bases de datos de origen y destino
Configure los siguientes parámetros:
Nombre de la tarea
|
Parámetro |
Descripción |
|
Task Name |
Nombre para la tarea de DTS. DTS genera un nombre predeterminado; especifique un nombre descriptivo para identificar fácilmente la tarea. El nombre no necesita ser único. |
Base de datos de origen
|
Parámetro |
Descripción |
|
Select a DMS database instance. |
Seleccione una base de datos registrada existente para completar automáticamente la configuración, o déjelo en blanco y configúrela manualmente. Para registrar una base de datos, consulte Registro de una instancia de base de datos de Alibaba Cloud o Registro de una base de datos alojada en un servicio en la nube de terceros o una base de datos autogestionada. Para el registro desde la consola DTS, consulte Gestión de conexiones de bases de datos. |
|
Database Type |
Seleccione PostgreSQL. |
|
Access Method |
Seleccione Alibaba Cloud Instance. |
|
Instance Region |
La región de la instancia de origen de RDS for PostgreSQL. |
|
Replicate Data Across Alibaba Cloud Accounts |
Seleccione No para usar una base de datos en la cuenta actual. |
|
Instance ID |
El ID de la instancia de origen de RDS for PostgreSQL. |
|
Database Name |
El nombre de la base de datos de origen que contiene los datos a sincronizar. |
|
Database Account |
La cuenta con privilegios para la instancia de origen. |
|
Database Password |
La contraseña de la cuenta de la base de datos. |
|
Encryption |
Seleccione Non-encrypted para una conexión estándar, o SSL-encrypted para una conexión cifrada. Para SSL, cargue el CA Certificate y, opcionalmente, el Client Certificate y la Private Key of Client Certificate; luego establezca la Private Key Password of Client Certificate. Consulte Cifrado SSL. |
Base de datos de destino
|
Parámetro |
Descripción |
|
Select a DMS database instance. |
Seleccione una base de datos registrada existente para completar automáticamente la configuración, o configúrela manualmente. |
|
Database Type |
Seleccione AnalyticDB for PostgreSQL. |
|
Access Method |
Seleccione Alibaba Cloud Instance. |
|
Instance Region |
La región de la instancia de destino de AnalyticDB for PostgreSQL. |
|
Instance ID |
El ID de la instancia de destino de AnalyticDB for PostgreSQL. |
|
Database Name |
El nombre de la base de datos de destino. |
|
Database Account |
La cuenta para la instancia de destino, con permisos de lectura y escritura. |
|
Database Password |
La contraseña de la cuenta de la base de datos. |
Paso 4: Probar la conectividad
Haga clic en Test Connectivity and Proceed.
DTS agrega automáticamente sus bloques CIDR de servidor a las listas blancas de las instancias de bases de datos de Alibaba Cloud y a las reglas de security group de las bases de datos alojadas en ECS. Para bases de datos autogestionadas en centros de datos o plataformas en la nube de terceros, agregue manualmente los bloques CIDR del servidor DTS a la lista blanca de la base de datos. Consulte Bloques CIDR de servidores DTS.
Agregar bloques CIDR de DTS a listas blancas o security groups implica riesgos de seguridad. Antes de continuar, tome medidas preventivas como aplicar credenciales seguras, limitar puertos expuestos, autenticar llamadas a la API, auditar regularmente las reglas de lista blanca y utilizar Express Connect, VPN Gateway o Smart Access Gateway para conectar la base de datos a DTS.
Paso 5: Configurar objetos de sincronización
Elegir tipos de sincronización
Seleccione los tipos de sincronización adecuados para su caso de uso:
|
Tipo de sincronización |
Cuándo seleccionarlo |
|
Schema Synchronization |
Selecciónelo para que DTS cree automáticamente las tablas de destino. Es obligatorio si también selecciona Full Data Synchronization. |
|
Full Data Synchronization |
Selecciónelo para copiar todos los datos existentes del origen al destino antes de iniciar la sincronización incremental. Es necesario para la configuración inicial. |
|
Incremental Data Synchronization |
Seleccionado de forma predeterminada. Mantiene el destino sincronizado con los cambios continuos del origen mediante replicación lógica. Es obligatorio para la sincronización continua. |
Para la mayoría de las configuraciones, seleccione las tres opciones: la sincronización de esquemas crea las tablas, la sincronización completa copia los datos históricos y la sincronización incremental mantiene actualizado el destino.
Configurar objetos y manejo de conflictos
|
Parámetro |
Descripción |
|
DDL and DML Operations to Be Synchronized |
Las operaciones SQL a sincronizar. Para configurar por tabla, haga clic derecho sobre un objeto en Selected Objects y seleccione las operaciones. Consulte SQL operations that support incremental synchronization. |
|
Processing Mode of Conflicting Tables |
Precheck and Report Errors: falla la verificación previa si las tablas de destino comparten nombres con las de origen. Utilice el mapeo de nombres de objetos para resolver conflictos. Ignore Errors and Proceed: omite la verificación de conflictos de nombres. Durante la sincronización completa, se conservan los registros existentes en el destino con claves primarias o únicas coincidentes; durante la sincronización incremental, se sobrescriben. Si los esquemas difieren, la inicialización podría fallar parcialmente. |
|
Capitalization of Object Names in Destination Instance |
Define cómo maneja DTS el uso de mayúsculas y minúsculas en los nombres de bases de datos, tablas y columnas en el destino. El valor predeterminado es DTS default policy. Consulte Especificación del uso de mayúsculas en nombres de objetos de la instancia de destino. |
|
Source Objects |
Seleccione objetos de esta sección y haga clic en |
|
Selected Objects |
Haga clic derecho en una tabla para cambiarle el nombre, establecer filtros de datos o configurar operaciones SQL por tabla. Para renombrar varios objetos a la vez, haga clic en Batch Edit. Consulte Mapeo de nombres de objetos y Set filter conditions. |
 para agregarlos a Selected Objects. Granularidad seleccionable: columnas, tablas o esquemas.
Cambiar el nombre de un objeto mediante el mapeo de nombres de objetos puede provocar que los objetos dependientes fallen en la sincronización.
Configurar ajustes avanzados
Haga clic en Next: Advanced Settings y configure los siguientes parámetros:
|
Parámetro |
Descripción |
|
Dedicated Cluster for Task Scheduling |
DTS utiliza un clúster compartido de forma predeterminada. Adquiera un clúster dedicado para mayor estabilidad. Consulte ¿Qué es un clúster dedicado de DTS?. |
|
Retry Time for Failed Connections |
Tiempo durante el cual DTS reintenta conexiones fallidas después de iniciar la tarea. Rango: 10–1440 minutos. Valor predeterminado: 720 minutos. Establézcalo en más de 30 minutos. Si DTS se reconecta dentro de este periodo, la tarea se reanuda; de lo contrario, falla. Se aplica el valor más corto entre las tareas que comparten el mismo origen o destino. |
|
Retry Time for Other Issues |
Tiempo durante el cual DTS reintenta operaciones DDL o DML fallidas. Rango: 1–1440 minutos. Valor predeterminado: 10 minutos. Establézcalo en más de 10 minutos y manténgalo inferior a Retry Time for Failed Connections. |
|
Enable Throttling for Full Data Synchronization |
Limita la carga de lectura/escritura en las bases de datos de origen y destino durante la sincronización completa. Configure Queries per second (QPS) to the source database, RPS of Full Data Migration y Data migration speed for full migration (MB/s). Disponible solo cuando se selecciona Full Data Synchronization. |
|
Enable Throttling for Incremental Data Synchronization |
Limita la carga durante la sincronización incremental. Configure RPS of Incremental Data Synchronization y Data synchronization speed for incremental synchronization (MB/s). |
|
Environment Tag |
Etiqueta opcional para identificar la instancia de DTS por entorno. |
|
Configure ETL |
Establézcalo en Yes para habilitar el procesamiento de extracción, transformación y carga (ETL) e introducir sentencias de transformación de datos. Establézcalo en No para omitirlo. Consulte ¿Qué es ETL? y Configuración de ETL en una tarea de migración o sincronización de datos. |
|
Monitoring and Alerting |
Establézcalo en Yes para recibir alertas cuando la tarea falle o la latencia de sincronización supere un umbral. Configure el umbral de alerta y los ajustes de notificación. Consulte Configuración de monitoreo y alertas. |
Configurar verificación de datos
Haga clic en Next Step: Data Verification para configurar la verificación de datos. Consulte Configuración de una tarea de verificación de datos.
(Opcional) Configurar campos de base de datos y tablas
Haga clic en Next: Configure Database and Table Fields para definir la estructura de tablas en la instancia de destino de AnalyticDB for PostgreSQL:
|
Parámetro |
Descripción |
|
Type |
El tipo de tabla en la instancia de destino. |
|
Primary Key Column |
La columna o columnas de clave primaria. Varias columnas forman una clave primaria compuesta. |
|
Distribution Key |
La clave de distribución para la tabla. Debe ser una de las columnas de clave primaria. Consulte Manage tables y Define table distribution. |
Este paso solo está disponible cuando se selecciona Schema Synchronization. Establezca Definition Status en All para ver y modificar todas las tablas.
Paso 6: Guardar configuración y ejecutar verificación previa
Haga clic en Next: Save Task Settings and Precheck.
Para previsualizar los parámetros de la API correspondientes a esta configuración de tarea, pase el cursor sobre el botón y haga clic en Preview OpenAPI parameters.
DTS ejecuta una verificación previa antes de iniciar la tarea. La tarea comienza únicamente después de aprobar dicha verificación.
Si la verificación previa falla, haga clic en View Details junto a cada elemento fallido, resuelva los problemas y haga clic en Precheck Again.
Si se activa una alerta: si no puede ignorarse, resuelva el problema y vuelva a ejecutar la verificación previa. Si puede ignorarse, haga clic en Confirm Alert Details, luego en Ignore, después en OK y finalmente en Precheck Again. Ignorar alertas puede causar inconsistencia en los datos.
Paso 7: Adquirir e iniciar la instancia
Espere hasta que Success Rate alcance 100% y luego haga clic en Next: Purchase Instance.
En la página de compra, configure lo siguiente:
|
Parámetro |
Descripción |
|
Billing Method |
Subscription: pago anticipado por un plazo fijo, más rentable para uso a largo plazo. Pay-as-you-go: facturación por hora, adecuado para uso a corto plazo. Libere la instancia cuando ya no la necesite para detener los cargos. |
|
Resource Group Settings |
El resource group para la instancia. Valor predeterminado: default resource group. Consulte ¿Qué es Resource Management? |
|
Instance Class |
El nivel de velocidad de sincronización. Consulte Clases de instancia de sincronización de datos. |
|
Subscription Duration |
Disponible solo para el método de facturación por suscripción. Opciones: 1–9 meses, 1 año, 2 años, 3 años o 5 años. |
Lea y seleccione Data Transmission Service (Pay-as-you-go) Service Terms, y luego haga clic en Buy and Start. En el cuadro de diálogo de confirmación, haga clic en OK.
La tarea aparecerá en la lista de tareas, donde podrá monitorear su progreso.
Pasos siguientes
Logical Replication Slot Failover — habilite esta función en la instancia de origen de RDS si planea realizar cambios de rol primario/secundario.
Mapeo de nombres de objetos — cambie el nombre de objetos en el destino sin modificar los objetos de origen.
Modificación de parámetros de una instancia de DTS — ajuste los parámetros de la tarea después de iniciarla.
Configuración de una tarea de verificación de datos — verifique la consistencia de datos entre el origen y el destino.