AnalyticDB for PostgreSQL distribuye los datos de las tablas entre los nodos de cómputo según el esquema de distribución que usted elija al crear la tabla. El esquema y la clave de distribución que seleccione afectan directamente el rendimiento de las consultas, el equilibrio de los datos y la eficiencia de las uniones en todo su clúster.
Esquemas de distribución
AnalyticDB for PostgreSQL admite tres esquemas de distribución:
CREATE TABLE <table_name> (...)
[ DISTRIBUTED BY (<column> [,..] ) | DISTRIBUTED RANDOMLY | DISTRIBUTED REPLICATED ]La versión V4.3 solo admite distribución por hash y distribución aleatoria. La distribución replicada se introdujo en la V6.0.
|
Esquema |
Sintaxis |
Funcionamiento |
Cuándo utilizarlo |
|
Distribución por hash (predeterminado) |
|
Asigna cada fila a un nodo de cómputo según el valor hash de la columna de distribución. Las filas con el mismo valor hash se envían al mismo nodo. Si no se especifica una cláusula |
Úselo para la mayoría de las tablas. Permite uniones colocalizadas y filtrado por nodo de cómputo cuando las consultas utilizan la clave de distribución. |
|
Distribución aleatoria |
|
Distribuye las filas uniformemente entre todos los nodos de cómputo mediante un algoritmo round-robin. Las filas con el mismo valor hash pueden terminar en nodos diferentes. |
Utilícelo solo cuando ninguna columna sea adecuada para la distribución por hash. No admite uniones colocalizadas ni filtrado por nodo de cómputo. |
|
Distribución replicada |
|
Almacena una copia completa de la tabla en cada nodo de cómputo. |
Apropiado para tablas de búsqueda pequeñas que se unen frecuentemente con tablas grandes. Mejora el rendimiento de las uniones. |
Ejemplos:
-- Hash distribution
CREATE TABLE products (
    name        varchar(40),
    prod_id     integer,
    supplier_id integer
) DISTRIBUTED BY (prod_id);

-- Random distribution
CREATE TABLE random_stuff (
    things  text,
    doodads text,
    etc     text
) DISTRIBUTED RANDOMLY;

-- Replicated distribution
CREATE TABLE replicated_stuff (
    things  text,
    doodads text,
    etc     text
) DISTRIBUTED REPLICATED;
Cómo afecta la distribución por hash al enrutamiento de consultas
Cuando una consulta filtra por la clave de distribución, AnalyticDB for PostgreSQL enruta la consulta únicamente a los nodos de cómputo que contienen las filas coincidentes. Por ejemplo, la siguiente consulta se envía solo al nodo que contiene prod_id = 101, en lugar de examinar todos los nodos:
SELECT * FROM products WHERE prod_id = 101;Elegir una clave de distribución
Siga estos pasos para seleccionar una clave de distribución eficaz para la distribución por hash:
Paso 1: Elija una columna con datos distribuidos uniformemente.
Una distribución desigual de los datos provoca sesgo de datos: algunos nodos de cómputo terminan con muchas más filas que otros, lo que aumenta su carga y ralentiza las consultas. Evite columnas booleanas, de hora y de fecha, ya que suelen tener baja cardinalidad y generan distribuciones sesgadas.
Paso 2: Elija una columna utilizada frecuentemente en condiciones de unión.
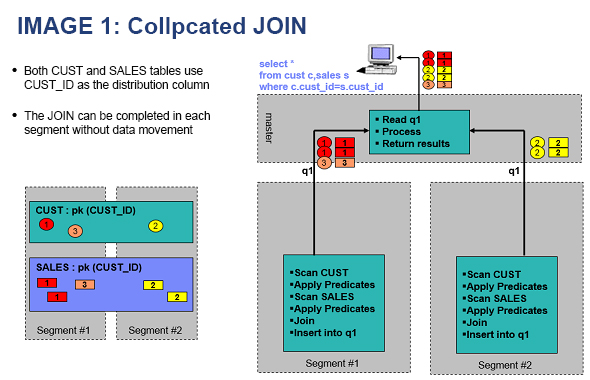
Cuando la clave de unión coincide con la clave de distribución, AnalyticDB for PostgreSQL realiza una unión colocalizada: cada nodo de cómputo une solo sus datos locales, sin movimiento de datos entre nodos.
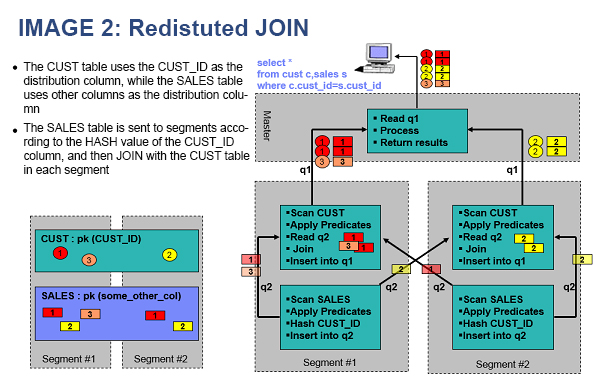
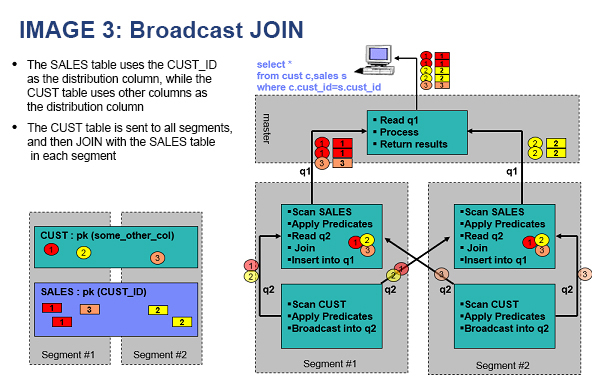
Si la clave de unión difiere de la clave de distribución, el motor de consultas debe ejecutar un movimiento de redistribución o un movimiento de difusión antes de la unión; ambos implican una mayor sobrecarga de red que una unión colocalizada.
Paso 3: Elija una columna utilizada frecuentemente como filtro de consulta.
Filtrar por la clave de distribución permite que AnalyticDB for PostgreSQL omita los nodos de cómputo que no contienen las filas relevantes, lo que reduce la cantidad de datos examinados por consulta.
Paso 4: Prefiera una clave única.
Una clave única, como la clave primaria, maximiza la cardinalidad y garantiza que las filas se distribuyan uniformemente entre los nodos. Si su tabla tiene una clave primaria, utilícela como punto de partida.
Paso 5: Considere una clave de distribución compuesta.
Si ninguna columna individual cumple con los criterios anteriores, combine dos o más columnas como clave de distribución:
CREATE TABLE t1 (c1 int, c2 int) DISTRIBUTED BY (c1, c2);Límites de las claves de distribución
Las columnas de la clave de distribución no se pueden actualizar. Para reasignar la distribución, use
ALTER TABLE ... SET DISTRIBUTED BY.-
La clave de distribución debe formar parte de la clave primaria o de una clave única. El siguiente ejemplo falla porque
c2(la clave de distribución) no está incluida en la clave primariac1:CREATE TABLE t1 (c1 int, c2 int, PRIMARY KEY (c1)) DISTRIBUTED BY (c2); -- ERROR: PRIMARY KEY and DISTRIBUTED BY definitions incompatible No se pueden usar columnas de tipo geometry ni tipos de datos personalizados como claves de distribución.
Solucionar problemas de sesgo de datos
El sesgo de datos ocurre cuando uno o más nodos de cómputo almacenan significativamente más filas que los demás. Una causa común es elegir una columna de baja cardinalidad, como una columna de estado o de fecha donde muchas filas comparten el mismo valor. Todas las filas con ese valor se asignan mediante hash al mismo nodo, lo que lo sobrecarga mientras los demás permanecen subutilizados.
Para detectar el sesgo de datos, consulte el recuento de filas por nodo de cómputo:
SELECT gp_segment_id, count(1)
FROM t1
GROUP BY 1
ORDER BY 2 DESC;

 gp_segment_id | count
---------------+--------
             2 | 131191
             0 |     72
             1 |     68
(3 rows)
El resultado anterior muestra un sesgo severo: el nodo 2 contiene casi todos los datos.
Para corregir el sesgo de datos, cambie la clave de distribución a una columna con valores distribuidos más uniformemente:
ALTER TABLE t1 SET DISTRIBUTED BY (c2);Después de la redistribución, los datos se distribuyen uniformemente entre todos los nodos de cómputo.