Utilice Data Transmission Service (DTS) para sincronizar datos desde un clúster de PolarDB for PostgreSQL hacia una instancia de ApsaraDB for SelectDB con el fin de realizar análisis de datos a gran escala. DTS admite la sincronización de esquemas, la sincronización completa de datos y la sincronización incremental continua.
Requisitos previos
Antes de empezar, asegúrese de contar con lo siguiente:
Una instancia de destino ApsaraDB for SelectDB con más espacio en disco que el utilizado por el clúster de origen PolarDB for PostgreSQL. Para obtener más información, consulte Create an instance.
El parámetro
wal_leveldel clúster de origen PolarDB for PostgreSQL debe estar establecido enlogical. Para obtener más información, consulte Set cluster parameters.
Facturación
|
Tipo de sincronización |
Costo |
|
Sincronización de esquemas y sincronización completa de datos |
Sin costo |
|
Sincronización incremental de datos |
Con cargo. Para obtener más información, consulte Descripción general de facturación. |
Operaciones SQL compatibles
|
Tipo de operación |
Sentencia SQL |
|
DML |
INSERT, UPDATE, DELETE |
|
DDL |
ADD COLUMN, DROP COLUMN |
Permisos obligatorios
|
Base de datos |
Permisos obligatorios |
Cómo otorgarlos |
|
Clúster de origen PolarDB for PostgreSQL |
Una cuenta con privilegios que sea propietaria de la base de datos a sincronizar |
|
|
Instancia de destino ApsaraDB for SelectDB |
Permisos de acceso al clúster (Usage_priv) y permisos de acceso a la base de datos (Select_priv, Load_priv, Alter_priv, Create_priv y Drop_priv) |
Límites
Base de datos de origen
Todas las tablas a sincronizar deben tener una clave primaria o un índice único no nulo. Si los campos de la tabla no son únicos, podrían aparecer datos duplicados en la base de datos de destino.
Para tablas sin clave primaria o índice único no nulo: seleccione Schema Synchronization en Synchronization Types y duplicate para Engine en el paso Configurations for Databases, Tables, and Columns.
Las transacciones de larga duración en la base de datos de origen pueden provocar la acumulación de registros WAL antes de que dichas transacciones se confirmen, lo cual podría agotar el espacio en disco de la base de datos de origen.
El clúster de PolarDB for PostgreSQL debe ser compatible con Logical Replication Slot Failover y tener esta función habilitada. Si el clúster utiliza PostgreSQL 14, que no admite Logical Replication Slot Failover, un cambio de alta disponibilidad (HA) podría causar un fallo permanente en la instancia de sincronización y requerir una reconfiguración completa.
Si un solo cambio incremental supera los 256 MB, la instancia de sincronización podría fallar permanentemente. Reconfigure la instancia de sincronización para recuperarla.
No ejecute operaciones DDL que modifiquen esquemas durante la sincronización inicial de esquemas o la sincronización inicial completa de datos. DTS consulta la base de datos de origen durante la sincronización inicial completa de datos, lo que genera bloqueos de metadatos que pueden impedir las operaciones DDL.
Base de datos de destino
Requisitos del modelo de datos de SelectDB
DTS solo puede sincronizar datos hacia tablas que utilicen el modelo Unique Key o el modelo Duplicate key en ApsaraDB for SelectDB. Elija el modelo según sus necesidades:
|
Requisito |
Modelo recomendado |
Notas |
|
Registros consistentes y deduplicados |
Modelo Unique Key |
Todas las claves únicas de la tabla de destino deben existir en la tabla de origen y en el objeto de sincronización. La ausencia de claves provoca inconsistencia en los datos. |
|
Inserción tipo append-only o de alto throughput |
Modelo Duplicate key |
Pueden aparecer datos duplicados si se produce un reintento o si se ejecutan dos o más operaciones DML sobre la misma fila después de iniciar la instancia de sincronización. Utilice las columnas |
Restricciones de objetos y nombres
Solo se puede especificar el parámetro
bucket_counten la sección Selected Objects. El valor debe ser un entero positivo. Valor predeterminado: auto.ApsaraDB for SelectDB solo admite nombres de bases de datos y tablas que comiencen con una letra. Utilice la función de asignación de nombres de objetos para renombrar aquellos que no empiecen con una letra.
Los nombres de objetos (bases de datos, tablas o columnas) que contengan caracteres chinos deben renombrarse mediante la función de asignación de nombres de objetos.
Una sola instancia de sincronización únicamente puede sincronizar una base de datos. Para sincronizar varias bases de datos, configure una instancia de sincronización independiente para cada una.
Alcance de la sincronización y límites de DDL
No se admite la sincronización de tablas de extensión TimescaleDB ni de tablas con herencia entre esquemas.
No es posible modificar operaciones DDL en varias columnas simultáneamente, ni ejecutar modificaciones DDL consecutivas sobre la misma tabla.
En un escenario de fusión de múltiples tablas (sincronización de varias tablas de origen a una sola tabla de destino), los esquemas de todas las tablas de origen deben ser idénticos. De lo contrario, podrían producirse inconsistencias en los datos o fallos en la tarea.
Tablas particionadas
Al sincronizar tablas particionadas, incluya tanto la tabla principal como todas sus particiones secundarias como objetos de sincronización. La tabla principal de una tabla particionada de PostgreSQL no almacena datos directamente; todos los datos residen en las particiones secundarias. Omitir particiones provoca inconsistencia en los datos.
Requisito de REPLICA IDENTITY
Ejecute el siguiente comando en las tablas antes de escribir datos en estos tres escenarios: cuando la instancia se ejecuta por primera vez; cuando selecciona objetos a nivel de esquema y se crea o reconstruye una tabla nueva mediante RENAME; y cuando utiliza la función para modificar objetos de sincronización.
ALTER TABLE schema.table REPLICA IDENTITY FULL;Reemplace schema y table con el nombre real del esquema y de la tabla. Ejecute este comando fuera de horas pico. No realice operaciones de bloqueo de tablas mientras se ejecuta este comando. Si omite la verificación previa correspondiente, DTS ejecutará automáticamente este comando durante la inicialización de la instancia.
Operaciones que causan fallos en la tarea
Las siguientes operaciones provocan el fallo de la tarea de sincronización. Reinicie la instancia de sincronización para reanudarla:
Agregar nodos de backend a la base de datos de destino ApsaraDB for SelectDB durante la sincronización
Crear clústeres en la instancia de destino ApsaraDB for SelectDB durante la sincronización
Tablas temporales
DTS crea las siguientes tablas temporales en la base de datos de origen para permitir la sincronización incremental. No las elimine durante la sincronización, ya que se borran automáticamente después de liberar la instancia de DTS:
public.dts_pg_class, public.dts_pg_attribute, public.dts_pg_type, public.dts_pg_enum, public.dts_postgres_heartbeat, public.dts_ddl_command, public.dts_args_session y public.aliyun_dts_instance.
Slot de replicación
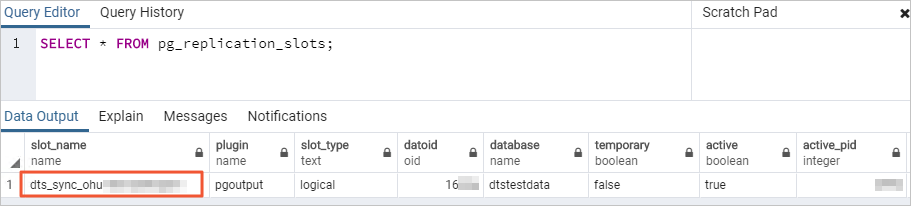
DTS crea un slot de replicación con el prefijo dts_sync_ en la base de datos de origen. Este slot retiene los registros incrementales de los últimos 15 minutos. Cuando la tarea de sincronización falla o se libera la instancia, DTS intenta limpiar el slot automáticamente.
Si cambia la contraseña de la cuenta de la base de datos de origen o elimina la lista de permitidos de direcciones IP de DTS durante la sincronización, el slot de replicación no podrá limpiarse automáticamente. Limpie manualmente el slot de replicación para evitar que se agote el espacio en disco. Si ocurre un cambio entre base de datos principal y secundaria, inicie sesión en la base de datos secundaria para realizar la limpieza.
Incremental synchronization latency
DTS utiliza una política de sincronización por lotes para reducir la carga en el destino. De forma predeterminada, DTS escribe datos como máximo una vez cada 5 segundos por objeto de sincronización, lo que resulta en una latencia de sincronización normal de hasta 10 segundos. Para reducir esta latencia, modifique el parámetro selectdb.reservoir.timeout.milliseconds de la instancia de DTS en la consola. El rango válido es de 1,000 a 10,000 milisegundos.
Un tiempo de procesamiento por lotes menor aumenta la frecuencia de escritura, lo que puede incrementar la carga y el tiempo de respuesta de escritura del destino y, a su vez, aumentar la latencia de sincronización de DTS. Ajuste el tiempo de procesamiento por lotes según la carga del destino.
Otras notas
DTS no verifica la validez de metadatos como las secuencias. Compruebe manualmente la validez de los metadatos antes y después de la sincronización.
Realice la sincronización completa de datos cuando la carga de CPU de las bases de datos de origen y de destino sea inferior al 30%.
Si una instancia falla, el equipo de soporte de DTS intentará recuperarla dentro de un plazo de 8 horas. Durante la recuperación, solo se podrán modificar los parámetros de la instancia de DTS; los parámetros de la base de datos no se alterarán. Para consultar los parámetros modificables, véase Modify instance parameters.
Crear una tarea de sincronización
Paso 1: Ir a la página Data Synchronization
Utilice una de las siguientes consolas.
Consola de DTS
Inicie sesión en .DTS console
En el panel de navegación izquierdo, haga clic en Data Synchronization.
En la esquina superior izquierda de la página, seleccione la región donde reside la tarea de sincronización.
Consola de DMS
Nota
Las operaciones reales pueden variar según el modo y el diseño de la consola de DMS. Para obtener más información, consulte Modo simple y Personalizar el diseño y estilo de la consola de DMS.
Inicie sesión en .DMS console
En la barra de navegación superior, pase el puntero sobre Data + AI y elija DTS (DTS) > Data Synchronization.
En la lista desplegable a la derecha de Data Synchronization Tasks, seleccione la región donde reside la instancia de sincronización.
Paso 2: Configurar las bases de datos de origen y de destino
Haga clic en Create Task para ir a la página de configuración de tareas.
-
Configure las bases de datos de origen y de destino mediante los siguientes parámetros.
Categoría
Parámetro
Descripción
Ninguna
Task Name
Nombre de la tarea. DTS genera un nombre automáticamente. Especifique un nombre descriptivo para facilitar la identificación de la tarea. No es necesario que sea único.
Source Database
Select Existing Connection
Si registró la instancia de base de datos en DTS, selecciónela de la lista desplegable. DTS completará automáticamente los parámetros de la base de datos. De lo contrario, configure manualmente los siguientes parámetros.
Database Type
Seleccione PolarDB for PostgreSQL.
Access Method
Seleccione Alibaba Cloud Instance.
Instance Region
Seleccione la región donde reside el clúster de origen PolarDB for PostgreSQL.
Replicate Data Across Alibaba Cloud Accounts
Seleccione No si las bases de datos de origen y de destino pertenecen a la misma cuenta de Alibaba Cloud.
Instance ID
Seleccione el ID del clúster de origen PolarDB for PostgreSQL.
Database Name
Introduzca el nombre de la base de datos que contiene los objetos a sincronizar.
Database Account
Introduzca la cuenta de la base de datos. Para consultar los requisitos de permisos, véase Required permissions.
Database Password
Introduzca la contraseña de la cuenta de la base de datos.
Destination Database
Select Existing Connection
Si registró la instancia de base de datos en DTS, selecciónela de la lista desplegable. DTS completará automáticamente los parámetros de la base de datos. De lo contrario, configure manualmente los siguientes parámetros.
Database Type
Seleccione SelectDB.
Access Method
Seleccione Alibaba Cloud Instance.
Instance Region
Seleccione la región donde reside la instancia de destino SelectDB.
Replicate Data Across Alibaba Cloud Accounts
Seleccione No si las bases de datos de origen y de destino pertenecen a la misma cuenta de Alibaba Cloud.
Instance ID
Seleccione el ID de la instancia de destino SelectDB.
Database Account
Introduzca la cuenta de la base de datos. Para consultar los requisitos de permisos, véase Required permissions.
Database Password
Introduzca la contraseña de la cuenta de la base de datos.
-
Haga clic en Test Connectivity and Proceed.
Asegúrese de que los bloques CIDR de los servidores de DTS estén agregados a la configuración de seguridad tanto de la base de datos de origen como de la de destino. Para obtener más información, consulte Agregar direcciones IP de servidores DTS a una lista de permitidos .
Paso 3: Configurar objetos de sincronización
-
En el paso Configure Objects, configure los parámetros de sincronización.
Parámetro Descripción Synchronization Types De forma predeterminada, Incremental Data Synchronization está seleccionado. Seleccione también Schema Synchronization y Full Data Synchronization. Una vez completada la verificación previa, DTS sincroniza los datos históricos como base para la sincronización incremental continua. ImportanteAl sincronizar desde PolarDB for PostgreSQL hacia SelectDB, se convierten los tipos de datos. Si no selecciona Schema Synchronization, cree manualmente las tablas de destino utilizando el modelo Unique o Duplicate correspondiente. Para obtener más información, consulte Data type mapping, Additional column information y Data model.
Processing Mode of Conflicting Tables Precheck and Report Errors: DTS busca tablas con el mismo nombre en la base de datos de destino. Si existe una tabla duplicada, la verificación previa falla y la tarea no se inicia. NotaSi no puede eliminar o renombrar la tabla duplicada, utilice la función de asignación de nombres de objetos. Para obtener más información, consulte Asignar nombres de esquemas, tablas y columnas. Ignore Errors and Proceed: DTS omite la verificación de nombres de tablas duplicados.
AvisoEsta opción puede causar inconsistencia en los datos. Si los esquemas de las tablas son iguales y un registro tiene una clave primaria o única coincidente, el registro de origen sobrescribe al de destino. Si los esquemas difieren, la inicialización podría fallar o solo se sincronizarán algunas columnas.
Capitalization of Object Names in Destination Instance La política de uso de mayúsculas y minúsculas para nombres de bases de datos, tablas y columnas en la instancia de destino. Predeterminado: DTS default policy. Para obtener más información, consulte Especificar el uso de mayúsculas y minúsculas en nombres de objetos de la instancia de destino. Source Objects Seleccione uno o varios objetos y haga clic en el icono  para moverlos a Selected Objects. Los objetos se pueden seleccionar a nivel de esquema, tabla o columna.
Selected Objects - Para renombrar un objeto de destino o especificar un objeto receptor, haga clic derecho sobre él en la sección Selected Objects. Para obtener más información, consulte Asignar nombres de objetos. - Para quitar un objeto seleccionado, haga clic en él y luego en el icono  . - Para establecer el parámetro
bucket_countde una tabla (disponible solo cuando Schema Synchronization está seleccionado y los objetos se seleccionan a nivel de tabla): haga clic derecho en la tabla, establezca Enable Parameter Settings en Yesconfiguración de notificaciones de alertas, introduzca el valor y haga clic en OK.NotaRenombrar un objeto mediante la asignación de nombres puede provocar que objetos dependientes fallen en la sincronización. Para filtrar datos con condiciones WHERE, haga clic derecho en una tabla y especifique las condiciones. Para obtener más información, consulte Especificar condiciones de filtro. Para seleccionar operaciones SQL para la sincronización incremental, haga clic derecho en un objeto y seleccione las operaciones.
-
Haga clic en Next: Advanced Settings y configure los siguientes parámetros.
Parámetro Descripción Dedicated Cluster for Task Scheduling De forma predeterminada, DTS programa la tarea en el clúster compartido. Para mejorar la estabilidad, adquiera un clúster dedicado. Para obtener más información, consulte Qué es un clúster dedicado de DTS. Retry Time for Failed Connections Intervalo de tiempo para reintentar conexiones fallidas. Valores válidos: 10–1440 minutos. Predeterminado: 720 minutos. Establezca un valor superior a 30 minutos. Si DTS se reconecta dentro de este intervalo, la tarea se reanuda. De lo contrario, la tarea falla. NotaSi varias tareas comparten la misma base de datos de origen o de destino y tienen diferentes intervalos de reintento, prevalece el intervalo más corto. DTS cobra por la instancia durante los reintentos.
Retry Time for Other Issues Intervalo de tiempo para reintentar operaciones DDL o DML fallidas. Valores válidos: 1–1440 minutos. Predeterminado: 10 minutos. Establezca un valor superior a 10 minutos. Este valor debe ser menor que Retry Time for Failed Connections. Enable Throttling for Full Data Synchronization Limite la velocidad de la sincronización completa de datos para reducir la carga en el origen y el destino. Configure Queries per second (QPS) to the source database, RPS of Full Data Migration y Data migration speed for full migration (MB/s). Disponible solo cuando Full Data Synchronization está seleccionado. Enable Throttling for Incremental Data Synchronization Limite la velocidad de la sincronización incremental de datos configurando RPS of Incremental Data Synchronization y Data synchronization speed for incremental synchronization (MB/s). Environment Tag Etiqueta opcional para identificar la instancia. Configure ETL Especifique si desea habilitar la función de extracción, transformación y carga (ETL). Seleccione Yes para introducir sentencias de procesamiento de datos en el editor de código. Para obtener más información, consulte Configurar ETL en una tarea de migración o sincronización de datos. Seleccione No para omitir la configuración de ETL. Monitoring and Alerting Especifique si desea configurar alertas. Seleccione Yes para configurar el umbral de alerta y la configuración de notificaciones. Para obtener más información, consulte la sección Configurar monitoreo y alertas al crear una tarea de DTS. -
(Opcional) Haga clic en Next: Configure Database and Table Fields para establecer la Primary Key Column, Distribution Key y Engine de las tablas de destino.
- Este paso solo está disponible cuando Schema Synchronization está seleccionado en Synchronization Types . Establezca Definition Status en All para realizar modificaciones. - Puede seleccionar varias columnas como clave primaria compuesta. Como mínimo, una columna de Primary Key Column debe seleccionarse también como Distribution Key . - Para tablas sin clave primaria o restricción UNIQUE, establezca Engine en duplicate . De lo contrario, la sincronización podría fallar o se podrían perder datos.
Paso 4: Ejecutar la verificación previa
-
Haga clic en Next: Save Task Settings and Precheck. DTS ejecuta una verificación previa antes de que pueda iniciarse la tarea de sincronización. La tarea solo comienza después de superar dicha verificación.
Para ver los parámetros de API de esta configuración, pase el puntero sobre Next: Save Task Settings and Precheck y haga clic en Preview OpenAPI parameters .
Si la verificación previa falla, haga clic en View Details junto a cada elemento fallido, resuelva el problema y vuelva a ejecutar la verificación previa.
-
Si se activa una alerta:
Si la alerta no se puede ignorar, haga clic en View Details, corrija el problema y vuelva a ejecutar la verificación previa.
Si la alerta se puede ignorar, haga clic en Confirm Alert Details, haga clic en Ignore en el cuadro de diálogo View Details, haga clic en OK y luego en Precheck Again.
Ignorar alertas puede causar inconsistencia en los datos y exponer su negocio a riesgos.
Paso 5: Adquirir la instancia
Espere hasta que Success Rate alcance 100%, luego haga clic en Next: Purchase Instance.
-
En la página buy, configure los siguientes parámetros.
Parámetro
Descripción
Billing Method
Subscription: Pago anticipado por una duración fija. Más rentable para uso a largo plazo. Pay-as-you-go: Facturación por hora. Adecuado para uso a corto plazo. Libere la instancia cuando ya no la necesite para reducir costos.
Resource Group Settings
El resource group para la instancia de sincronización. Predeterminado: default resource group. Para obtener más información, consulte What is Resource Management?
Instance Class
Nivel de velocidad de sincronización. Selecciónelo según sus necesidades empresariales. Para obtener más información, consulte Clases de instancia de sincronización de datos.
Subscription Duration
Disponible solo para el método de facturación por suscripción. Opciones: 1–9 meses, 1 año, 2 años, 3 años o 5 años.
Lea y seleccione Data Transmission Service (Pay-as-you-go) Service Terms.
Haga clic en Buy and Start. En el cuadro de diálogo que aparece, haga clic en OK.
La tarea aparecerá en la lista de tareas. Monitoree su progreso desde allí.
Asignación de tipos de datos
La siguiente tabla muestra cómo se asignan los tipos de datos de PolarDB for PostgreSQL a los tipos de datos de SelectDB.
| Categoría | Tipo de dato de PolarDB for PostgreSQL | Tipo de dato de SelectDB |
|---|---|---|
| Numérico | SMALLINT | SMALLINT |
| INTEGER | INT | |
| BIGINT | BIGINT | |
| DECIMAL | DECIMAL | |
| NUMERIC | DECIMAL | |
| REAL | DOUBLE | |
| DOUBLE | DOUBLE | |
| SMALLSERIAL | SMALLINT | |
| SERIAL | INT | |
| BIGSERIAL | BIGINT | |
| Monetario | MONEY | STRING |
| Carácter | CHAR(n), VARCHAR(n) | VARCHAR. Importante
Para evitar la pérdida de datos, CHAR(n) y VARCHAR(n) se convierten a VARCHAR(4\*n). Si no se especifica longitud, se utiliza el valor predeterminado de SelectDB VARCHAR(65533). Si la longitud excede 65533, los datos se convierten a STRING. |
| TEXT | STRING | |
| Binario | BYTEA | STRING |
| Fecha y hora | TIMESTAMP [(P)] [WITHOUT TIME ZONE] | DATETIMEV2 |
| TIMESTAMP [(P)] WITH TIME ZONE | DATETIMEV2 | |
| DATE | DATEV2 | |
| TIME [(P)] [WITHOUT TIME ZONE] | VARCHAR(50) | |
| TIME [(P)] WITH TIME ZONE | VARCHAR(50) | |
| INTERVAL [FIELDS] [(P)] | STRING | |
| Booleano | BOOLEAN | BOOLEAN |
| Geométrico | POINT, LINE, LSEG, BOX, PATH, POLYGON, CIRCLE | STRING |
| Dirección de red | CIDR, INET, MACADDR, MACADDR8 | STRING |
| Búsqueda de texto | TSVECTOR | STRING |
| XML | XML | STRING |
| JSON | JSON | JSON |
Información adicional de columnas
Para tablas que utilizan el modelo Duplicate key, DTS agrega automáticamente o requiere las siguientes columnas en la tabla de destino.
|
Nombre de columna |
Tipo de dato |
Valor predeterminado |
Descripción |
|
|
Int |
0 |
Indicador de eliminación. Inserción: 0. Actualización: 0. Eliminación: 1. |
|
|
Bigint |
0 |
Sincronización completa de datos: 0. Sincronización incremental de datos: la marca de tiempo correspondiente en segundos del registro binario de la base de datos de origen. |
|
|
Bigint |
0 |
Sincronización completa de datos: 0. Sincronización incremental de datos: el ID de registro del registro incremental, que identifica de manera única la entrada del registro. El valor es único e incremental. |