DataStudio es el módulo de DataWorks para desarrollar y programar tareas periódicas. Se integra con Operation Center y ofrece una interfaz de desarrollo visual para motores de cómputo como MaxCompute, Hologres y E-MapReduce. Incluye desarrollo de código inteligente, flujos de trabajo híbridos multimotor y publicación estandarizada de tareas. DataStudio le permite construir almacenes de datos sin conexión, almacenes de datos en tiempo real y sistemas de consultas ad hoc.
Acceder a DataStudio
Inicie sesión en la consola de DataWorks. En la región objetivo, haga clic en en el panel de navegación izquierdo. Seleccione un espacio de trabajo de la lista desplegable y haga clic en Go to Data Development.
DataStudio solo es compatible con Google Chrome 69 o posterior en una PC.
Descripción general
Funciones
La siguiente tabla describe las principales funciones de DataStudio. Los términos clave se definen en Appendix: Concepts.

|
Tipo |
Descripción |
|
Organización y gestión de objetos |
DataStudio organiza y gestiona los objetos de las siguientes maneras:
Create a workflow. Management modes. Nota
En DataStudio, se aplican los siguientes límites al número de flujos de trabajo y objetos que puede crear en un workspace:
Si la cantidad de flujos de trabajo u objetos en el espacio de trabajo actual alcanza el límite superior, no podrá crear nuevos elementos. |
|
Desarrollo de tareas |
Todos los tipos de nodo disponibles se enumeran en Supported node types. |
|
Programación de tareas |
Configure time properties. Guide for configuring scheduling dependencies. |
|
Depuración de tareas |
DataStudio permite depurar tareas individuales y flujos de trabajo completos. Task debugging process. |
|
Control de procesos |
Ofrece publicación estandarizada de tareas y control de procesos:
|
|
Otras funciones |
|
Descripción general de la interfaz
Consulte DataStudio feature guide para conocer la interfaz de desarrollo de datos y aprender a utilizar las funciones de cada módulo.
Proceso de desarrollo
DataStudio admite tareas de sincronización en tiempo real, tareas programadas sin conexión (incluidas sincronización y procesamiento) y tareas activadas manualmente para diversos motores de cómputo. Para obtener información sobre las capacidades de sincronización de datos, consulte Data Integration. Antes de empezar, revise los requisitos de desarrollo de cada motor de cómputo y elija el tipo de tarea adecuado.
-
Guías de desarrollo de motores de cómputo: DataWorks es compatible con diversas fuentes de datos y motores de cómputo. Los requisitos de configuración varían según el motor. Guías principales de motores de cómputo:
-
Proceso general de desarrollo: Los espacios de trabajo de DataWorks operan en standard mode and basic mode. El proceso de desarrollo difiere ligeramente entre modos.
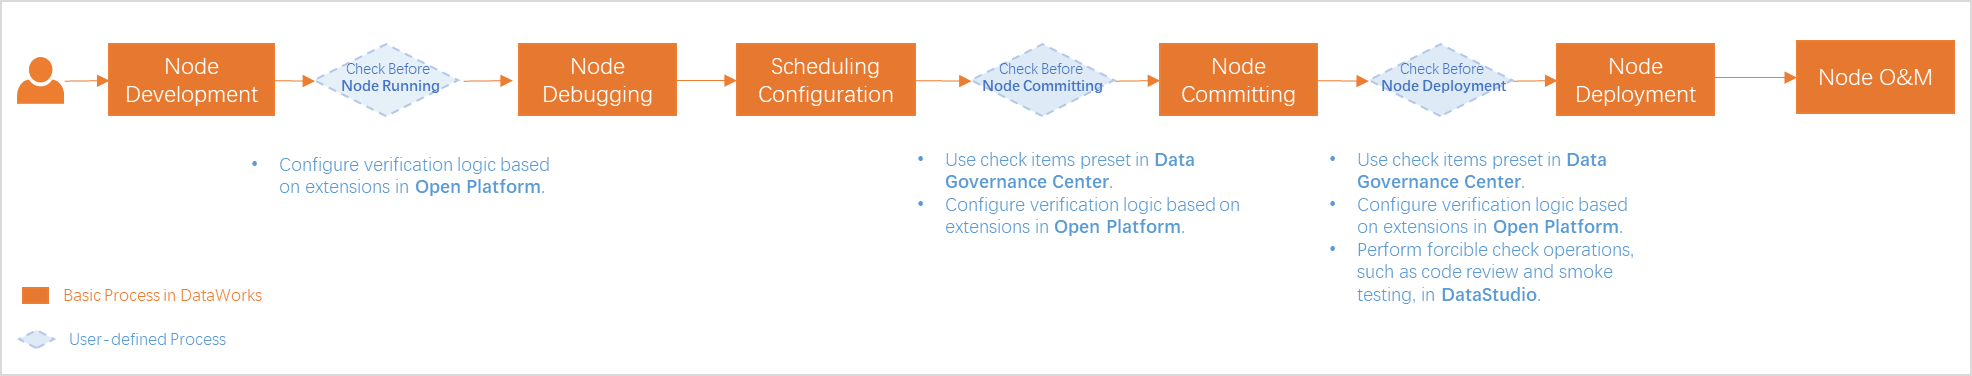
Proceso de desarrollo en un espacio de trabajo en modo estándar.
Proceso de desarrollo en un espacio de trabajo en modo básico.
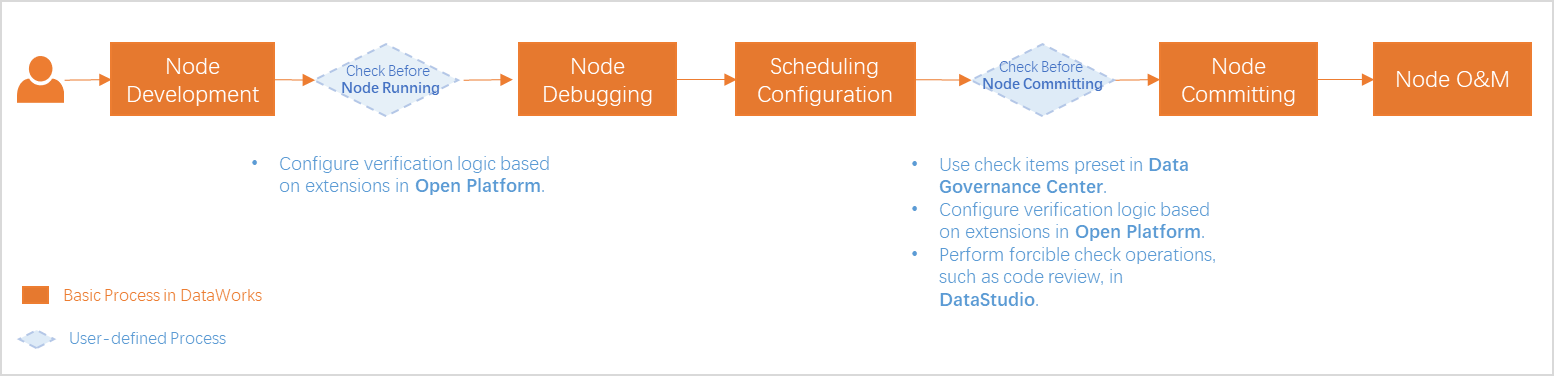
Proceso básico: En modo estándar, el ciclo de vida de la tarea programada incluye desarrollo, depuración, configuración de programación, confirmación, publicación y operación y mantenimiento. Guide to the data development process.
-
Control de procesos: Utilice code review y smoke testing integrados, verificaciones predefinidas en Data Governance Center y validación personalizada mediante extensiones de Open Platform para garantizar el cumplimiento de estándares.
NotaLas opciones de control de procesos varían según el modo del espacio de trabajo. Las funciones disponibles en la consola son definitivas.
Organización
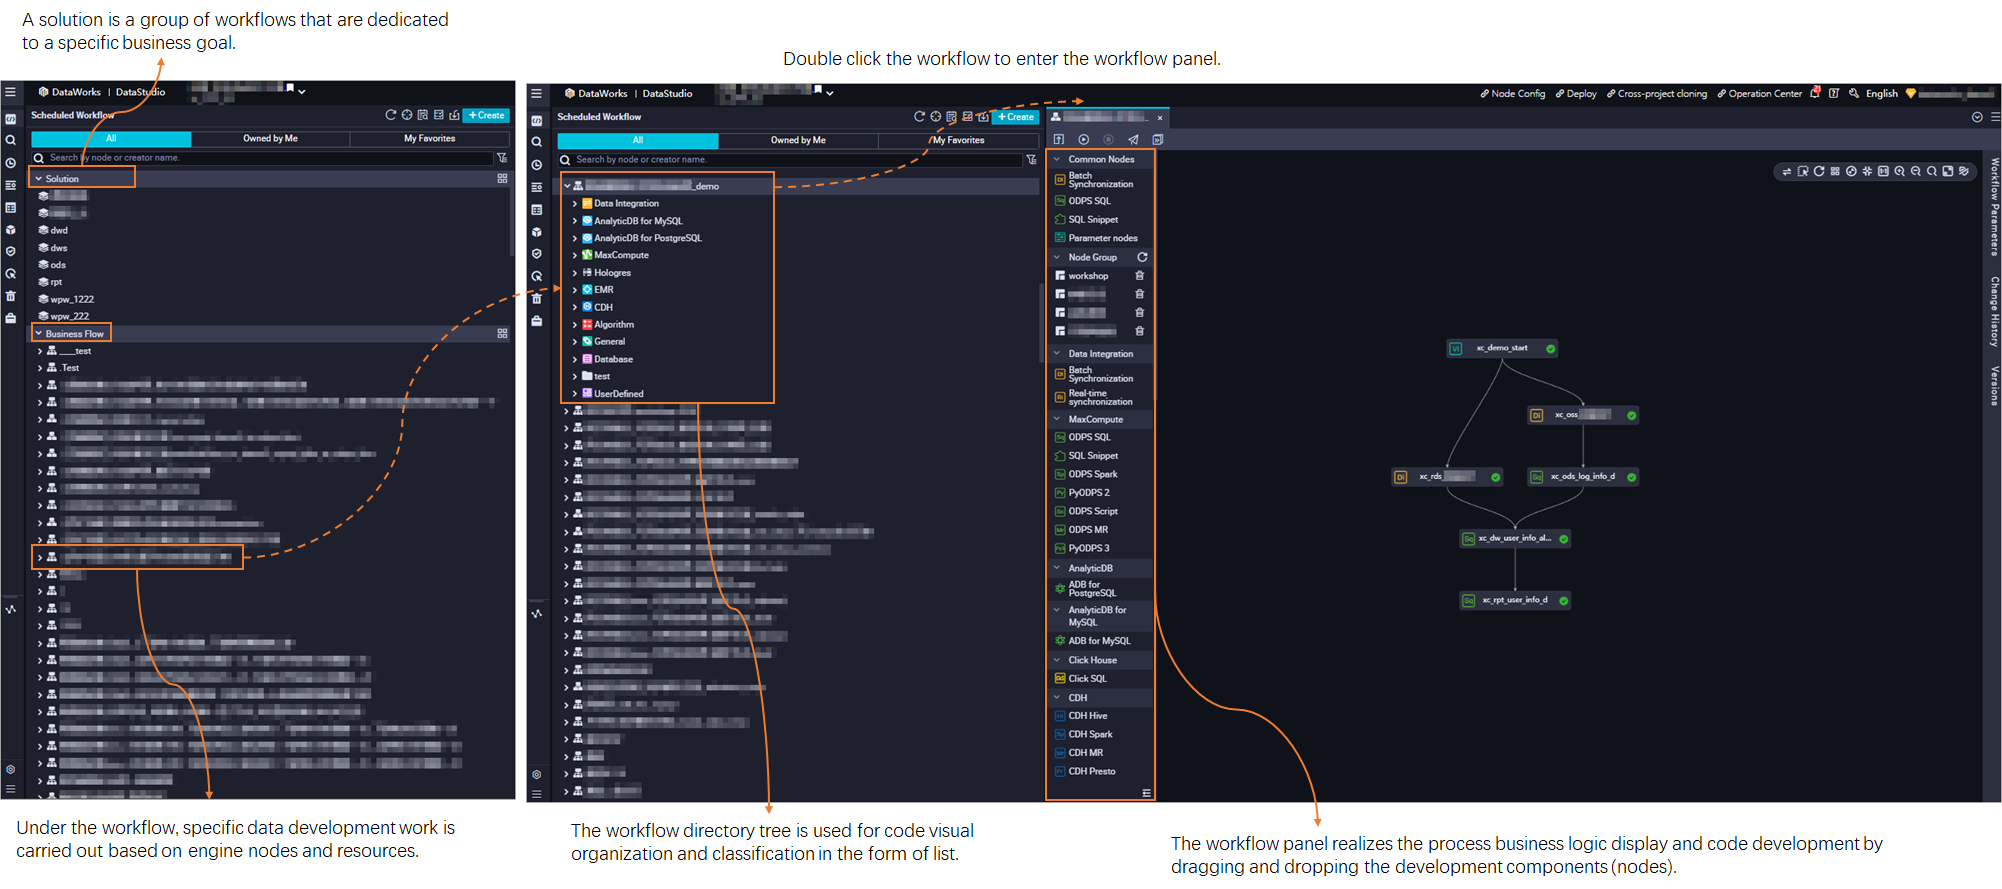
En DataStudio, el flujo de trabajo es la unidad básica para el desarrollo de código y la organización de recursos. Los flujos de trabajo y los nodos de tareas se desarrollan de forma independiente en cada espacio de trabajo y no se afectan entre sí. Create a workflow.
Los flujos de trabajo se presentan como un árbol de directorios y un panel de operaciones, lo que facilita organizar el código desde una perspectiva empresarial.
Estructura de árbol de directorios: Proporciona una forma de organizar el código según los tipos de tareas.
Panel de flujo de trabajo: Ofrece una visualización orientada a procesos de la lógica empresarial.
Primeros pasos
Requisitos previos
Para desarrollar tareas, modelar datos o programar tareas periódicas en DataWorks, debe asociar sus fuentes de datos o clústeres como recursos de cómputo en DataStudio. Sin esta asociación, no podrá crear nodos de desarrollo de datos.
-
Cree las fuentes de datos o clústeres necesarios para los tipos de tareas planificadas.
Fuente de datos o clúster
Descripción
DataWorks asocia automáticamente la primera fuente de datos de MaxCompute. Asocie manualmente las siguientes.
Asocie manualmente estas fuentes de datos después de crearlas.
DataWorks asocia automáticamente los clústeres registrados. No se requiere asociación manual.
-
Inicie sesión en la consola de DataWorks. En la región objetivo, haga clic en en el panel de navegación izquierdo. Seleccione un espacio de trabajo de la lista desplegable y haga clic en Go to Data Development.
-
En el panel de navegación izquierdo, haga clic en Computing Resources.
Si el módulo Computing Resource no aparece en el panel de navegación izquierdo, agréguelo desde Personal Settings . Module Management .
-
Asocie un recurso de cómputo.
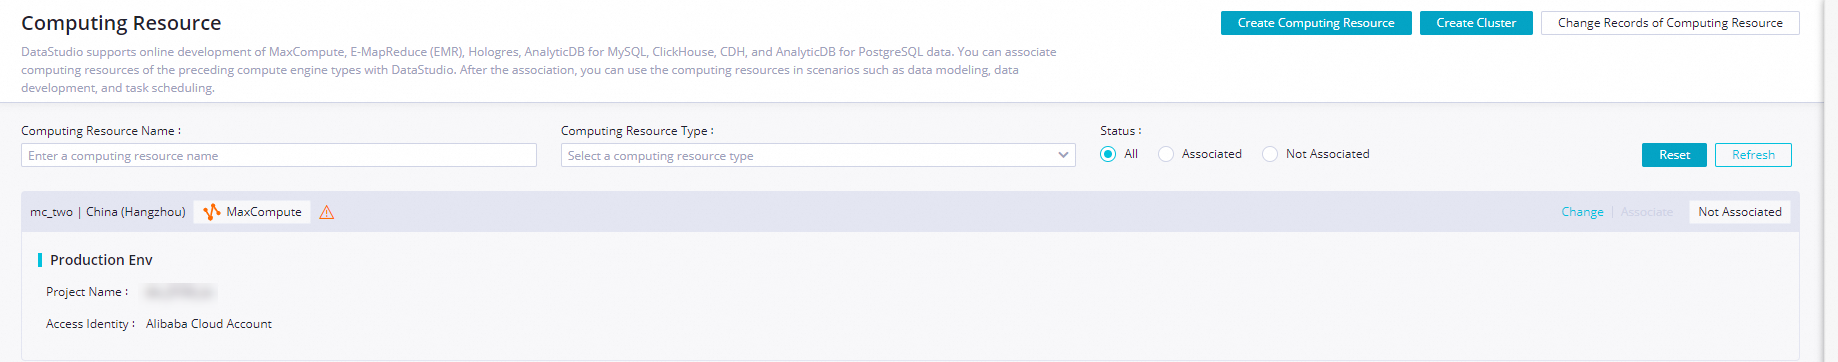
En la página Computing Resource, busque la fuente de datos o el clúster objetivo por Computing Resource Name o Computing Resource Type y haga clic en Associate. Después de la asociación, podrá usar la fuente de datos para el desarrollo.
NotaSi cambia la información de la fuente de datos, actualice la página para ver las modificaciones.
-
En algunos casos, es posible que una fuente de datos o clúster no pueda asociarse con DataStudio:
La asociación depende de la configuración. Por ejemplo, las fuentes de datos que usan un par de AccessKey no pueden asociarse. Revise la página de asociación para conocer las limitaciones.
A la fuente de datos le falta un entorno de desarrollo o producción.
Un recurso de cómputo de MaxCompute no puede asociarse con varios espacios de trabajo de DataWorks simultáneamente.
NotaLa plataforma muestra el motivo de cualquier error de asociación.
Solo MaxCompute, E-MapReduce, Hologres, AnalyticDB for MySQL, ClickHouse, CDH/CDP y AnalyticDB for PostgreSQL pueden asociarse con DataStudio.
Los tipos de fuentes de datos asociables y sus límites varían según la edición de DataWorks. Features of different editions of DataWorks.
-
Tutorial
Get started with data development cubre las operaciones básicas y el proceso de desarrollo.
Tipos de nodo compatibles
DataStudio proporciona diversos tipos de nodo, muchos de los cuales admiten programación periódica. Seleccione los nodos según sus necesidades empresariales. Supported node types.
Apéndice: Conceptos
-
Desarrollo de tareas
Término
Descripción
Solution
Conjunto de flujos de trabajo gestionados colectivamente. Los flujos de trabajo pueden reutilizarse en múltiples soluciones para facilitar la colaboración.
Workflow
Conjunto de tareas, tablas, recursos y funciones para un requisito empresarial. Las tareas se ejecutan según una programación.
Manually triggered workflow
Conjunto de tareas, tablas, recursos y funciones para un requisito empresarial específico.
A diferencia de los flujos de trabajo regulares, las tareas en un flujo activado manualmente deben iniciarse de forma manual en lugar de ejecutarse según una programación.
DAG
Abreviatura de
directed acyclic graph. Muestra los nodos y sus dependencias. En DataStudio, todas las tareas dentro de un flujo de trabajo comparten un DAG.Task
Unidad básica de ejecución en DataWorks. Las tareas se ejecutan secuencialmente según sus dependencias.
Node
Representa una tarea en un DAG. Los nodos se ejecutan secuencialmente según sus dependencias.
-
Programación de tareas
Término
Descripción
Dependency
Define el orden de ejecución entre tareas. Si la tarea B solo se ejecuta después de que finaliza la tarea A, entonces A es una dependencia ascendente de B. Se representa con flechas en un DAG.
Output name
Identificador globalmente único para un nodo. Un nodo puede tener varios nombres de salida. DataWorks utiliza estos nombres para definir dependencias de programación.
Output table name
Nombre de la tabla de salida de la tarea, que ayuda a las tareas descendentes a confirmar la fuente de datos correcta. No modifique los nombres de tablas de salida generados automáticamente. Este identificador no afecta el nombre real de la tabla, el cual está determinado por la lógica SQL.
NotaEl Output Name de un nodo debe ser globalmente único, mientras que el Output Table Name no tiene esta restricción.
Scheduling resource group
Grupo de recursos utilizado para la programación de tareas. Overview of DataWorks resource groups.
Scheduling parameter
Variables en el código que recuperan dinámicamente valores de tiempo de ejecución, como fecha y hora. Defina parámetros de programación en DataWorks para asignar valores a las variables del código durante la ejecución.
Business date
Fecha en que ocurrió una transacción empresarial. En cómputo sin conexión, suele ser el día anterior a la ejecución de la tarea. De forma predeterminada, DataWorks establece esta fecha como el día previo a la ejecución, con precisión diaria. Por ejemplo, al generar estadísticas de ventas de ayer, la fecha de negocio corresponde a ayer.
Scheduling time
Hora prevista en que se programa la ejecución de una tarea, con precisión al segundo. La hora de inicio real puede variar debido a diversos factores.