DataWorks proporciona el nodo for-each, que permite recorrer en bucle el conjunto de resultados de un nodo de asignación y orquestar un flujo de negocio. Este tema describe los componentes y la lógica del nodo for-each.
Notas de uso
A continuación se describe cómo utilizar el nodo for-each.
|
Descripción |
Referencias |
|
Conozca los escenarios en los que puede utilizar el nodo for-each. |
Nota
Esto solo se utiliza para recorrer el conjunto de resultados devuelto por el nodo de asignación. |
|
Consulte los límites y las notas sobre el nodo for-each, como el número máximo de recorridos, cómo probar el nodo y cómo consultar los registros. |
|
|
Aprenda a personalizar el flujo de negocio dentro de un nodo for-each. El flujo debe comenzar con el nodo Start integrado y terminar con el nodo End integrado. |
|
|
Tenga en cuenta que el número de recorridos de un nodo for-each lo determina la salida de su nodo de asignación precedente. |
|
|
Sepa que el nodo for-each proporciona variables integradas para recuperar valores relevantes en cada recorrido. |
|
|
Consulte ejemplos sobre cómo recuperar valores de variables y cómo se calcula el número de recorridos. |
Examples of retrieving values when the upstream assignment node is a Shell or ODPS SQL node |
Escenarios
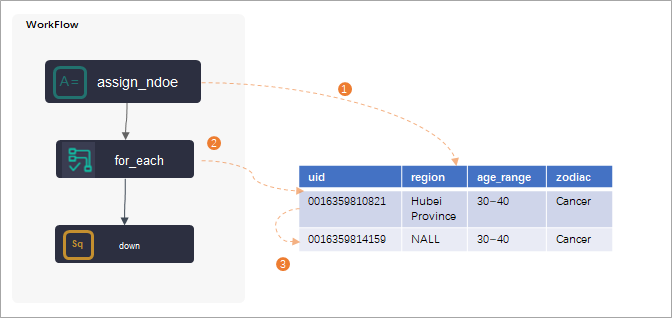
El nodo for-each de DataWorks se utiliza principalmente en escenarios que requieren bucles. Debe usarse junto con un assignment node precedente. El nodo for-each recibe la salida del nodo de asignación y luego recorre los resultados en bucle.
Límites
El nodo for-each solo es compatible con DataWorks Standard Edition y versiones posteriores. Para obtener más información, consulte Feature Details by Version.
Un nodo for-each puede ejecutar un bucle un máximo de 1,024 veces. El número real de recorridos lo determina el conjunto de resultados que genera el nodo de asignación.
No se admite la ejecución simultánea. Un nuevo bucle solo puede iniciarse después de que haya finalizado el anterior.
Notas
|
Dimensión |
Categoría |
Descripción |
|
Dependencias precedentes y subsiguientes |
Configuración de dependencias |
El nodo for-each recorre los valores transmitidos desde un assignment node. Por lo tanto, el nodo de asignación debe ser un nodo precedente del nodo for-each. |
|
Compatibilidad con recorridos |
Número máximo de recorridos |
Un nodo for-each admite un máximo de 1,024 bucles. Si se supera este límite, se produce un error de ejecución. El número real de bucles lo controla la salida del nodo de asignación precedente. |
|
Número de recorridos |
Lo determina el conjunto de resultados que genera el nodo de asignación. |
|
|
Nodos internos |
Orquestación de flujos |
|
|
Recuperación de valores |
Se proporcionan variables integradas para recuperar valores específicos del nodo de asignación precedente. |
|
|
Depuración y ejecución |
Depuración de tareas |
|
|
Consulta de registros |
Cuando consulte el registro de ejecución de un nodo for-each en el Operation Center, haga clic con el botón derecho en la instancia y seleccione View Inner Nodes para ver los registros de ejecución de los nodos internos. |
Componentes del nodo y orquestación del flujo
El nodo for-each en DataWorks es un tipo especial de nodo que contiene nodos internos. Al crear un nodo for-each, se generan automáticamente tres nodos internos: un Start node (inicio del bucle), un Shell node (tarea del bucle) y un End node (fin del bucle). Estos nodos internos forman un flujo interno que recorre en bucle la salida del nodo de asignación precedente.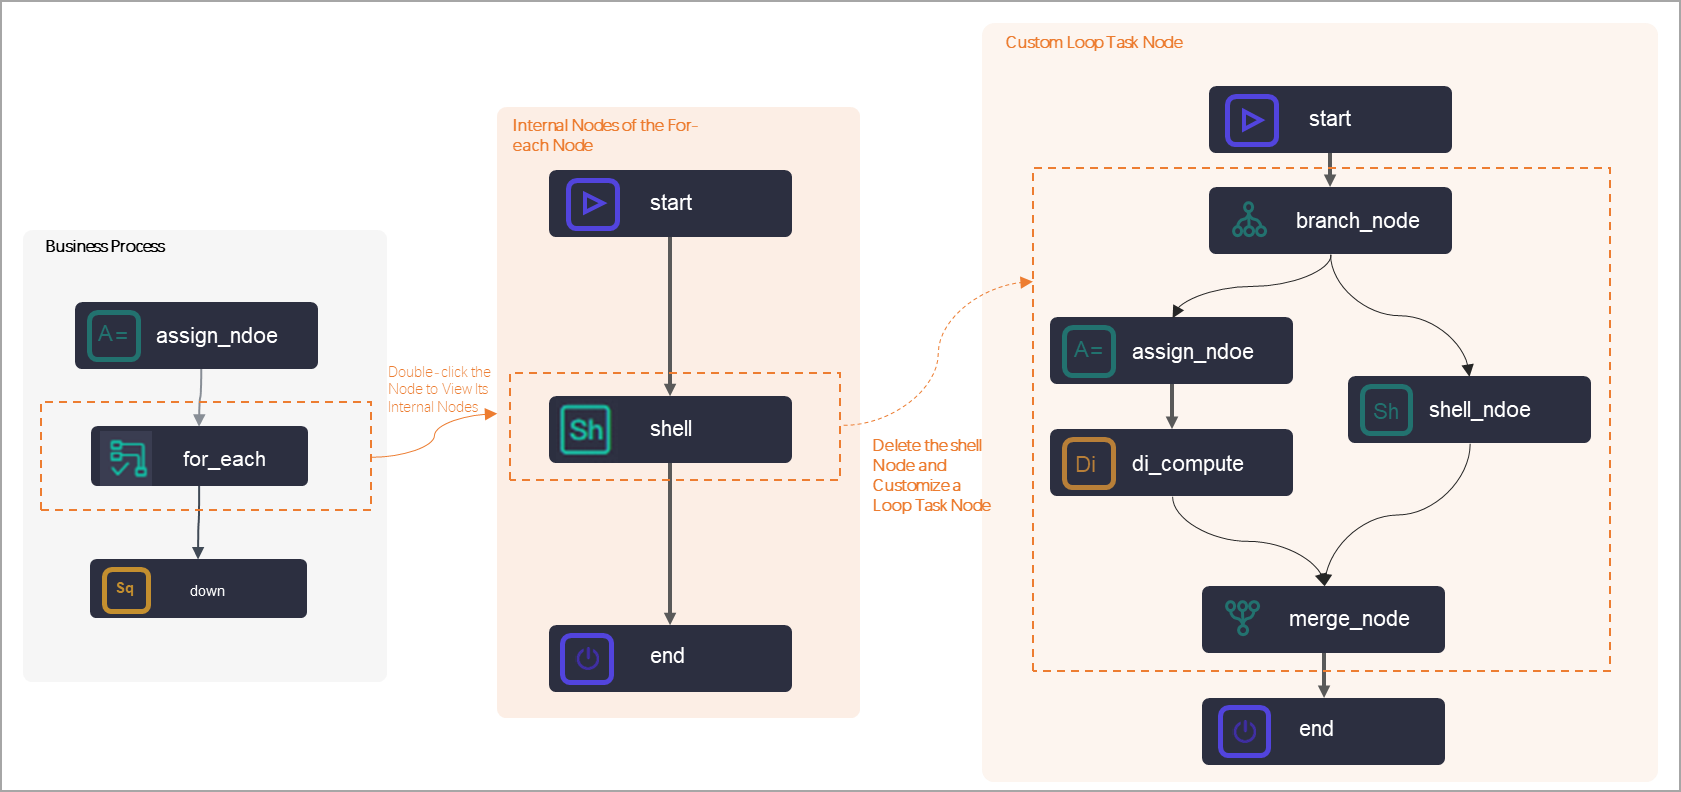 Como se muestra en la figura anterior:
-
Shell node
De forma predeterminada, DataWorks crea un nodo interno Shell para ejecutar tareas. También puede eliminar el Shell node predeterminado y personalizar el nodo para la tarea de recorrido en bucle.
Si la tarea de recorrido en bucle es una tarea Shell, puede hacer doble clic en el Shell node para abrir el editor de código y desarrollar el código de la tarea.
-
Si la tarea de recorrido en bucle es compleja, puede crear otros nodos de tarea en el flujo interno y reconstruir el proceso de ejecución del nodo según sea necesario.
NotaAl personalizar un nodo de tarea de bucle, puede eliminar las dependencias entre los nodos internos y reorquestar el flujo interno. Sin embargo, el Start node y el End node deben ser el primer y el último nodo del flujo interno.
-
Start node y End node
Estos son los nodos de inicio y fin para cada bucle en el flujo interno. No contienen ningún código de tarea específico.
NotaEl End node de un nodo for-each no controla el número de bucles. El número de bucles lo determina la salida del nodo de asignación precedente.
Número de recorridos
Un nodo for-each puede ejecutar un bucle un máximo de 1,024 veces. El número real de recorridos lo determina el conjunto de resultados que genera el nodo de asignación.
El número de recorridos lo determina el conjunto de resultados que genera el nodo de asignación:
-
Recorridos Shell y Python: La salida es una matriz unidimensional. El número de bucles corresponde a la cantidad de elementos en la matriz. Los elementos están separados por comas.
Por ejemplo, si el lenguaje de asignación del nodo de asignación es Shell o Python (Python 2) y la salida es la matriz unidimensional
2021-03-28,2021-03-29,2021-03-30,2021-03-31,2021-04-01, el nodo for-each realiza cinco bucles. -
Recorridos SQL: La salida es una matriz bidimensional. El número de bucles corresponde al número de filas en la matriz.
Por ejemplo, si el lenguaje de asignación del nodo de asignación es ODPS SQL y la salida es una matriz bidimensional:
+----------------------------------------------+
| uid            | region         | age_range       | zodiac |
+----------------------------------------------+
| 0016359810821  | Hubei Province | 30-40 years old | Cancer |
| 0016359814159  | Unknown        | 30-40 years old | Cancer |
+----------------------------------------------+
El nodo for-each realiza dos bucles.
Variables integradas
Puede utilizar los siguientes métodos en los nodos internos de un nodo for-each para recuperar el conjunto de resultados del nodo de asignación precedente. Si existe un nodo de asignación en el flujo interno del nodo for-each, puede recuperar valores mediante el método de recuperación de valores predeterminado para nodos subsiguientes. Para obtener más información sobre el método de recuperación de valores, consulte Assignment node.
Cuando un nodo for-each de DataWorks recorre en bucle la salida de un nodo de asignación, puede usar variables integradas para recuperar el número de bucle actual y el desplazamiento.
|
Variable integrada |
Descripción |
Comparación con un bucle for |
|
|
Obtiene el conjunto de datos del nodo de asignación. |
Equivalente al siguiente código en un bucle for: |
|
|
Obtiene el valor de recorrido actual. |
Tome como ejemplo el siguiente bucle for:
|
|
|
El desplazamiento actual (el desplazamiento de cada recorrido con respecto al primero). |
|
|
|
Obtiene el número actual de recorridos. |
- |
Si conoce el esquema de tabla de su salida, puede utilizar las siguientes variables para recuperar otros valores.
|
Otra variable |
Descripción |
|
|
Cuando la salida del nodo de asignación precedente es una matriz bidimensional, esta variable obtiene los datos de una columna específica en la fila de datos actual durante cada recorrido. |
|
|
Cuando la salida del nodo de asignación precedente es una matriz bidimensional, esta variable obtiene los datos en la fila i y la columna j del conjunto de datos. |
|
|
Cuando la salida del nodo de asignación precedente es una matriz unidimensional, esta variable obtiene los datos en un índice específico. |
Ejemplos de uso de variables integradas
Ejemplo 1: El nodo de asignación precedente es un nodo Shell
-
Salida del nodo de asignación
El nodo de asignación precedente es un nodo Shell. La salida final es
2021-03-28,2021-03-29,2021-03-30,2021-03-31,2021-04-01. -
Recuperación de valores en el nodo for-each
NotaDado que la salida es una matriz unidimensional con cinco elementos separados por comas, el nodo for-each realiza cinco bucles.
Variable integrada
Valor en el 1.er bucle
Valor en el 2.º bucle
${dag.loopDataArray}2021-03-28,2021-03-29,2021-03-30,2021-03-31,2021-04-01${dag.foreach.current}2021-03-282021-03-29${dag.offset}0
1
${dag.loopTimes}1
2
${dag.foreach.current[3]}2021-03-30
Ejemplo 2: El nodo de asignación precedente es un nodo ODPS SQL
-
Salida del nodo de asignación
El nodo de asignación precedente es un nodo ODPS SQL. La última sentencia select devuelve dos registros:
+----------------------------------------------+ | uid | region | age_range | zodiac | +----------------------------------------------+ | 0016359810821 | Hubei Province | 30-40 years old | Cancer | | 0016359814159 | Unknown | 30-40 years old | Cancer | +----------------------------------------------+ -
Recuperación de valores en el nodo for-each
NotaDado que la salida es una matriz bidimensional con dos filas, el nodo for-each realiza dos recorridos.
Variable integrada
Valor en el 1.er bucle
Valor en el 2.º bucle
${dag.loopDataArray}+----------------------------------------------+ | uid | region | age_range | zodiac | +----------------------------------------------+ | 0016359810821 | Hubei Province | 30-40 years old | Cancer | | 0016359814159 | Unknown | 30-40 years old | Cancer | +----------------------------------------------+${dag.foreach.current}0016359810821,Hubei Province,30-40 years old,Cancer0016359814159,Unknown,30-40 years old,Cancer${dag.offset}0
1
${dag.loopTimes}1
2
${dag.foreach.current[0]}00163598108210016359814159${dag.loopDataArray[1][0]}0016359814159