Después de instalar un agente de ARMS para Python en una aplicación de modelo de lenguaje grande (LLM), Application Real-Time Monitoring Service (ARMS) recopila automáticamente datos de rendimiento de las operaciones en su pipeline de LLM. La pestaña LLM operation proporciona métricas de volumen de invocaciones, latencia y errores para cuatro categorías de operaciones.
Utilice estas métricas para identificar cuellos de botella de latencia, rastrear tasas de error y localizar los modelos o funciones específicos que degradan el rendimiento.
|
Categoría de operación |
Qué monitorea |
Caso de uso típico |
|
Embedding |
Llamadas de conversión de texto a vector |
Detectar modelos de embedding lentos o con errores en pipelines de búsqueda por similitud y clasificación |
|
Search enhancement |
Etapas de recuperación y reranking en pipelines RAG |
Identificar qué etapa de RAG (recuperación o reranking) introduce latencia o errores |
|
Tool call |
Llamadas a herramientas externas y API realizadas por el LLM (motores de búsqueda, bases de datos, calculadoras) |
Encontrar dependencias externas poco fiables que causan tiempos de espera agotados o fallos |
|
Method calls |
Métodos personalizados internos y operaciones de tareas dentro de su aplicación |
Localizar cuellos de botella en la lógica de negocio personalizada y el procesamiento interno |
Cada categoría ofrece tres niveles de métricas:
|
Nivel |
Qué muestra |
Cuándo utilizarlo |
|
Métricas agregadas |
Totales y promedios para el rango de tiempo seleccionado |
Obtener una visión general del estado de la categoría de operación |
|
Tendencias por minuto |
Series temporales minuto a minuto |
Correlacionar cambios de rendimiento con despliegues o picos de tráfico |
|
Clasificaciones (Top 5) |
Las 5 funciones, modelos o herramientas principales por volumen, latencia o errores |
Identificar qué componente específico requiere optimización |
Requisitos previos
Antes de empezar, asegúrese de contar con lo siguiente:
Un agente de ARMS instalado para la aplicación de LLM. Para más detalles, consulte Monitor LLM applications in ARMS
Acceder a la pestaña LLM operation
Inicie sesión en la consola de ARMS. En el panel de navegación izquierdo, seleccione LLM Application Monitoring > Application List.
En la página que aparece, seleccione una región en la barra de navegación superior y haga clic en la aplicación que desea gestionar.
-
En la barra de navegación superior, seleccione una pestaña en la lista desplegable de LLM operation.
Embedding
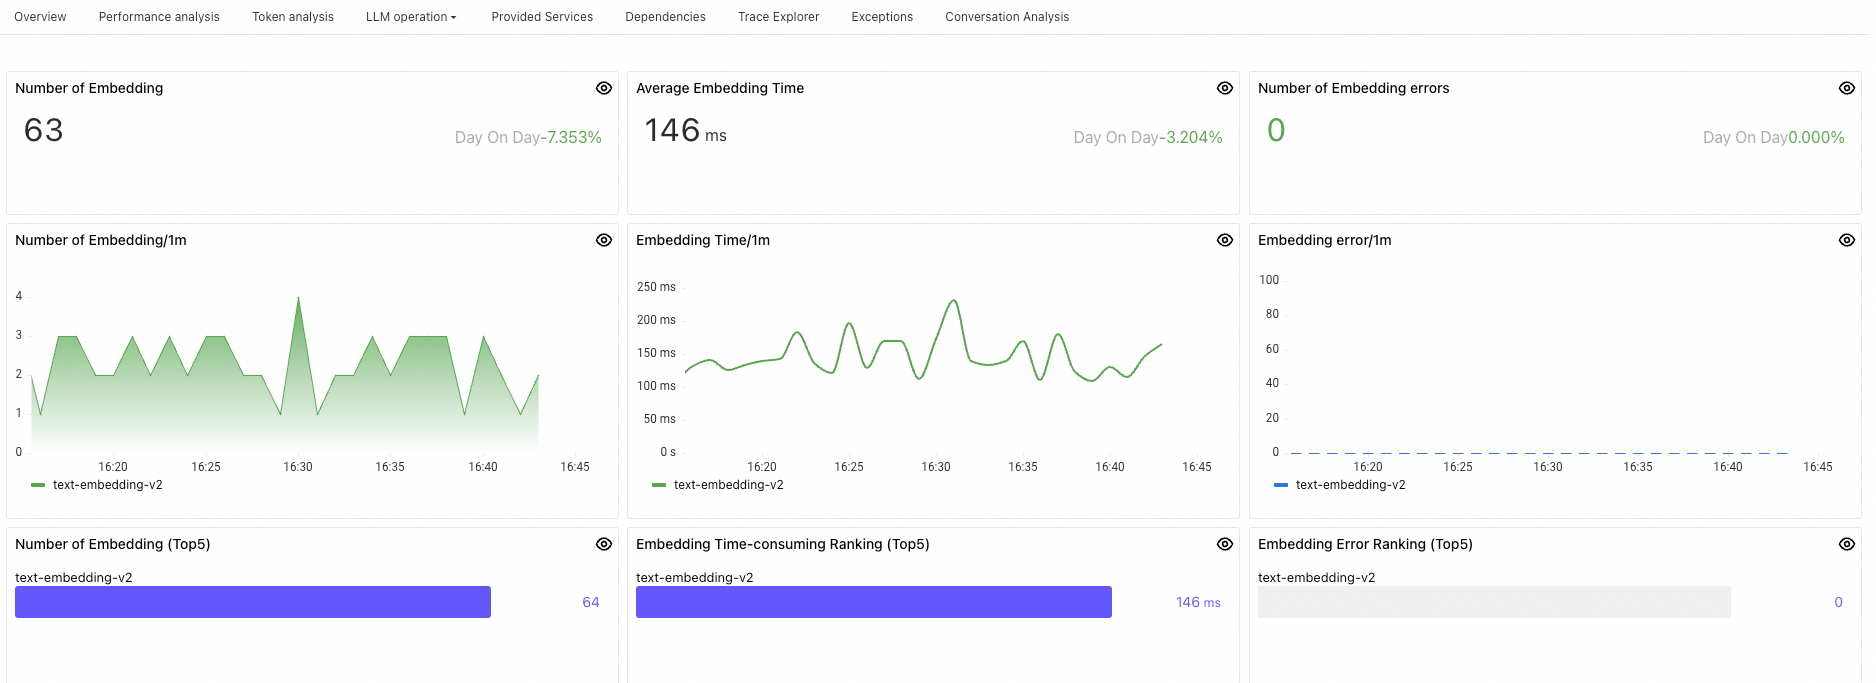
El embedding convierte texto, imágenes u otros tipos de datos en vectores de baja dimensión que capturan el significado semántico. Estos vectores impulsan tareas de cálculo de similitud, recuperación y clasificación en su aplicación de LLM.
Panel
Descripción
Number of Embedding
Total de invocaciones de embedding dentro del rango de tiempo seleccionado.
Average Embedding Time
Latencia promedio en todas las invocaciones de embedding dentro del rango de tiempo seleccionado.
Number of Embedding errors
Total de invocaciones de embedding con errores dentro del rango de tiempo seleccionado.
Number of Embedding/1m
Invocaciones de embedding por minuto.
Embedding Time/1m
Latencia promedio de embedding por minuto.
Embedding error/1m
Invocaciones de embedding con errores por minuto.
Number of Embedding (Top5)
Las 5 funciones o modelos de embedding principales por cantidad de invocaciones, ordenados de mayor a menor.
Embedding Time-consuming Ranking (Top5)
Las 5 funciones o modelos de embedding principales por latencia promedio, ordenados de mayor a menor.
Embedding Error Ranking (Top5)
Las 5 funciones o modelos de embedding principales por cantidad de errores, ordenados de mayor a menor.
Search enhancement
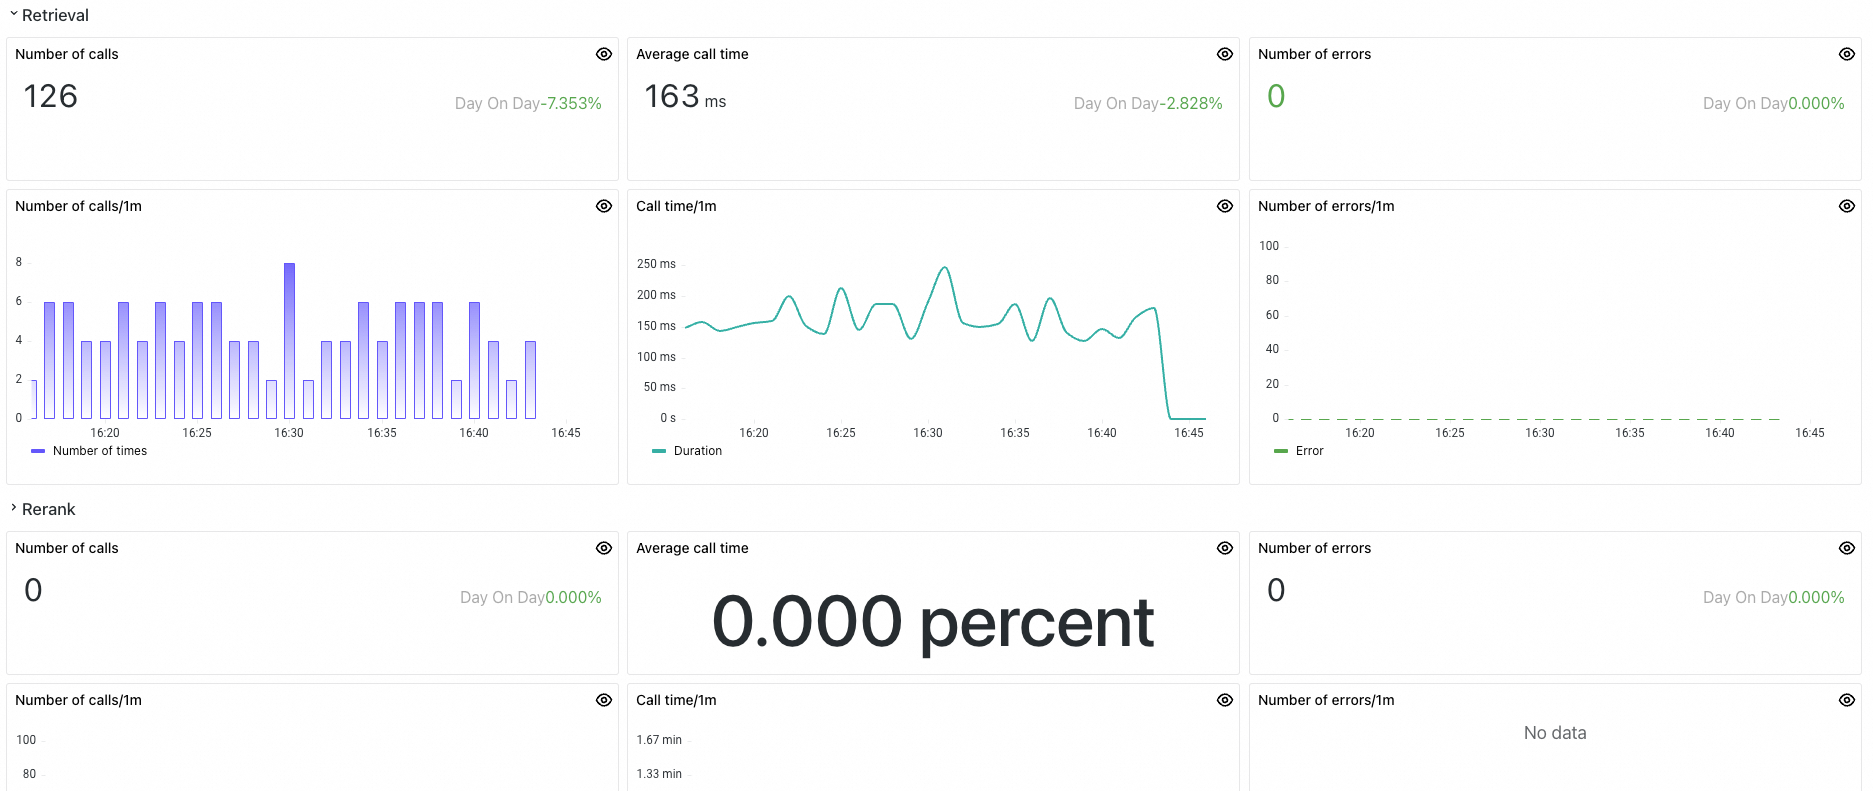
La generación aumentada por recuperación (RAG) combina la recuperación y el reranking para mejorar la relevancia y precisión del contenido generado por el LLM. El panel de search enhancement monitorea ambas etapas por separado, lo que permite identificar si la recuperación o el reranking es el cuello de botella.
Panel
Descripción
Métricas de recuperación
Number of calls
Total de invocaciones de recuperación dentro del rango de tiempo seleccionado.
Average call time
Latencia promedio en todas las operaciones de recuperación dentro del rango de tiempo seleccionado.
Number of errors
Total de invocaciones de recuperación con errores dentro del rango de tiempo seleccionado.
Number of calls/1m
Invocaciones de recuperación por minuto.
Call time/1m
Latencia promedio de recuperación por minuto.
Number of errors/1m
Invocaciones de recuperación con errores por minuto.
Métricas de rerank
Number of calls
Total de invocaciones de rerank dentro del rango de tiempo seleccionado.
Average call time
Latencia promedio en todas las operaciones de rerank dentro del rango de tiempo seleccionado.
Number of errors
Total de invocaciones de rerank con errores dentro del rango de tiempo seleccionado.
Number of calls/1m
Invocaciones de rerank por minuto.
Call time/1m
Latencia promedio de rerank por minuto.
Number of errors/1m
Invocaciones de rerank con errores por minuto.
Tool call
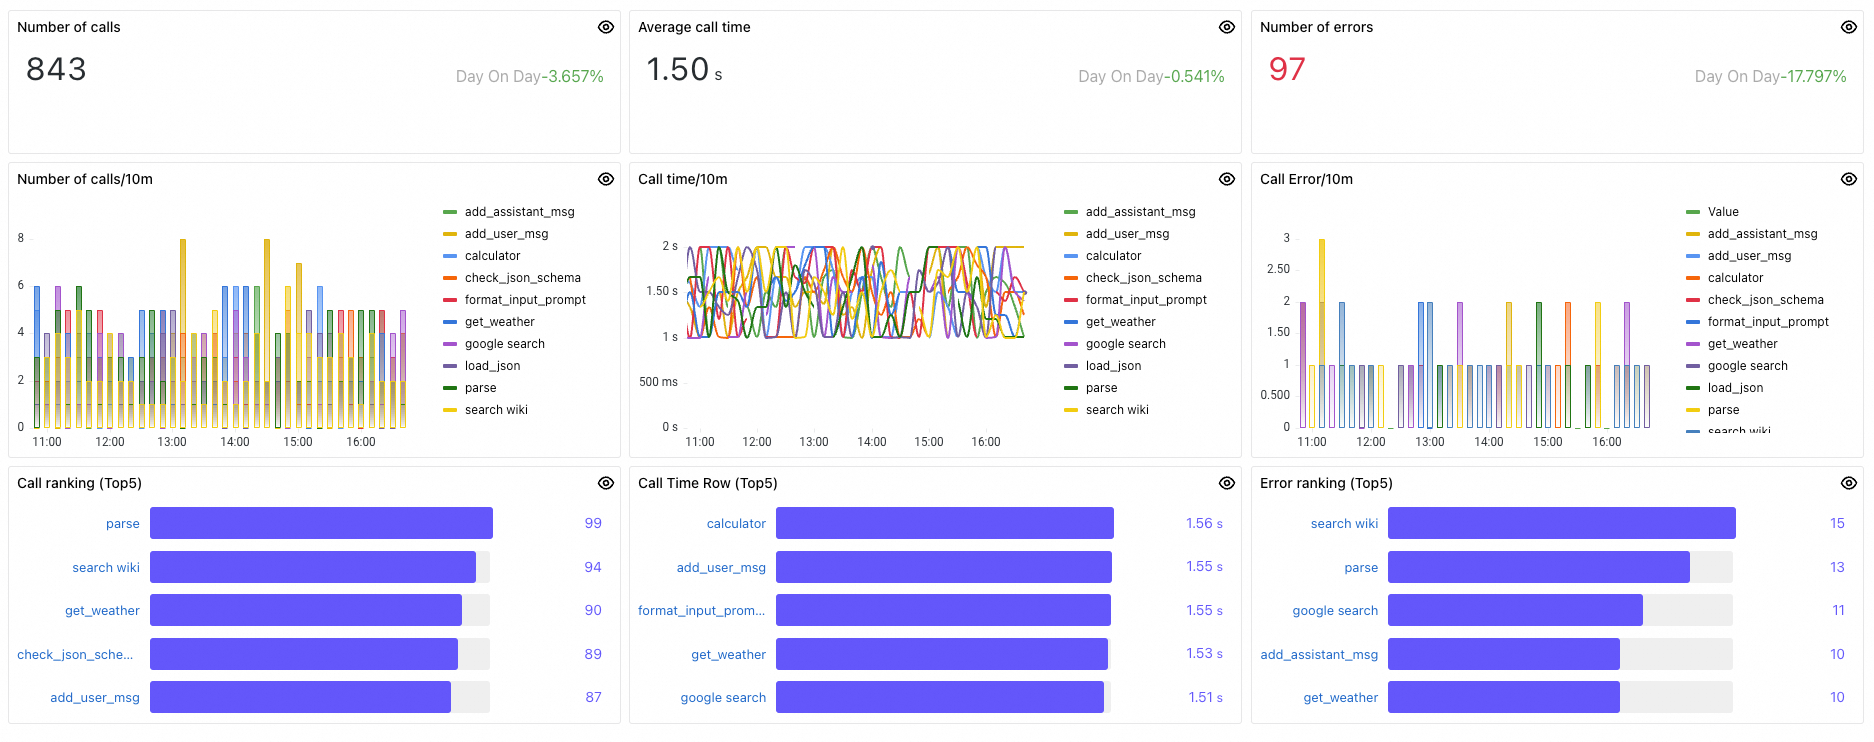
La invocación de herramientas es el proceso mediante el cual un LLM llama a herramientas externas o API para ejecutar tareas como cálculos, consultas a bases de datos, búsquedas web o traducciones. Estas herramientas pueden incluir calculadoras, interfaces de consulta de bases de datos, motores de búsqueda y servicios de traducción, y sirven para ampliar las capacidades del LLM de modo que pueda manejar tareas más complejas o específicas.
Panel
Descripción
Number of calls
Total de invocaciones de herramientas dentro del rango de tiempo seleccionado.
Average call time
Latencia promedio en todas las invocaciones de herramientas dentro del rango de tiempo seleccionado.
Number of errors
Total de invocaciones de herramientas con errores dentro del rango de tiempo seleccionado.
Number of calls/10m
Invocaciones de herramientas por minuto.
Call time/10m
Latencia promedio de invocación de herramientas por minuto.
Call Error/10m
Invocaciones de herramientas con errores por minuto.
Call ranking (Top5)
Las 5 herramientas principales por cantidad de invocaciones, ordenadas de mayor a menor.
Call Time Row (Top5)
Las 5 herramientas principales por latencia promedio, ordenadas de mayor a menor.
Error ranking (Top5)
Las 5 herramientas principales por cantidad de errores, ordenadas de mayor a menor.
Method calls
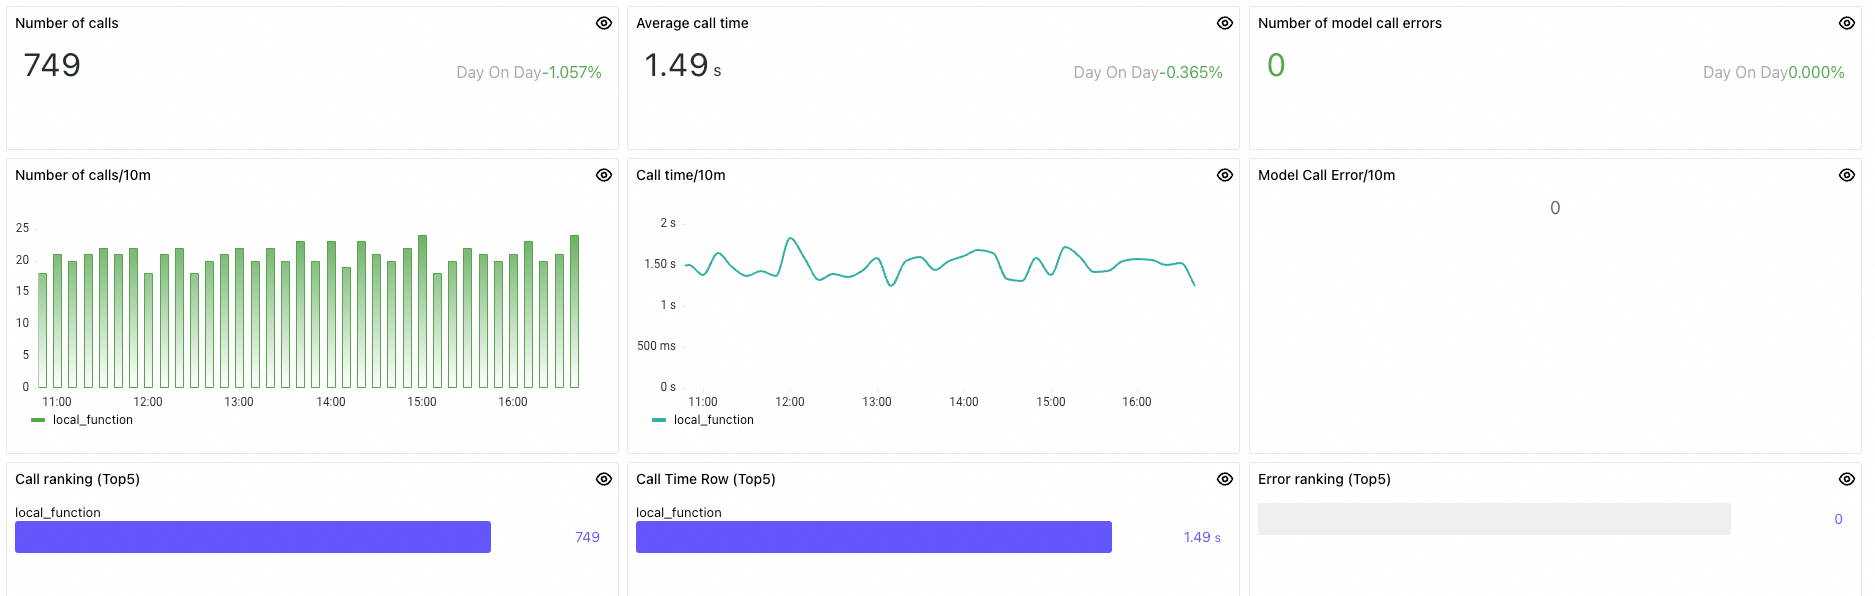
Las llamadas de método rastrean métodos personalizados internos: invocaciones de métodos locales y operaciones de tareas importantes que se ejecutan dentro de su aplicación. Estas métricas ayudan a identificar cuellos de botella en la lógica personalizada y a evaluar la eficiencia del procesamiento interno.
Panel
Descripción
Number of calls
Total de invocaciones de tareas dentro del rango de tiempo seleccionado.
Average call time
Latencia promedio en todas las invocaciones de tareas dentro del rango de tiempo seleccionado.
Number of model call errors
Total de invocaciones de tareas con errores dentro del rango de tiempo seleccionado.
Number of calls/10m
Invocaciones de tareas por minuto.
Call time/10m
Latencia promedio de invocación de tareas por minuto.
Model Call Error/10m
Invocaciones de tareas con errores por minuto.
Call ranking
Las 5 tareas principales por cantidad de invocaciones, ordenadas de mayor a menor.
Call Time Row (Top5)
Las 5 tareas principales por latencia promedio, ordenadas de mayor a menor.
Error ranking (Top5)
Las 5 tareas principales por cantidad de errores, ordenadas de mayor a menor.