Después de instalar el agente de Python para su aplicación de Large Language Model (LLM), Application Real-Time Monitoring Service (ARMS) comienza a monitorearla. En la página Descripción general, puede consultar las métricas clave de su aplicación LLM, como el número de llamadas al modelo, el uso de tokens, la cantidad de trazas y la cantidad de sesiones.
Requisitos previos
El agente debe estar instalado en su aplicación LLM. Para obtener más información, consulte Connect an LLM application or inference service to ARMS.
Descripción general de la aplicación LLM
Inicie sesión en la consola de ARMS. En el panel de navegación izquierdo, seleccione .
En la página Application list, seleccione una región en la parte superior de la página y luego haga clic en el nombre de la aplicación de destino.
En la barra de navegación superior, haga clic en Descripción general.
Panel
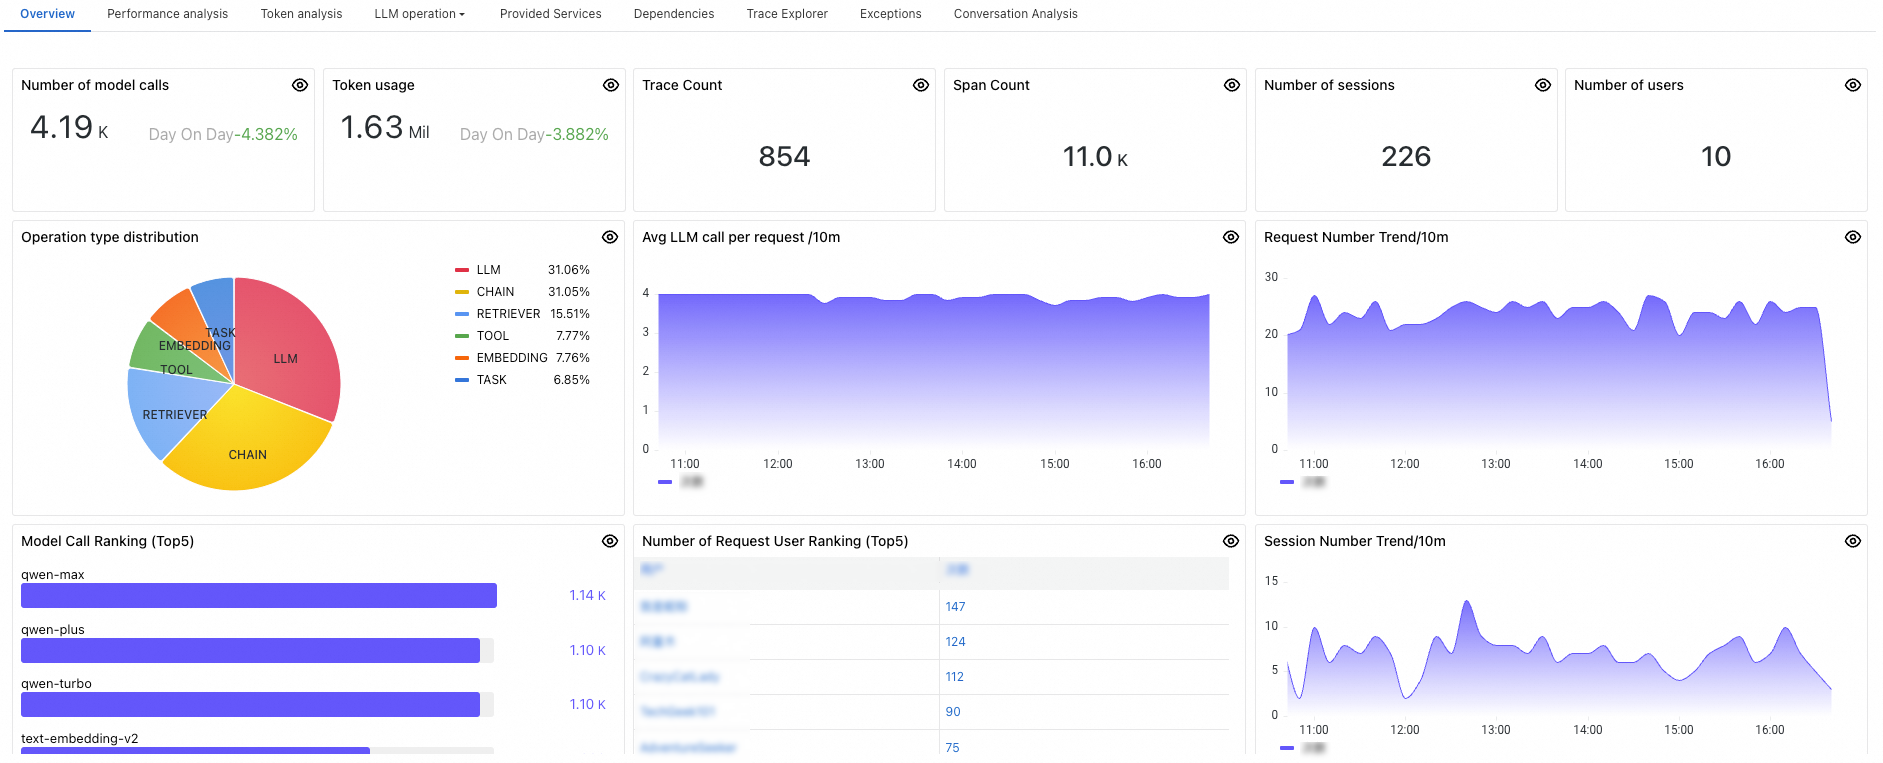
Panel | Descripción |
Number of model calls | Número de veces que la aplicación llama al LLM dentro del intervalo de tiempo seleccionado. |
Token usage | Cantidad de tokens que consume la aplicación dentro del intervalo de tiempo seleccionado. |
Trace count | Cantidad de trazas que genera la aplicación dentro del intervalo de tiempo seleccionado. |
Span count | Cantidad de spans que genera la aplicación dentro del intervalo de tiempo seleccionado. |
Session count | Cantidad de sesiones que inicia la aplicación dentro del intervalo de tiempo seleccionado. |
Number of users | Total de usuarios únicos que interactúan con la aplicación dentro del intervalo de tiempo seleccionado. |
Operation type distribution |
|
Avg LLM call per request | Promedio de llamadas al LLM por solicitud, calculado en intervalos de un minuto. |
Request count trend | Registra la cantidad de solicitudes a la aplicación LLM por minuto. |
Model call ranking | Enumera los cinco LLM llamados con mayor frecuencia en la aplicación. |
User ranking by request count | Enumera los cinco usuarios que generaron más solicitudes en la aplicación. |
Session count trend | Registra la cantidad de sesiones de la aplicación LLM por minuto. |