Despliegue un servicio de inference de modelo destilado DeepSeek listo para producción en ACK con KServe.
Contexto
Modelo DeepSeek-R1
KServe
Arena
Requisitos previos
Se creó un clúster de Kubernetes con GPU node pools.
El clúster está connected via kubectl.
Se instaló ack-kserve add-on.
Se configuró Arena client.
Especificaciones de GPU y costos
Los parámetros del modelo consumen la mayor parte de la memoria de la GPU durante la inference. Calcule la memoria de GPU necesaria:
Para un modelo de 7B con precisión predeterminada FP16: 7 mil millones de parámetros a 2 bytes cada uno (punto flotante de 16 bits / 8 bits por byte).
Además de la carga del modelo, considere la caché KV y la utilización de la GPU. Con un búfer típico, utilice una instancia acelerada por GPU con 24 GiB de memoria de GPU, como ecs.gn7i-c8g1.2xlarge o ecs.gn7i-c16g1.4xlarge. Consulte GPU-accelerated compute-optimized instance family y GPU-accelerated cloud server billing.
Despliegue del modelo
Paso 1: Preparar los archivos del modelo DeepSeek-R1-Distill-Qwen-7B
-
Descargue el modelo DeepSeek-R1-Distill-Qwen-7B desde ModelScope.
NotaDebe instalar Git Large File Storage (LFS). Ejecute
yum install git-lfsoapt-get install git-lfs. Consulte Instalar Git Large File Storage.git lfs install GIT_LFS_SKIP_SMUDGE=1 git clone https://www.modelscope.cn/deepseek-ai/DeepSeek-R1-Distill-Qwen-7B.git cd DeepSeek-R1-Distill-Qwen-7B/ git lfs pull -
Cree un directorio en OSS y cargue los archivos del modelo.
NotaConsulte Install ossutil.
ossutil mkdir oss://<your-bucket-name>/models/DeepSeek-R1-Distill-Qwen-7B ossutil cp -r ./DeepSeek-R1-Distill-Qwen-7B oss://<your-bucket-name>/models/DeepSeek-R1-Distill-Qwen-7B -
Cree un volumen persistente (PV) y una solicitud de volumen persistente (PVC) con nombre
llm-modelpara el clúster objetivo. Consulte Use statically provisioned ossfs 1.0 volumes.Console
Configuraciones de PV de ejemplo:
Parámetro
Descripción
Tipo de PV
OSS
Nombre
llm-model
Certificado de acceso
AccessKey ID y AccessKey secret para acceder a OSS.
ID de bucket
El bucket de OSS del paso anterior.
Ruta de OSS
La ruta de almacenamiento del modelo, por ejemplo,
/models/DeepSeek-R1-Distill-Qwen-7B.Configuraciones de PVC de ejemplo:
Parámetro
Descripción
Tipo de PVC
OSS
Nombre
llm-model
Modo de asignación
Seleccione un PV existente
Volúmenes existentes
Seleccione el PV creado anteriormente.
kubectl
Archivo YAML de ejemplo:
apiVersion: v1
kind: Secret
metadata:
  name: oss-secret
stringData:
  akId: <your-oss-ak> # Your AccessKey ID for accessing OSS.
  akSecret: <your-oss-sk> # Your AccessKey secret for accessing OSS.
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: llm-model
  labels:
    alicloud-pvname: llm-model
spec:
  capacity:
    storage: 30Gi
  accessModes:
    - ReadOnlyMany
  persistentVolumeReclaimPolicy: Retain
  csi:
    driver: ossplugin.csi.alibabacloud.com
    volumeHandle: llm-model
    nodePublishSecretRef:
      name: oss-secret
      namespace: default
    volumeAttributes:
      bucket: <your-bucket-name> # The name of your bucket.
      url: <your-bucket-endpoint> # The endpoint, such as oss-cn-hangzhou-internal.aliyuncs.com.
      otherOpts: "-o umask=022 -o max_stat_cache_size=0 -o allow_other"
      path: <your-model-path> # In this example, the path is /models/DeepSeek-R1-Distill-Qwen-7B/.
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: llm-model
spec:
  accessModes:
    - ReadOnlyMany
  resources:
    requests:
      storage: 30Gi
  selector:
    matchLabels:
      alicloud-pvname: llm-model
Paso 2: Desplegar el servicio de inference
-
Inicie el servicio de inference llamado deepseek.
arena serve kserve \
    --name=deepseek \
    --image=kube-ai-registry.cn-shanghai.cr.aliyuncs.com/kube-ai/vllm:v0.6.6 \
    --gpus=1 \
    --cpu=4 \
    --memory=12Gi \
    --data=llm-model:/models/DeepSeek-R1-Distill-Qwen-7B \
    "vllm serve /models/DeepSeek-R1-Distill-Qwen-7B --port 8080 --trust-remote-code --served-model-name deepseek-r1 --max-model-len 32768 --gpu-memory-utilization 0.95 --enforce-eager"
Parámetros:
Parámetro
Obligatorio
Descripción
--name
Sí
Nombre del servicio de inference. Debe ser único a nivel global.
--image
Sí
Imagen del servicio de inference.
--gpus
No
Número de GPU. Valor predeterminado: 0.
--cpu
No
Número de CPU.
--memory
No
Tamaño de la memoria.
--data
No
Ruta del artefacto del modelo. En este ejemplo, el PV
llm-modeldel paso anterior, montado en /models/ dentro del contenedor.Salida esperada:
inferenceservice.serving.kserve.io/deepseek created
INFO[0003] The Job deepseek has been submitted successfully
INFO[0003] You can run `arena serve get deepseek --type kserve -n default` to check the job status
Paso 3: Comprobar el servicio de inference
-
Compruebe el estado de despliegue del servicio de inference de KServe.
arena serve get deepseekSalida esperada:
Name:       deepseek
Namespace:  default
Type:       KServe
Version:    1
Desired:    1
Available:  1
Age:        3m
Address:    http://deepseek-default.example.com
Port:       :80
GPU:        1
Instances:
  NAME                                 STATUS   AGE  READY  RESTARTS  GPU  NODE
  ----                                 ------   ---  -----  --------  ---  ----
  deepseek-predictor-7cd4d568fd-fznfg  Running  3m   1/1    0         1    cn-beijing.172.16.1.77
La salida confirma que el servicio de inference está desplegado.
-
Envíe una solicitud al servicio de inference a través de la IP de la puerta de enlace NGINX Ingress.
# Get the IP address of the NGINX Ingress.
NGINX_INGRESS_IP=$(kubectl -n kube-system get svc nginx-ingress-lb -ojsonpath='{.status.loadBalancer.ingress[0].ip}')
# Get the hostname of the inference service.
SERVICE_HOSTNAME=$(kubectl get inferenceservice deepseek -o jsonpath='{.status.url}' | cut -d "/" -f 3)
# Send a request to the inference service.
curl -H "Host: $SERVICE_HOSTNAME" -H "Content-Type: application/json" http://$NGINX_INGRESS_IP:80/v1/chat/completions -d '{"model": "deepseek-r1", "messages": [{"role": "user", "content": "Say this is a test!"}], "max_tokens": 512, "temperature": 0.7, "top_p": 0.9, "seed": 10}'
Salida esperada:
{"id":"chatcmpl-0fe3044126252c994d470e84807d4a0a","object":"chat.completion","created":1738828016,"model":"deepseek-r1","choices":[{"index":0,"message":{"role":"assistant","content":"<think>\n\n</think>\n\nIt seems like you're testing or sharing some information. How can I assist you further? If you have any questions or need help with something, feel free to ask!","tool_calls":[]},"logprobs":null,"finish_reason":"stop","stop_reason":null}],"usage":{"prompt_tokens":9,"total_tokens":48,"completion_tokens":39,"prompt_tokens_details":null},"prompt_logprobs":null}
Observability
En producción, la observability de los servicios de inference de LLM es esencial para detectar y localizar fallas a tiempo. vLLM proporciona métricas de inference. Consulte la documentación de Metrics. KServe también ofrece métricas de salud del servicio. Ambas están integradas en Arena; agregue --enable-prometheus=true al enviar la aplicación.
arena serve kserve \
    --name=deepseek \
    --image=kube-ai-registry.cn-shanghai.cr.aliyuncs.com/kube-ai/vllm:v0.6.6 \
    --gpus=1 \
    --cpu=4 \
    --memory=12Gi \
    --enable-prometheus=true \
    --data=llm-model:/models/DeepSeek-R1-Distill-Qwen-7B \
    "vllm serve /models/DeepSeek-R1-Distill-Qwen-7B --port 8080 --trust-remote-code --served-model-name deepseek-r1 --max-model-len 32768 --gpu-memory-utilization 0.95 --enforce-eager"
Monitoree el servicio de inference desplegado con vLLM mediante un panel de Grafana. Obtenga el JSON oficial del panel de vLLM desde el sitio web oficial de vLLM e impórtelo a Grafana. Para obtener más información, consulte Export and import dashboards. Después de la configuración:
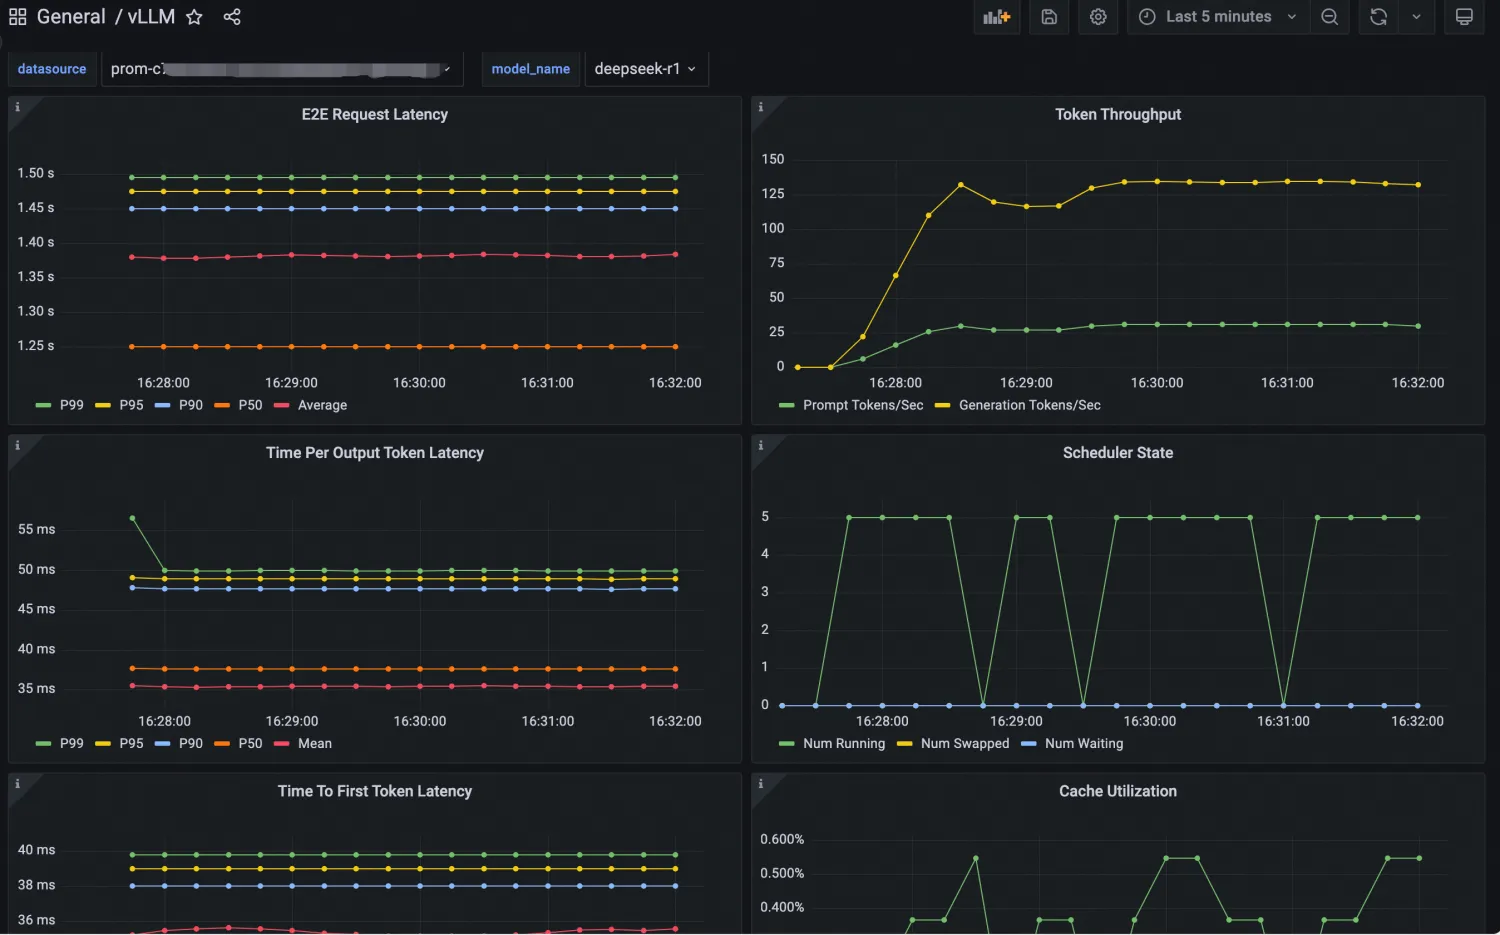
Importar un panel de Grafana
Importar el panel
Inicie sesión en la consola de ARMS.
En el panel de navegación izquierdo, haga clic en Integration Management.
En la pestaña integrated environments, seleccione container environment, busque por nombre del clúster ACK y haga clic en el entorno objetivo.
-
En la pestaña Component Management, copie y guarde el Cluster ID, y haga clic en Dashboard Directory.
El nombre del directorio de paneles contiene el ID de clúster correspondiente.
En el lado derecho de la pestaña Dashboards , haga clic en Import .
-
Copie el contenido de grafana.json, péguelo en el cuadro de texto Import via panel json y haga clic en Load.
NotaTambién puede importar el panel si carga el archivo JSON.
Mantenga la configuración predeterminada y haga clic en Import.
Comprobar los datos del panel
-
Busque el origen de datos por saved cluster ID o ID de instancia de Prometheus, y selecciónelo.
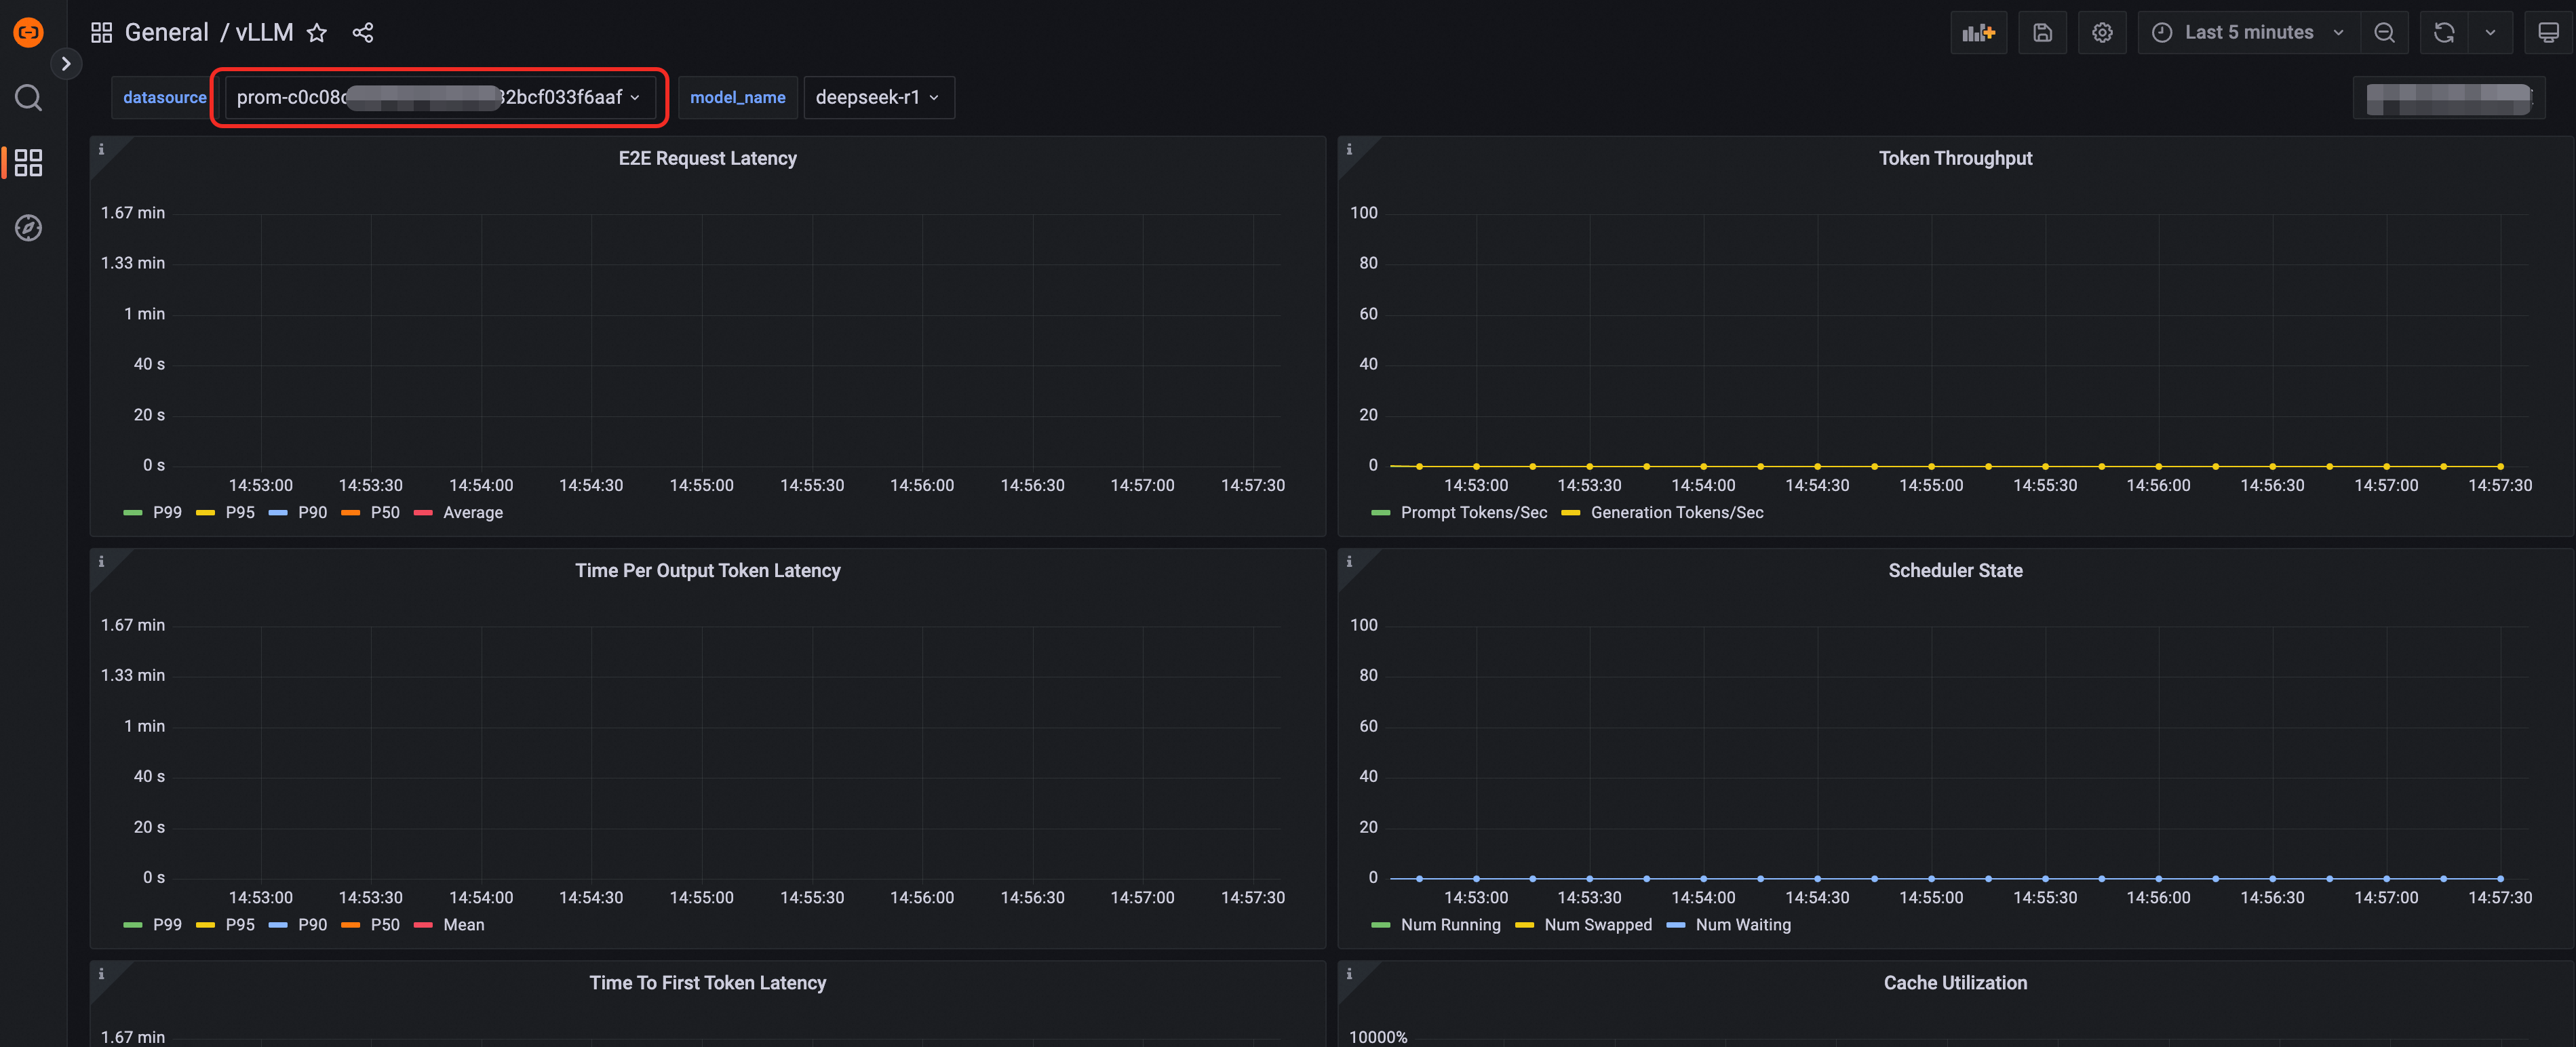
-
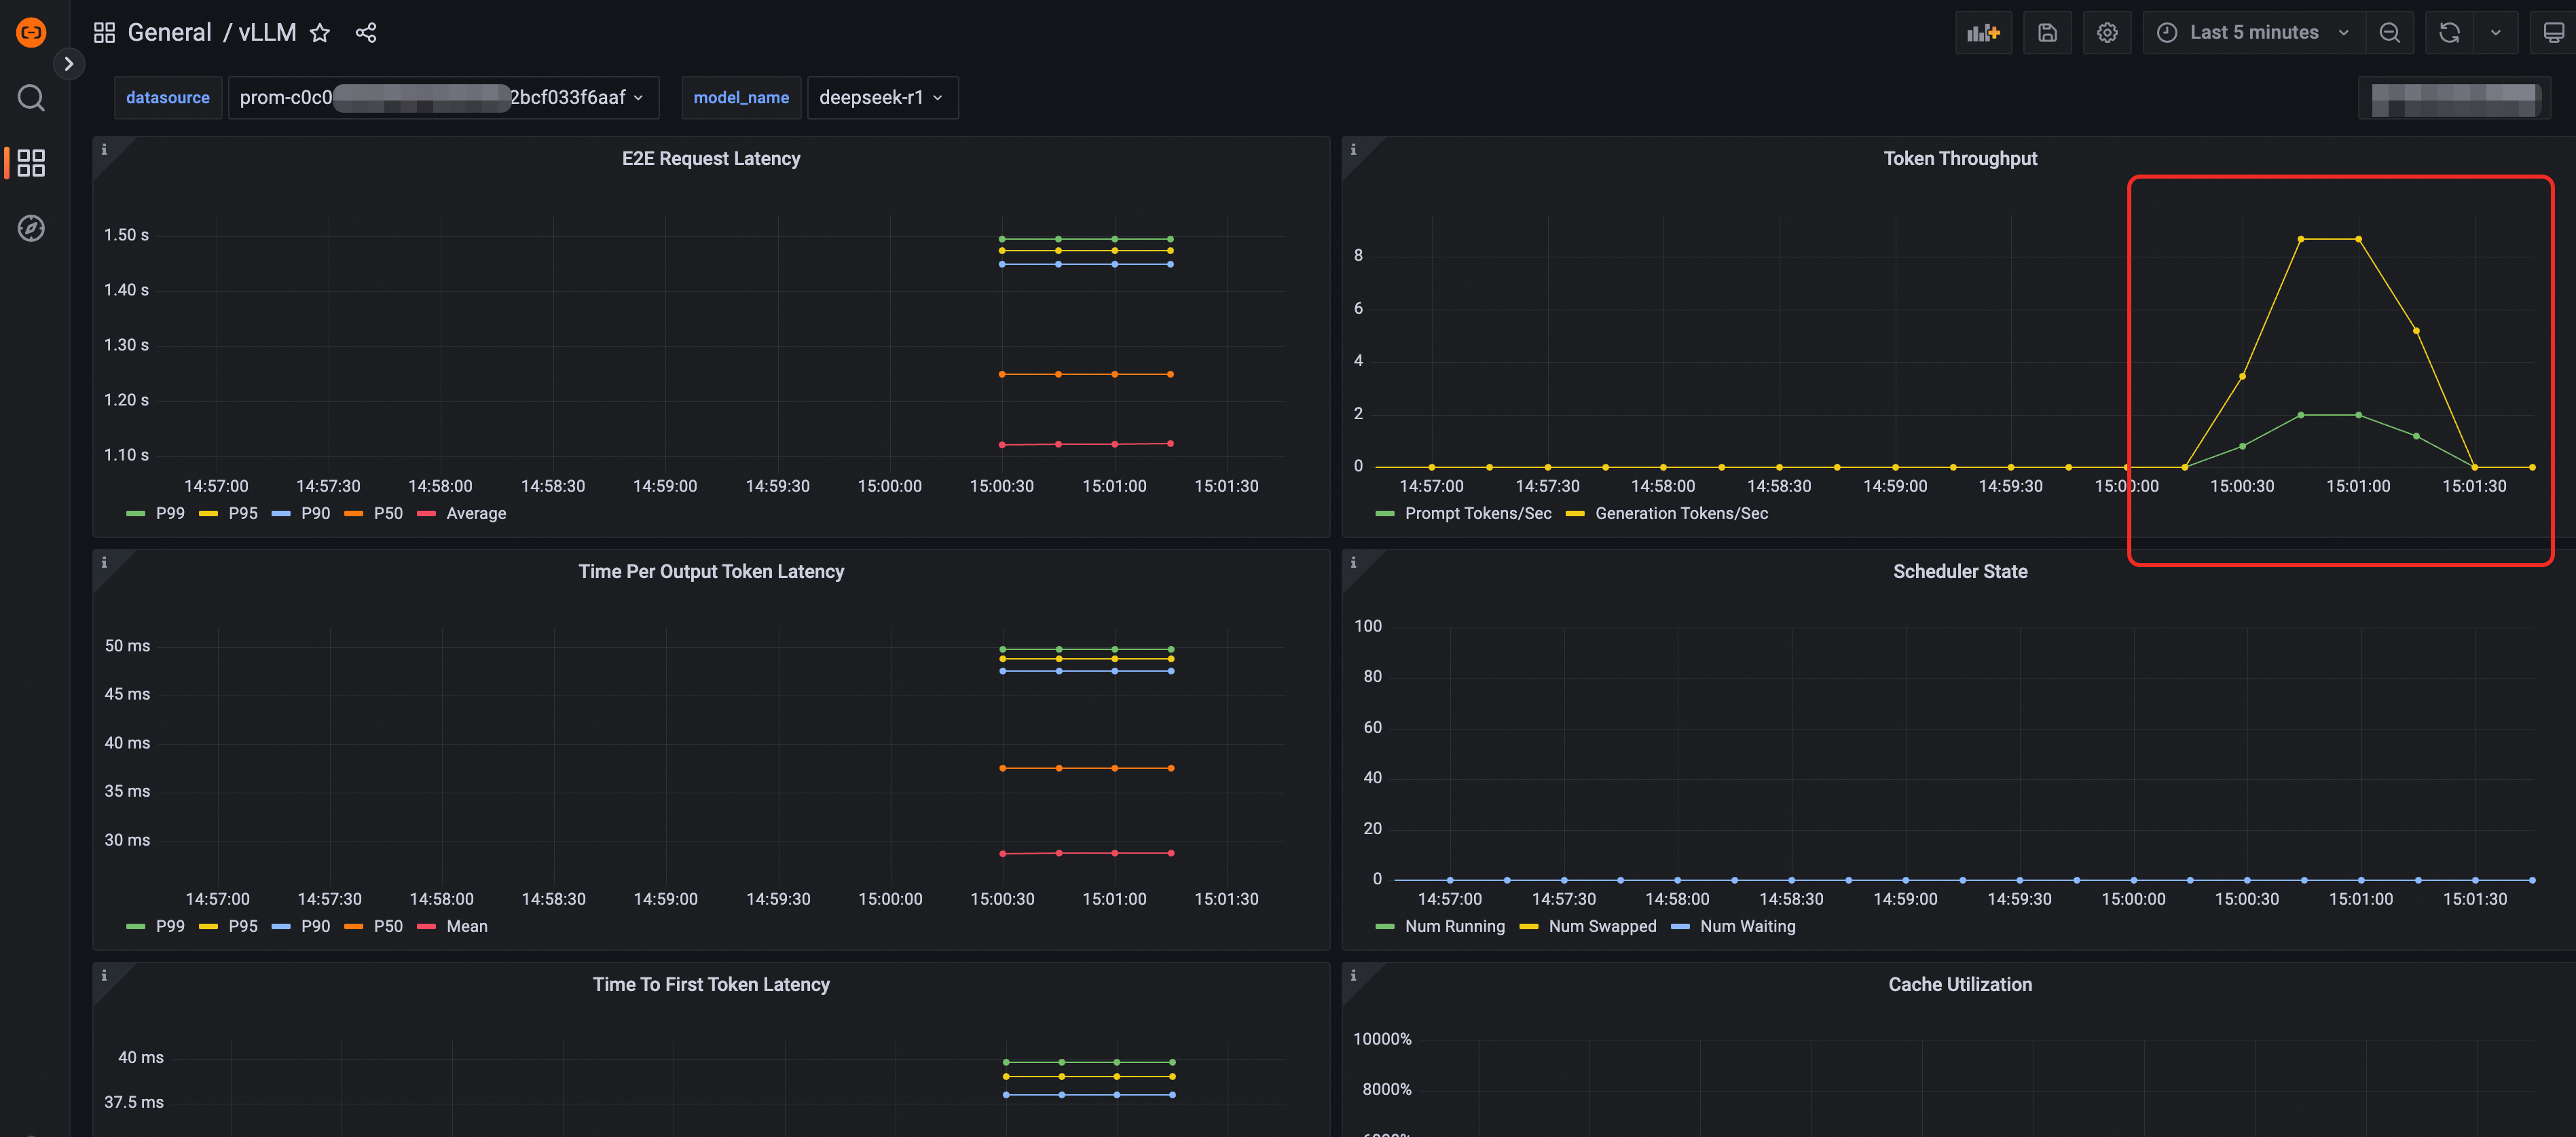
Envíe solicitudes a access the inference service para simular tráfico. Compruebe que métricas como Token Throughput aparezcan en el panel.
Escalado automático
KServe gestiona cargas de trabajo fluctuantes mediante el Horizontal Pod Autoscaler (HPA) de Kubernetes y ack-alibaba-cloud-metrics-adapter de ACK, lo que permite escalar los pods del servicio de modelos según CPU, memoria, utilización de GPU o métricas personalizadas. Consulte Configure auto scaling for a service.
Aceleración de modelos
Los artefactos de modelos grandes extraídos de servicios de almacenamiento como OSS y NAS pueden provocar retrasos prolongados e inicios en frío. Utilice Fluid para acelerar la carga de modelos y optimizar el rendimiento de inference en servicios basados en KServe. Consulte Use Fluid for model acceleration.
Versión canary
ACK admite estrategias de versión canary, como la división de tráfico por porcentaje y el enrutamiento basado en encabezados, para reducir los riesgos de despliegue. Consulte Implement canary releases for inference services.
Inference con GPU compartida
El modelo DeepSeek-R1-Distill-Qwen-7B requiere solo 14 GB de memoria de GPU. En instancias con GPU más grandes, la inference con GPU compartida divide una sola GPU entre varios servicios de inference, lo que mejora la utilización. Consulte Deploy GPU sharing inference services.