Consulte las métricas de workqueue, recursos y Kube API de kube-controller-manager mediante el panel de monitoreo.
Conceptos clave
Workqueue
Antes de empezar
Acceder al panel
Consulte View monitoring dashboards for cluster control plane components.
Lista de métricas
A continuación se listan las métricas de kube-controller-manager.
|
Métrica |
Tipo |
Descripción |
|
workqueue_adds_total |
Counter |
Total de eventos agregados a la |
|
workqueue_depth |
Gauge |
Profundidad actual de la |
|
workqueue_queue_duration_seconds_bucket |
Histogram |
Tiempo que un elemento espera en la |
|
memory_utilization_byte |
Gauge |
Utilización de memoria. Unidad: bytes. |
|
cpu_utilization_core |
Gauge |
Utilización de CPU. Unidad: núcleos. |
|
resource_utilization_level |
Gauge |
Nivel de utilización de recursos.
|
|
rest_client_requests_total |
Counter |
Total de solicitudes HTTP desglosado por código de estado, método y host. |
|
rest_client_request_duration_seconds_bucket |
Histogram |
Latencia de solicitudes HTTP desglosada por verbo y URL. |
Las siguientes métricas de utilización de recursos ya no están en uso. Elimine cualquier alerta o regla de monitoreo que dependa de estas métricas:
cpu_utilization_ratio: Utilización de CPU.
memory_utilization_ratio: Utilización de memoria.
Uso del panel
Configure el quantile de solicitud y el interval de muestreo PromQL en el panel. Las siguientes secciones describen cada gráfico y su consulta PromQL correspondiente.
Workqueue
Vista del panel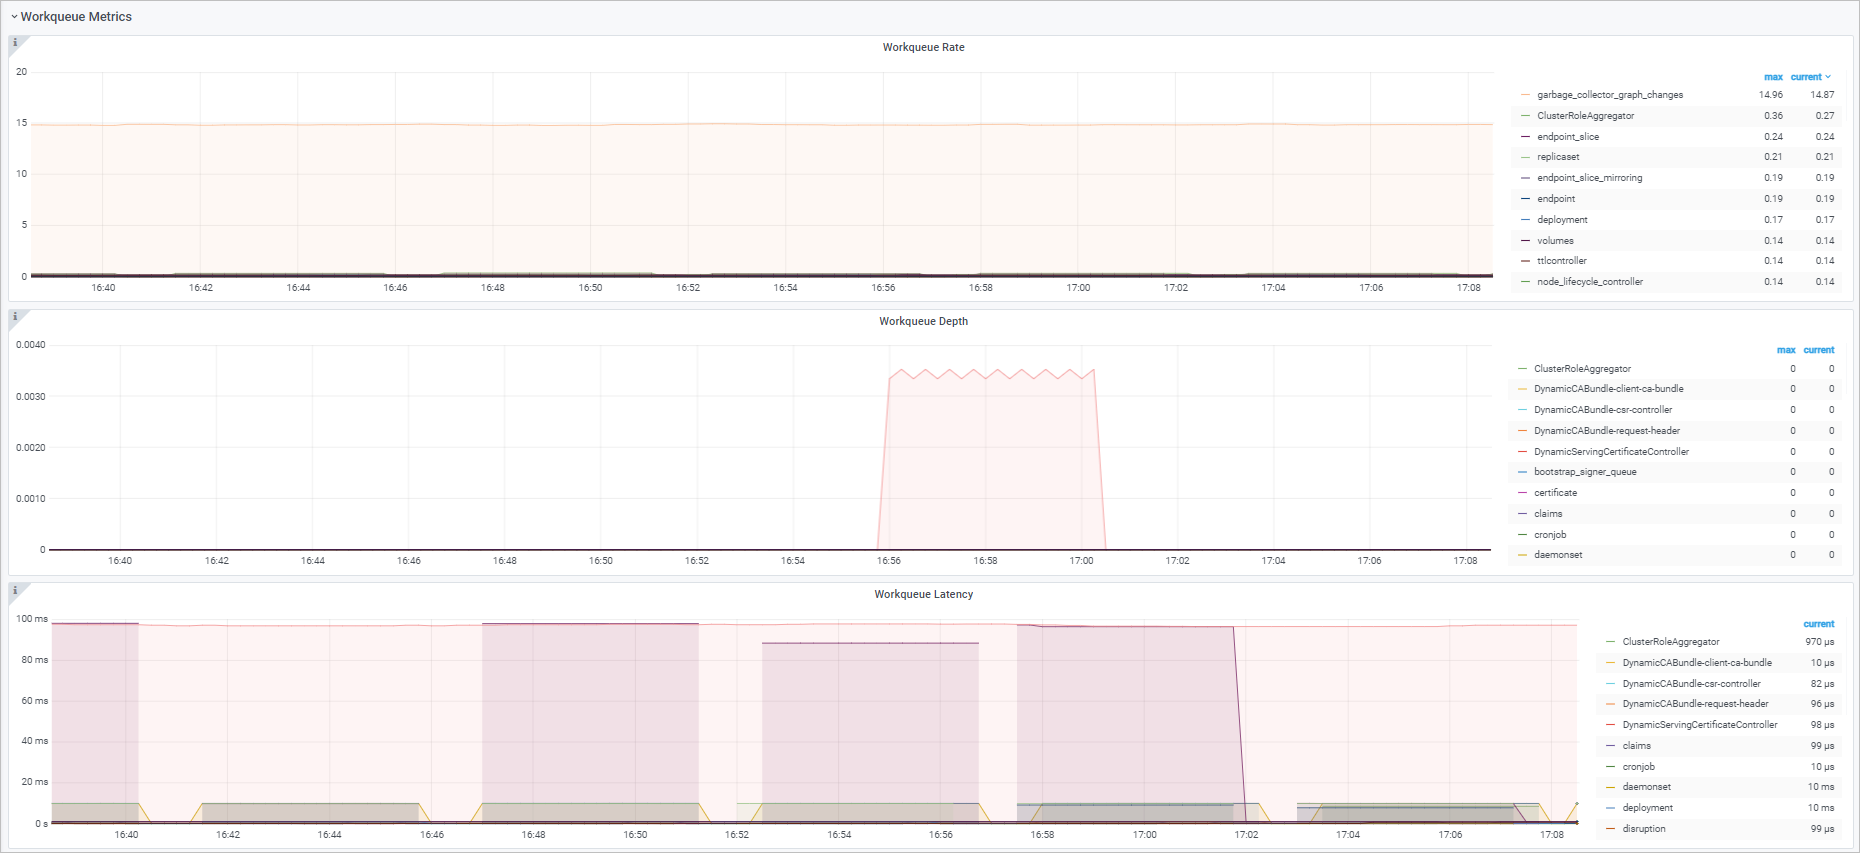
Gráficos
|
Nombre |
PromQL |
Descripción |
|
Workqueue Add Rate |
sum(rate(workqueue_adds_total{job="ack-kube-controller-manager"}[$interval])) by (name) |
Tasa de eventos agregados a la Workqueue. |
|
Workqueue Depth |
sum(rate(workqueue_depth{job="ack-kube-controller-manager"}[$interval])) by (name) |
Tasa promedio de cambio en la profundidad de la Workqueue. |
|
Workqueue Processing Latency |
histogram_quantile($quantile, sum(rate(workqueue_queue_duration_seconds_bucket{job="ack-kube-controller-manager"}[5m])) by (name, le)) |
Tiempo que un elemento espera en la Workqueue. |
Recursos
Vista del panel
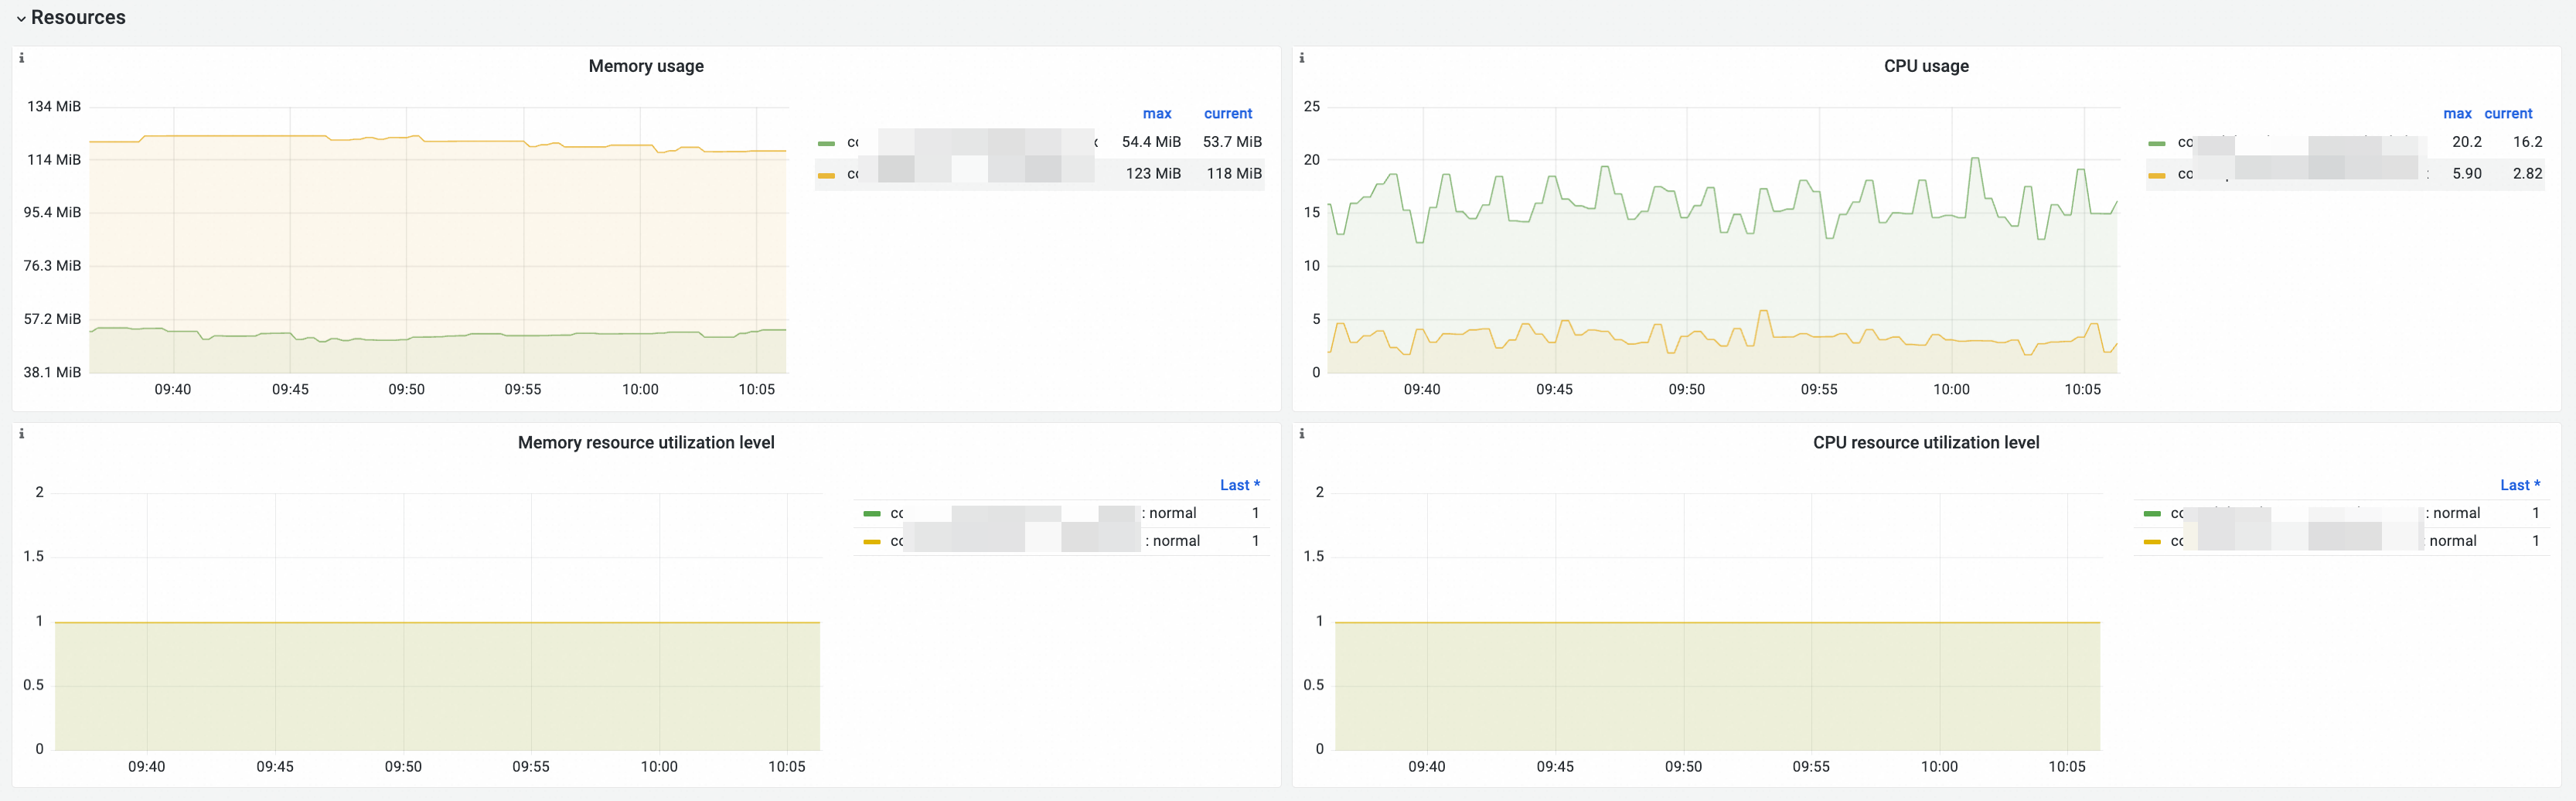
Gráficos
|
Nombre del gráfico |
PromQL |
Descripción |
|
Memory Utilization |
memory_utilization_byte{container="kube-controller-manager"} |
Utilización de memoria. Unidad: bytes. |
|
CPU Utilization |
cpu_utilization_core{container="kube-controller-manager"}*1000 |
Utilización de CPU. Unidad: milinúcleos. |
|
Memory Resource Utilization Level |
|
|
|
CPU Resource Utilization Level |
|
Kube API
Vista del panel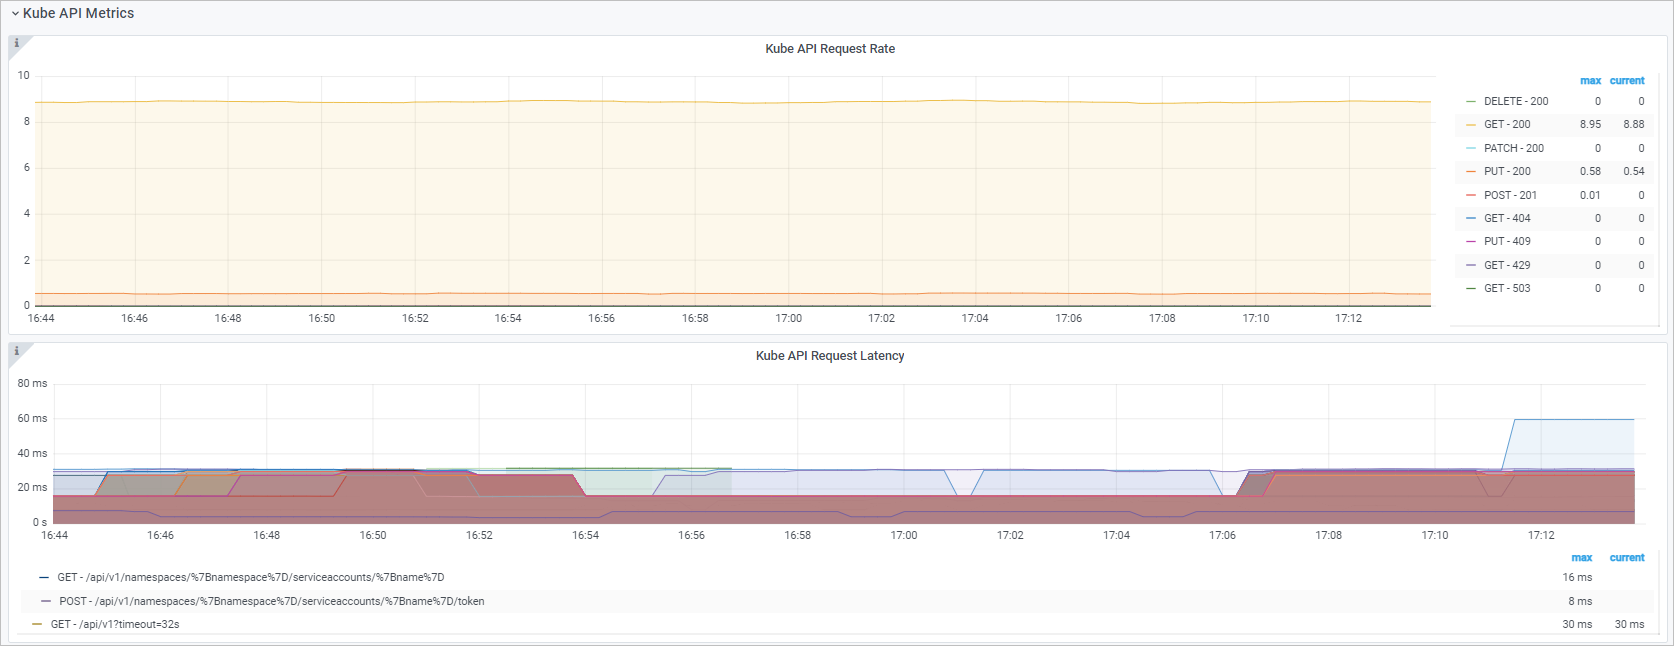
Gráficos
|
Nombre del gráfico |
PromQL |
Descripción |
|
Kube API Request QPS |
|
QPS de solicitudes HTTP desde kube-controller-manager hacia kube-apiserver, desglosado por método y código de estado. |
|
Kube API Request Latency |
histogram_quantile($quantile, sum(rate(rest_client_request_duration_seconds_bucket{job="ack-kube-controller-manager"}[$interval])) by (verb,url,le)) |
Latencia de solicitudes HTTP desde kube-controller-manager hacia kube-apiserver, desglosada por verbo y URL. |
Referencias
Para consultar las métricas y paneles de otros componentes del plano de control, consulte Monitoring metrics for the kube-apiserver component, Monitoring metrics for the etcd component, Monitoring metrics for the kube-scheduler component y Monitoring metrics for the cloud-controller-manager component.