El complemento cloud-controller-manager permite que los componentes principales de Kubernetes interactúen con el proveedor de nube mediante la API de Kubernetes. Este tema enumera sus métricas, explica cómo usar los paneles de monitoreo y analiza las anomalías más comunes en las métricas.
Antes de empezar
Acceso a los paneles
Consulte View monitoring dashboards for control plane components.
Lista de métricas
El componente cloud-controller-manager expone las siguientes métricas.
Métrica | Tipo | Descripción |
ccm_slb_latency_ms | Histogram | Latencia de sincronización de Classic Load Balancer (CLB). Unidad: ms. Umbrales de bucket: |
ccm_node_latency_ms | Histogram | Latencia de sincronización de nodos. Unidad: ms. Umbrales de bucket: |
ccm_route_latency_ms | Histogram | Latencia de sincronización de rutas. Unidad: ms. Umbrales de bucket: |
workqueue_adds_total | Counter | Total de eventos agregados a |
workqueue_depth | Gauge | Profundidad actual de |
workqueue_queue_duration_seconds_bucket | Histogram | Tiempo que un elemento espera en |
memory_utilization_byte | Gauge | Utilización de memoria. Unidad: bytes. |
cpu_utilization_core | Gauge | Utilización de CPU. Unidad: núcleos. |
resource_utilization_level | Gauge | Nivel de utilización de recursos.
|
rest_client_requests_total | Counter | Total de solicitudes HTTP por código de estado, método y host. |
rest_client_request_duration_seconds_bucket | Histogram | Latencia de solicitudes HTTP por verbo y URL. |
Las siguientes métricas de utilización de recursos ya no se utilizan. Elimine cualquier alerta o regla de monitoreo que dependa de estas métricas:
cpu_utilization_ratio: Utilización de CPU.
memory_utilization_ratio: Utilización de memoria.
Paneles
Los paneles basados en PromQL visualizan las métricas del componente.
CCM
Visualización de observability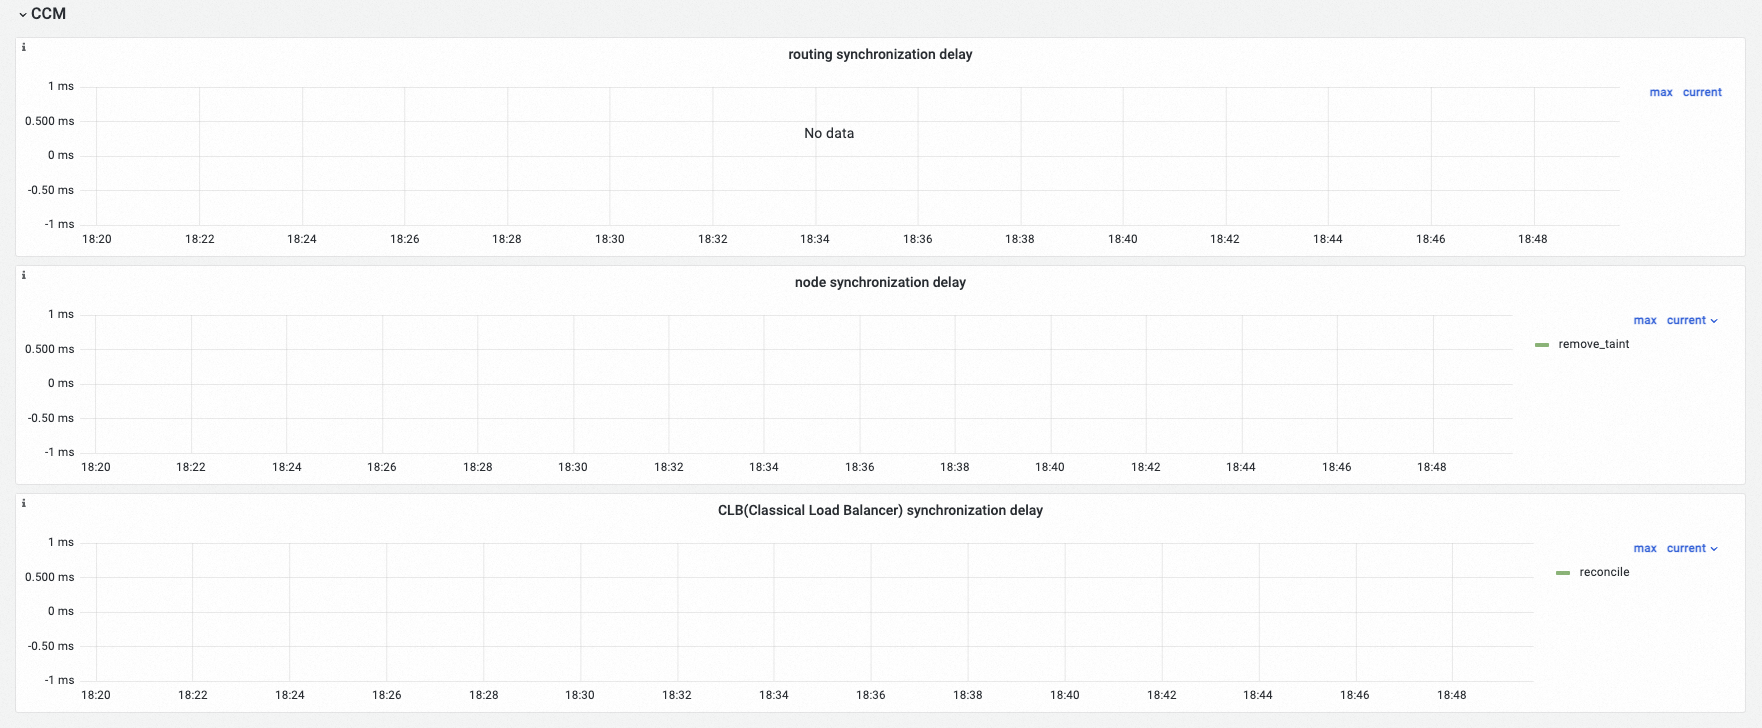
Detalles del panel
|
Nombre del panel |
PromQL |
Descripción |
|
Latencia de sincronización de rutas |
histogram_quantile($quantile, sum(rate(ccm_route_latencies_duration_milliseconds_bucket[$interval])) by (verb, le)) |
Latencia de sincronización de rutas. Unidad: ms. |
|
Latencia de sincronización de nodos |
histogram_quantile($quantile, sum(rate(ccm_node_latencies_duration_milliseconds_bucket[$interval])) by (verb, le)) |
Latencia de sincronización de nodos. Unidad: ms. |
|
Latencia de sincronización de CLB (Classic Load Balancer) |
histogram_quantile($quantile, sum(rate(ccm_slb_latencies_duration_milliseconds_bucket[$interval])) by (verb, le)) |
Latencia de sincronización de CLB. Unidad: ms. |
Cola
Visualización de observability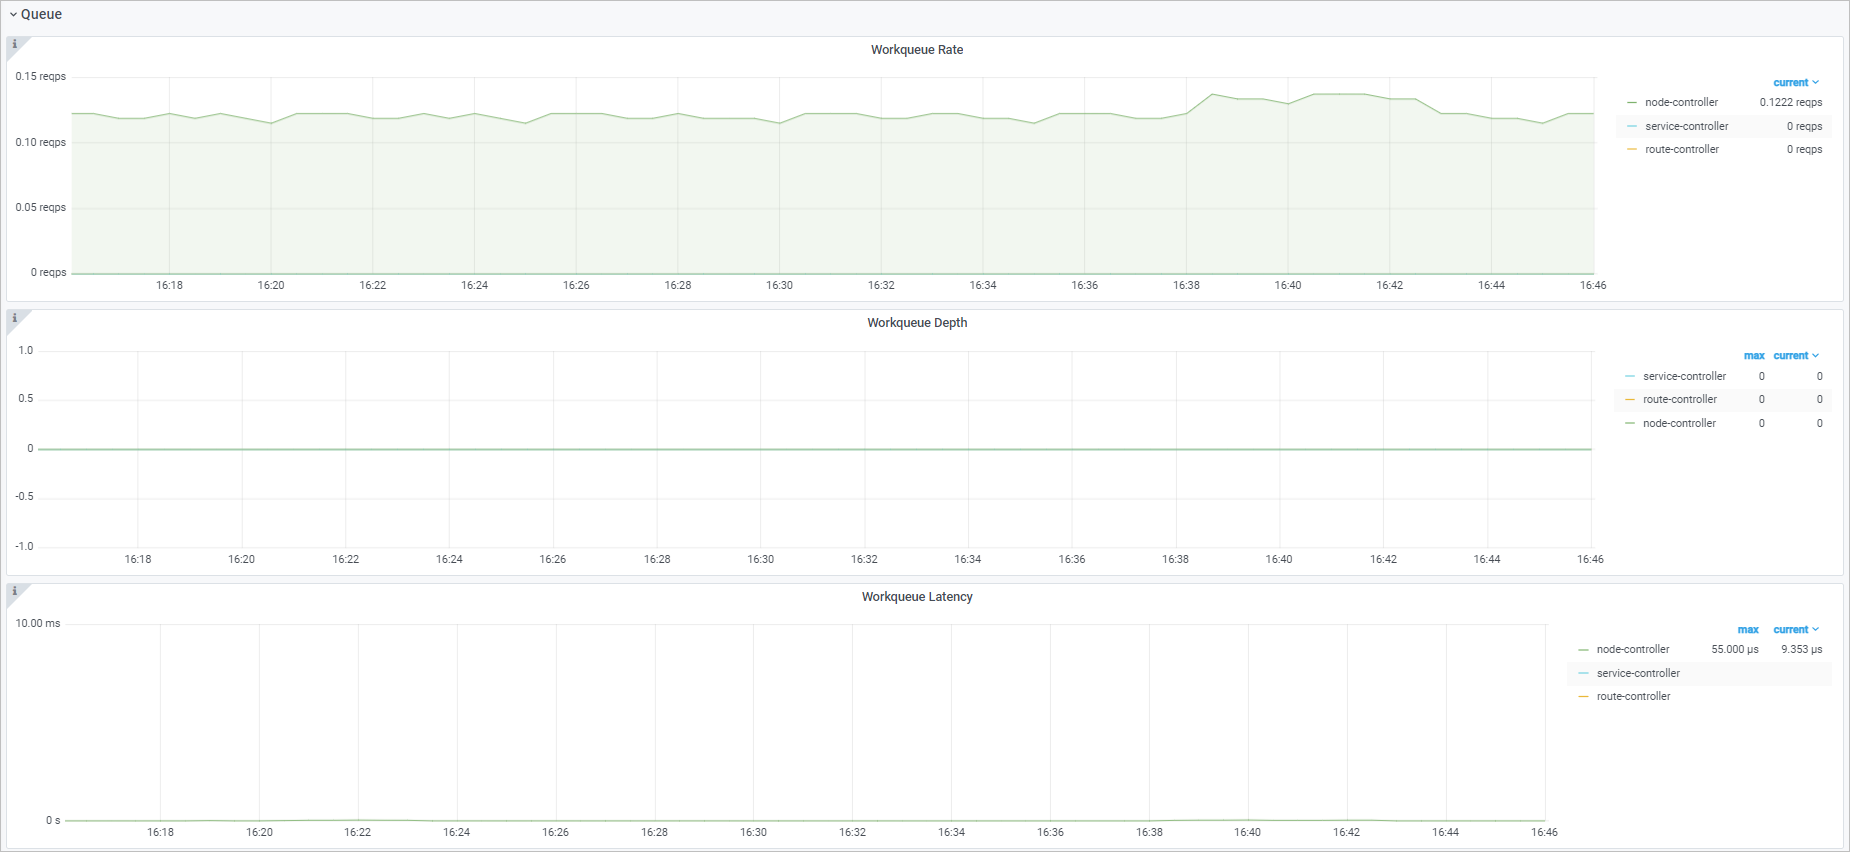
Detalles del panel
|
Nombre del panel |
PromQL |
Descripción |
|
Tasa de adición a Workqueue |
sum(rate(workqueue_adds_total{job="ack-cloud-controller-manager"}[$interval])) by (name) |
Tasa de eventos agregados a Workqueue. |
|
Profundidad de Workqueue |
workqueue_depth{job="ack-cloud-controller-manager"} |
Tasa promedio de cambio en la profundidad de Workqueue. |
|
Latencia de procesamiento de Workqueue |
histogram_quantile($quantile, sum(rate(workqueue_queue_duration_seconds_bucket{job="ack-cloud-controller-manager"}[$interval])) by (name, le)) |
Tiempo que un elemento espera en Workqueue. |
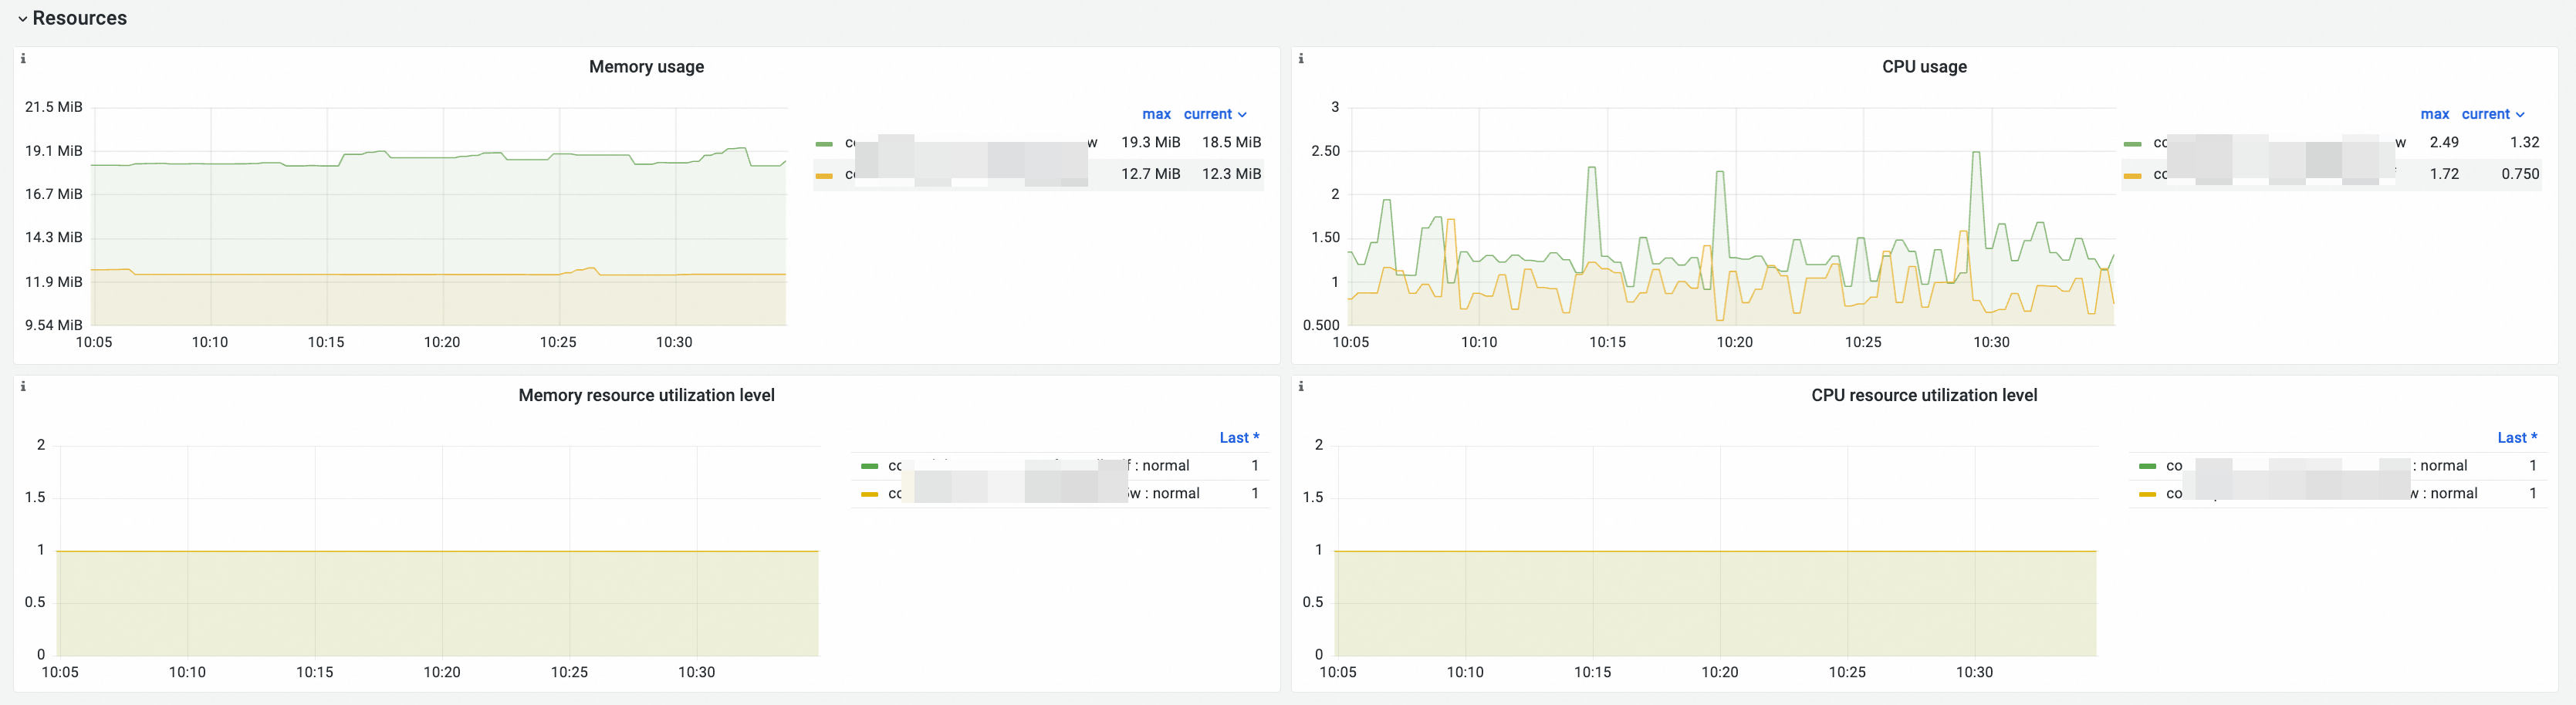
Recursos
Visualización de observability
Detalles del panel
Nombre del panel | PromQL | Descripción |
Uso de memoria | memory_utilization_byte{container="cloud-controller-manager"} | Utilización de memoria. Unidad: bytes. |
CPU Usage | cpu_utilization_core{container="cloud-controller-manager"}*1000 | Utilización de CPU. Unidad: milinúcleo. |
Nivel de utilización de memoria |
|
|
Nivel de utilización de CPU |
|
Kube API
Visualización de observability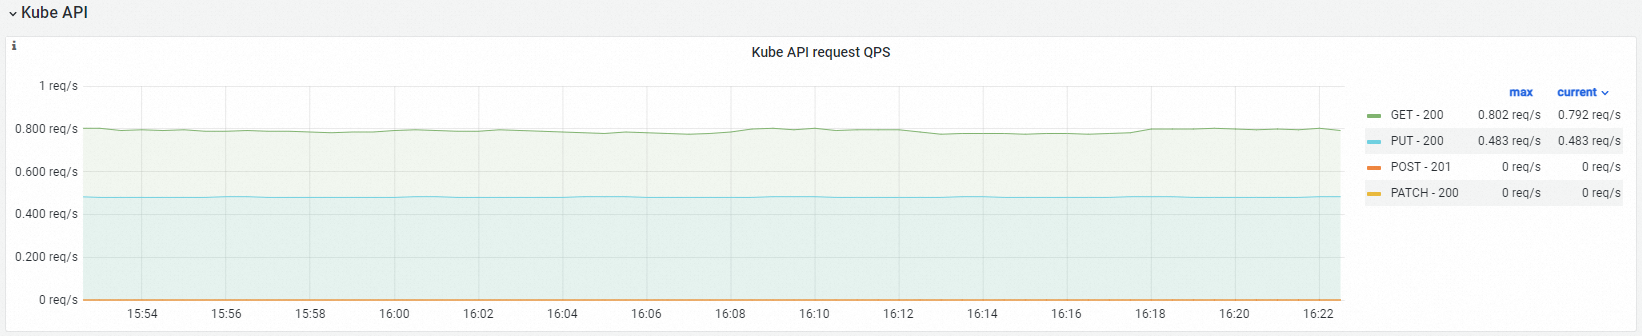
Detalles del panel
Nombre del panel | PromQL | Descripción |
QPS de solicitudes a Kube API |
| QPS de solicitudes HTTP desde cloud-controller-manager hacia kube-apiserver, desglosado por método y código de estado. |
Anomalías comunes en métricas
Latencia de sincronización de Classic Load Balancer (CLB)
|
Condiciones normales |
Condiciones anómalas |
Descripción |
Recomendaciones |
|
La latencia de sincronización de CLB (Classic Load Balancer) es ≤ 10 s. |
La latencia de sincronización de CLB (Classic Load Balancer) supera los 10 s. |
La sincronización de CLB tarda demasiado. |
Compruebe si hay eventos anómalos en el Service. |
Profundidad de Workqueue
|
Condiciones normales |
Condiciones anómalas |
Descripción |
Recomendaciones |
|
La profundidad de Workqueue es ≤ 10. |
La profundidad de Workqueue supera 10. |
Gran acumulación de elementos pendientes de sincronización. |
Una cola excesivamente larga ralentiza la sincronización de Services. Reduzca la frecuencia de cambios en nodos, Pods y Services del clúster. |
Documentación relacionada
Para otros componentes del plano de control, consulte kube-apiserver monitoring metrics, etcd monitoring metrics, kube-scheduler monitoring metrics y kube-controller-manager monitoring metrics.