Los volúmenes persistentes (PV) de OSS admiten varios clientes, pero la compatibilidad total con escrituras degrada el rendimiento de lectura. La separación de lectura y escritura resuelve este problema al enrutar las lecturas y las escrituras por rutas de montaje distintas. Esto mejora el rendimiento en cargas de trabajo intensivas en lectura, como el entrenamiento de modelos, la inference y el análisis de datos.
Implemente la separación de lectura y escritura para los PV de OSS con ossfs o el SDK de OSS. Este documento lo demuestra mediante un trabajo de entrenamiento de reconocimiento de escritura a mano MNIST.
Requisitos previos
Asegúrese de contar con lo siguiente:
El componente Container Storage Interface (CSI) más reciente instalado. Cada cliente requiere una versión distinta de CSI. Consulte Manage csi-plugin and csi-provisioner components.
Un bucket de OSS en la misma cuenta de Alibaba Cloud que el clúster.
No se recomienda acceder a OSS entre cuentas distintas.
Elija un cliente
Los PV de OSS son compatibles con tres clientes: ossfs 1.0, ossfs 2.0 y strmvol. Todos permiten el acceso de solo lectura, pero sus capacidades de escritura difieren:
|
Client |
Read-only |
Read/write |
Best for |
|
ossfs 1.0 |
Sí |
Escritura completa |
Cargas de trabajo generales de lectura y escritura; modo de lectura directa disponible (v1.91+) |
|
ossfs 2.0 |
Sí |
Solo escrituras secuenciales por anexión |
Cargas de trabajo intensivas en lectura; requiere CSI >= 1.33.1 |
|
strmvol |
Sí |
— |
Muchos archivos pequeños (conjuntos de datos, registros de series temporales, backtesting cuantitativo) |
Consulte la referencia de selección de clientes.
Casos de uso
Acceso de solo lectura
Establezca el modo de acceso del PV en ReadOnlyMany para evitar modificaciones accidentales de los datos. Esta opción es adecuada para inference, análisis de datos y consultas de registros.
Para cargas de trabajo intensivas en lectura, utilice ossfs 2.0 (CSI >= 1.33.1). Consulte Uso de PV de ossfs 2.0.
Si maneja muchos archivos pequeños, utilice strmvol. Consulte Uso de PV de strmvol.
Configure los siguientes parámetros de otherOpts para ajustar ossfs 1.0 en escenarios de solo lectura. La mayoría de las cargas de trabajo pueden usar los valores predeterminados.
|
Parameter |
Default |
Description |
|
|
Deshabilitado |
Habilita la caché de búfer del kernel para lecturas no en tiempo real. Utiliza memoria libre para la caché. |
|
|
20 |
Fragmentos simultáneos para cargar y descargar archivos grandes. |
|
|
20 |
Número máximo de solicitudes simultáneas de listado de metadatos. Debe ser >= |
|
|
1000 |
Cantidad de entradas de metadatos almacenadas en caché. Establézcalo en |
|
|
Deshabilitado |
Modo de lectura directa para escenarios de solo lectura (ossfs >= 1.91). Consulte Características y pruebas de rendimiento de la nueva versión de ossfs 1.0 y Optimización del rendimiento para escenarios de solo lectura. |
Acceso de lectura y escritura
Establezca el modo de acceso del PV en ReadWriteMany para las cargas de trabajo que escriben datos.
ossfs no garantiza la consistencia en escrituras simultáneas. Varios escritores sobre los mismos objetos pueden corromper los datos. Use un único escritor por ruta para las escrituras de puntos de control.
Eliminar o modificar archivos en la ruta montada también elimina o modifica los objetos del bucket de OSS. Habilite el control de versiones para protegerse contra la pérdida de datos.
En cargas de trabajo intensivas en lectura con rutas separadas para leer y escribir (como el entrenamiento de modelos), monte la ruta de lectura como ReadOnlyMany con la caché habilitada. Gestione las escrituras mediante un PV ReadWriteMany o el SDK de OSS.
Cómo funciona la separación de lectura y escritura
La separación de lectura y escritura enruta las operaciones por puntos de montaje distintos. Cada uno apunta a una subruta diferente del mismo bucket de OSS, lo que aísla la E/S de lectura de la E/S de escritura.
Ruta de lectura: monte una subruta (por ejemplo,
/tf-train/train/data) comoReadOnlyManycon la caché habilitada. Las lecturas repetidas se atienden desde la memoria.Ruta de escritura: monte otra subruta (por ejemplo,
/tf-train/training_logs) comoReadWriteMany, o escriba directamente mediante el SDK.
Ejemplo: entrenamiento de reconocimiento de escritura a mano MNIST
El trabajo de entrenamiento realiza lo siguiente:
Lee el conjunto de datos de entrenamiento desde
/tf-train/train/dataen el bucket de OSS mediante un PV de solo lectura.Escribe los puntos de control del entrenamiento en
/tf-train/training_logscon un PV de lectura y escritura o con el SDK de OSS.
Descargue el conjunto de datos MNIST y cárguelo en /tf-train/train/data dentro de su bucket de OSS:
Organización de los archivos en el bucket de OSS:

Implemente las operaciones de lectura y escritura con ossfs
Las escrituras de puntos de control son anexiones secuenciales, por lo que tanto ossfs 1.0 como ossfs 2.0 funcionan para la ruta de escritura.
-
Despliegue la aplicación de entrenamiento. La aplicación monta la subruta
/tf-traindel bucket de OSS en el directorio/mntdel pod. Consulte Uso de volúmenes aprovisionados estáticamente con ossfs 1.0 o Uso de PV de ossfs 2.0.-
Cree un PV de ossfs 1.0:
cat << EOF | kubectl apply -f - apiVersion: v1 kind: Secret metadata: name: oss-secret namespace: default stringData: akId: "<your-accesskey-id>" akSecret: "<your-accesskey-secret>" --- apiVersion: v1 kind: PersistentVolume metadata: name: tf-train-pv labels: alicloud-pvname: tf-train-pv spec: capacity: storage: 10Gi accessModes: - ReadWriteMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-train-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o max_stat_cache_size=0 -o allow_other" path: "/tf-train" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-train-pvc spec: accessModes: - ReadWriteMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-train-pv EOF -
Cree el pod de entrenamiento:
Durante el entrenamiento, ossfs carga los archivos de
/mnt/training_logs(pod) hacia/tf-train/training_logs(bucket de OSS).cat << EOF | kubectl apply -f - apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:rw imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc EOF
-
-
Compruebe las lecturas y escrituras de datos.
-
Revise el estado del pod:
kubectl get pod tf-mnistEspere a que el estado cambie de
RunningaCompleted:NAME READY STATUS RESTARTS AGE tf-mnist 0/1 Completed 0 2m12s -
Revise el tiempo de carga de datos:
kubectl logs tf-mnist | grep dataloadResultado esperado:
dataload cost time: 1.54191803932 Inicie sesión en la consola de administración de OSS y compruebe que los archivos existen bajo
/tf-train/training_logsen el bucket.
-
Optimice el rendimiento de lectura con la separación de lectura y escritura
Divida el PV único de lectura y escritura en dos: un PV de solo lectura con ajustes de caché para el conjunto de datos y un PV de escritura para los puntos de control. Solo cambia la configuración de montaje; el código de entrenamiento permanece igual.
Existen dos opciones de escritura:
Opción 1: use un PV de ossfs de lectura y escritura independiente para escribir los puntos de control.
Opción 2: use el SDK de OSS para escribir los puntos de control directamente y omitir ossfs por completo.
Opción 1: escritura mediante un PV de ossfs de lectura y escritura
-
Cree un PV de ossfs 1.0 de solo lectura para el conjunto de datos. Los cambios clave de configuración son:
Establezca
accessModesenReadOnlyManytanto en el PV como en el PVC. Monte la subruta del conjunto de datos/tf-train/train/data.-
En
otherOpts, agregue-o kernel_cache -o max_stat_cache_size=10000 -o umask=022:kernel_cachehabilita la caché de lectura en memoria.max_stat_cache_size=10000almacena 10,000 entradas de metadatos en caché (~40 MB). Ajústelo según el tipo de instancia y el tamaño del conjunto de datos.umask=022otorga acceso de lectura a los procesos del contenedor que no son root.
cat << EOF | kubectl apply -f - apiVersion: v1 kind: Secret metadata: name: oss-secret namespace: default stringData: akId: "<your-accesskey-id>" akSecret: "<your-accesskey-secret>" --- apiVersion: v1 kind: PersistentVolume metadata: name: tf-train-pv labels: alicloud-pvname: tf-train-pv spec: capacity: storage: 10Gi accessModes: - ReadOnlyMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-train-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o kernel_cache -o max_stat_cache_size=10000 -o umask=022 -o allow_other" path: "/tf-train/train/data" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-train-pvc spec: accessModes: - ReadOnlyMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-train-pv EOF -
Cree un PV de ossfs 1.0 de lectura y escritura para los puntos de control, y monte la subruta
/tf-train/training_logs. La caché de metadatos se deshabilita (max_stat_cache_size=0) porque las escrituras secuenciales de puntos de control no se benefician de ella.cat << EOF | kubectl apply -f - apiVersion: v1 kind: PersistentVolume metadata: name: tf-logging-pv labels: alicloud-pvname: tf-logging-pv spec: capacity: storage: 10Gi accessModes: - ReadWriteMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-logging-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o max_stat_cache_size=0 -o allow_other" path: "/tf-train/training_logs" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-logging-pvc spec: accessModes: - ReadWriteMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-logging-pv EOF -
Despliegue el pod de entrenamiento con ambos PV montados.
No se requieren cambios en el código. Monte ambos PV: el de solo lectura en
/mnt/train/datay el de lectura y escritura en/mnt/training_logs.cat << EOF | kubectl apply -f - apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:rw imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt/train/data" - name: logging mountPath: "/mnt/training_logs" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc - name: logging persistentVolumeClaim: claimName: tf-logging-pvc EOF
Opción 2: escritura mediante el SDK de OSS
Escriba los puntos de control directamente en OSS con el SDK; no necesita un PV de lectura y escritura. El pod lee desde un PV de solo lectura y escribe mediante el SDK.
-
Agregue el SDK de Python de OSS a la imagen del contenedor:
RUN pip install oss2Consulte Installation.
-
Modifique el código de entrenamiento para cargar los puntos de control con el SDK. El código original guarda los puntos de control en
log_dircada 100 iteraciones mediantetf.train.Saverconmax_to_keep=0, lo que genera 10 conjuntos de puntos de control tras 1,000 iteraciones.Establezca
max_to_keep=1para conservar solo el punto de control más reciente y reducir el consumo de memoria.Cargue cada punto de control en OSS con
put_object_from_filedespués de guardarlo.
Use E/S asíncrona con el SDK para mejorar aún más el rendimiento cuando las rutas de lectura y escritura están separadas.
def train():
    ...
saver = tf.train.Saver(max_to_keep=0)

    for i in range(FLAGS.max_steps):
        if i % 10 == 0:  # Record summaries and test-set accuracy
            summary, acc = sess.run([merged, accuracy], feed_dict=feed_dict(False))
            print('Accuracy at step %s: %s' % (i, acc))
            if i % 100 == 0:
                print('Save checkpoint at step %s: %s' % (i, acc))
                saver.save(sess, FLAGS.log_dir + '/model.ckpt', global_step=i)
Reemplace el código anterior por cargas basadas en el SDK. Dos cambios reducen el consumo de memoria y eliminan el PV de lectura y escritura: lea la AccessKey y la configuración del bucket desde variables de entorno. Consulte Configure access credentials.
import oss2
from oss2.credentials import EnvironmentVariableCredentialsProvider

auth = oss2.ProviderAuth(EnvironmentVariableCredentialsProvider())
url = os.getenv('URL','<default-url>')
bucketname = os.getenv('BUCKET','<default-bucket-name>')
bucket = oss2.Bucket(auth, url, bucketname)

...
def train():
  ...
  saver = tf.train.Saver(max_to_keep=1)

 for i in range(FLAGS.max_steps):
    if i % 10 == 0:  # Record summaries and test-set accuracy
      summary, acc = sess.run([merged, accuracy], feed_dict=feed_dict(False))
      print('Accuracy at step %s: %s' % (i, acc))
      if i % 100 == 0:
        print('Save checkpoint at step %s: %s' % (i, acc))
        saver.save(sess, FLAGS.log_dir + '/model.ckpt', global_step=i)
        # FLAGS.log_dir = os.path.join(os.getenv('TEST_TMPDIR', '/mnt'),'training_logs')
        for path,_,file_list in os.walk(FLAGS.log_dir) :
          for file_name in file_list:
            bucket.put_object_from_file(os.path.join('tf-train/training_logs', file_name), os.path.join(path, file_name))
La imagen del contenedor modificada es
registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:ro. -
Despliegue el pod con el PV de solo lectura y las credenciales del SDK. El pod establece
accessModesenReadOnlyManyy pasaOSS_ACCESS_KEY_IDyOSS_ACCESS_KEY_SECRETpara que el SDK se autentique con las mismas credenciales que el PV.cat << EOF | kubectl apply -f - apiVersion: v1 kind: Secret metadata: name: oss-secret namespace: default stringData: akId: "<your-accesskey-id>" akSecret: "<your-accesskey-secret>" --- apiVersion: v1 kind: PersistentVolume metadata: name: tf-train-pv labels: alicloud-pvname: tf-train-pv spec: capacity: storage: 10Gi accessModes: - ReadOnlyMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-train-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o kernel_cache -o max_stat_cache_size=10000 -o umask=022 -o allow_other" path: "/tf-train/train/data" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-train-pvc spec: accessModes: - ReadOnlyMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-train-pv --- apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" - name: OSS_ACCESS_KEY_ID #The source of the AccessKey is the same as that of the PV. valueFrom: secretKeyRef: name: oss-secret key: akId - name: OSS_ACCESS_KEY_SECRET #The source of the AccessKey is the same as that of the PV. valueFrom: secretKeyRef: name: oss-secret key: akSecret - name: URL #You can ignore this if a default URL is configured. value: "https://oss-<region>.aliyuncs.com" - name: BUCKET #You can ignore this if a default BUCKET is configured. value: "<bucket-name>" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:ro imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt/train/data" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc EOF
Compruebe la separación de lectura y escritura
Después de desplegar con cualquiera de las opciones de escritura:
-
Revise el estado del pod:
kubectl get pod tf-mnistEspere a que el estado cambie a
Completed:NAME READY STATUS RESTARTS AGE tf-mnist 0/1 Completed 0 2m25s -
Revise el tiempo de carga de datos:
kubectl logs tf-mnist | grep dataloadCon la separación de lectura y escritura y la caché del kernel habilitada, el tiempo de carga de datos disminuye:
dataload cost time: 0.843528985977La línea base sin separación es de aproximadamente 1.54 segundos. Los trabajos de entrenamiento más grandes y las cargas de datos repetidas muestran una mejora mayor.
-
Inicie sesión en la consola de administración de OSS y compruebe que los archivos de puntos de control están presentes bajo
/tf-train/training_logsen el bucket.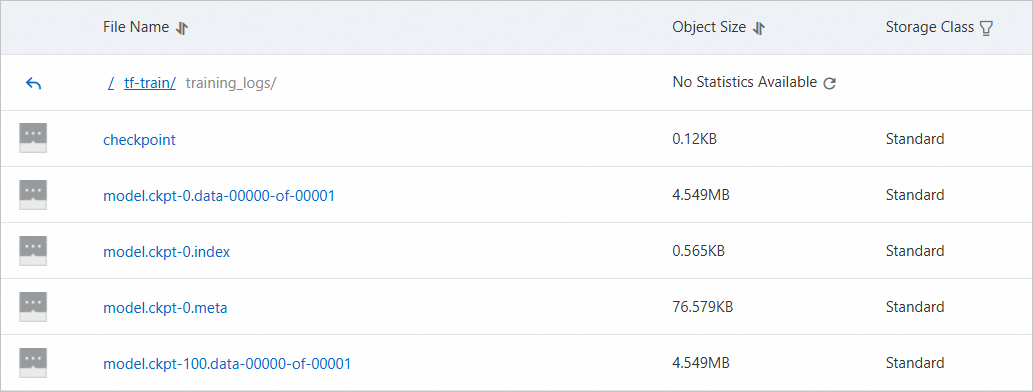
Referencias
Referencia del SDK de OSS
Este tema utiliza el SDK de Python. Otros SDK disponibles:
Para otros SDK (PHP, Node.js, Browser.js, .NET, Android, iOS, Ruby), consulte la referencia del SDK.
Otras herramientas de escritura
Estas herramientas también permiten escribir en OSS:
|
Tool |
Reference |
|
OpenAPI |
|
|
Interfaz de línea de comandos de ossutil |
|
|
Herramienta de administración gráfica ossbrowser |