模型压缩通过量化等技术减小模型体积和计算复杂度,同时尽量保持预测性能。适用于GPU显存有限或需要降低部署成本的场景。
简介
PAI-Model Gallery支持基于Weight-only Quantization技术的模型量化,通过MinMax-8Bit或MinMax-4Bit策略将模型浮点数参数量化到8位或4位整数表示,减小模型体积、降低显存占用,同时保持较好的性能。
压缩模型
筛选可压缩的模型。从Model Gallery模型广场页面左侧的支持操作筛选区,选择压缩即可过滤出可压缩的模型。
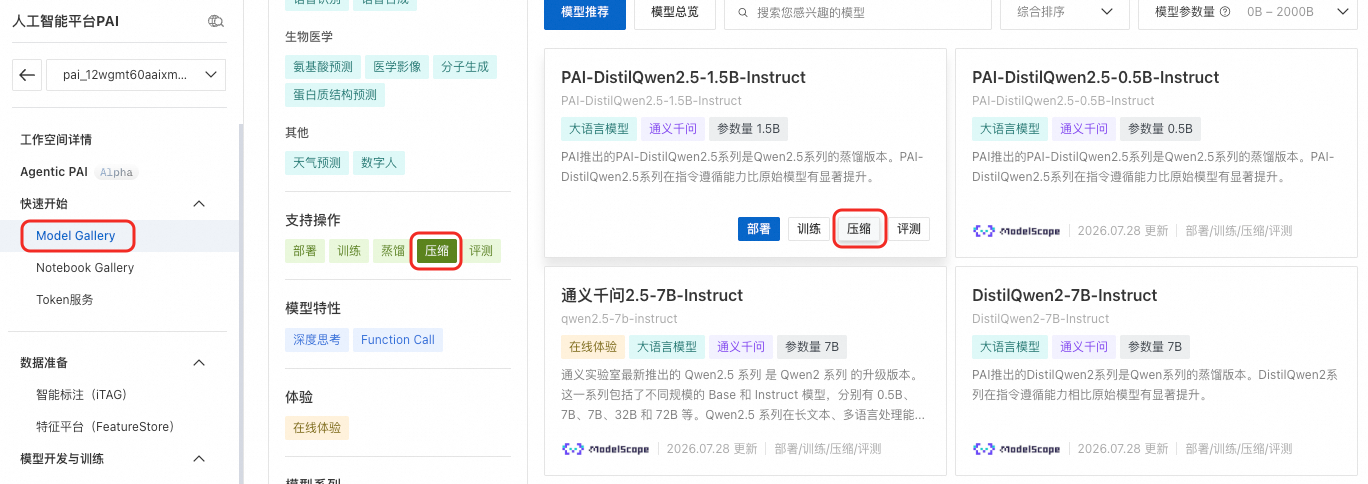
单击目标模型卡片上的压缩按钮,配置压缩任务。关键配置如下,其他参数按需配置。
参数
说明
压缩方式
当前仅支持基于Weight-only Quantization技术的模型量化方法,即将模型的权重参数转换到更低的bit位,降低模型推理的显存占用。
压缩策略
MinMax-8Bit:使用最小值-最大值(min-max)缩放方法将模型量化到8位整数表示。
MinMax-4Bit:使用最小值-最大值(min-max)缩放方法将模型量化到4位整数表示。
完成配置后,单击压缩。页面跳转到任务详情页面,可查看压缩任务的基本信息、实时状态和任务日志。
后续您可以在PAI-Model Gallery > 任务管理 > 压缩任务中可查看压缩任务。
部署模型
模型压缩任务成功后,在模型详情页右上角可单击部署,部署压缩后的模型。服务调用请参见通过共享网关调用(公网/内网)。
评测模型
模型部署完成后,您可以评测模型查看模型压缩后的效果,详情请参见模型评测(ModelEval)。