灵骏智算本地缓存加速将训练数据缓存至计算节点本地,避免每轮训练重复从远端存储读取数据,大幅提升数据读取性能。适用于多Epoch训练、大规模数据集等需要反复读取数据的场景。
功能概述
本地缓存支持以下核心能力:
高速缓存:利用计算节点的本地盘构建读缓存,加速数据集与Checkpoint访问,显著降低数据访问延迟。
水平扩展:缓存吞吐能力随计算节点规模线性扩展,支持数百至数千个节点规模。
RDMA大带宽加速:支持RDMA网络通信协议,在高并发数据读取场景下充分利用高速网络带宽,显著提升吞吐。
数据预热:在训练任务启动前,将指定数据主动加载到本地缓存,避免首轮训练冷启动延迟。
客户端流控:对DLC任务客户端读取带宽限速,防止单个任务占用过多存储带宽影响其他任务。
Serverless简单易用:一键开启和关闭,无需修改代码,对程序无侵入,无需关注运维。
适用场景与功能使用建议
本地缓存适用于数据集规模远大于单次读取量、需要反复遍历的多轮训练任务。RDMA加速、数据预热、客户端流控三项能力分别对应不同训练特征,可按需组合:
场景特征 | 建议开启的功能 | 预期效果 |
高并发数据读取(num_workers较大、batch_size较大) | 本地缓存 + RDMA加速 | 分布式缓存节点间通过RDMA协议传输数据,充分利用高速网络带宽,高并发场景下吞吐显著提升 |
对首轮延迟敏感,希望第一个Epoch即享受加速 | 本地缓存 + 数据预热 | 在任务启动前将数据提前加载到缓存,消除首轮冷启动延迟 |
多任务共享同一存储,需避免单个任务挤占带宽,或者避免RDMA缓存场景下访问缓存数据过多挤占分布式训练的RDMA带宽 | 本地缓存 + 客户端流控 | 为每个任务设定读取带宽上限,保障集群多任务并行稳定性 |
大规模视频/图像数据集的多Epoch训练 | 本地缓存 + RDMA + 数据预热 | 视频类数据集I/O压力大,RDMA提升吞吐,预热消除冷启动 |
数据集反复遍历、Epoch数较多的常规训练 | 本地缓存 | 首轮从存储读取并写入缓存,后续轮次直接从本地缓存读取,逐轮加速 |
若您的任务并发读取压力大,建议开启RDMA加速;若对首轮延迟敏感,建议配合使用数据预热;若集群中多任务共享存储,建议开启客户端流控进行带宽保护。
使用限制与说明
存储支持:支持OSS、智算CPFS。
适用资源:仅支持灵骏智算资源。开启后占用算力节点资源:挂载一个文件系统/OSS Bucket占用4核CPU、14 GB内存;每多挂载一个,额外占用1核CPU、2 GB内存。请在创建前预留资源。
RDMA资源占用:RDMA模式下挂载一个文件系统/OSS Bucket占用每个节点8核CPU、16 GB RAM;每多挂载一个,额外占用1核CPU、2 GB内存。节点需配备RDMA网卡,灵骏智算高规格节点默认支持。
容量与策略:最大缓存容量与灵骏智算规格相关,淘汰策略为LRU(最近最少使用)。
加速目标:仅加速数据读取,不支持写。
数据高可用性:不保证数据高可用。缓存数据可能丢失,重要训练数据请及时备份。
工作机制:多轮训练时,第一轮从存储实例(如OSS、智算CPFS)读取数据并写入缓存,性能略慢于直读存储。后续轮次直接从本地缓存读取,速度更快。配合数据预热可使第一轮也享受缓存加速。
使用方法
整体流程:开启Quota缓存配置 → 配置安全组入规则 → 创建DLC任务并开启缓存 → 按需配置RDMA/流控/预热。
步骤一:开启资源配额(Quota)本地缓存
在左侧导航栏单击资源配额(Quota) > 灵骏智算资源,找到并单击目标Quota名称进入管理页面。注意多级嵌套Quota仅一级Quota支持开启本地缓存功能。
切换至本地缓存页签,单击打开本地缓存加速,设置需要缓存的存储路径。缓存路径应指向训练数据所在的存储目录。
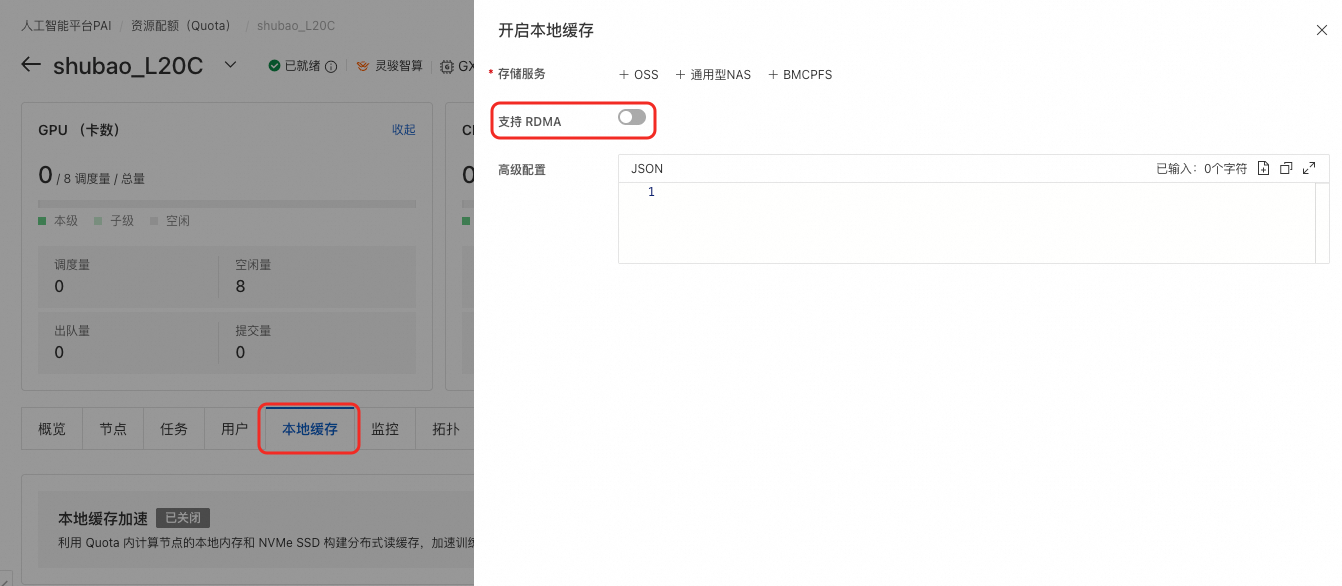
如需使用RDMA加速,在缓存配置页面中打开支持RDMA开关。
步骤二:安全组配置入规则
当安全组类型为企业级安全组时,需额外配置入规则,使缓存服务与VPC网络连通。
在资源配额页面网络信息区域查看配置的安全组,记录安全组名称或ID。
到对应安全组的页面,如果安全组类型为企业级,需要增加一项入方向的规则:
授权策略选择允许。
优先级设为1。
协议选择自定义TCP。
访问来源设置为IPv4类型,并填写本VPC的网段如:
10.0.0.0/8。访问目的选择端口放行 端口
10080/(10080+n-1),10070/(10070+n-1),n = 存储服务条目数(n ≤ 10)。示例:配了 4 个存储服务 → 放通10080/10083和10070/10073)。
访问来源配置为资源配额使用的交换机对应的网段。访问目的端口数需要与缓存配置的存储服务数相同。
步骤三:创建DLC任务并使用缓存
使用目标资源配额的灵骏资源创建DLC任务。
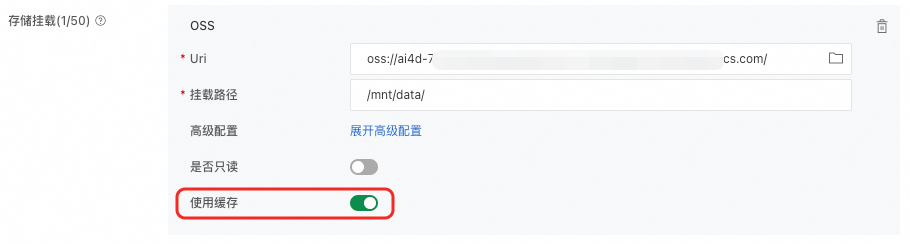
在配置 DLC 任务的存储挂载参数时,选择OSS挂载Uri及挂载路径(例如
/mnt/data/)。当挂载的存储地址命中已配置的缓存地址时,对应的使用缓存开关将自动开启(用户可选择关闭)。
步骤四:客户端流控配置(可选)
如需对DLC任务的客户端读取带宽进行限速,可在创建DLC任务时,在数据集的高级配置中添加mountOptions参数:
{
  "mountOptions": "-o g_tier_DadiSdkGetTrafficLimit=3221225472"
}
参数说明:
g_tier_DadiSdkGetTrafficLimit:客户端读取流控阈值,单位为B/s(字节/秒)。默认值为3221225472(即3 GB/s)。
常用流控值参考:
目标限速 | 配置值(B/s) |
1 GB/s | 1073741824 |
3 GB/s(默认) | 3221225472 |
4 GB/s | 4294967296 |
5 GB/s | 5368709120 |
步骤五:数据预热(可选)
训练任务启动前,可通过数据预热功能,将指定数据加载到本地缓存,避免首轮冷启动延迟。
控制台方式
创建预热任务
在本地缓存标签页滚动至数据预热区域,单击右上角+ 创建预热任务。
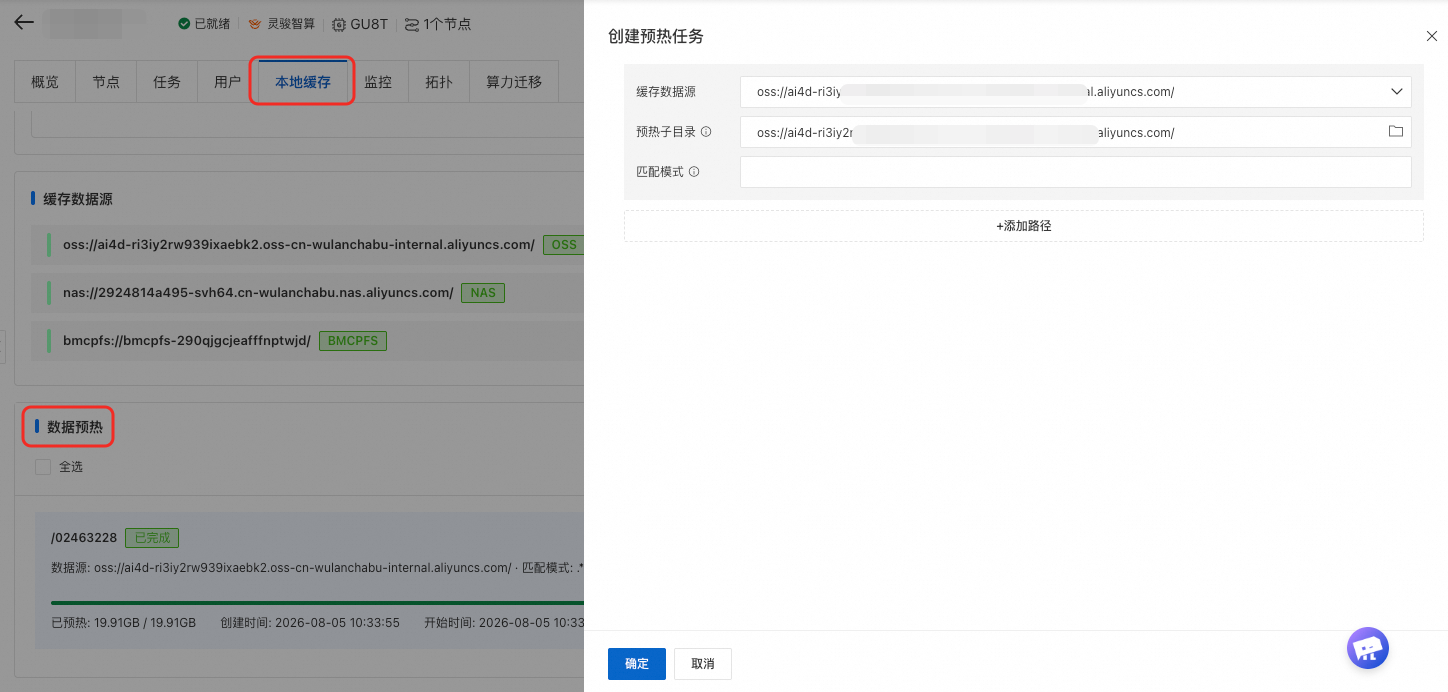
在创建对话框中,按需填写以下字段:
字段
是否必填
说明
建议
缓存数据源
是
下拉选择,仅能选择步骤一中已配置的存储实例。
训练任务读取哪个Bucket就选哪个。
预热子目录
否
在选中数据源下定位到具体子目录。可手动输入,或单击右侧文件夹图标浏览目录。留空则对整条数据源全量预热。
精确到数据集或Checkpoint子目录,降低无效流量。
匹配模式
否
相对于子目录的正则匹配,默认
.*即全匹配。例:只预热小图
.*\.jpg$。需要预热多个位置时,单击底部+ 添加路径追加一组配置;单击行首删除图标可移除。
单击确定提交。任务立即进入数据预热列表。
说明
每个缓存实例同一时刻只有一条预热任务在执行,多条任务按提交顺序FIFO排队,其余处于Creating排队状态。预热量不应超过缓存总容量,否则数据会被LRU淘汰策略互相驱逐。
查看预热进度
预热任务列表展示以下信息:预热ID、路径(数据源+子目录+匹配模式)、状态、创建时间、完成时间、匹配文件数/字节数、失败原因。
状态说明:
Creating:已提交,排队等待执行。
Running:正在将数据拉取到本地缓存。
Completed:预热完成,缓存已加载。
Cancelled:已主动取消。
Failed:预热失败,请查看失败原因(常见:路径不存在、匹配模式无匹配文件)。
取消或删除预热任务
状态为Creating或Running的任务,单击行末取消按钮即可终止。
Completed或Failed的历史记录仅供审计,可直接删除。
关闭本地缓存加速总开关会清空所有预热记录和缓存数据,操作前请确认无正在运行的训练任务依赖当前缓存。
API方式
确定预热端口
每个缓存配置项对应一个独立的预热端口,端口范围为10070~10079:
缓存序号 | 预热端口 |
第1个缓存 | 10070 |
第2个缓存 | 10071 |
第3个缓存 | 10072 |
发起数据预热
在同一Quota下的DSW或DLC实例中,执行以下命令发起预热:
预热API可在同一Quota下的DSW或DLC实例中直接调用(DSW实例默认具有所需角色权限)。
# 如果getDataCacheService 的response 中isShareded = true 则使用如下命令:
curl -s "http://<CacheServiceId>-svc-0.t<主账号id>.svc.cluster.local.<clusterId>.t<主账号id>:<Port>/v1/warmup/load?target_path=<path1>,<path2>&pattern=<glob_pattern>"

# 其余情况则使用如下命令:
curl -s "http://<CacheServiceId>.t<主账号id>.svc.cluster.local.<clusterId>.t<主账号id>:<Port>/v1/warmup/load?target_path=<path1>,<path2>&pattern=<glob_pattern>"
参数说明:
isShareded:在控制台Quota详情页的本地缓存页签,按F12进入检查页面,查看getDataCacheService接口的response,即可看到isShareded字段的值。CacheServiceId:通过GetQuota接口查询目标资源配额信息,从主Quota(第一级资源配额)的返回结果中获取CacheServiceId。主账号id:在控制台右上角,单击用户头像可查看主账号ID。clusterId:同isShareded,在getDataCacheService接口的response中可查看到该值。Port:第一步中确定的预热端口。target_path:需要预热的数据路径,支持多个路径以逗号分隔。必须为挂载目录下的相对路径。例如,若需预热BMCPFS上的/path1/path2,则target_path=path1/path2。pattern(可选):文件匹配模式,支持正则表达式。例如pattern=.*.txt表示仅预热.txt后缀的文件。
示例:
# 预热挂载目录下 dataset/train 中所有 .txt 文件
curl -s "http://cacheservice-xxxx:t10953*******.svc.cluster.local.ca076dea628***********.t10953*******:10070/v1/warmup/load?target_path=dataset/train&pattern=.*.txt"
查询预热状态
使用以下命令查询预热进度:
# 如果getDataCacheService 的response 中isShareded = true 则使用如下命令:
curl -s "http://<CacheServiceId>-svc-0.t<主账号id>.svc.cluster.local.<clusterId>.t<主账号id>:<Port>/v1/warmup/stat?target_path=<path1>,<path2>&preceding_time=<minutes>"

# 其余情况则使用如下命令:
curl -s "http://<CacheServiceId>.t<主账号id>.svc.cluster.local.<clusterId>.t<主账号id>:<Port>/v1/warmup/stat?target_path=<path1>,<path2>&preceding_time=<minutes>"
参数说明:
target_path:与预热请求中的路径一致。preceding_time:查询最近N分钟内的预热状态,单位为分钟。
示例:
# 查询最近 10 分钟内 dataset/train 的预热状态
curl -s "http://cacheservice-xxxx:t10953*******.svc.cluster.local.ca076dea628***********.t10953*******:10070/v1/warmup/stat?target_path=dataset/train&preceding_time=10"
注意事项
预热API仅可在与缓存服务同一Quota下的DSW或DLC实例中调用。
target_path必须使用挂载目录下的相对路径,不要使用绝对路径。如果存在多级嵌套的资源配额,请确认
CacheServiceId来自第一级资源配额(主Quota)。预热操作为异步执行,可通过
/v1/warmup/stat接口持续跟踪进度。
常见问题
Q:开启RDMA后第一个Epoch会有加速效果吗?
不开启数据预热时,第一个Epoch需从存储实例拉取数据并写入缓存,性能会略慢于直读存储。加速效果主要体现在后续Epoch的缓存命中阶段。RDMA模式下,即使首次拉取,网络传输效率也优于传统TCP,第一个Epoch可能有一定提升。如需确保首轮加速,建议配合数据预热。
Q:开启本地缓存会额外占用多少资源?
挂载一个文件系统/OSS Bucket时,标准模式占用每个节点4核CPU、14 GB内存;RDMA模式占用8核CPU、16 GB内存。每多挂载一个存储,额外占用1核CPU、2 GB内存。请在创建前预留资源。
Q:数据预热功能是否支持所有实例类型?
预热API可在同一Quota下的DSW或DLC实例中直接调用。DSW实例默认具有所需角色权限,无需额外配置。