本文介绍如何使用 AOQ SDK 接入 qwen-audio-3.1-asr-flash-streaming 实时语音识别模型,实现语音输入法功能。
方案概述
语音输入法的典型交互流程为:用户点击语音输入按钮后立即开始说话,识别结果实时回显到输入框。客户端核心实现要点如下:
- 点击即采集:用户点击按钮后立即启动音频采集并缓存 PCM 数据,同时异步申请连接凭证和建立连接。由于连接建立需要一定时间,而用户在此期间已经开始说话,因此需要先缓存再补发。
- 倍速补发追平:连接成功并收到模型就绪事件后,将缓存的音频以倍速发送给模型,追平后再切换为实时发送。
- Data 通道传输音频:qwen-audio-3.1-asr-flash-streaming 采用 Inference 协议(run-task / continue-task / finish-task)。当前场景需要先缓存音频再倍速补发,因此通过
sendDataMsg接口以 JSON 消息形式传输音频数据。AOQ 服务端已对 JSON 格式的音频消息做了封装,客户端发送 JSON 后服务端自动解析为二进制数据转发给模型。 - 中间结果与最终结果:模型持续返回识别结果,中间结果(
sentence_end: false)实时展示,最终结果(sentence_end: true)追加到输入框。
准备工作
前置条件
- 开通阿里云百炼,并按获取与配置 API Key获取 API Key。API Key 只保存在业务 AppServer,不要写入客户端代码或提交到代码仓库。
{endpoint}使用华北2(北京)的{WorkspaceId}.cn-beijing.maas.aliyuncs.com或新加坡的{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com,替换为实际业务空间 ID,并使用对应地域和业务空间的 API Key。- 从 SDK 下载获取最新版 AOQ Client SDK。
- 搭建业务 AppServer,并按 Token 鉴权实现服务端代理鉴权。每次建立新连接前,客户端都应从 AppServer 获取新的连接凭证。
导入 SDK
从 SDK 下载获取最新版 AOQ Client SDK 后,根据开发平台导入对应 SDK。后续客户端代码以 Android 为例,其他平台使用相同的接口设计和事件流程。
Android
-
将 Opus 插件中的
libPluginOpus.so按 ABI 放入app/src/main/jniLibs/armeabi-v7a/和app/src/main/jniLibs/arm64-v8a/,将AoqClientSdk-release.aar放入app/libs,并在app/build.gradle中配置依赖和 SDK 支持的 ABI:android { defaultConfig { minSdk 21 ndk { abiFilters 'armeabi-v7a', 'arm64-v8a' } } } dependencies { implementation fileTree(dir: 'libs', include: ['*.aar']) } -
在
AndroidManifest.xml中声明以下权限:<uses-permission android:name="android.permission.INTERNET" /> <uses-permission android:name="android.permission.ACCESS_NETWORK_STATE" /> <uses-permission android:name="android.permission.RECORD_AUDIO" /> <uses-permission android:name="android.permission.MODIFY_AUDIO_SETTINGS" /> -
在使用麦克风前动态申请
RECORD_AUDIO权限。
iOS
- 将
AoqClientSdk.framework与PluginOpus.framework拖入 Xcode 工程,在 Target > General > Frameworks, Libraries, and Embedded Content 中选择 Embed & Sign。SDK 支持 iOS 13.0 及以上 arm64 设备。 - 在 Info.plist 中添加
NSMicrophoneUsageDescription,并在使用麦克风前请求用户授权。 - Swift 工程使用
import AoqClientSdk;Objective-C 工程使用#import <AoqClientSdk/AoqClientSdk.h>。
HarmonyOS
-
将 Opus 插件中的
libPluginOpus.so放入entry/libs/arm64-v8a/,将AoqClientSdk.har放入entry/libs,并在entry/oh-package.json5中声明依赖。该 SDK 兼容 API 12,支持 arm64-v8a:{ "dependencies": { "@aoq/client-sdk": "file:./libs/AoqClientSdk.har" } } -
在
entry/src/main/module.json5中声明以下权限:"requestPermissions": [ { "name": "ohos.permission.INTERNET" }, { "name": "ohos.permission.MICROPHONE", "reason": "$string:perm_mic_reason", "usedScene": { "abilities": ["EntryAbility"], "when": "inuse" } } ] -
在使用麦克风前调用
abilityAccessCtrl.createAtManager().requestPermissionsFromUser申请ohos.permission.MICROPHONE。
Linux (Python)
-
解压 SDK,并保持
aoq_client_sdk.py、libAoqClientSdk.so和libonnxruntime.so.1.16.3位于同一目录。 -
将 SDK 目录加入 Python 和动态库搜索路径:
export PYTHONPATH="$PWD/AoqClientSdk:$PYTHONPATH" export LD_LIBRARY_PATH="$PWD/AoqClientSdk:$LD_LIBRARY_PATH" -
在 Python 代码中使用
import aoq_client_sdk。也可通过AOQ_CLIENT_SDK_LIB环境变量指定libAoqClientSdk.so的绝对路径。
AppServer 获取 Token
客户端通过 AppServer 获取连接凭证。按 Token 鉴权实现服务端代理鉴权,AppServer 调用百炼分配接口,返回 SDK 连接所需的 Token、SID、Relay 端点等信息。
curl -X POST \
  "https://{endpoint}/api/v1/webrtc/inference?model=qwen-audio-3.1-asr-flash-streaming" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${DASHSCOPE_API_KEY}" \
  -H "x-dashscope-rtc-transport: moq" \
  -d "{\"clientIp\": \"${CLIENT_REAL_IP}\"}"
| 响应字段 | SDK 字段 |
|---|---|
|
|
|
|
|
|
|
|
|
|
客户端实现流程
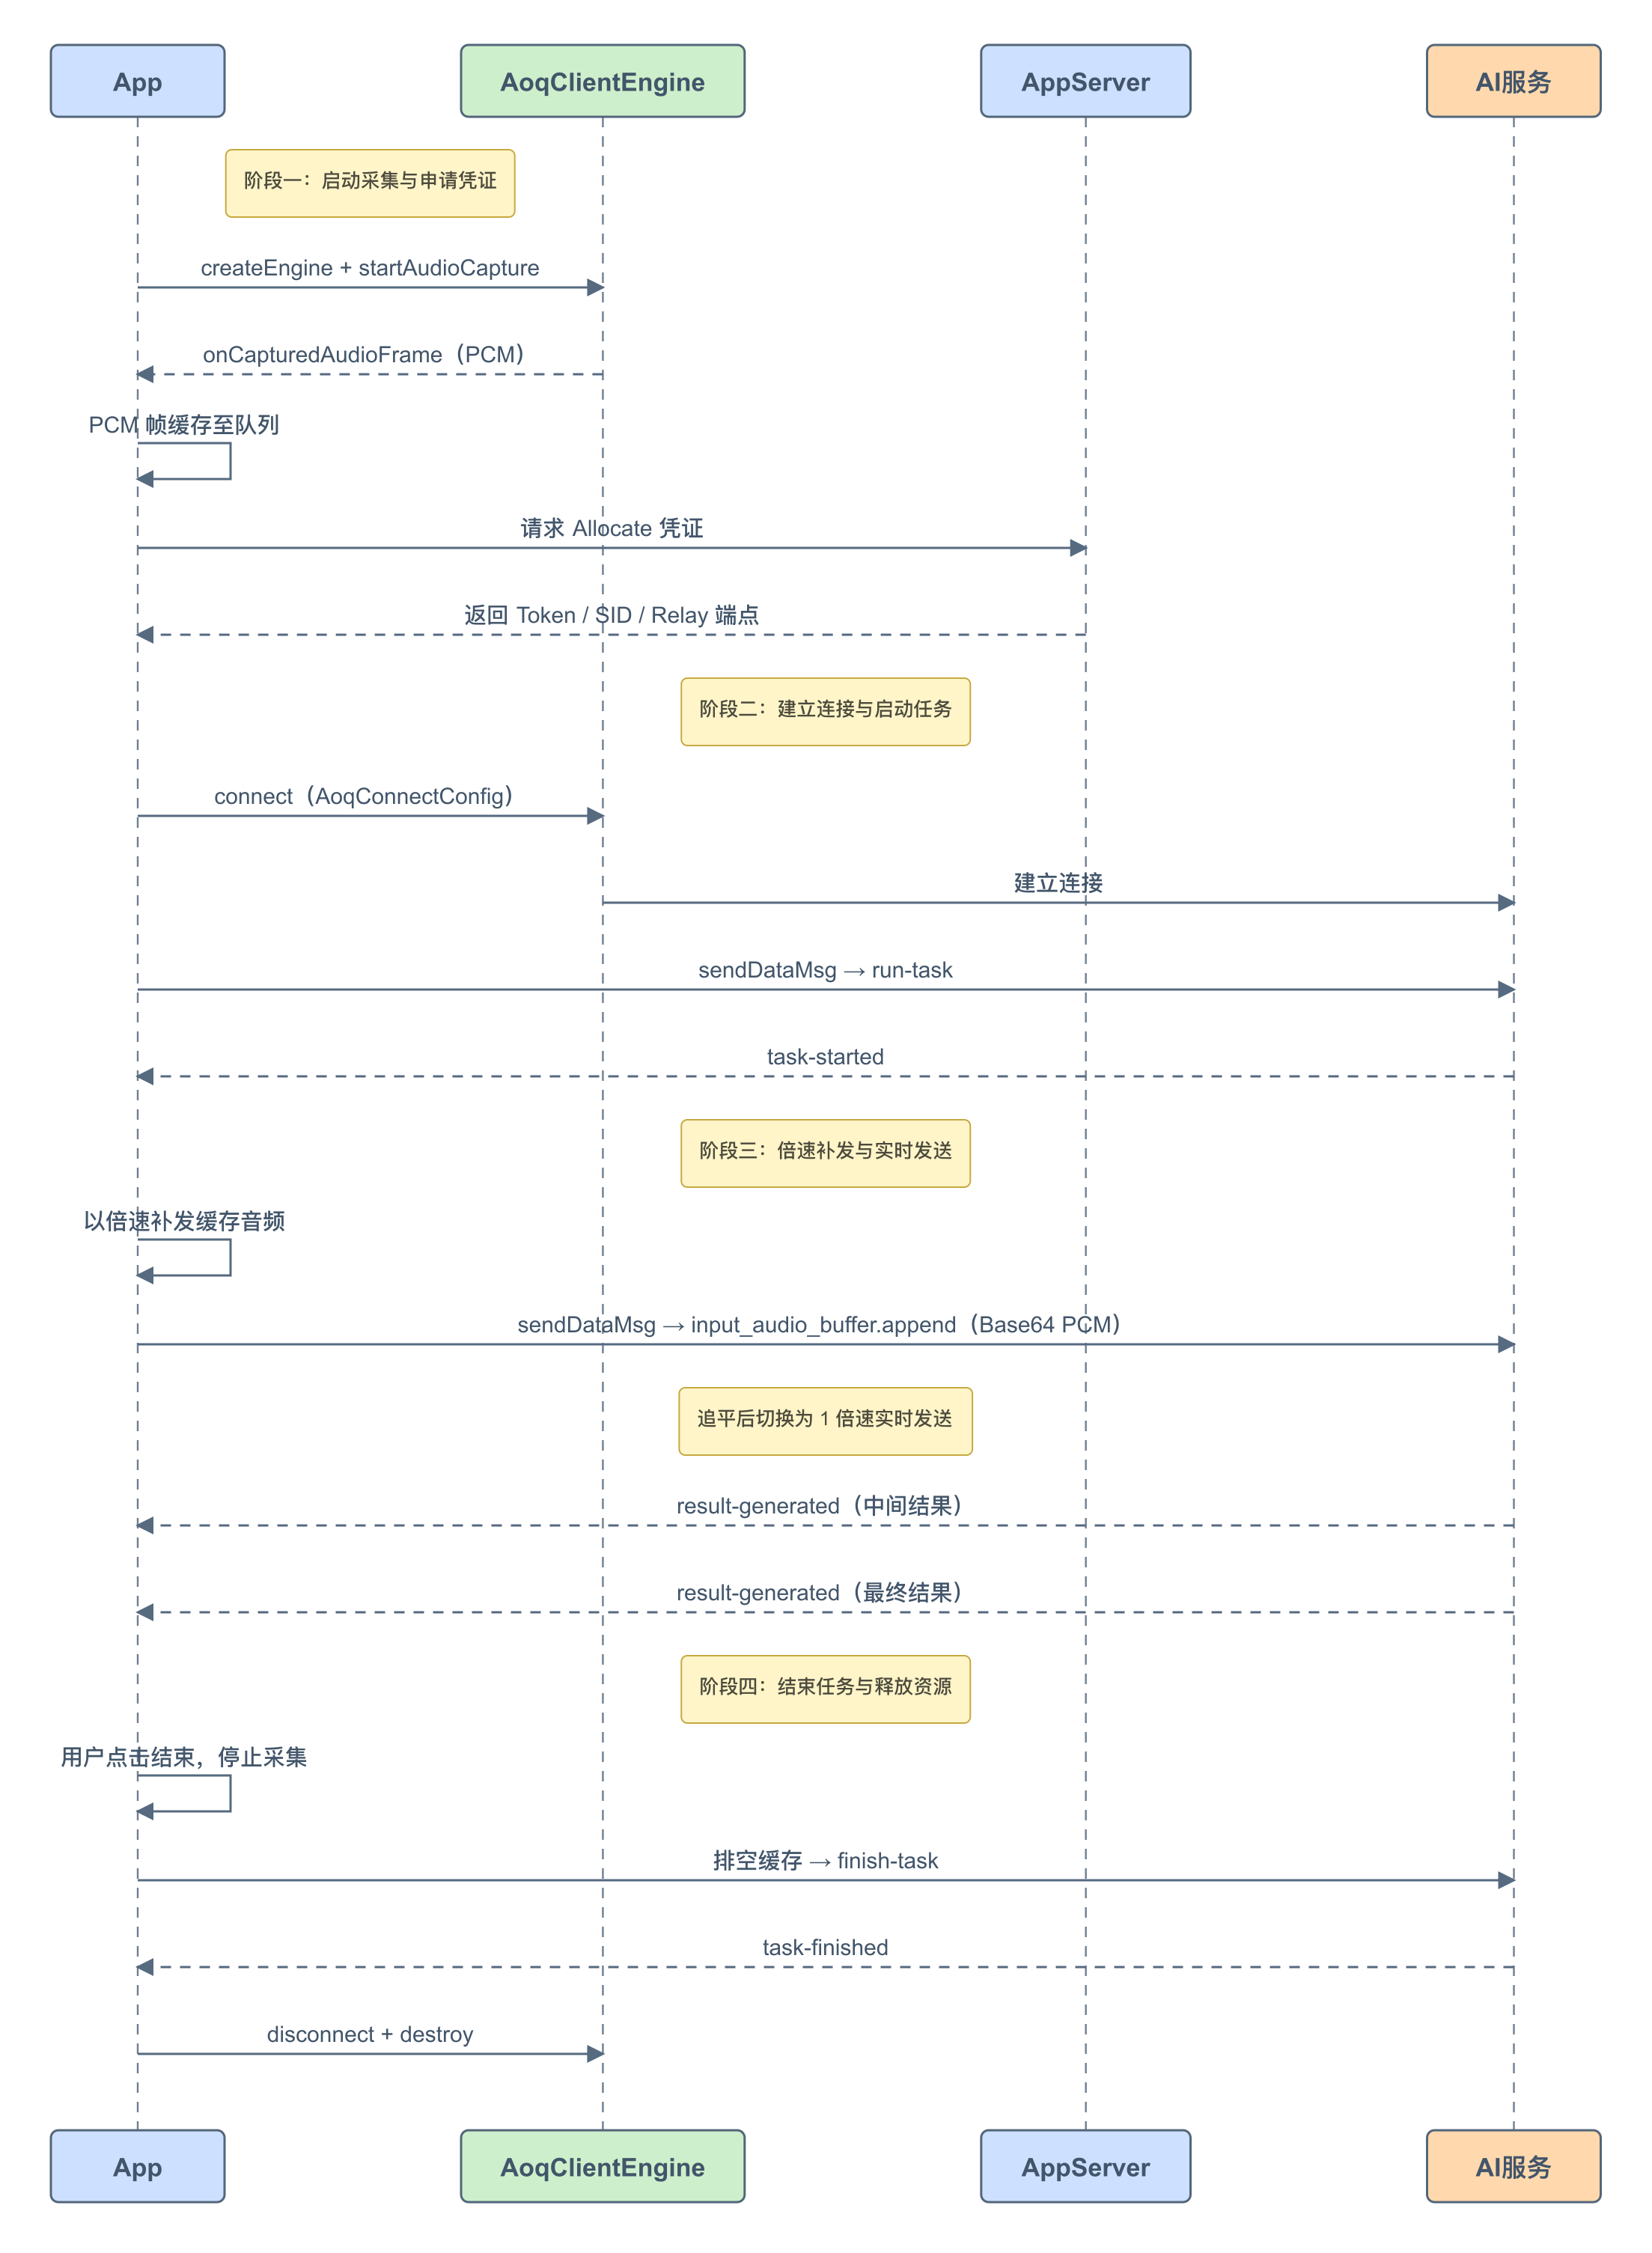
以下以 Android 为例,按实现顺序分步说明。其他平台使用相同的接口设计和事件流程。
1. 创建引擎并设置回调
创建 AoqClientEngine 实例,注册连接状态回调和 Data 消息回调。连接成功后发送 run-task,Data 消息回调负责处理服务端事件。
// 创建引擎
AoqClientEngine.AoqCreateConfig create = new AoqClientEngine.AoqCreateConfig();
create.workDir = getCacheDir().getAbsolutePath();
engine = AoqClientEngine.createEngine(this, create, new AoqClientListener() {
    @Override
    public void onConnectionStatusChange(
            @NonNull AoqClientEngine.AoqConnectionStatus state) {
        if (state == AoqClientEngine.AoqConnectionStatus.AoqConnectionStatusConnected) {
            // 连接成功,发送 run-task(见步骤 4)
        }
    }

    @Override
    public void onDataMsg(@NonNull AoqClientEngine.AoqDataMsg msg) {
        // 解析服务端事件(见步骤 5)
    }

    @Override
    public void onError(int code, String message) {
        // 错误处理
    }
});
2. 配置音频编码并启动采集
配置 PCM 编码(16 kHz、单声道),通过 setAudioFrameObserver 注册采集回调获取 PCM 数据,调用 enableSendMediaStream(Audio, false) 关闭音频媒体上行(音频通过 Data 通道发送),最后调用 startAudioCapture() 启动采集。
本文示例使用 AOQ SDK 内部采集,通过 onCapturedAudioFrame 回调获取 PCM 数据。也可以自行实现音频采集(如 Android 的 AudioRecord),只需将采集到的 PCM 数据放入缓存队列,后续的发送逻辑完全相同。
方式 A:使用 SDK 内部采集
本文代码示例调用 startAudioCapture,通过 onCapturedAudioFrame 获取 PCM,然后复制到应用缓存。应注册 AoqAudioSourceCaptured 原始采集回调,用于连接建立前的缓存。
int SAMPLE_RATE = 16000;

// 配置 PCM 编码
AoqClientEngine.AoqAudioCodecConfig codec = new AoqClientEngine.AoqAudioCodecConfig();
codec.codecType = AoqClientEngine.AoqEncoderType.AoqEncoderTypeAudioPCM;
codec.sampleRate = SAMPLE_RATE;
codec.channel = 1;
codec.bitrate = 256000;
engine.setAudioEncoderConfig(codec);

// 注册采集回调
engine.setAudioFrameObserver(new AoqClientListener.AoqAudioFrameListener() {
    @Override
    public void onCapturedAudioFrame(
            @NonNull AoqClientEngine.AoqAudioFrameData frame) {
        if (frame.dataPtr != null && frame.dataSize > 0) {
            // 将 PCM 数据缓存到队列(见步骤 5)
            pcmQueue.offer(frame.dataPtr, frame.dataSize);
        }
        Arrays.fill(frame.dataPtr, (byte) 0);  // 清零防止媒体上行
    }
});

AoqClientEngine.AoqAudioObserverConfig observer = new AoqClientEngine.AoqAudioObserverConfig();
observer.sampleRate = SAMPLE_RATE;
observer.channels = 1;
observer.mode = AoqClientEngine.AoqAudioObserverMode.AoqAudioObserverModeReadWrite;
engine.enableAudioFrameObserver(true,
        AoqClientEngine.AoqAudioSource.AoqAudioSourceCaptured, observer);

// 关闭音频媒体上行(音频通过 Data 通道发送)
engine.enableSendMediaStream(AoqClientEngine.AoqTrackType.AoqTrackTypeAudio, false);

// 启动采集(点击即采集,不等连接)
engine.startAudioCapture(new AoqClientEngine.AoqAudioCaptureConfig());
方式 B:业务自行采集
业务使用平台录音能力或已有音频采集组件,输出符合上述格式要求的 PCM,并写入同一个缓存队列。后续仍然通过 sendDataMsg 发送本文定义的音频 JSON,无需把 PCM 再送入 SDK 的采集接口。
两种方式选择其一,避免同时启动两套录音。自行采集时,业务负责格式转换、停止确认和音频设备释放。
3. 配置连接和传输轨道并建立连接
将 AppServer 返回的凭证填入 AoqConnectConfig,发布 Audio + Data 轨道,订阅 Data 轨道。Audio 轨道声明是连接所需的,但媒体上行已关闭,实际音频通过 Data 通道传输。
说明必须发布 Audio 轨道:ASR 模型要求连接时声明 Audio 轨道,否则连接会失败。但实际音频数据不通过音频媒体通道发送,而是通过 Data 通道以 input_audio_buffer.append 消息传输。因此需要在连接前调用 enableSendMediaStream(Audio, false) 关闭音频媒体上行,避免 SDK 自动发送采集到的音频。
// 从 AppServer 获取凭证后,构建连接配置
AoqClientEngine.AoqConnectConfig config = new AoqClientEngine.AoqConnectConfig();
config.token = aoqTokenForClient;
config.sid = sid;
config.certFingerprint = clientRelayCertFingerprint;
config.workspaceIdHash = workspaceIdHash;
// relayEndpoints 从响应解析后添加

// 发布 Audio + Data 轨道
AoqClientEngine.AoqTrackParam audioTrack = new AoqClientEngine.AoqTrackParam();
audioTrack.trackType = AoqClientEngine.AoqTrackType.AoqTrackTypeAudio;
config.publishTracks.add(audioTrack);

AoqClientEngine.AoqTrackParam dataTrack = new AoqClientEngine.AoqTrackParam();
dataTrack.trackType = AoqClientEngine.AoqTrackType.AoqTrackTypeData;
config.publishTracks.add(dataTrack);

// 订阅 Data 轨道
AoqClientEngine.AoqTrackParam subData = new AoqClientEngine.AoqTrackParam();
subData.trackType = AoqClientEngine.AoqTrackType.AoqTrackTypeData;
config.subscribeTracks.add(subData);

// 建立连接
engine.connect(config);
4. 发送 run-task 启动识别任务
连接成功后,每轮语音输入生成一个新的 task_id,例如使用 UUID.randomUUID().toString()。在连接成功回调中,通过 sendDataMsg 发送下列 JSON;同一轮只发送一次 run-task。
run-task 事件结构如下,任务 ID 为示例值,实际应替换为本轮新生成的值。具体事件请参考客户端事件。
{
  "header": {
    "action": "run-task",
    "task_id": "9fb212ea-6f83-4aef-9b8e-1bdd71f1d4d3",
    "streaming": "duplex"
  },
  "payload": {
    "task_group": "audio",
    "task": "asr",
    "function": "recognition",
    "model": "qwen-audio-3.1-asr-flash-streaming",
    "parameters": {
      "format": "pcm",
      "sample_rate": 16000
    },
    "input": {}
  }
}
控制消息和音频消息,通过同一个 sendDataMsg 接口发送:
String taskId = UUID.randomUUID().toString();
JSONObject root = new JSONObject()
        .put("header", new JSONObject()
                .put("action", "run-task")
                .put("task_id", taskId)
                .put("streaming", "duplex"))
        .put("payload", new JSONObject()
                .put("task_group", "audio")
                .put("task", "asr")
                .put("function", "recognition")
                .put("model", "qwen-audio-3.1-asr-flash-streaming")
                .put("parameters", new JSONObject()
                        .put("format", "pcm")
                        .put("sample_rate", 16000))
                .put("input", new JSONObject()));

AoqClientEngine.AoqDataMsg msg = new AoqClientEngine.AoqDataMsg();
msg.data = root.toString().getBytes(StandardCharsets.UTF_8);
engine.sendDataMsg(msg);
5. 收到 task-started 后倍速补发缓存音频
在 onDataMsg 中解析 JSON。收到当前任务的下列事件后,才将发送状态切换为就绪。
{
  "header": {
    "event": "task-started",
    "task_id": "9fb212ea-6f83-4aef-9b8e-1bdd71f1d4d3"
  },
  "payload": {}
}
以上为事件关键字段示例,其余响应字段可按业务需要读取,具体事件请参考服务端事件。此时音频缓存通常已经积累了“凭证申请 + AOQ 建连 + 模型任务启动”期间采集到的音频。对带有 task_id 的响应核对当前任务 ID;重复的 task-started 不应启动第二个发送循环。
音频数据封装格式: qwen-audio-3.1-asr-flash-streaming 的 Inference 协议(客户端事件)只定义了 run-task、continue-task、finish-task 三种控制事件,音频数据本身不是通过 JSON 事件发送的。但通过 AOQ Data 通道传输时,音频数据需要以 JSON 消息形式发送。为此,AOQ 在 SDK 层面封装了 input_audio_buffer.append 事件,用于承载音频数据:
| 字段 | 类型 | 说明 |
|---|---|---|
| string | 固定为 |
| string | 事件唯一标识,用于关联和去重 |
| string | Base64 编码的 PCM 音频数据 |
客户端将采集到的 PCM 数据编码为 Base64 后包装到此 JSON 中,通过 sendDataMsg 发送。AOQ 服务端收到此 JSON 后,解析 audio 字段为二进制 PCM 数据,按照模型协议转发给 ASR 模型。客户端无需关心二进制帧的封装细节,只需确保 PCM 格式(采样率、声道数、位深)与 run-task 中声明的 format 和 sample_rate 一致。
{
    "type": "input_audio_buffer.append",
    "event_id": "event_550e8400-e29b-41d4-a716-446655440000",
    "audio": "AQID//+AgAAEAACAAAAA..."
}
发送音频数据:
从缓存队列中取出 PCM 数据,包装为 input_audio_buffer.append JSON 后通过 sendDataMsg 发送:
byte[] pcm = pcmQueue.poll(640);  // 取出一帧 PCM 数据

if (pcm != null) {
    JSONObject event = new JSONObject()
            .put("type", "input_audio_buffer.append")
            .put("event_id", "event_" + UUID.randomUUID())
            .put("audio", Base64.encodeToString(pcm, Base64.NO_WRAP));

    AoqClientEngine.AoqDataMsg msg = new AoqClientEngine.AoqDataMsg();
    msg.data = event.toString().getBytes(StandardCharsets.UTF_8);
    engine.sendDataMsg(msg);
}
处理服务端事件:
在 onDataMsg 回调中解析服务端事件,收到 task-started 后启动音频发送,收到 result-generated 后解析识别结果,具体事件请参考服务端事件。
JSONObject root = new JSONObject(new String(msg.data, StandardCharsets.UTF_8));
String event = root.optJSONObject("header").optString("event");

if ("task-started".equals(event)) {
    // 模型就绪,启动音频发送(倍速补发缓存,追平后实时发送)
} else if ("result-generated".equals(event)) {
    // 解析识别结果(见步骤 6)
    JSONObject sentence = root.optJSONObject("payload")
            .optJSONObject("output").optJSONObject("sentence");
    if (sentence != null && !sentence.optBoolean("heartbeat")) {
        String text = sentence.optString("text", "");
        boolean isFinal = sentence.optBoolean("sentence_end");
        // 展示识别结果
    }
} else if ("task-finished".equals(event)) {
    // 任务完成
} else if ("task-failed".equals(event)) {
    // 任务失败
}
6. 处理识别结果并显示
result-generated 事件携带识别句子,包含 text、sentence_end 等字段。中间结果实时展示,最终结果追加到输入框。具体事件定义请参考服务端事件。
private void handleRecognitionResult(JSONObject root) {
    JSONObject payload = root.optJSONObject("payload");
    JSONObject output = payload == null ? null : payload.optJSONObject("output");
    JSONObject sentence = output == null ? null : output.optJSONObject("sentence");
    if (sentence == null || sentence.optBoolean("heartbeat")) return;

    String text = sentence.optString("text", "");
    if (text.isEmpty()) return;
    boolean isFinal = sentence.optBoolean("sentence_end");

    // 中间结果用于实时展示,最终结果用于追加
    listener.onResult(text, isFinal);
}
7. 发送 finish-task 结束识别任务
用户点击结束后,先调用 engine.stopAudioCapture() 停止采集,等待缓存中剩余的 PCM 数据排空后,发送 finish-task 通知服务端音频已发送完毕,具体事件定义请参考客户端事件。
说明task_id 必须与本轮 run-task 一致。
finish-task 事件结构如下:
{
    "header": {
        "action": "finish-task",
        "task_id": "UUID",
        "streaming": "duplex"
    },
    "payload": {
        "input": {}
    }
}
通过 sendDataMsg 发送:
engine.stopAudioCapture();  // 停止采集

// 等待缓存排空后发送 finish-task
JSONObject root = new JSONObject()
        .put("header", new JSONObject()
                .put("action", "finish-task")
                .put("task_id", taskId)
                .put("streaming", "duplex"))
        .put("payload", new JSONObject()
                .put("input", new JSONObject()));

AoqClientEngine.AoqDataMsg msg = new AoqClientEngine.AoqDataMsg();
msg.data = root.toString().getBytes(StandardCharsets.UTF_8);
engine.sendDataMsg(msg);
模型完成后返回的关键事件为:
{
  "header": {
    "event": "task-finished",
    "task_id": "9fb212ea-6f83-4aef-9b8e-1bdd71f1d4d3"
  },
  "payload": {}
}
8. 断开连接并销毁引擎
收到 task-finished 后,如果不再需要复用连接,按以下方式清理资源;发生异常或超时时也应清理资源。
engine.stopAudioCapture();
engine.setAudioFrameObserver(null);
engine.disconnect();
AoqClientEngine.destroy();
engine = null;
注意事项
- 必须收到
task-started后才能发送音频,否则数据会被丢弃。 finish-task必须在缓存排空(queue.size() == 0)后发送,确保最后一段音频被模型处理。- 收到
task-finished后不要立即断开连接,可复用同一连接发起新任务(新task_id)。 result-generated中的心跳包(heartbeat: true)应忽略,不作为识别结果。
典型场景
同一连接多次识别
收到 task-finished 后,连接仍然可用。客户端可以使用新的 task_id 再次发送 run-task,开始新一轮识别,无需重新建立连接。这适用于连续语音输入场景,减少重复连接的延迟。
// 第一轮识别结束后(收到 task-finished)
// 使用新的 task_id 发送 run-task,开始第二轮
taskId = UUID.randomUUID().toString();
sendRunTask();
自行实现音频采集
本文示例使用 AOQ SDK 的内部采集(startAudioCapture + onCapturedAudioFrame 回调),也可以自行实现音频采集。只需将采集到的 PCM 数据(16 kHz、单声道、16 位)放入 PcmQueue,后续的缓存补发和发送逻辑完全相同。