本文为您介绍如何通过实时计算Flink版、流式数据湖仓Paimon和分析型数据库StarRocks搭建流式湖仓。
背景信息
随着社会数字化发展,企业对数据时效性的需求越来越强烈。传统的离线数仓搭建方法论比较明确,通过定时调度离线作业的方式,将上一时段产生的新鲜变更并入分层的数仓中(ODS->DWD->DWS->ADS),但是存在延时长和成本高两大问题。离线作业的调度通常每小时甚至每天才进行一次,数据的消费者仅能看到上一小时甚至昨天的数据。同时,数据的更新多以覆写(overwrite)分区的方式进行,需要重新读取分区中原有的数据,才能与新鲜变更合并,产生新的结果数据。
基于实时计算Flink版和流式数据湖仓Paimon搭建流式湖仓可以解决上述传统离线数仓的问题。利用Flink的实时计算能力,数据可以在数仓分层之间实时流动。同时,利用Paimon高效的更新能力,数据变更可以在分钟级的延时内传递给下游消费者。因此,流式湖仓在延时和成本上具有双重优势。
关于流式数据湖仓Paimon的更多特性,请参见特色功能和Apache Paimon官方网站。
方案架构和优势
架构
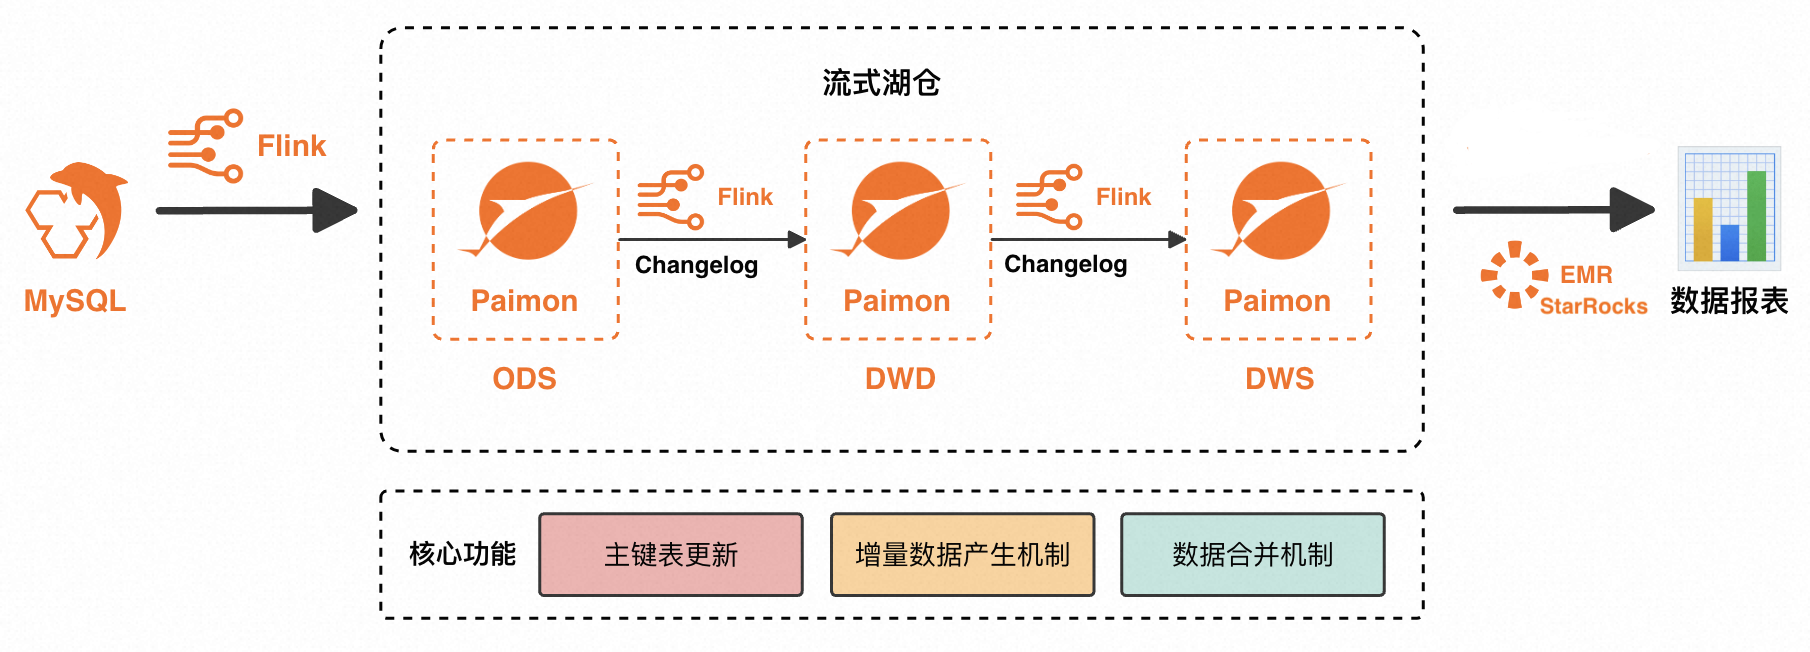
实时计算Flink版是强大的流式计算引擎,支持对海量实时数据高效处理。流式数据湖仓Paimon是流批统一的湖存储格式,支持高吞吐的更新和低延迟的查询。Paimon与Flink深度集成,能够提供一体化的流式湖仓联合解决方案。本文基于Flink+Paimon搭建流式湖仓的方案架构如下:
-
Flink将数据源写入Paimon,形成ODS层。
-
Flink订阅ODS层的变更数据(Changelog)进行加工,形成DWD层再次写入Paimon。
-
Flink订阅DWD层的Changelog进行加工,形成DWS层再次写入Paimon。
-
最后由开源大数据平台E-MapReduce的StarRocks读取Paimon外部表,对外提供应用查询。
优势
该方案有如下优势:
-
Paimon的每一层数据都可以在分钟级的延时内将变更传递给下游,将传统离线数仓的延时从小时级甚至天级降低至分钟级。
-
Paimon的每一层数据都可以直接接受变更数据,无需覆写分区,极大地降低了传统离线数仓数据更新与订正的成本,解决了中间层数据不易查、不易更新、不易修正的问题。
-
模型统一,架构简化。ETL链路的逻辑是基于Flink SQL实现的;ODS层、DWD层和DWS层的数据统一存储在Paimon中,可以降低架构复杂度,提高数据处理效率。
该方案依赖于Paimon的三个核心能力,详情如下表所示。
|
Paimon核心能力 |
详情 |
|
主键表更新 |
Paimon底层使用LSM Tree数据结构,可以实现高效的数据更新。 关于Paimon主键表、Paimon底层数据结构的介绍请参见Primary Key Table和File Layouts。 |
|
增量数据产生机制(Changelog Producer) |
Paimon可以为任意输入数据流产生完整的增量数据(所有的update_after数据都有对应的update_before数据),保证数据变更可以完整地传递给下游。详情请参见增量数据产生机制。 |
|
数据合并机制(Merge Engine) |
当Paimon主键表收到多条具有相同主键的数据时,为了保持主键的唯一性,Paimon结果表会将这些数据合并成一条数据。Paimon支持去重、部分更新、预聚合等丰富多样的数据合并行为,详情请参见数据合并机制。 |
实践场景
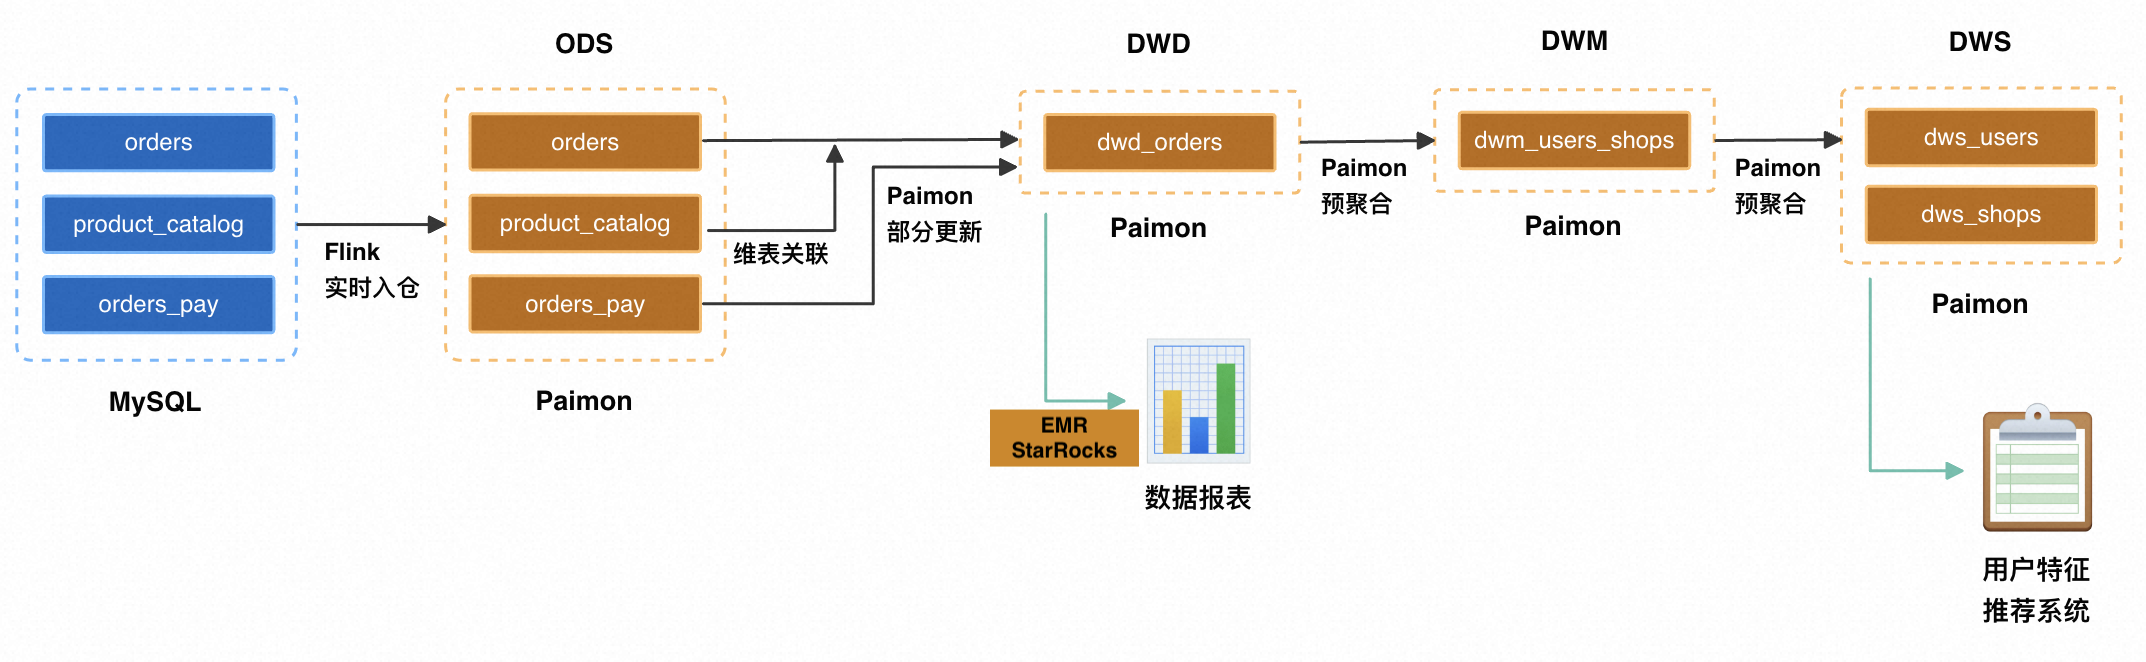
本文以某个电商平台为例,通过搭建一套流式湖仓,实现数据的加工清洗,并支持上层应用对数据的查询。流式湖仓实现了数据的分层和复用,并支撑各个业务方的报表查询(交易大屏、行为数据分析、用户画像标签)以及个性化推荐等多个业务场景。
-
构建ODS层:业务数据库实时入仓
MySQL有orders(订单表),orders_pay(订单支付表)和product_catalog(商品类别字典表)三张业务表,这三张表通过Flink实时写入OSS,并以Paimon格式进行存储,作为ODS层。 -
构建DWD层:主题宽表
将订单表、商品类别字典表、订单支付表利用Paimon的部分更新(partial-update)合并机制进行打宽,以分钟级延时生成DWD层宽表并产出变更数据(Changelog)。 -
构建DWS层:指标计算
Flink实时消费宽表的变更数据,利用Paimon的预聚合(aggregation)合并机制产出DWM层dwm_users_shops(用户-商户聚合中间表),并最终产出DWS层dws_users(用户聚合指标表)以及dws_shops(商户聚合指标表)。
前提条件
-
已开通数据湖构建,推荐使用DLF 2.5提供作为存储服务,详情请参见快速使用DLF。
-
已开通Flink全托管,详情请参见开通实时计算Flink版。
-
已开通EMR的StarRocks,详情请参见快速使用存算分离版实例。
StarRocks实例、DLF需要与Flink工作空间处于相同地域。
使用限制
仅实时计算引擎VVR 11.1.0及以上版本支持该流式湖仓方案。
构建流式湖仓
准备MySQL CDC数据源
本文以云数据库RDS MySQL版为例,创建数据库名称为order_dw,并创建三张业务表及数据。
-
重要
RDS MySQL版实例需要与Flink工作空间处于同一VPC。不在同一VPC下时请参见如何访问跨VPC的其他服务?
-
创建名称为order_dw的数据库,并创建高权限账号或具有数据库order_dw读写权限的普通账号。
创建三张表,并插入相应数据。
CREATE TABLE `orders` (
  order_id bigint not null primary key,
  user_id varchar(50) not null,
  shop_id bigint not null,
  product_id bigint not null,
  buy_fee bigint not null,
  create_time timestamp not null,
  update_time timestamp not null default now(),
  state int not null
);
CREATE TABLE `orders_pay` (
  pay_id bigint not null primary key,
  order_id bigint not null,
  pay_platform int not null,
  create_time timestamp not null
);
CREATE TABLE `product_catalog` (
  product_id bigint not null primary key,
  catalog_name varchar(50) not null
);
-- 准备数据
INSERT INTO product_catalog VALUES(1, 'phone_aaa'),(2, 'phone_bbb'),(3, 'phone_ccc'),(4, 'phone_ddd'),(5, 'phone_eee');
INSERT INTO orders VALUES
(100001, 'user_001', 12345, 1, 5000, '2023-02-15 16:40:56', '2023-02-15 18:42:56', 1),
(100002, 'user_002', 12346, 2, 4000, '2023-02-15 15:40:56', '2023-02-15 18:42:56', 1),
(100003, 'user_003', 12347, 3, 3000, '2023-02-15 14:40:56', '2023-02-15 18:42:56', 1),
(100004, 'user_001', 12347, 4, 2000, '2023-02-15 13:40:56', '2023-02-15 18:42:56', 1),
(100005, 'user_002', 12348, 5, 1000, '2023-02-15 12:40:56', '2023-02-15 18:42:56', 1),
(100006, 'user_001', 12348, 1, 1000, '2023-02-15 11:40:56', '2023-02-15 18:42:56', 1),
(100007, 'user_003', 12347, 4, 2000, '2023-02-15 10:40:56', '2023-02-15 18:42:56', 1);
INSERT INTO orders_pay VALUES
(2001, 100001, 1, '2023-02-15 17:40:56'),
(2002, 100002, 1, '2023-02-15 17:40:56'),
(2003, 100003, 0, '2023-02-15 17:40:56'),
(2004, 100004, 0, '2023-02-15 17:40:56'),
(2005, 100005, 0, '2023-02-15 18:40:56'),
(2006, 100006, 0, '2023-02-15 18:40:56'),
(2007, 100007, 0, '2023-02-15 18:40:56');
管理元数据
创建Paimon Catalog
-
登录实时计算控制台。
-
在左侧导航栏,选择元数据管理页面,单击创建Catalog。
-
在内置Catalog页签,单击Apache Paimon,单击下一步。
-
填写以下参数,选择DLF作为存储类型,单击确定。
配置项
说明
是否必填
备注
metastore
元数据存储类型。
是
此示例选择为dlf存储类型。
catalog name
DLF数据目录名称。
重要使用RAM用户或角色时,请确保拥有DLF数据读写权限,详情请参见数据授权管理。
是
推荐使用DLF 2.5,无需您再填写AccessKey等信息,支持快速选择已创建的DLF数据目录,创建数据目录操作请参见数据目录。
通过新建数据目录操作创建paimoncatalog后,选择名称为paimoncatalog的数据目录。
-
在数据目录下创建相应的order_dw数据库,以便后续同步MySQL中order_dw库下所有表的数据。
在左侧导航栏,选择,单击新建一个临时查询。
-- 使用paimoncatalog数据源
USE CATALOG paimoncatalog;
-- 新建order_dw数据库
CREATE DATABASE order_dw;
返回
The following statement has been executed successfully!表示创建库成功。
关于Paimon Catalog的更多使用方法详情请参见管理Paimon Catalog。
创建MySQL Catalog
-
在元数据管理页面,单击创建Catalog。
-
在内置Catalog页签,单击MySQL,单击下一步。
-
填写以下参数,单击确定,新建名为mysqlcatalog的MySQL Catalog。
配置项
说明
是否必填
备注
catalog name
Catalog名称。
是
填写为自定义的英文名。本文以mysqlcatalog为例。
hostname
MySQL数据库的IP地址或者Hostname。
是
详情请参见查看和管理实例连接地址和端口。由于RDS MySQL版实例和Flink全托管处于相同VPC,此处应填写内网地址。
port
MySQL数据库服务的端口号,默认值为3306。
否
详情请参见查看和管理实例连接地址和端口。
default-database
默认的MySQL数据库名称。
是
本文填写需要同步的数据库名order_dw。
username
MySQL数据库服务的用户名。
是
本文为准备MySQL CDC数据源中创建的账号。
password
MySQL数据库服务的密码。
是
本文为准备MySQL CDC数据源中创建的密码。
构建ODS层:业务数据库实时入仓
基于Flink CDC,通过数据摄入YAML作业实现MySQL数据同步至Paimon,一次性将ODS层构建出来。
-
创建并启动数据摄入YAML同步作业。
-
在实时计算控制台的页面,新建名为ods的YAML空白草稿作业。
-
将如下代码复制到编辑器,注意修改相应的用户名和密码等参数。
source:
  type: mysql
  name: MySQL Source
  hostname: rm-bp1e********566g.mysql.rds.aliyuncs.com
  port: 3306
  username: ${secret_values.username}
  password: ${secret_values.password}
  tables: order_dw.\.*  # 支持正则表达,读取order_dw库下所有的表
  #(可选)同步增量阶段新创建的表的数据
  scan.binlog.newly-added-table.enabled: true
  #(可选)同步表注释和字段注释
  include-comments.enabled: true
  #(可选)优先分发无界的分片以避免可能出现的TaskManager OutOfMemory问题
  scan.incremental.snapshot.unbounded-chunk-first.enabled: true
  #(可选)开启解析过滤,加速读取
  scan.only.deserialize.captured.tables.changelog.enabled: true
sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: rest
  catalog.properties.uri: http://cn-beijing-vpc.dlf.aliyuncs.com
  catalog.properties.warehouse: paimoncatalog
  catalog.properties.token.provider: dlf
pipeline:
  name: MySQL to Paimon Pipeline
配置项
描述
是否必填
示例
catalog.properties.metastoreMetastore类型,固定为rest。
是
rest
catalog.properties.token.providerToken提供方,固定为dlf。
是
dlf
catalog.properties.uri访问DLF Rest Catalog Server的URI,格式为
http://[region-id]-vpc.dlf.aliyuncs.com。详见服务接入点中的Region ID。是
http://cn-beijing-vpc.dlf.aliyuncs.com
catalog.properties.warehouseDLF Catalog名称。
是
paimoncatalog
hostnameMySQL数据库的IP地址或者Hostname。详情请参见查看和管理实例连接地址和端口。由于RDS MySQL版实例和Flink全托管处于相同VPC,此处应填写内网地址。
是
rm-bp1e********566g.mysql.rds.aliyuncs.com
usernameMySQL数据库用户名。建议使用密钥管理,详情请参见变量管理。
是
${secret_values.username}
passwordMySQL数据库密码。建议使用密钥管理,详情请参见变量管理。
是
${secret_values.password}
Paimon写入性能优化请参见Paimon性能优化。
-
单击右上方的部署。
-
在,单击刚刚部署的ods作业操作列的启动,选择无状态启动启动作业。作业启动配置详情请参见作业启动。
-
-
查看MySQL同步到Paimon的三张表的数据。
在实时计算控制台的页面的查询脚本页签,将如下代码拷贝到查询脚本后,选中目标片段后单击右上角的运行。
SELECT * FROM paimoncatalog.order_dw.orders ORDER BY order_id;执行查询后,返回 orders 表中的 7 条订单记录,包含 order_id(100001~100007)、user_id、shop_id、product_id、buy_fee(1000~5000)、create_time、update_time 和 state 列,state 值均为 1。
构建DWD层:主题宽表
-
创建DWD层Paimon宽表dwd_orders
在实时计算控制台的页面的查询脚本页签,将如下代码拷贝到查询脚本后,选中目标片段后单击右上角的运行。
CREATE TABLE paimoncatalog.order_dw.dwd_orders (
    order_id BIGINT,
    order_user_id STRING,
    order_shop_id BIGINT,
    order_product_id BIGINT,
    order_product_catalog_name STRING,
    order_fee BIGINT,
    order_create_time TIMESTAMP,
    order_update_time TIMESTAMP,
    order_state INT,
    pay_id BIGINT,
    pay_platform INT COMMENT 'platform 0: phone, 1: pc',
    pay_create_time TIMESTAMP,
    PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
    'merge-engine' = 'partial-update', -- 使用部分更新数据合并机制产生宽表
    'changelog-producer' = 'lookup' -- 使用lookup增量数据产生机制以低延时产出变更数据
);
返回
The following statement has been executed successfully!表示创建成功。 -
实时消费ODS层orders、orders_pay表的变更数据
在实时计算控制台的页面,新建名为dwd的SQL流作业,并将如下代码复制到SQL编辑器后,部署作业并无状态启动作业。
通过该SQL作业,orders表会与product_catalog表进行维表关联,关联后的结果将与orders_pay一起写入dwd_orders表中,利用Paimon表的部分更新数据合并机制,将orders表和orders_pay表中order_id相同的数据进行打宽。
SET 'execution.checkpointing.max-concurrent-checkpoints' = '3'; SET 'table.exec.sink.upsert-materialize' = 'NONE'; SET 'execution.checkpointing.interval' = '10s'; SET 'execution.checkpointing.min-pause' = '10s'; -- Paimon目前暂不支持在同一个作业里通过多条INSERT语句写入同一张表,因此这里使用UNION ALL。 INSERT INTO paimoncatalog.order_dw.dwd_orders SELECT o.order_id, o.user_id, o.shop_id, o.product_id, dim.catalog_name, o.buy_fee, o.create_time, o.update_time, o.state, NULL, NULL, NULL FROM paimoncatalog.order_dw.orders o LEFT JOIN paimoncatalog.order_dw.product_catalog FOR SYSTEM_TIME AS OF proctime() AS dim ON o.product_id = dim.product_id UNION ALL SELECT order_id, NULL, NULL, NULL, NULL, NULL, NULL, NULL, NULL, pay_id, pay_platform, create_time FROM paimoncatalog.order_dw.orders_pay; -
查看宽表dwd_orders的数据
在实时计算控制台的页面的查询脚本页签,将如下代码拷贝到查询脚本后,选中目标片段后单击右上角的运行。
SELECT * FROM paimoncatalog.order_dw.dwd_orders ORDER BY order_id;执行成功后,返回
dwd_orders宽表的 7 条订单记录,包含order_id、order_user_id、order_shop_id、order_product_id、order_product_catalog_name、order_fee、order_create_time、order_update_time共 8 个字段,order_id范围为 100001~100007,订单金额从 1000 到 5000,创建时间均为 2023-02-15。
构建DWS层:指标计算
-
创建DWS层的聚合表dws_users以及dws_shops
在实时计算控制台的页面的查询脚本页签,将如下代码拷贝到查询脚本后,选中目标片段后单击右上角的运行。
-- 用户维度聚合指标表。
CREATE TABLE paimoncatalog.order_dw.dws_users (
    user_id STRING,
    ds STRING,
    paid_buy_fee_sum BIGINT COMMENT '当日完成支付的总金额',
    PRIMARY KEY (user_id, ds) NOT ENFORCED
) WITH (
    'merge-engine' = 'aggregation', -- 使用预聚合数据合并机制产生聚合表
    'fields.paid_buy_fee_sum.aggregate-function' = 'sum' -- 对 paid_buy_fee_sum 的数据求和产生聚合结果
    -- 由于dws_users表不再被下游流式消费,因此无需指定增量数据产生机制
);
-- 商户维度聚合指标表。
CREATE TABLE paimoncatalog.order_dw.dws_shops (
    shop_id BIGINT,
    ds STRING,
    paid_buy_fee_sum BIGINT COMMENT '当日完成支付总金额',
    uv BIGINT COMMENT '当日不同购买用户总人数',
    pv BIGINT COMMENT '当日购买用户总人次',
    PRIMARY KEY (shop_id, ds) NOT ENFORCED
) WITH (
    'merge-engine' = 'aggregation', -- 使用预聚合数据合并机制产生聚合表
    'fields.paid_buy_fee_sum.aggregate-function' = 'sum', -- 对 paid_buy_fee_sum 的数据求和产生聚合结果
    'fields.uv.aggregate-function' = 'sum', -- 对 uv 的数据求和产生聚合结果
    'fields.pv.aggregate-function' = 'sum' -- 对 pv 的数据求和产生聚合结果
    -- 由于dws_shops表不再被下游流式消费,因此无需指定增量数据产生机制
);
-- 为了同时计算用户视角的聚合表以及商户视角的聚合表,另外创建一个以用户 + 商户为主键的中间表。
CREATE TABLE paimoncatalog.order_dw.dwm_users_shops (
    user_id STRING,
    shop_id BIGINT,
    ds STRING,
    paid_buy_fee_sum BIGINT COMMENT '当日用户在商户完成支付的总金额',
    pv BIGINT COMMENT '当日用户在商户购买的次数',
    PRIMARY KEY (user_id, shop_id, ds) NOT ENFORCED
) WITH (
    'merge-engine' = 'aggregation', -- 使用预聚合数据合并机制产生聚合表
    'fields.paid_buy_fee_sum.aggregate-function' = 'sum', -- 对 paid_buy_fee_sum 的数据求和产生聚合结果
    'fields.pv.aggregate-function' = 'sum', -- 对 pv 的数据求和产生聚合结果
    'changelog-producer' = 'lookup', -- 使用lookup增量数据产生机制以低延时产出变更数据
    -- dwm层的中间表一般不直接提供上层应用查询,因此可以针对写入性能进行优化。
    'file.format' = 'avro', -- 使用avro行存格式的写入性能更加高效。
    'metadata.stats-mode' = 'none' -- 放弃统计信息会增加OLAP查询代价(对持续的流处理无影响),但会让写入性能更加高效。
);
返回
The following statement has been executed successfully!表示创建成功。 -
DWD层dwd_orders表的变更数据
在实时计算控制台页签,新建名为dwm的SQL流作业,并将如下代码复制到SQL编辑器后,部署作业并无状态启动作业。
通过该SQL作业,dwd_orders表的数据会写入dwm_users_shops表中,利用Paimon表的预聚合数据合并机制,自动对order_fee求和,算出用户在商户的消费总额。同时,自动对1求和,也能算出用户在商户的消费次数。
SET 'execution.checkpointing.max-concurrent-checkpoints' = '3'; SET 'table.exec.sink.upsert-materialize' = 'NONE'; SET 'execution.checkpointing.interval' = '10s'; SET 'execution.checkpointing.min-pause' = '10s'; INSERT INTO paimoncatalog.order_dw.dwm_users_shops SELECT order_user_id, order_shop_id, DATE_FORMAT (pay_create_time, 'yyyyMMdd') as ds, order_fee, 1 -- 一条输入记录代表一次消费 FROM paimoncatalog.order_dw.dwd_orders WHERE pay_id IS NOT NULL AND order_fee IS NOT NULL; -
实时消费DWM层dwm_users_shops表的变更数据
在实时计算控制台的页面,新建名为dws的SQL流作业,并将如下代码复制到SQL编辑器后,部署作业并无状态启动作业。
通过该SQL作业,dwm_users_shops表的数据会写入dws_users表和dws_shops表中,利用Paimon表的预聚合数据合并机制,在dws_users表中,计算每个用户的总消费额(paid_buy_fee_sum),在dws_shops表中计算商户的总流水(paid_buy_fee_sum),商户的消费用户数量(对1求和)和消费总人次(pv)。
SET 'execution.checkpointing.max-concurrent-checkpoints' = '3'; SET 'table.exec.sink.upsert-materialize' = 'NONE'; SET 'execution.checkpointing.interval' = '10s'; SET 'execution.checkpointing.min-pause' = '10s'; -- 与dwd不同,此处每一条INSERT语句写入的是不同的Paimon表,可以放在同一个作业中。 BEGIN STATEMENT SET; INSERT INTO paimoncatalog.order_dw.dws_users SELECT user_id, ds, paid_buy_fee_sum FROM paimoncatalog.order_dw.dwm_users_shops; -- 以商户为主键,部分热门商户的数据量可能远高于其他商户。 -- 因此使用local merge在写入Paimon之前先在内存中进行预聚合,缓解数据倾斜问题。 INSERT INTO paimoncatalog.order_dw.dws_shops /*+ OPTIONS('local-merge-buffer-size' = '64mb') */ SELECT shop_id, ds, paid_buy_fee_sum, 1, -- 一条输入记录代表一名用户在该商户的所有消费 pv FROM paimoncatalog.order_dw.dwm_users_shops; END; -
查看dws_users表和dws_shops表的数据
在实时计算控制台的页面的查询脚本页签,将如下代码拷贝到查询脚本后,选中目标片段后单击右上角的运行。
--查看dws_users表数据 SELECT * FROM paimoncatalog.order_dw.dws_users ORDER BY user_id;执行查询后,dws_users 表返回三条记录,包含
user_id、ds、payed_buy_fee_sum三列:user_001对应 8,000.00,user_002对应 5,000.00,user_003对应 5,000.00,日期均为 20230215。--查看dws_shops表数据 SELECT * FROM paimoncatalog.order_dw.dws_shops ORDER BY shop_id;执行 dws_shops 表查询后,结果包含
shop_id、ds、payed_buy_fee_sum、uv、pv共 5 列,返回 4 行数据(shop_id 为 12345~12348,ds 均为 20230215,payed_buy_fee_sum 分别为 5000.00、4000.00、7000.00、2000.00,uv 分别为 1、1、2、2,pv 分别为 1、1、3、2)。
捕捉业务数据库的变化
前面已完成了流式湖仓的构建,下面将测试流式湖仓捕捉业务数据库变化的能力。
-
向MySQL的order_dw数据库中插入如下数据。
INSERT INTO orders VALUES (100008, 'user_001', 12345, 3, 3000, '2023-02-15 17:40:56', '2023-02-15 18:42:56', 1), (100009, 'user_002', 12348, 4, 1000, '2023-02-15 18:40:56', '2023-02-15 19:42:56', 1), (100010, 'user_003', 12348, 2, 2000, '2023-02-15 19:40:56', '2023-02-15 20:42:56', 1); INSERT INTO orders_pay VALUES (2008, 100008, 1, '2023-02-15 18:40:56'), (2009, 100009, 1, '2023-02-15 19:40:56'), (2010, 100010, 0, '2023-02-15 20:40:56'); -
查看dws_users表和dws_shops表的数据。 在实时计算控制台的页面的查询脚本页签,将如下代码拷贝到查询脚本后,选中目标片段后单击右上角的运行。
-
dws_users表
SELECT * FROM paimoncatalog.order_dw.dws_users ORDER BY user_id;查询返回三行数据,包含
user_id、ds、payed_buy_fee_sum三列:user_001/ 20230215 / 11,000.00,user_002/ 20230215 / 6,000.00,user_003/ 20230215 / 7,000.00。 -
dws_shops表
SELECT * FROM paimoncatalog.order_dw.dws_shops ORDER BY shop_id;查询结果包含 5 列:
shop_id、ds、payed_buy_fee_sum、uv、pv,共 4 行数据。shop_id 分别为 12345、12346、12347、12348,ds 均为 20230215,payed_buy_fee_sum 分别为 8000.00、4000.00、7000.00、5000.00,uv 分别为 1、1、2、3,pv 分别为 2、1、3、4。
-
使用流式湖仓
上一小节展示了在Flink中进行Paimon Catalog的创建与Paimon表的写入。本节展示流式湖仓搭建完成后,利用StarRocks进行数据分析的一些简单应用场景。
连接StarRocks与DLF
详情请参见Serverless StarRocks访问DLF。
排名查询
对DWS层聚合表进行分析。本文使用StarRocks查询23年2月15日交易额前三高的商户的代码示例如下。
SELECT ROW_NUMBER() OVER (ORDER BY paid_buy_fee_sum DESC) AS rn, shop_id, paid_buy_fee_sum
FROM paimoncatalog.order_dw.dws_shops
WHERE ds = '20230215'
ORDER BY rn LIMIT 3;
查询结果返回 3 行数据:rn=1 对应 shop_id=12345、payed_buy_fee_sum=8000.00;rn=2 对应 shop_id=12347、payed_buy_fee_sum=7000.00;rn=3 对应 shop_id=12348、payed_buy_fee_sum=5000.00。
明细查询
对DWD层宽表进行分析。本文使用StarRocks查询某个客户23年2月特定支付平台支付的订单明细的代码示例如下。
SELECT * FROM paimoncatalog.order_dw.dwd_orders
WHERE order_create_time >= '2023-02-01 00:00:00' AND order_create_time < '2023-03-01 00:00:00'
AND order_user_id = 'user_001'
AND pay_platform = 0
ORDER BY order_create_time;;
查询返回结果如下。
   order_id  order_user_id  order_shop_id  order_product_id  order_product_catalog_name  order_fee
0  100006    user_001       12348          1                 phone_aaa                   1000
1  100004    user_001       12347          4                 phone_ddd                   2000
数据报表
对DWD层宽表进行分析。本文使用StarRocks查询23年2月内每个品类的订单总量和订单总金额的代码示例如下。
SELECT
  order_create_time AS order_create_date,
  order_product_catalog_name,
  COUNT(*),
  SUM(order_fee)
FROM
  paimoncatalog.order_dw.dwd_orders
WHERE
  order_create_time >= '2023-02-01 00:00:00'  and order_create_time < '2023-03-01 00:00:00'
GROUP BY
  order_create_date, order_product_catalog_name
ORDER BY
  order_create_date, order_product_catalog_name;
执行上述查询后返回9条记录,显示2023-02-15 10:40:56至18:40:56期间按小时粒度的订单数据。产品目录包括phone_ddd、phone_aaa、phone_eee、phone_ccc、phone_bbb等,每条记录的count(*)均为1,sum(order_fee)值分别为2000、1000、1000、2000、3000、4000、5000、3000、1000。
相关文档
-
通过Flink批处理能力搭建Paimon离线湖仓,详情请参见Flink批处理。