本文介绍 Flink Python Coding Skill 的功能架构、安装方式与典型使用场景。
功能概述
Flink Python Coding Skill 是实时计算 Flink 版提供的 AI 编程辅助工具,以插件形式集成到主流 AI 编程助手中,将 PyFlink 实时计算开发知识体系注入 AI Agent,根据自然语言描述生成 Flink Python 作业代码。
Skill 覆盖 PyFlink 开发全链路,包括环境初始化、数据源接入、算子选择、数据处理、结果写入与部署准备,并重点强化 DataFrame API 与多模态 AI 处理能力,降低实时计算与 AI 数据预处理作业的开发门槛。
核心特性如下。
|
特性 |
说明 |
|
自然语言驱动开发 |
以一句话描述需求,Skill 自动完成 API 选择、参数配置与代码生成,无需记忆复杂 API |
|
API 真实性校验 |
内置 PyFlink 官方 API 文档库与算子验证脚本,实时校验 API 是否存在,避免生成不存在的接口 |
|
生产级代码标准 |
自动补全 Checkpoint、并行度、UDF 返回类型与 Model Provider 配置,生成的代码可直接部署 |
|
多模态能力一体化 |
原生支持 image 系列算子、 |
|
多平台集成 |
支持 Claude Code、Cursor、Codex、Gemini CLI、通义灵码、Qoder 等主流 AI 编程助手,一条命令完成安装 |
控制台内的AI智能助手也内置作业开发技能,支持SQL生成与校验、草稿创建与部署,详情请参见智能助手.
技术架构
Flink Python Coding Skill 采用多层知识注入架构,将完整的 PyFlink 开发知识体系系统化注入 AI Agent,确保生成的代码准确、可运行、可部署。
各层组件的功能如下。
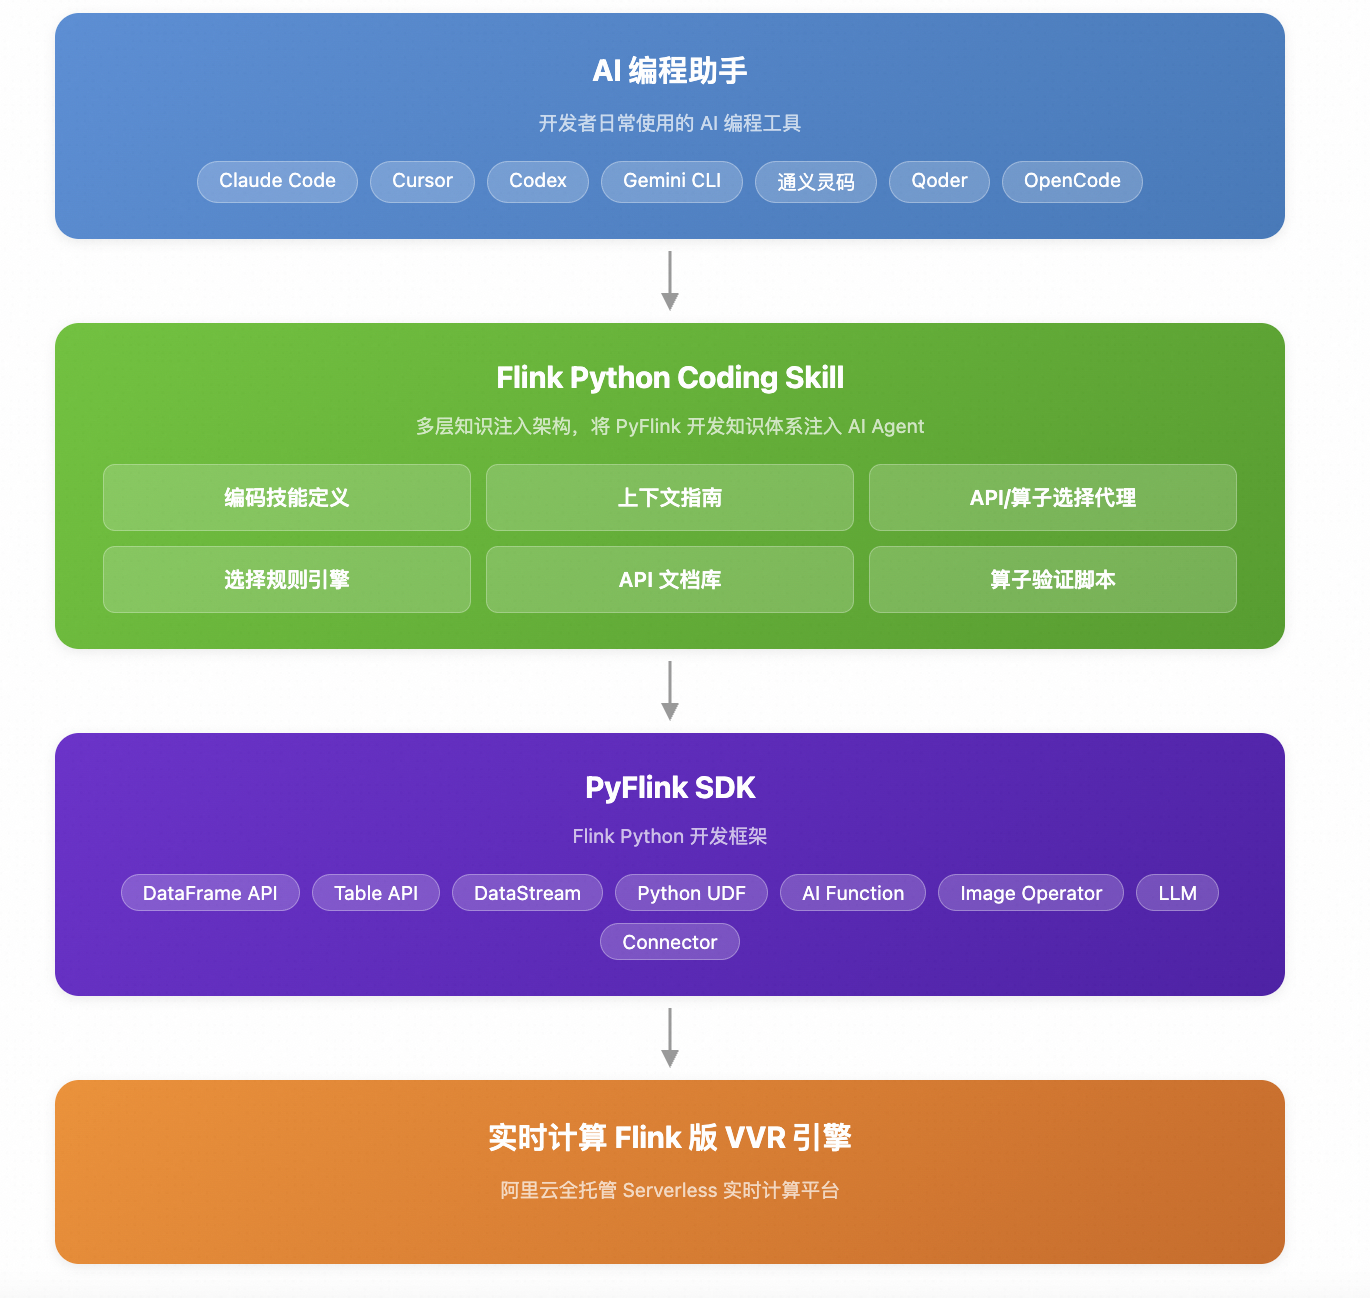
|
组件 |
功能 |
|
编码技能定义 |
定义 Skill 的核心职责、能力边界和工作流程 |
|
上下文指南 |
覆盖 PyFlink DataFrame、Table、DataStream、AI Function 与多模态算子的参考文档 |
|
API 与算子选择代理 |
智能代理,负责 API 与算子的发现、验证和推荐 |
|
选择规则引擎 |
基于性能优先、流处理优先、兼容性优先等原则的选择策略 |
|
API 文档库 |
PyFlink 完整 API 文档,含 DataFrame、Image Operator、LLM 与 AI Function,支持实时查询 |
|
算子验证脚本 |
可执行脚本,验证 API 与算子是否存在并获取详细文档 |
适用平台
Flink Python Coding Skill 遵循 Agent Skills 开放标准,支持主流 AI 编程助手。各平台的安装目录如下。
|
AI 编程平台 |
安装目录 |
|
通用标准目录 |
|
|
Claude Code |
|
|
Cursor |
|
|
Codex |
|
|
OpenCode |
|
|
Gemini CLI |
|
|
通义灵码与 Qoder |
|
前提条件
已安装 Node.js 18 及以上版本。
安装 Skill
在项目根目录执行以下命令,自动完成下载与安装,无需手动解压。
npx skills add aliyun/alibabacloud-aiops-skills \
  --skill alibabacloud-flink-python-coding \
  --global \
--full-depth更多安装说明,请参见阿里云 Skill 门户。
验证安装
安装过程中根据命令行提示选择目标 AI Coding Agent。安装完成后重启 Agent 客户端,执行以下命令确认全局安装结果。
npx skills list --global输出中应包含以下内容。
SKILL.md      # Skill 定义与使用说明
assets        # 静态资源
references # PyFlink API 文档与参考资料如需安装到特定 AI 助手的专属目录,例如 .claude/skills/,在安装完成后将目录复制过去即可。
使用方法
安装完成后,在 AI 编程助手中以自然语言描述需求即可,无需套用固定模板。为使生成的代码贴合业务逻辑,提示词中建议包含以下信息。
|
提示要素 |
说明 |
|
VVR 引擎版本 |
例如 VVR 11.8.0,确保生成的 API 与目标引擎匹配 |
|
连接器与 Schema |
数据源和数据汇的类型,例如 Kafka、Paimon、Hologres,以及字段定义 |
|
数据处理操作 |
期望执行的转换、过滤、聚合、UDF、AI 推理或多模态处理 |
提示词示例如下。
创建一个 Flink Python 作业,VVR 11.8.0,从 OSS-CDC 读取机器人采集的帧图片(字段:image_url、episode_id、frame_id、timestamp),调用 qwen3-vl-max 生成场景描述,再用 text-embedding-v4 生成向量,结果写入 Paimon 数据湖。Skill 将自动生成从数据读取、DataFrame 处理到结果写出的完整作业链路。
-
按确认的 Schema、启动语义和流批模式从数据源读取数据。
-
以与目标 VVR 版本匹配的 PyFlink API 完成转换、时间处理、关联、聚合、UDF、AI 推理或多模态处理。
-
通过已确认的数据汇写出结果,保持约定的 Schema、时间语义和 Changelog 语义。
-
自动管理 Connector 参数、模型配置、Python 依赖和运行文件,避免在代码中写入凭据值。
-
按实际需要生成代码包、依赖包和部署说明,供作业部署使用。
Skill 在本地执行 Python 语法检查与 API 验证,本地验证无法覆盖线上环境中的全部问题。将作业部署到目标工作空间并实际启动后,需验证数据源连通性、资源配置、检查点配置和处理结果。
核心能力
智能 API 推荐
PyFlink 提供多层次的 API 体系,包括类 pandas 的 DataFrame API、声明式的 Table API 与 SQL、底层的 DataStream API、Python UDF,以及多模态 Image Operator、LLM 与 AI Function 扩展能力。Skill 内置的 API Selector 智能代理自动完成 API 选择与验证。
-
任务驱动推荐:根据任务描述,自动推荐最优 API 组合,并给出选择理由。
-
API 真实性校验:基于 PyFlink 官方 API 文档实时验证 API 是否存在。
-
备选方案提供:首选 API 存在限制时,自动提供替代方案,包括 UDF 回退方案。
DataFrame API 的核心能力覆盖范围如下。
-
标准数据处理:
from_records、from_dict、with_column、filter、select、group_by、join。 -
多模态图片处理:
fetch_content、image.is_valid、image.decode、image.resize、image.encode。 -
LLM 原生调用:
llm.predict、llm.ai_embed。 -
数据写出:
write_kafka、write_hologres、write_generic。
常见问题规避
通用 AI 生成的 PyFlink 代码常见问题及 Skill 的处理方式如下。
|
常见问题 |
处理方式 |
|
调用不存在的 API |
基于 PyFlink 官方文档实时校验,并执行本地检查 |
|
遗漏执行触发 |
根据目标输出格式调用数据写出函数,触发作业执行 |
|
引擎版本选择错误 |
匹配指定的 VVR 引擎版本 |
|
UDF 返回类型不匹配 |
基于文档给出正确的返回类型声明方式 |
|
连接器配置缺失 |
自动补全 Kafka、OSS、Paimon 等连接器的必要参数 |
|
流批模式混淆 |
根据需求自动选择 streaming 或 batch 模式 |
使用示例
场景一:PyFlink API 推荐与答疑
需求描述:从 OSS 读取视频并按固定时间间隔抽帧,调用大模型分析画面场景,需要确定可用的 API 与实现路径。
提示词示例如下。
我需要在 PyFlink 中从 OSS 上读取视频,每隔 5 秒取一帧,调用一次大模型分析画面场景。应该使用哪些 API?运行效果如下。
推荐使用 VVR 11.8+ 的 DataFrame 多模态 API。核心链路是:

OSS URI → read_video_frames → IMAGE → image_encode(data_url) → llm.predict

需要使用的主要 API:

- pf.read_video_frames(...):推荐的高层接口,直接接受单个 OSS URI、路径列表、通配路径或包含视频 URI 的 DataFrame;sample_interval_ms=5000 表示按视频时间轴每 5 秒采样,而不是 Flink 的处理时间定时器。
- video_explode_frames(...):底层抽帧算子,将结果展开为"一帧一行";需要精细控制视频切片时可直接使用它。
- video_metadata(...)、video_split(...):长视频需要先探测时长、分片并重新分布负载时使用。
- image_encode(..., output="data_url"):把 IMAGE 编码成可被视觉模型消费的 Data URL。
- pf.set_model_provider(...)、pf.OpenAICompatProvider(...):注册内置模型或百炼、OpenAI 兼容模型。
- DataFrame.llm.predict(...):逐帧执行视觉理解并输出场景描述。

对于长视频,不建议使用 video_extract_frames,因为它会把所有帧放进同一行的数组;read_video_frames 与 video_explode_frames 的逐帧输出更适合模型调用和并发控制。

如果视频是持续上传到 OSS 的:

- 使用 oss-cdc Connector 订阅 OSS/MNS 对象创建事件;
- 得到 url 列后调用 pf.read_video_frames(video_df, "url", ...)。

生产中还可以用 OSS URI + frame_time_ms 作为缓存键,避免作业恢复或模型重试造成重复计费。
无需自行检索和比对文档,以自然语言描述需求即可获得经过官方文档核对的 API 建议、适用条件和实现路径。
场景二:使用 PyFlink 对实时评论进行情感分析
需求描述:对 Kafka Topic 中的客户评价实时执行情感分析,将情感标签与置信度写回 Kafka。
提示词示例如下。
我想用 VVR 11.8 实现一个客户评价分析作业。
我有一个 Kafka 集群,连接端点是 kafka.example.com:9092。
customer_reviews 这个 Topic 里有 review_id 和 review 两个字段。
请调用 Flink AI 服务里的大模型判断每条评价的情感,再把 review_id、
情感标签和置信度写到同一集群的 review_sentiments Topic。
无需手写 Flink SQL,无需理解 DataStream 算子链,以自然语言描述即可产出可部署的作业。
场景三:电商商品图片分析与向量化入湖
需求描述:批量处理 OSS 上的商品图片,完成读取、预处理与主色提取,调用多模态大模型生成商品描述并写入 Hologres。
提示词示例如下。
我们有一批商品图片需要用 PyFlink 做实时处理。
输入是 oss://example-bucket/product-images/input/ 下的 Parquet 文件,
字段为 product_id 和 image_url。
请先下载、校验和解码图片,再统一缩放到 256×256 并计算图片质量分。
之后使用 colorthief 提取主色,
然后使用大模型生成商品描述,要求100字以内。
最后把 product_id、质量分、主色、商品描述写到 Paimon 数据湖,
Paimon 仓库路径为 oss://example-bucket/warehouse/。
使用的 VVR 版本为 11.8。
无需部署模型、管理 GPU 资源或编写推理服务。DataFrame API 内置 image 系列多模态算子与 AI 函数,可直接在 Flink 流批作业中完成图片理解、文本生成与向量化。