Kafka连接器可以用于Flink CDC数据摄入作业开发,作为源端读取或目标端写入。本文介绍Kafka 数据摄入连接器的语法结构、参数配置和使用示例。
前提条件
请根据需求选择以下任意一种方式连接集群:
连接阿里云云消息队列Kafka版集群
Kafka集群版本在0.11及以上。
云消息队列 Kafka 版集群已创建。详情请参见创建资源。
Flink工作空间与Kafka集群处于同一VPC内,且云消息队列 Kafka 版已对Flink开放白名单,具体操作请参见配置白名单。
重要写入阿里云Kafka的限制:
阿里云Kafka不支持zstd压缩格式写入。
阿里云Kafka不支持幂等和事务写入,无法使用Kafka结果表提供的精确一次语义exactly-once semantic功能。自实时计算引擎VVR 8.0.0版本起,Kafka Connector 使用的开源Kafka Client版本升级到3.x版本,该Client的
properties.enable.idempotence属性默认值从false变为true表示显式开启幂等写入, 因此在使用实时计算引擎VVR 8.0.0及以上版本写入阿里云Kafka时,需要在结果表中添加显式配置properties.enable.idempotence=false以关闭幂等写入功能,避免无法写入阿里云Kafka的问题。阿里云Kafka的存储引擎对比与功能限制参见存储引擎对比。
连接自建Apache Kafka集群
使用限制
建议在实时计算引擎VVR 11.1及以上版本使用Kafka作为Flink CDC数据摄入的同步数据源。
仅支持JSON、Debezium JSON和Canal JSON格式,其他数据格式暂不支持。
对于数据源,仅实时计算引擎VVR 8.0.11及以上版本支持同一张表的数据分布在多个分区。
注意事项
目前不推荐使用事务写入,这是 Flink 社区和 Kafka 社区的设计缺陷所致。当设置sink.delivery-guarantee = exactly-once,Kafka Connector 会启用事务写入,存在三个已知问题:
每个 Checkpoint 会生成一个 Transaction ID。如果 Checkpoint 间隔太短,Transaction ID会过多。Kafka 集群的 Coordinator 可能因此内存不足,从而破坏 Kafka 集群的稳定性。
每个事务会创建一个 Producer 实例。如果同时提交的事务太多,TaskManager 的内存可能耗尽,从而破坏 Flink 作业的稳定性。
多个 Flink 作业若使用相同的
sink.transactional-id-prefix,它们生成的事务 ID 可能冲突。一个作业写入失败时,会阻塞 Kafka 分区的 LSO(Log Start Offset)前进,这会影响所有消费者读取该分区的数据。
如果你需要 Exactly-Once 语义,改用 Upsert Kafka 写入主键表,并用主键保证幂等性。如果需要使用事务写入,请参见Kafka SQL连接器。
语法结构
source:
  type: kafka
  name: Kafka source
  properties.bootstrap.servers: localhost:9092
  topic: ${kafka.topic}
sink:
type: kafka
name: Kafka Sink
properties.bootstrap.servers: localhost:9092配置项
通用
参数
说明
是否必填
数据类型
默认值
备注
type
源端或目标端类型。
是
String
无
固定值为kafka
name
源端或目标端名称。
否
String
无
无
properties.bootstrap.servers
Kafka broker地址。
是
String
无
格式为
host:port,host:port,host:port,以英文逗号(,)分割。properties.*
对Kafka客户端的直接配置。
否
String
无
Flink会将properties.前缀移除,并将剩余的配置传递给Kafka客户端。例如可以通过
'properties.allow.auto.create.topics' = 'false'来禁用自动创建topic。其中
properties.sasl.jaas.config的用户名和密码可填写secret://kms.<secret-name>.<key>引用KMS托管的凭据,避免明文暴露。仅实时计算引擎VVR 11.9及以上版本支持,配置步骤请参见KMS 凭据管理集成。key.format
读取或写入Kafka消息key部分使用的格式。
否
String
无
对Source,仅支持json。
对Sink,取值如下:
csv
json
说明仅实时计算引擎VVR 11.0.0及以上版本支持该参数。
value.format
读取或写入Kafka消息value部分时使用的格式。
否
String
debezium-json
对Source,取值如下:
debezium-json
canal-json
json
对Sink,取值如下:
debezium-json
canal-json
canal-protobuf
说明仅实时计算引擎VVR 8.0.10及以上版本支持debezium-json和canal-json格式。
仅实时计算引擎VVR 11.0.0及以上版本支持json格式。
源表
参数
说明
是否必填
数据类型
默认值
备注
topic
读取的topic名称。
否
String
无
以英文分号 (;) 分隔多个topic名称,例如topic-1和topic-2
说明topic和topic-pattern两个选项只能指定其中一个。
topic-pattern
匹配读取topic名称的正则表达式。所有匹配该正则表达式的topic在作业运行时均会被读取。
否
String
无
示例:
user_event_.*:匹配所有以user_event_开头的 topicprod\.logs\..*:匹配prod.logs.前缀的 topic(.需转义)
说明topic和topic-pattern两个选项只能指定其中一个。
properties.group.id
消费组ID。
否
String
无
如果指定的group id为首次使用,则必须将properties.auto.offset.reset设置为earliest或latest以指定首次启动位点。
scan.startup.mode
Kafka读取数据的启动位点。
否
String
group-offsets
取值如下:
earliest-offset:从Kafka最早分区开始读取。
latest-offset:从Kafka最新位点开始读取。
group-offsets(默认值):从指定的properties.group.id已提交的位点开始读取。
timestamp:从scan.startup.timestamp-millis指定的时间戳开始读取。
specific-offsets:从scan.startup.specific-offsets指定的偏移量开始读取。
说明该参数在作业无状态启动时生效。作业在从checkpoint重启或状态恢复时,会优先使用状态中保存的进度恢复读取。
scan.startup.specific-offsets
specific-offsets启动模式下,指定每个分区的启动偏移量。
否
String
无
例如
partition:0,offset:42;partition:1,offset:300scan.startup.timestamp-millis
timestamp启动模式下,指定启动位点时间戳。
否
Long
无
单位为毫秒
scan.topic-partition-discovery.interval
动态检测Kafka topic和partition的时间间隔。
否
Duration
5分钟
分区检查间隔默认为5分钟。需要显式地设置分区检查间隔为非正数才能关闭此功能。开启动态分区发现后,Kafka Source 可以自动地发现新增的分区并自动读取对应分区上的数据。在topic-pattern模式下,不仅读取已有topic的新增分区数据,也会读取符合正则匹配的新增topic的所有分区数据。
scan.check.duplicated.group.id
是否检查通过
properties.group.id指定的消费者组有重复。否
Boolean
false
参数取值如下:
true:在启动作业前检查消费者组是否有重复,如有重复作业将会报错,避免与现有的消费者组产生冲突。
false:直接启动作业,不检查消费者组冲突。
schema.inference.strategy
Schema解析策略。
否
String
continuous
取值如下:
continuous:对每条数据均进行 Schema 解析。在前后 Schema 不兼容时,解析出更宽的 Schema 并产生 Schema 变更事件。
static:仅在作业启动时进行一次Schema解析,后续根据初始Schema解析数据,不会产生Schema变更事件。
说明Schema解析详情可见Kafka SQL连接器。
仅VVR 8.0.11及以上版本支持该配置项。
scan.max.pre.fetch.records
Schema初始解析时,对每个分区最多尝试消费解析的消息数量
否
Int
50
在作业实际读取并处理数据前,对每个分区尝试提前消费指定数量的最新消息,用于初始化Schema信息。
key.fields-prefix
自定义添加到消息键(Key)解析出字段名称的前缀,以避免Kafka消息键解析后的命名冲突问题。
否
String
无
假设该配置项设为key_,当key中包含字段名a时,解析key后该字段名称为key_a。
说明key.fields-prefix的配置值不可以是value.fields-prefix的前缀。
value.fields-prefix
自定义添加到消息体(Value)解析出字段名称的前缀,以避免Kafka消息体解析后的命名冲突问题。
否
String
无
假设该配置项设为value_,当value中包含字段名b时,解析value后该字段名称为value_b。
说明value.fields-prefix的配置值不可以是key.fields-prefix的前缀。
metadata.list
需要传递给下游的元数据列
否
String
无
可用的元数据列包括
topic、partition、offset、timestamp、timestamp-type、headers、leader-epoch、__raw_key__和__raw_value__。使用英文逗号分隔。说明__raw_key__和__raw_value__元数据列需要VVR 11.6及更高版本可用。scan.value.initial-schemas.ddls
通过DDL方式指定某些表的初始Schema。
否
String
无
多个DDL使用英文
;连接。例如,使用CREATE TABLE db1.t1 (id BIGINT, name VARCHAR(10)); CREATE TABLE db1.t2 (id BIGINT);为表db1.t1和表db1.t2分别指定初始Schema。这里的DDL表结构应当和写入目标表保持一致,并且满足Flink SQL的语法规则。
说明VVR 11.5及以上版本支持该配置。
ingestion.ignore-errors
是否忽略数据解析过程中的报错。
否
Boolean
false
说明VVR 11.5及以上版本支持该配置。
ingestion.error-tolerance.max-count
忽略数据解析过程报错时,累计多少次报错后作业失败。
否
Integer
-1
仅当ingestion.ignore-errors开启时生效,默认值-1表示解析异常不触发作业失败。
说明VVR 11.5及以上版本支持该配置。
scan.duplicate-field.strategy
在 Key 和 Value 部分解析出重复字段名时,应该如何进行处理。
否
String
EXCEPTION
参数取值如下:
EXCEPTION:在 key 和 value 存在重复字段时,抛出异常。这是 VVR 11.6 及更早版本的默认行为。
PREFER_KEY:在字段重复时,优先选择 key 字段的值。
PREFER_VALUE:在字段重复时,优先选择 value 字段的值。
说明VVR 11.7 及以上版本支持该配置。
table-id.include
按解析后 Table ID 选择需要保留的表,默认保留全部表。
否
String
无
支持正则表达式,点号需要转义,如
inventory.orders_\.*表示保留 inventory 库内以 orders_ 开头的表。多个选择器用英文逗号分隔,匹配任意一个即保留。
说明VVR 11.9 及以上版本支持该配置。
scan.emit.create-table-events.in-batch.enabled
是否批量发送初始建表事件。
否
Boolean
true
仅在如下2种场景生效,其他情况会自动关闭该能力。
未配置key format
配置了key format,value format为json且未配置decode.parser-table-id.fields
说明VVR 11.9 及以上版本支持该配置。
源表 Debezium JSON 格式
参数
是否必填
数据类型
默认值
描述
debezium-json.distributed-tables
否
Boolean
false
如果Debezium JSON内单张表数据会出现在多个分区,则需要开启此选项。
说明仅VVR 8.0.11及以上版本支持该配置项。
重要修改该配置项后,需要无状态启动作业。
debezium-json.schema-include
否
Boolean
false
设置Debezium Kafka Connect时,可以启用Kafka配置value.converter.schemas.enable,以在消息中包含schema。此选项表明Debezium JSON消息是否包含schema。
参数取值如下:
true:Debezium JSON消息包含schema。
false:Debezium JSON消息不包含schema。
debezium-json.ignore-parse-errors
否
Boolean
false
参数取值如下:
true:当解析异常时,跳过当前行。
false(默认值):报出错误,作业启动失败。
debezium-json.infer-schema.primitive-as-string
否
Boolean
false
解析表结构时,是否解析所有类型为String类型。
参数取值如下:
true:解析所有基本类型为String。
false(默认值):按照基本规则进行解析。
debezium-json.infer-schema.string-type-inference
否
Boolean
true
是否尝试将字符串字段推断为 TIME、DATE 或 TIMESTAMP类型。设置为 false 时跳过该推断,字段保持 STRING。
说明VVR 11.8及以上版本支持该配置。
源表 Canal JSON 格式
参数
是否必填
数据类型
默认值
描述
canal-json.distributed-tables
否
Boolean
false
如果Canal JSON内单张表数据会出现在多个分区,则需要开启此选项。
说明仅VVR 8.0.11及以上版本支持该配置项。
重要修改该配置项后,需要无状态启动作业。
canal-json.database.include
否
String
无
一个可选的正则表达式,通过正则匹配Canal记录中的database元字段,仅读取指定数据库的changelog记录。正则字符串与Java的Pattern兼容。
canal-json.table.include
否
String
无
一个可选的正则表达式,通过正则匹配Canal记录中的table元字段,仅读取指定表的changelog记录。正则字符串与Java的Pattern兼容。
canal-json.ignore-parse-errors
否
Boolean
false
参数取值如下:
true:当解析异常时,跳过当前行。
false(默认值):报出错误,作业启动失败。
canal-json.infer-schema.primitive-as-string
否
Boolean
false
解析表结构时,是否所有类型解析为String类型。
参数取值如下:
true:解析所有基本类型为String。
false(默认值):按照基本规则进行解析。
canal-json.infer-schema.strategy
否
String
AUTO
解析表结构时的解析策略。
参数取值如下:
AUTO(默认值):通过解析JSON数据自动解析。如果数据中不包含sqlType字段,建议使用AUTO以避免解析失败。
SQL_TYPE:通过canal json数据中的sqlType数组解析。如果数据包含sqlType字段时,建议将canal-json.infer-schema.strategy设置为SQL_TYPE以获得更精确的类型。
MYSQL_TYPE:通过canal json数据中的mysqlType数组解析。
当Kafka中的Canal JSON数据包含sqlType字段且需要更精确的类型映射时,建议将canal-json.infer-schema.strategy设置为SQL_TYPE。
sqlType类型映射规则请见Kafka SQL连接器。
说明VVR 11.1及以上版本支持该配置。
MYSQL_TYPE在VVR 11.3及以上版本支持使用。
canal-json.mysql.treat-mysql-timestamp-as-datetime-enabled
否
Boolean
true
是否将mysql timestamp类型映射到cdc timestamp类型:
true(默认):mysql timestamp类型映射到cdc timestamp类型。
false:mysql timestamp类型映射到cdc timestamp_ltz类型。
canal-json.mysql.treat-tinyint1-as-boolean.enabled
否
Boolean
true
使用MYSQL_TYPE解析时,是否将mysql tinyint(1)类型映射到cdc boolean类型:
true(默认):mysql tinyint(1)类型映射到cdc boolean类型。
false:mysql tinyint(1)类型映射到cdc tinyint(1)类型。
该配置仅当canal-json.infer-schema.strategy配置为MYSQL_TYPE时生效。
canal-json.infer-schema.string-type-inference
否
Boolean
true
是否尝试将字符串字段推断为 TIME、DATE 或 TIMESTAMP类型。设置为 false 时跳过该推断,字段保持 STRING。
说明VVR 11.8及以上版本支持该配置。
源表 JSON 格式
参数
是否必填
数据类型
默认值
描述
json.timestamp-format.standard
否
String
SQL
指定输入和输出时间戳格式。参数取值如下:
SQL:解析yyyy-MM-dd HH:mm:ss.s{precision}格式的输入时间戳,例如2020-12-30 12:13:14.123。
ISO-8601:解析yyyy-MM-ddTHH:mm:ss.s{precision}格式的输入时间戳,例如2020-12-30T12:13:14.123。
json.ignore-parse-errors
否
Boolean
false
参数取值如下:
true:当解析异常时,跳过当前行。
false(默认值):报出错误,作业启动失败。
json.infer-schema.primitive-as-string
否
Boolean
false
解析表结构时,是否解析所有类型为String类型。
参数取值如下:
true:解析所有基本类型为String。
false(默认值):按照基本规则进行解析。
json.infer-schema.flatten-nested-columns.enable
否
Boolean
false
解析JSON格式数据时,是否递归式地展开JSON中的嵌套列。参数取值如下:
true:递归式展开。
false(默认值):将嵌套列当作String处理。
json.decode.parser-table-id.fields
否
String
无
解析JSON格式数据时,是否使用部分JSON字段值生成tableId,多个字段使用英文
,连接。例如:JSON数据为{"col0":"a", "col1","b", "col2","c"},生成结果如下:配置
tableId
col0
a
col0,col1
a.b
col0,col1,col2
a.b.c
json.infer-schema.fixed-types
否
String
无
解析JSON格式数据时,指定某些字段的具体类型,多个字段使用英文
,连接。例如:id BIGINT, name VARCHAR(10)可以指定JSON数据中的id字段类型为BIGINT,name字段类型为VARCHAR(10)。说明VVR 11.5及以上版本支持该配置。
VVR 11.5版本使用该配置时,需要额外添加配置
scan.max.pre.fetch.records: 0。
json.decode.converter-class
否
String
无
在解析JSON数据前,通过converter可以对JSON byte[]提前进行修改,填写具体实现类的全限定名。
说明VVR 11.6及以上版本支持该配置。
json.decode.empty-value-as-delete.enabled
否
Boolean
false
是否将Kafka compacted topic中的墓碑消息(value 为空)解析为 DELETE 事件,用于 compacted topic 镜像、CDC 删除信号等以空 value 表示删除语义的场景。
说明VVR 11.7 及以上版本支持该配置。
json.infer-schema.string-type-inference
否
Boolean
true
是否尝试将字符串字段推断为 TIME、DATE 或 TIMESTAMP类型。设置为 false 时跳过该推断,字段保持 STRING。
说明VVR 11.8及以上版本支持该配置。
结果表
参数
说明
是否必填
数据类型
默认值
备注
type
目标端类型。
是
String
无
固定值为kafka
name
目标端名称。
否
String
无
无
topic
Kafka Topic名称。
否
String
无
开启时,所有的数据都会写入这个Topic。
说明如果没有开启,每条数据会写入到其TableID对应字符串(通过
.拼接生成)的Topic,例如databaseName.tableName。partition.strategy
数据写入Kafka分区的策略。
否
String
all-to-zero
取值如下:
all-to-zero(默认值):将所有数据写入 0 号分区。
hash-by-key:根据主键的哈希值将数据写到多个分区。保证同一个主键的数据在同一个分区并且有序。
sink.tableId-to-topic.mapping
上游表名到下游 Kafka Topic名的映射关系。
否
String
无
每个映射关系由
;分割,上游表的表名和下游 Kafka 的Topic名由:分割,表名可以使用正则表达式,映射到同一个topic的多张表可以使用,拼接。例如mydb.mytable1:topic1;mydb.mytable2:topic2。说明配置这个参数能够在保留原始表名信息的同时修改映射的Topic。
结果表Canal JSON格式
参数
是否必填
数据类型
默认值
描述
canal-json.serialize.update.keep-changed-fields-only
否
Boolean
false
写入 canal-json 格式的 UPDATE 消息时,old 部分是否仅包含发生变化字段的变更前的值。
说明VVR 11.8及以上版本支持该配置。
结果表Debezium JSON格式
参数
是否必填
数据类型
默认值
描述
debezium-json.include-schema.enabled
否
Boolean
false
Debezium JSON数据中是否包含Schema信息。
debezium-json.emit.full-table-id.enabled
否
Boolean
false
是否将完整的三段式Table ID写入Debezium JSON元数据字段中。
启用此参数时的映射关系为:
CDC Table ID部分
Debezium JSON键
Namespace
dbSchema
schemaTable
table禁用此参数时的映射关系为:
CDC Table ID部分
Debezium JSON键
Namespace
无
Schema
dbTable
table说明VVR 11.6及以上版本支持此配置。
复用已有 Catalog
自VVR 11.5版本起,您可以在Flink CDC数据摄入作业中直接引用“数据管理”页面中创建的内置Kafka Catalog,减少手写连接属性工作量。
source:
  type: kafka
  using.built-in-catalog: kafka_catalog
目前,数据摄入作业支持自动复用以下 Kafka Catalog 参数:
properties.bootstrap.servers
format
key.fields-prefix
value.fields-prefix
timestamp-format.standard
infer-schema.flatten-nested-columns.enable
infer-schema.primitive-as-string
max.fetch.records
如果希望覆盖以上自动复用的参数,可显式写出相应的 YAML 参数,其具备更高的优先级。
配置示例
使用 Kafka 作为数据摄入源端:
source:
  type: kafka
  name: Kafka source
  properties.bootstrap.servers: ${kafka.bootstraps.server}
  topic: ${kafka.topic}
  value.format: ${value.format}
  scan.startup.mode: ${scan.startup.mode}

sink:
  type: hologres
  name: Hologres sink
  endpoint: <yourEndpoint>
  dbname: <yourDbname>
  username: ${secret_values.ak_id}
  password: ${secret_values.ak_secret}
  sink.type-normalize-strategy: BROADEN
使用 Kafka 作为数据摄入目标端:
source:
  type: mysql
  name: MySQL Source
  hostname: ${secret_values.mysql.hostname}
  port: ${mysql.port}
  username: ${secret_values.mysql.username}
  password: ${secret_values.mysql.password}
  tables: ${mysql.source.table}
  server-id: 8601-8604

sink:
  type: kafka
  name: Kafka Sink
  properties.bootstrap.servers: ${kafka.bootstraps.server}

route:
  - source-table: ${mysql.source.table}
    sink-table: ${kafka.topic}
其中,使用route模块以设置源表写入Kafka的Topic名称。
阿里云Kafka默认不开启自动创建Topic功能,参见自动化创建Topic相关问题,写入到阿里云Kafka时,需要预先创建对应的Topic,详情请参见步骤三:创建资源。
使用示例
下面展示几个典型使用场景的配置示例。
读取单独topic
读取topic customers,写入阿里云数据湖的配置示例:
source:
  type: kafka
  topic: customers
  properties.bootstrap.servers: localhost:9092
  properties.group.id: ${kafka.group.id}
  value.format: json
  # (可选)动态识别每条数据Schema,并比对生成Schema变更
  schema.inference.strategy: continuous

sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: rest
  catalog.properties.uri: dlf_uri
  catalog.properties.warehouse: your_warehouse
  catalog.properties.token.provider: dlf
  #(可选)提交用户名,建议为不同作业设置不同的提交用户以避免冲突
  commit.user: your_job_name
  #(可选)开启删除向量,提升读取性能
  table.properties.deletion-vectors.enabled: true
其中,Json格式默认生成的表名和topic名称相同。
读取多个topic
读取符合正则表达式的多个topic,写入 StarRocks SQL连接器 的配置示例:
source:
  type: kafka
  topic-pattern: user_event_.*
  properties.bootstrap.servers: localhost:9092
  properties.group.id: ${kafka.group.id}
  value.format: json
  # (可选)动态识别每条数据Schema,并比对生成Schema变更
  schema.inference.strategy: continuous

sink:
  type: starrocks
  jdbc-url: jdbc:mysql://<yourFeHostname>:9030
  load-url: <yourFeHostname>:8030
  username: <yourUsername>
  password: ${secret_values.starrocks_password}

  # (可选)数据量不大的作业建议调低 flush 间隔,避免数据长时间不落盘(默认 300000,即 5 分钟)
  sink.buffer-flush.interval-ms: 5000
  # (可选)上游为 utf8mb4 字符集时建议设为 4,避免文本截断(默认 3)
  unicode-char.max-bytes: 4
  # (可选)自动建表的分桶数;StarRocks 2.5.7 以下必须显式配置,更高版本可自动推断
  table.create.num-buckets: 8
  # (可选)自动建表的副本数,按集群情况配置
  table.create.properties.replication_num: 3
  # (可选)StarRocks 3.2 及以上建议开启,加速表结构变更
  table.create.properties.fast_schema_evolution: true
  # 注意:通过 transform 变更主键时,必须同时设置 sink.ignore.update-before: false,
  # 否则旧主键对应的行会残留在下游
其中,Json格式默认生成的表名和topic名称相同。
读取key并防止字段冲突
为了防止 key 和 value 的字段冲突导致报错,有以下解决方案:
为字段添加前缀,避免字段冲突:
source:
  type: kafka
  topic: ${kafka.topic}
  properties.bootstrap.servers: localhost:9092
  properties.group.id: ${kafka.group.id}
  key.format: json
  value.format: json
  # key部分的字段名添加key_前缀
  key.fields-prefix: key_
  # value部分的字段名添加value_前缀
  value.fields-prefix: value_
  # (可选)动态识别每条数据Schema,并比对生成Schema变更
  schema.inference.strategy: continuous

sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: rest
  catalog.properties.uri: dlf_uri
  catalog.properties.warehouse: your_warehouse
  catalog.properties.token.provider: dlf
  #(可选)提交用户名,建议为不同作业设置不同的提交用户以避免冲突
  commit.user: your_job_name
  #(可选)开启删除向量,提升读取性能
table.properties.deletion-vectors.enabled: true配置冲突解决策略,详情请见Kafka SQL连接器。如下配置会优先使用key中字段,出现重复时忽略value中的同名字段。
source:
  type: kafka
  topic: ${kafka.topic}
  properties.bootstrap.servers: localhost:9092
  properties.group.id: ${kafka.group.id}
  key.format: json
  value.format: json
  # 优先使用key的字段,忽略同名的value中字段
  scan.duplicate-field.strategy: PREFER_KEY
  # (可选)动态识别每条数据Schema,并比对生成Schema变更
  schema.inference.strategy: continuous

sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: rest
  catalog.properties.uri: dlf_uri
  catalog.properties.warehouse: your_warehouse
  catalog.properties.token.provider: dlf
  #(可选)提交用户名,建议为不同作业设置不同的提交用户以避免冲突
  commit.user: your_job_name
  #(可选)开启删除向量,提升读取性能
  table.properties.deletion-vectors.enabled: true
增加元数据列
读取topic customers,并在字段增加元数据topic和partition的配置示例:
source:
  type: kafka
  topic: customers
  properties.bootstrap.servers: localhost:9092
  properties.group.id: ${kafka.group.id}
  value.format: json
  # (可选)动态识别每条数据Schema,并比对生成Schema变更
  schema.inference.strategy: continuous
  metadata.list: topic,partition

sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: rest
  catalog.properties.uri: dlf_uri
  catalog.properties.warehouse: your_warehouse
  catalog.properties.token.provider: dlf
  #(可选)提交用户名,建议为不同作业设置不同的提交用户以避免冲突
  commit.user: your_job_name
  #(可选)开启删除向量,提升读取性能
  table.properties.deletion-vectors.enabled: true
解析报错处理
数据解析报错会导致作业失败,支持配置容忍解析报错,常配合脏数据收集使用。
完全忽略解析报错的配置示例:
source:
  type: kafka
  topic: customers
  properties.bootstrap.servers: localhost:9092
  properties.group.id: ${kafka.group.id}
  value.format: json
  # (可选)动态识别每条数据Schema,并比对生成Schema变更
  schema.inference.strategy: continuous
  # 开启忽略解析报错,默认忽略全部解析报错
  ingestion.ignore-errors: true

sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: rest
  catalog.properties.uri: dlf_uri
  catalog.properties.warehouse: your_warehouse
  catalog.properties.token.provider: dlf
  #(可选)提交用户名,建议为不同作业设置不同的提交用户以避免冲突
  commit.user: your_job_name
  #(可选)开启删除向量,提升读取性能
  table.properties.deletion-vectors.enabled: true

# 开启脏数据收集器,打印解析失败数据
pipeline:
  dirty-data.collector:
    name: Logger Dirty Data Collector
    type: logger
累计解析失败30次后作业报错的配置示例:
source:
  type: kafka
  topic: customers
  properties.bootstrap.servers: localhost:9092
  properties.group.id: ${kafka.group.id}
  value.format: json
  # (可选)动态识别每条数据Schema,并比对生成Schema变更
  schema.inference.strategy: continuous
  # 开启忽略解析报错
  ingestion.ignore-errors: true
  # 解析报错发生30次后触发作业失败
  ingestion.error-tolerance.max-count: 30

sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: rest
  catalog.properties.uri: dlf_uri
  catalog.properties.warehouse: your_warehouse
  catalog.properties.token.provider: dlf
  #(可选)提交用户名,建议为不同作业设置不同的提交用户以避免冲突
  commit.user: your_job_name
  #(可选)开启删除向量,提升读取性能
  table.properties.deletion-vectors.enabled: true

# 开启脏数据收集器,打印解析失败数据
pipeline:
  dirty-data.collector:
    name: Logger Dirty Data Collector
    type: logger
JSON数据读取
接下来介绍 Json 格式读取常见的一些使用方式。
指定 table id 解析
默认 json 数据的 table id 是 topic 名称,可以指定数据中的字段值作为table id。如下示例将字段 db 和 tbl 指定为 table id。
source:
  type: kafka
  topic: customers
  properties.bootstrap.servers: localhost:9092
  properties.group.id: ${kafka.group.id}
  value.format: json
  # (可选)动态识别每条数据Schema,并比对生成Schema变更
  schema.inference.strategy: continuous
  # 指定字段 db 和 table 作为 table id
  value.json.decode.parser-table-id.fields: db,tbl

sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: rest
  catalog.properties.uri: dlf_uri
  catalog.properties.warehouse: your_warehouse
  catalog.properties.token.provider: dlf
  #(可选)提交用户名,建议为不同作业设置不同的提交用户以避免冲突
  commit.user: your_job_name
  #(可选)开启删除向量,提升读取性能
  table.properties.deletion-vectors.enabled: true

# 开启脏数据收集器,打印解析失败数据
pipeline:
  dirty-data.collector:
    name: Logger Dirty Data Collector
    type: logger
指定字段类型
字段类型解析按照字段值推导获取,有些字段类型的推断并不是用户期望的类型。支持指定某些字段的固定类型,并跳过后续对这个字段类型的推导和演变。
如下配置固定了4个字段的类型:
source:
  type: kafka
  topic: customers
  properties.bootstrap.servers: localhost:9092
  properties.group.id: ${kafka.group.id}
  value.format: json
  # 指定字段 db 和 tbl 作为 table id
  value.json.decode.parser-table-id.fields: db,tbl
  # 固定指定部分字段类型
  value.json.infer-schema.fixed-types: 'db STRING, tbl STRING, id BIGINT, amount DECIMAL(18, 2)'
  # 允许未声明字段继续动态推断
  schema.inference.strategy: continuous

sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: rest
  catalog.properties.uri: dlf_uri
  catalog.properties.warehouse: your_warehouse
  catalog.properties.token.provider: dlf
  #(可选)提交用户名,建议为不同作业设置不同的提交用户以避免冲突
  commit.user: your_job_name
  #(可选)开启删除向量,提升读取性能
  table.properties.deletion-vectors.enabled: true

# 开启脏数据收集器,打印解析失败数据
pipeline:
  dirty-data.collector:
    name: Logger Dirty Data Collector
    type: logger
Canal Json数据读取
接下来介绍 Canal Json 格式读取常见的一些使用方式。
类型推导策略
默认情况下,读取 Canal json 数据会使用数据值进行Schema类型推导。
source:
  type: kafka
  topic: customers
  properties.bootstrap.servers: localhost:9092
  properties.group.id: ${kafka.group.id}
  value.format: canal-json
  # (可选)动态识别每条数据Schema,并比对生成Schema变更
  schema.inference.strategy: continuous

sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: rest
  catalog.properties.uri: dlf_uri
  catalog.properties.warehouse: your_warehouse
  catalog.properties.token.provider: dlf
  #(可选)提交用户名,建议为不同作业设置不同的提交用户以避免冲突
  commit.user: your_job_name
  #(可选)开启删除向量,提升读取性能
  table.properties.deletion-vectors.enabled: true

# 开启脏数据收集器,打印解析失败数据
pipeline:
  dirty-data.collector:
    name: Logger Dirty Data Collector
    type: logger
此外支持使用 canal json 数据中记录的 Schema 信息(sql type 或 mysql type)进行推导,如下例子使用 mysql type 推导Schema。
source:
  type: kafka
  topic: customers
  properties.bootstrap.servers: localhost:9092
  properties.group.id: ${kafka.group.id}
  value.format: canal-json
  # (可选)动态识别每条数据Schema,并比对生成Schema变更
  schema.inference.strategy: continuous
  # 使用 mysql type 信息推导 Schema,也可以配置为 SQL_TYPE 通过 sql type 推导
  value.canal-json.infer-schema.strategy: MYSQL_TYPE

sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: rest
  catalog.properties.uri: dlf_uri
  catalog.properties.warehouse: your_warehouse
  catalog.properties.token.provider: dlf
  #(可选)提交用户名,建议为不同作业设置不同的提交用户以避免冲突
  commit.user: your_job_name
  #(可选)开启删除向量,提升读取性能
  table.properties.deletion-vectors.enabled: true

# 开启脏数据收集器,打印解析失败数据
pipeline:
  dirty-data.collector:
    name: Logger Dirty Data Collector
    type: logger
Debezium Json数据读取
读取topic customers,写入阿里云数据湖的配置示例:
source:
  type: kafka
  topic: customers
  properties.bootstrap.servers: localhost:9092
  properties.group.id: ${kafka.group.id}
  value.format: debezium-json
  # (可选)动态识别每条数据Schema,并比对生成Schema变更
  schema.inference.strategy: continuous

sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: rest
  catalog.properties.uri: dlf_uri
  catalog.properties.warehouse: your_warehouse
  catalog.properties.token.provider: dlf
  #(可选)提交用户名,建议为不同作业设置不同的提交用户以避免冲突
  commit.user: your_job_name
  #(可选)开启删除向量,提升读取性能
  table.properties.deletion-vectors.enabled: true
MySQL 原始 binlog 同步 Kafka
Flink CDC数据摄入支持同步MySQL 原始binlog内容到 canal json,如下作业可以同步多张表的binlog到 topic order_dw_tables。
source:
  type: mysql
  hostname: #{hostname}
  port: 3306
  username: #{username}
  password: #{password}
  tables: order_dw.\.*
  server-id: 28601-28604
  #(可选)同步增量阶段新创建的表的数据
  scan.binlog.newly-added-table.enabled: true
  #(可选)同步表注释和字段注释
  include-comments.enabled: true
  #(可选)优先分发无界的分片以避免可能出现的TaskManager OutOfMemory问题
  scan.incremental.snapshot.unbounded-chunk-first.enabled: true
  #(可选)开启解析过滤,加速读取
  scan.only.deserialize.captured.tables.changelog.enabled: true
  # 在 Canal JSON 中补充 mysqlType、sqlType、sql、isDdl 等信息
  include-binlog-meta.enable: true

sink:
  type: kafka
  properties.bootstrap.servers: localhost:9092
  topic: order_dw_tables
  # Kafka value 使用 Canal JSON changelog 格式
  value.format: canal-json
  # 指定序列化日期类型数据时使用的格式
  value.canal-json.timestamp-format.standard: SQL
  # 数据统一写入分区0,保证binlog顺序
  partition.strategy: all-to-zero
高级功能
表结构解析和变更同步策略
Kafka连接器会维护当前已知的所有表的Schema。
表结构信息初始化
表结构信息包含字段和数据类型信息、库表信息和主键信息,这三种信息的初始化方式如下:
字段和数据类型信息
数据摄入作业能够根据数据自动推导出表的字段和数据类型信息,然而在某些场景下,您可能希望指定某些表的字段和类型,根据用户指定字段类型的粒度,表结构信息的初始化有以下三种配置策略:
完全由程序推导表结构
在读取Kafka数据前,Kafka连接器会预先在每个分区中尝试消费最多scan.max.pre.fetch.records条消息,解析每条数据的Schema,再将这些Schema合并,用于初始化表结构信息。后续在实际消费数据前会根据初始化的Schema产生对应的建表事件。
对于Debezium JSON和Canal JSON格式,表信息在具体消息中,提前消费的scan.max.pre.fetch.records条消息中可能包含了若干个表的数据,因此对每张表而言,提前消费的数据条数无法确定。预消费和初始化表结构信息只会在实际消费和处理每个分区的消息前进行一次,若后续有新表数据,该表的第一条数据解析出的表结构会作为初始表结构,不会重新预消费和初始化对应的表结构。
仅VVR 8.0.11及以上版本支持单表数据分布在多个分区,对于该场景需要将配置项debezium-json.distributed-tables或canal-json.distributed-tables设为true。
指定初始表结构
在某些场景下,您希望自行指定初始的表结构,例如将 Kafka 的数据写入到一张预先创建的下游表中。这时您可以通过添加scan.value.initial-schemas.ddls参数指定初始的表结构。配置示例如下:
source:
  type: kafka
  name: Kafka Source
  properties.bootstrap.servers: host:9092
  topic: test-topic
  value.format: json
  scan.startup.mode: earliest-offset
  # 使用数据中的 db、table 字段作为 Table ID
  json.decode.parser-table-id.fields: db,table
  # 设置初始表结构
  scan.value.initial-schemas.ddls: CREATE TABLE db1.t1 (id BIGINT, name VARCHAR(10)); CREATE TABLE db1.t2 (id BIGINT);
这里的建表语句需要和目标表的表结构保持一致。这样,我们就为 db1.t1 这张表指定了 id 这个字段的初始类型为 BIGINT,name 这个字段的初始类型为 VARCHAR(10) ,为 db1.t2 这张表指定了 id 这个字段的初始类型为 BIGINT。
这里的建表语句使用的是 FlinkSQL 的语法。
指定字段设置为固定类型
在某些场景下,您希望固定特定字段的数据类型,例如对于某些可能被推导为 TIMESTAMP 类型的字段,您希望以字符串的格式下发,这时您可以通过添加json.infer-schema.fixed-types参数指定初始的表结构(仅在消息格式为 json 时有效)。配置示例如下:
source:
  type: kafka
  name: Kafka Source
  properties.bootstrap.servers: host:9092
  topic: test-topic
  value.format: json
  scan.startup.mode: earliest-offset
  # 设置特定字段始终为固定类型
  json.infer-schema.fixed-types: id BIGINT, name VARCHAR(10)
  scan.max.pre.fetch.records: 0
这样,我们就为所有的 id 字段指定了类型固定为 BIGINT,所有的 name 字段指定了类型固定为 VARCHAR(10)。
这里的类型与 FlinkSQL 的数据类型一致。
库表信息
对于Canal JSON和Debezium JSON格式,表信息由具体消息解析得到,包括数据库和表名。
对于JSON格式,默认配置下,表信息仅包含表名,即数据所在的topic名称。如果您的数据中包含库表信息,可以通过json.infer-schema.fixed-types指定库表信息所在的字段,我们会将这些字段映射到库名/表名中。配置示例如下:
source:
  type: kafka
  name: Kafka Source
  properties.bootstrap.servers: host:9092
  topic: test-topic
  value.format: json
  scan.startup.mode: earliest-offset
  # 使用 col1 字段中的值作为库名,使用 col2 字段中的值作为表名
  json.decode.parser-table-id.fields: col1,col2
这样,我们会将每条数据下发到库名为col1字段的值,表名为col2字段的值的表中。
主键信息
对于Canal JSON格式,会根据JSON中的pkNames字段定义表的主键。
对于Debezium JSON和JSON格式,JSON中不包含主键信息,可以通过transform规则手动为表添加主键:
transform:
  - source-table: \.*.\.*
    projection: \*
    primary-keys: key1, key2
Schema解析和Schema变更
在表结构初始化完成后,若schema.inference.strategy配置为static,Kafka连接器会根据初始的表结构解析每个消息的消息体(Value),不会产生Schema变更事件。若schema.inference.strategy配置为continuous,Kafka连接器会解析每个Kafka消息的消息体,解析出消息的物理列,并与当前维护的Schema比对,若解析出的Schema与当前Schema不一致时,会尝试将Schema合并,同时生成对应的表结构变更事件,合并规则如下:
如果解析出的物理列中包含当前Schema中没有的字段,则会将这些字段加入到Schema中,同时产生新增可空列事件。
如果解析出的物理列中不包含当前Schema中已有的字段,该字段仍会保留,该列的数据会填充为NULL,不产生删除列事件。
如果两者出现了同名列,则按照以下场景进行处理:
当类型相同且精度不同时,会取两者中较大精度的类型,同时产生列类型变更事件。
当类型不同时,会按照如下图的树形结构找到最小父节点,作为该同名列的类型,同时产生列类型变更事件。
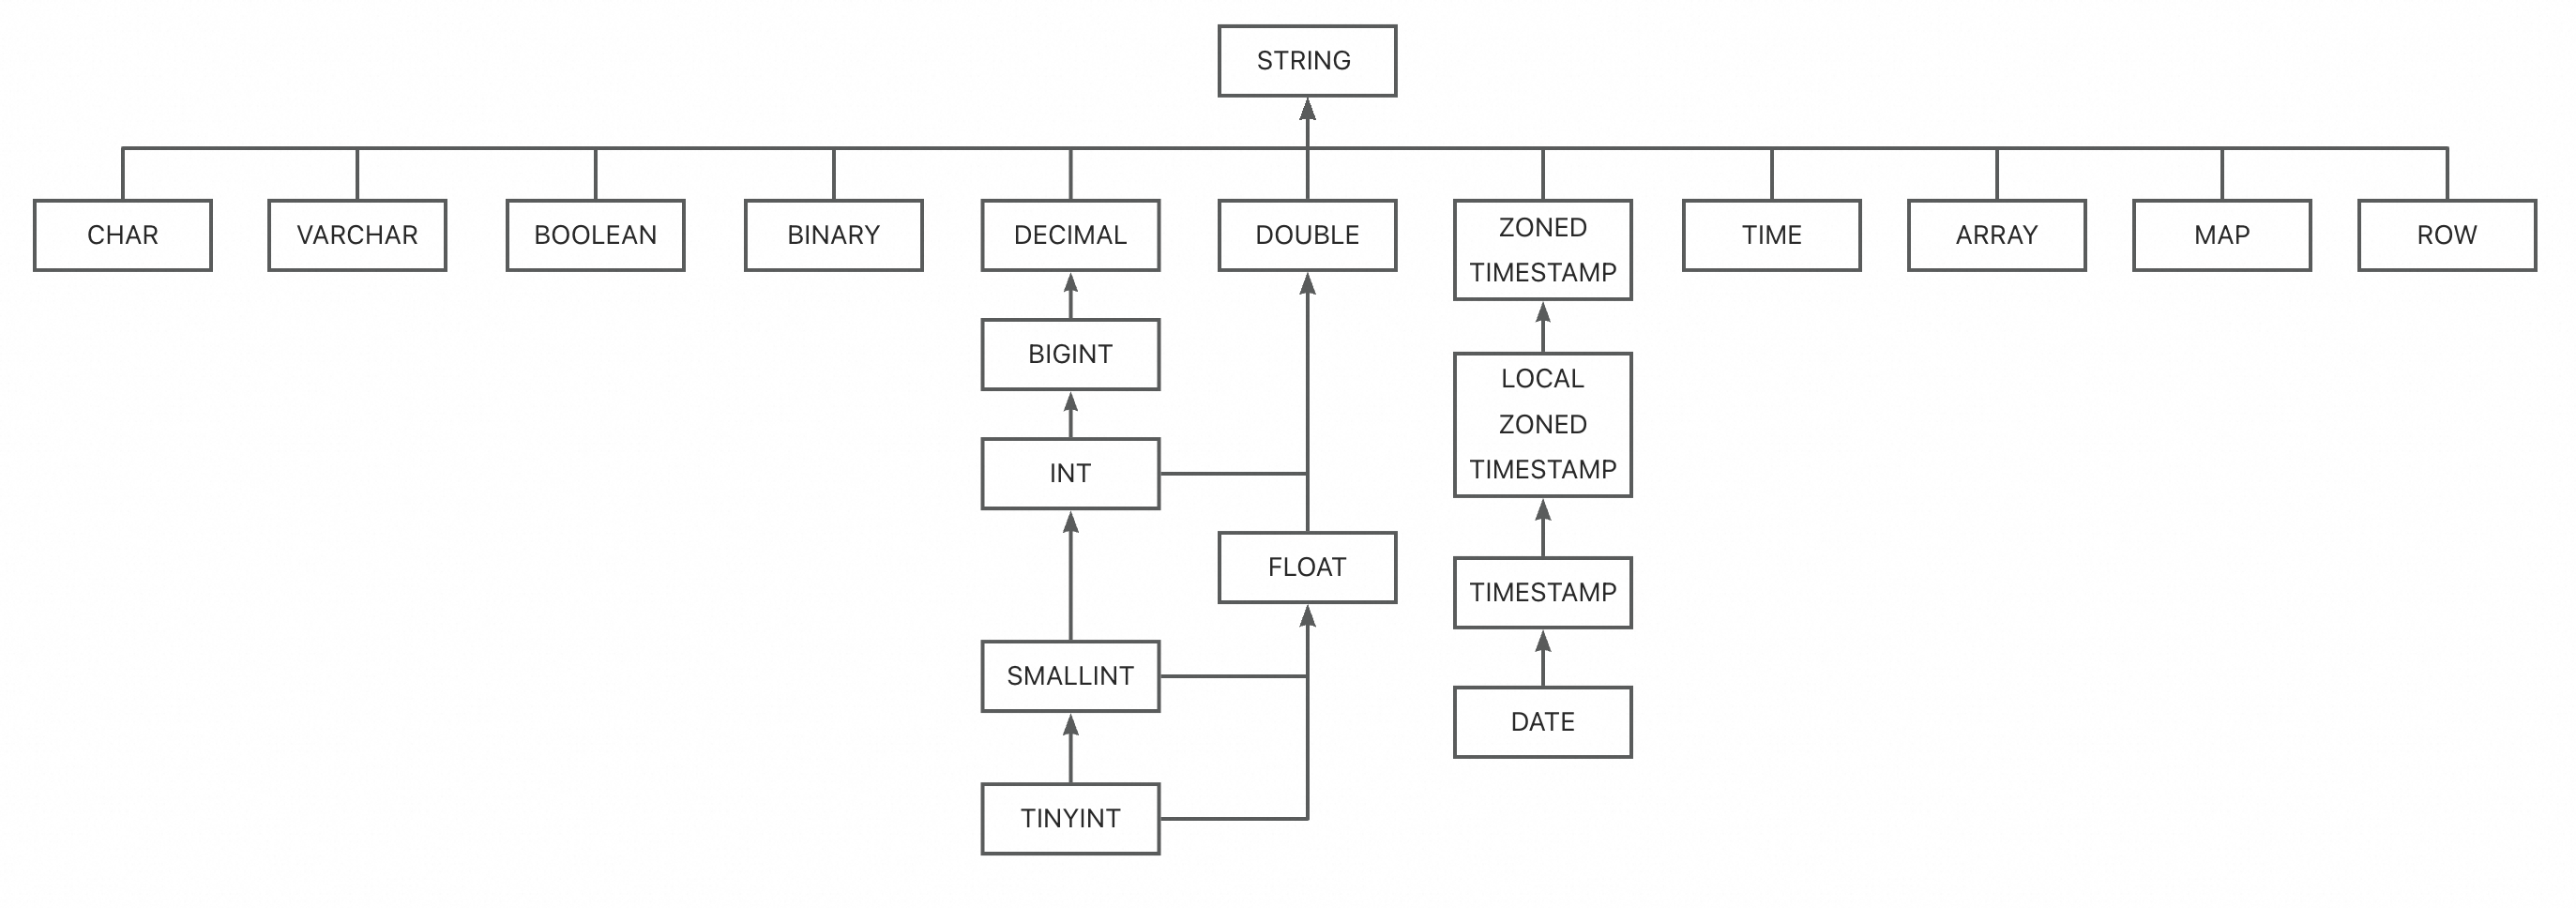
当前支持的Schema变更策略如下:
添加列:会在当前Schema末尾添加对应的列,并同步新增列的数据,新增的列会设置为可空列。
删除列:不会产生删除列事件,而是后续将该列的数据自动填充为NULL值。
重命名列:被看作为添加列和删除列,在当前Schema末尾添加重命名后的列,并将重命名前的列数据填充为NULL值。
列类型变更:
对于支持列类型变更的下游系统,在下游Sink支持处理列类型变更后,数据摄入作业支持普通列的类型变更,例如,从INT类型变更到BIGINT类型。此类变更依赖于下游Sink支持的列类型变更规则,不同的结果表支持的列类型变更规则也不相同,请参考结果表文档获取其支持的列类型变更规则。
对于不支持列类型变更的下游系统,比如Hologres,此类场景可以使用宽类型映射,即作业启动时在下游系统建立类型更加宽泛的表,在列类型变更发生时判断该类型变更下游Sink是否可以接受从而实现宽容的列类型变更支持。
当前暂不支持的Schema变更:
主键或索引等约束的变更。
从NOT NULL转为NULLABLE变更。
Canal JSON的Schema解析
Canal JSON数据中可能包含可选的sqlType字段,其中记录了数据列的精确类型信息。为了获取更准确的Schema,可以通过将canal-json.infer-schema.strategy配置为SQL_TYPE使用sqlType中的类型。类型映射关系如下:
JDBC类型
Type Code
CDC类型
BIT
-7
BOOLEAN
BOOLEAN
16
TINYINT
-6
TINYINT
SMALLINT
-5
SMALLINT
INTEGER
4
INT
BIGINT
-5
BIGINT
DECIMAL
3
DECIMAL(38,18)
NUMERIC
2
REAL
7
FLOAT
FLOAT
6
DOUBLE
8
DOUBLE
BINARY
-2
BYTES
VARBINARY
-3
LONGVARBINARY
-4
BLOB
2004
DATE
91
DATE
TIME
92
TIME
TIMESTAMP
93
TIMESTAMP
CHAR
1
STRING
VARCHAR
12
LONGVARCHAR
-1
其他类型
脏数据容忍与收集
在某些情况下,您的 Kafka 数据源中可能包含一些格式不正确的数据(脏数据),为了避免同步作业因为这些脏数据导致频繁失败重启,您可以配置忽略这部分异常数据。配置示例如下:
source:
  type: kafka
  name: Kafka Source
  properties.bootstrap.servers: host:9092
  topic: test-topic
  value.format: json
  scan.startup.mode: earliest-offset
  # 开启脏数据容忍功能
  ingestion.ignore-errors: true
  # 容忍 1000 条脏数据
  ingestion.error-tolerance.max-count: 1000
这里配置了忽略 1000 条脏数据的策略,让您的作业能够在存在小批量脏数据时正常运行,而在脏数据条数超过这个阈值时让作业进入失败状态,提醒您对数据进行校验。
如果您希望作业永远不因为脏数据的存在导致失败,可以采用如下的配置:
source:
  type: kafka
  name: Kafka Source
  properties.bootstrap.servers: host:9092
  topic: test-topic
  value.format: json
  scan.startup.mode: earliest-offset
  # 开启脏数据容忍功能
  ingestion.ignore-errors: true
  # 容忍所有的脏数据
  ingestion.error-tolerance.max-count: -1
脏数据容忍策略保障了作业不会因为异常数据频繁失败,您可能还希望进一步的了解这些脏数据的信息以调整 Kafka 数据生产者的行为,参考脏数据收集中介绍的流程,您可以在 TaskManager 日志中查看到作业的脏数据,配置示例如下:
source:
  type: kafka
  name: Kafka Source
  properties.bootstrap.servers: host:9092
  topic: test-topic
  value.format: json
  scan.startup.mode: earliest-offset
  # 开启脏数据容忍功能
  ingestion.ignore-errors: true
  # 容忍所有的脏数据
  ingestion.error-tolerance.max-count: -1

pipeline:
  dirty-data.collector:
    # 将脏数据写入 TaskManager 的日志文件中
    type: logger
表名与Topic的映射策略
在使用kafka作为数据摄入作业的目标端时,由于写入到Kafka消息格式(debezium-json或者canal-json)中还包含表名信息,后续消费Kafka消息时往往以数据中的表名信息作为实际表名(而非topic名称),因此需要谨慎配置表名与Topic的映射策略。
假设在MySQL有mydb.mytable1,mydb.mytable2两张表需要同步,可能的配置策略有以下几种:
1. 不配置任何映射策略
在没有任何映射策略的情况下,每张表会写入到对应的由“库名.表名”组成的topic中。因此mydb.mytable1的数据会写入到名为mydb.mytable1的topic中,mydb.mytable2的数据会写入到名为mydb.mytable2的topic中。配置示例如下:
source:
  type: mysql
  name: MySQL Source
  hostname: ${secret_values.mysql.hostname}
  port: ${mysql.port}
  username: ${secret_values.mysql.username}
  password: ${secret_values.mysql.password}
  tables: mydb.mytable1,mydb.mytable2
  server-id: 8601-8604

sink:
  type: kafka
  name: Kafka Sink
  properties.bootstrap.servers: ${kafka.bootstraps.server}
2. 配置route规则进行映射(不推荐)
在很多场景下,用户不希望写入的topic直接为“库名.表名”的格式,希望将数据写入到指定的topic中,因此会配置route规则进行映射。配置示例如下:
source:
  type: mysql
  name: MySQL Source
  hostname: ${secret_values.mysql.hostname}
  port: ${mysql.port}
  username: ${secret_values.mysql.username}
  password: ${secret_values.mysql.password}
  tables: mydb.mytable1,mydb.mytable2
  server-id: 8601-8604

sink:
  type: kafka
  name: Kafka Sink
  properties.bootstrap.servers: ${kafka.bootstraps.server}

 route:
  - source-table: mydb.mytable1,mydb.mytable2
    sink-table: mytable1
此时所有来自mydb.mytable1,mydb.mytable2的数据都会写入到mytable1这一个topic中。
然而,通过route规则修改写入的topic名称时,也会修改Kafka消息(debezium-json或者canal-json格式)中的表名信息,此时Kafka消息中所有的表名都为mytable1,在其他系统消费这个topic的Kafka消息时,可能出现不符合预期的情况。
3. 配置sink.tableId-to-topic.mapping参数进行映射(推荐)
为了在配置表名与Topic的映射规则的同时保留源表表名信息,可以使用sink.tableId-to-topic.mapping参数完成该需求。配置示例如下:
source:
  type: mysql
  name: MySQL Source
  hostname: ${secret_values.mysql.hostname}
  port: ${mysql.port}
  username: ${secret_values.mysql.username}
  password: ${secret_values.mysql.password}
  tables: mydb.mytable1,mydb.mytable2
  server-id: 8601-8604

sink:
  type: kafka
  name: Kafka Sink
  properties.bootstrap.servers: ${kafka.bootstraps.server}
  sink.tableId-to-topic.mapping: mydb.mytable1,mydb.mytable2:mytable
或者
source:
  type: mysql
  name: MySQL Source
  hostname: ${secret_values.mysql.hostname}
  port: ${mysql.port}
  username: ${secret_values.mysql.username}
  password: ${secret_values.mysql.password}
  tables: mydb.mytable1,mydb.mytable2
  server-id: 8601-8604

sink:
  type: kafka
  name: Kafka Sink
  properties.bootstrap.servers: ${kafka.bootstraps.server}
  sink.tableId-to-topic.mapping: mydb.mytable1:mytable;mydb.mytable2:mytable
此时所有来自mydb.mytable1,mydb.mytable2的数据都会写入到mytable1这一个topic中,并且Kafka消息(debezium-json或者canal-json格式)中的表名信息仍然为mydb.mytable1或者mydb.mytable2,在其他系统消费这个topic的Kafka消息时,能正确获取源表表名信息。
JSON Converter实现
JSON格式的数据有时无法保证格式完全一致,或者有处理需求无法通过Transform配置模块完成,例如合并两个列为新的列并删除原有的两列,并保证能进行 Schema 变更同步。为了更灵活处理JSON数据,可以通过实现KafkaPayloadConverter接口在框架处理前,提前对JSON数据进行修改,使用时需要添加配置json.decode.converter-class填写具体实现类的全限定名。
实现和使用JSON Converter的流程如下:
实现KafkaPayloadConverter接口并打包,在开源Demo仓库已经提供了一些实现示例。
将打好的包添加到数据摄入作业的附加依赖。
在Source模块填写json.decode.converter-class配置,以开源项目中的ArrayElementExtractorConverter类为例:
source:
  type: kafka
  properties.bootstrap.servers: localhost:9092
  topic: my_cdc_topic
  properties.group.id: flink-cdc-group
  scan.startup.mode: earliest-offset
  value.format: json
  # 对 Kafka 消息 value 的 JSON 数据应用自定义转换器
  value.json.decode.converter-class: org.apache.flink.cdc.connectors.kafka.ArrayElementExtractorConverter
部署作业并运行。
key format和value format
在VVR 11.5及以前的版本中,key format 和 value format的配置无法进行区分,当使用相同的format时,format配置会同时应用在key format和value format。
VVR 11.6及以后的版本对这部分进行了优化,以json format 为例,format 的配置项的传递规则如下:
format前缀(如json.infer-schema.primitive-as-string): 为了保持版本兼容,format前缀的配置会默认同时应用到 key format和 value format。
key前缀加format前缀(如key.json.infer-schema.primitive-as-string): key前缀加format前缀的配置会只应用在key format,优先级比format前缀的配置更高。
value前缀加format前缀(如value.json.infer-schema.primitive-as-string): value前缀加format前缀的配置会只应用在value format,优先级比format前缀的配置更高。
如下的Kafka source配置,为key format和value format配置了不同的JSON Converter。
source:
  type: kafka
  properties.bootstrap.servers: localhost:9092
  topic: my_cdc_topic
  properties.group.id: flink-cdc-group
  scan.startup.mode: earliest-offset
  key.format: json
  value.format: json
  # 对 Kafka 消息 key 的 JSON 数据应用自定义转换器
  key.json.decode.converter-class: com.example.KeyExampleConverter
  # 对 Kafka 消息 value 的 JSON 数据应用自定义转换器
  value.json.decode.converter-class: com.example.ValueExampleConverter