Tablestore vektör araması (KnnVectorQuery), büyük ölçekli veri kümelerindeki en benzer veri öğelerini bulmak için sayısal vektörler kullanarak yaklaşık en yakın komşu sorguları gerçekleştirir. Yaygın kullanım senaryoları arasında bilgi alma destekli üretim (RAG), öneri sistemleri, benzerlik tespiti, doğal dil işleme ve anlamsal arama yer alır.
Senaryolar
Vektör araması; öneri sistemleri, görüntü ve video erişimi, doğal dil işleme ve anlamsal arama gibi alanlarda uygulanır.
-
Bilgi alma destekli üretim (RAG)
RAG, özellikle özel veya kurumsal verilerde Büyük Dil Modellerinin (LLM) çıktı doğruluğunu artırmak amacıyla bilgi almayı LLM'lerle birleştiren bir yapay zeka çerçevesidir. RAG, bilgi tabanı senaryolarında yaygın olarak kullanılır.
-
Öneri sistemi
E-ticaret, sosyal medya ve akış platformlarında kullanıcı davranışları, tercihler ve içerik özellikleri vektörlere kodlanır. Vektör araması eşleşen ürünleri, makaleleri veya videoları bularak kişiselleştirilmiş öneriler sunar; böylece kullanıcı memnuniyeti ve sadakati artar.
-
Benzerlik tespiti (görüntüler, videolar ve ses)
Görüntü, video, ses, ses izi ve yüz tanıma süreçlerinde yapılandırılmamış veriler vektör temsillerine dönüştürülür. Vektör araması ardından en benzer hedefleri bulur. Örneğin, bir kullanıcı bir e-ticaret platformuna görüntü yüklediğinde sistem benzer stil, renk veya desene sahip ürün görsellerini bulur.
-
Doğal dil işleme ve anlamsal arama
Doğal dil işleme (NLP) alanında metinler Word2Vec veya BERT gömme gibi vektör temsillerine dönüştürülür. Vektör araması sorgu anlamını eşleştirerek en alakalı belgeleri, haberleri veya Soru&Cevap çiftlerini bulur; böylece arama sonuçlarının alaka düzeyi ve kullanıcı deneyimi iyileşir.
-
Bilgi grafiği ve yapay zeka sohbeti
Bilgi grafiği düğümleri ve ilişkileri vektörler olarak temsil edilebilir. Vektör araması varlık bağlama, ilişki çıkarımı ve yapay zeka sohbeti yanıt sürelerini hızlandırarak karmaşık sorulara daha doğru yanıtlar verilmesini sağlar.
Temel avantajlar
Düşük maliyet
Çekirdek motor optimize edilmiş DiskAnn teknolojisini kullanır. Hiyerarşik Gezinilebilir Küçük Dünya (HNSW) algoritmasının aksine DiskAnn tüm dizin verilerini belleğe yüklemez. HNSW ile karşılaştırılabilir bir geri çağırma oranı ve performans sunarken %10'dan daha az bellek kullanır ve benzer sistemlere kıyasla maliyetleri önemli ölçüde düşürür.
Kullanım kolaylığı
Vektör araması, arama dizininin sunucusuz bir alt özelliğidir. Sistem kurulumu veya dağıtımı gerekmez. Başlamak için Tablestore konsolunda bir örnek oluşturun.
Özellik kullandıkça öde faturalama yöntemini destekler; kullanım düzeyi yönetimi veya manuel yatay ölçeklendirme gerektirmez. Sistem hem depolama hem de hesaplama için yatay olarak ölçeklenir. Vektör araması yüz milyarlarca veri girişine kadar desteklerken vektör dışı arama on trilyon veri girişine kadar destekler.
Vektör araması sırasında dahili motor, bir sorgu optimize edici kullanarak en iyi algoritma ve yürütme yolunu otomatik olarak seçer. Kapsamlı parametre ayarı yapmadan yüksek geri çağırma ve performansa ulaşabilirsiniz; bu da giriş engelini düşürür ve geliştirme döngüsünü kısaltır.
Vektör aramasına SQL, Java, Go, Python ve Node.js gibi birden çok dil için SDK'lar ve LangChain, LangChain4J ile LlamaIndex gibi açık kaynaklı çerçeveler aracılığıyla erişebilirsiniz.
İşlev genel bakışı
KnnVectorQuery, sayısal vektörler üzerinde yaklaşık en yakın komşu sorgusu gerçekleştirerek büyük ölçekli bir veri kümesindeki en benzer veri öğelerini bulur.
Vektör araması bir arama dizininin tüm özelliklerini devralır. Kullanıma hazır, kullandıkça öde bir hizmet olarak sistem dağıtımı gerektirmez. Akış tabanlı dizin oluşturma, verilerin yazıldıktan sonra neredeyse gerçek zamanlı olarak sorgulanmasına olanak tanır. Ayrıca yüksek aktarım hızlı ekleme, güncelleme ve silme işlemlerini destekler ve HNSW tabanlı sistemlerle karşılaştırılabilir sorgu performansı sunar.
KnnVectorQuery'i kullanmak için sorgu vektörünü, aranacak vektör alanını ve alınacak en yakın komşu sayısını (TopK) belirtin. Sorgu, sorgu vektörüne en benzer TopK vektörleri döndürür. Gerektiğinde sonuçları filtrelemek için bunu diğer vektör dışı arama özellikleriyle birleştirebilirsiniz.
Vektör alanı açıklaması
KnnVectorQuery'i kullanmadan önce bir arama dizini oluştururken bir vektör alanı yapılandırın. Vektör boyutlarını, veri türünü ve uzaklık ölçüm algoritmasını belirtin.
Veri tablosundaki karşılık gelen alan String veri türünü kullanmalı ve arama dizini Float32 dize dizisi kullanmalıdır. Vektör alanı yapılandırması hakkında ayrıntılı bilgi için aşağıdaki tabloya bakın.
|
Yapılandırma öğesi |
Açıklama |
|
dimension |
Vektör boyutları. Desteklenen maksimum boyut 4096'dır. Değer, yukarı akıştaki gömme sistemi tarafından üretilen vektörlerin boyutuyla eşleşmelidir. Vektör alanının dizi uzunluğu yapılandırılan dimension parametresine eşit olmalıdır. Örneğin, vektör alanı değeri Not
Yalnızca yoğun vektörler desteklenir. Vektör alanı boyutu, dizin oluşturulduğunda şemada ayarlanan boyutla eşleşmelidir. Eşleşmemesi durumunda o satır için dizin oluşturma işlemi başarısız olur. |
|
dataType |
Vektörün veri türü. Yalnızca Float32 desteklenir. Float32, NaN ve Infinite gibi aşırı değerleri desteklemez. Veri türü, yukarı akıştaki gömme sistemi tarafından üretilen vektör veri türüyle eşleşmelidir. Not
Diğer veri türlerine sahip vektörleri kullanmak için destek talebi gönderin şeklinde bizimle iletişime geçin. |
|
metricType |
Vektörler arasındaki mesafeyi ölçmek için kullanılan algoritma. Geçerli değerler: euclidean, cosine ve dot_product. Uzaklık ölçüm algoritması, yukarı akıştaki gömme sisteminin önerilen algoritmasıyla eşleşmelidir. Daha fazla bilgi için bkz. Uzaklık ölçüm algoritmaları. |
Bir gömme sisteminin farklı modelleri veya sürümleri boyut, veri türü ve uzaklık ölçüm algoritması dahil olmak üzere farklı özelliklere sahip vektörler üretir. Vektör arama sistemindeki vektör alanının özellikleri (boyut, veri türü ve uzaklık ölçüm algoritması) gömme sistemi tarafından üretilen vektörlerin özellikleriyle eşleşmelidir. Vektör oluşturma hakkında daha fazla bilgi için bkz. Vektör oluşturmanın iki yolu.
Uzaklık ölçüm algoritmaları
Vektör araması euclidean, cosine ve dot_product olmak üzere üç uzaklık ölçüm algoritmasını destekler. Daha yüksek puan iki vektör arasında daha büyük benzerlik olduğunu gösterir.
|
MetricType |
Puanlama formülü |
Performans |
Açıklama |
|
Öklid mesafesi (euclidean) |
|
Yüksek |
Öklid mesafesi, çok boyutlu bir uzayda iki vektör arasındaki düz çizgi mesafesini ölçer. Performans için Tablestore uygulaması son karekök hesaplamasını atlar. Daha yüksek puan daha büyük benzerlik anlamına gelir. |
|
Nokta çarpımı (dot_product) |
|
En yüksek |
Nokta çarpımı, aynı boyuttaki iki vektörün karşılık gelen koordinatlarını çarpar ve sonuçları toplar. Daha yüksek puan daha büyük benzerlik anlamına gelir. Önemli
Float32 vektörlerini bir tabloya yazmadan önce normalize edin; örneğin L2 normunu kullanın. Normalizasyon yapılmazsa kötü sorgu sonuçları, yavaş vektör dizini oluşturma ve düşük sorgu performansı gibi sorunlar ortaya çıkabilir. Vektör normalizasyonu örneği için bkz. Ek 2: Vektör normalizasyonu örneği. |
|
Kosinüs benzerliği (cosine) |
|
Düşük |
İki vektör arasındaki açının kosinüsünü ölçer. Daha yüksek puan daha büyük benzerlik anlamına gelir. Kosinüs benzerliği genellikle metin verileri için kullanılır. Sıfıra bölme tanımsız olduğundan bir Float32 vektörünün kareler toplamı 0 ise kosinüs benzerliği hesaplanamaz. Önemli
Kosinüs benzerliği hesaplaması karmaşıktır. Verileri tabloya yazmadan önce vektörleri normalleştirmenizi ve uzaklık ölçüm algoritması olarak dot_product kullanmanızı öneririz. Vektör normalizasyonu örneği için bkz. Ek 2: Vektör normalizasyonu örneği. |
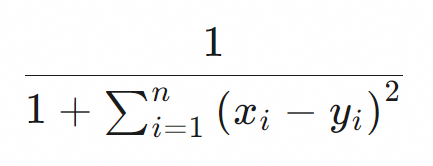
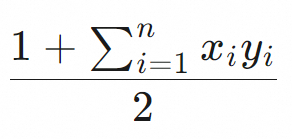
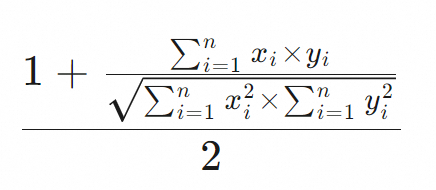
Notlar
Vektör aramasını kullanırken aşağıdaki hususlara dikkat edin:
Vektör alanı türlerinin sayısı, boyutları ve diğer özellikleri için sınırlamalar geçerlidir. Daha fazla bilgi için bkz. Arama dizini sınırlamaları.
Arama dizini sunucu tarafında bölümlere ayrılır. Her bölüm kendi TopK en yakın komşularını döndürür ve sonuçlar daha sonra istemci düğümünde toplanır. Bu nedenle, tüm verilere göz atmak için bir token kullanılırsa döndürülen toplam satır sayısı sunucu tarafındaki bölüm sayısına bağlıdır.
Şu anda vektör arama özelliği aşağıdaki bölgelerde kullanılabilir: Çin (Hangzhou), Çin (Shanghai), Çin (Qingdao), Çin (Beijing), Çin (Zhangjiakou), Çin (Ulanqab), Çin (Shenzhen), Çin (Guangzhou), Çin (Chengdu), Çin (Hong Kong), Japonya (Tokyo), Singapur, Malezya (Kuala Lumpur), Endonezya (Cakarta), Filipinler (Manila), Tayland (Bangkok), Almanya (Frankfurt), Birleşik Krallık (Londra), ABD (Virginia), ABD (Silicon Valley), Suudi Arabistan (Riyad - İş Ortağı Bölgesi).
Yordam
-
Tablestore'daki verileri vektörlere dönüştürmek ve depolamak için açık kaynaklı modelleri kullanın.
Tablestore'a vektör verileri yazın.
-
Bir arama dizini oluştururken vektör alanını yapılandırın.
Vektör alanının türünü, boyutlarını ve uzaklık ölçüm algoritmasını yapılandırın.
Verileri sorgulamak için vektör aramasını kullanın.
Faturalama
Genel önizleme sırasında KNN vektör sorgusu özelliğine özgü faturalandırılabilir öğeler için ücret alınmaz. Diğer faturalandırılabilir öğeler mevcut faturalama kurallarına göre ücretlendirilir.
Bir arama dizini kullanarak veri sorguladığınızda tüketilen okuma aktarım hızı için ücretlendirilirsiniz. Daha fazla bilgi için bkz. Arama dizinlerinin faturalandırılabilir öğeleri.
Ek 1: BoolQuery ile birlikte kullanım
KnnVectorQuery ve BoolQuery farklı şekillerde birleştirilebilir. Aşağıdaki iki örnek bir filtrenin az miktarda veriyi eşleştirdiği bir senaryoyu varsayar.
Bir tabloda 100 milyon görüntü bulunduğunu varsayalım. Bir kullanıcının toplamda 50.000 görüntüsü vardır ancak bunlardan yalnızca 50'si son 7 günde eklenmiştir. Kullanıcı, görüntüye göre arama kullanarak son 7 günde eklenen görüntüler arasından en benzer 10 görüntüyü bulmak istemektedir. Aşağıdaki tablo bu iki birleştirme yönteminin nasıl farklılaştığını göstermektedir.
|
|
|
|
|
|
|
KnnVectorQuery BoolQuery koşulunu karşılayan satırlara isabet eder ve en benzer TopK satırları döndürür. SearchRequest yanıtı TopK sonuçlarından ilk Bu örnekte KnnVectorQuery önce filtreyi kullanarak "a" kullanıcısına ait son 7 gündeki tüm 50 görüntüyü seçer ardından bu 50 görüntü arasından en benzer 10 görüntüyü bulur ve döndürür. |
|
|
|
BoolQuery'deki her alt sorgu önce çalıştırılır ve ardından tüm alt sorgu sonuçlarının kesişimi hesaplanır. Bu örnekte KnnVectorQuery tabloda bulunan 100 milyon görüntü arasından en benzer ilk 500 görüntüyü döndürür ardından "a" kullanıcısına ait son 7 gündeki 10 görüntüyü sırayla bulur. Ancak en benzer ilk 500 görüntü "a" kullanıcısının son 7 gündeki 50 görüntüsünün tamamını içermeyebilir. Bu nedenle bu sorgu yöntemi son 7 gündeki en benzer 10 görüntüyü bulamayabilir ve hatta hiç veri döndürmeyebilir. |


Ek 2: Vektör normalizasyonu örneği
Aşağıdaki kod bir vektörü normalize eder:
  public static float[] l2normalize(float[] v, boolean throwOnZero) {
    double squareSum = 0.0f;
    int dim = v.length;
    for (float x : v) {
      squareSum += x * x;
    }
    if (squareSum == 0) {
      if (throwOnZero) {
        throw new IllegalArgumentException("can't normalize a zero-length vector");
      } else {
        return v;
      }
    }
    double length = Math.sqrt(squareSum);
    for (int i = 0; i < dim; i++) {
      v[i] /= length;
    }
    return v;
  }