SQL Geliştirme, manuel müdahale gerektirmeden Simple Log Service'te sorgu ve analizleri hızlandırmak için depolama ve hesaplama kaynaklarını esnek şekilde ölçeklendirir.
Nasıl çalışır
Arka plan
Simple Log Service, depolamayı hesaplamadan ayırır: parça tabanlı depolama katmanı veri depolama ve yönetimini üstlenirken, hesaplama katmanı sorgu ve analiz için SQL kullanır.
Analiz performansını artırmak için bu katmanlardan birini veya her ikisini iyileştirebilirsiniz. Aşağıdaki bölümlerde yaygın yaklaşımlar karşılaştırılmaktadır.

Çözüm 1: Bir parçayı bölme
Depolama kapasitesini genişletmek ve dolaylı olarak hesaplama aktarım hızını artırmak için bir parçayı manuel olarak bölün.
Sınırlamalar:
Bu yöntem yalnızca yeni yazılan veriler için geçerlidir.
Aktif parçalar ücretlendirmeye tabidir. Faturalama.
Tek bir sorgu, eşzamanlılık ve veri hacmi tarafından sınırlanır.
Parçaları manuel olarak bölmek veya birleştirmek gerekir.
Çözüm 2: Sorguları parçalara ayırma
Büyük bir sorguyu birden fazla alt sorguya ayırın ve sonuçları toplayın.
Sınırlamalar:
İkincil toplama mantığının ve ara depolamanın korunmasını gerektirir. Bunun için Planlanmış SQL kullanın.
Analiz boyutlarının değiştirilmesi, toplama mantığının yeniden oluşturulmasını gerektirir.
Çok büyük veri hacimlerinde hesaplama darboğazları hala oluşabilir.
Çözüm 3: SQL Geliştirme kullanma
SQL Geliştirme, veri hacmine göre depolama ve hesaplama kaynaklarını dinamik olarak ölçeklendirerek manuel ayar gerektirmeden daha hızlı analiz sağlar.

|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Büyük sorguları alt sorgulara ayırmanız gerekir. |
|
|
|
|
|
|
Ön koşullar
Bir Standard LogStore oluşturulmuştur. Daha fazla bilgi için bkz. Temel LogStore Oluşturma.
Günlükler toplanmıştır. Daha fazla bilgi için bkz. Veri toplama.
Dizinler yapılandırılmıştır. Daha fazla bilgi için bkz. Dizinleri yapılandırma.
Yordam
SQL Geliştirme'yi aşağıdaki yollardan biriyle etkinleştirin:
Tek bir sorgu için etkinleştirme: Yalnızca LogStore'daki mevcut sorgu için geçerlidir.
Varsayılan olarak etkinleştirme: Uyarılar ve panolar dahil olmak üzere Project'teki tüm sorgular için geçerlidir.
Konsol
Tek bir sorgu için etkinleştirme
Simple Log Service konsolunda oturum açın.
-
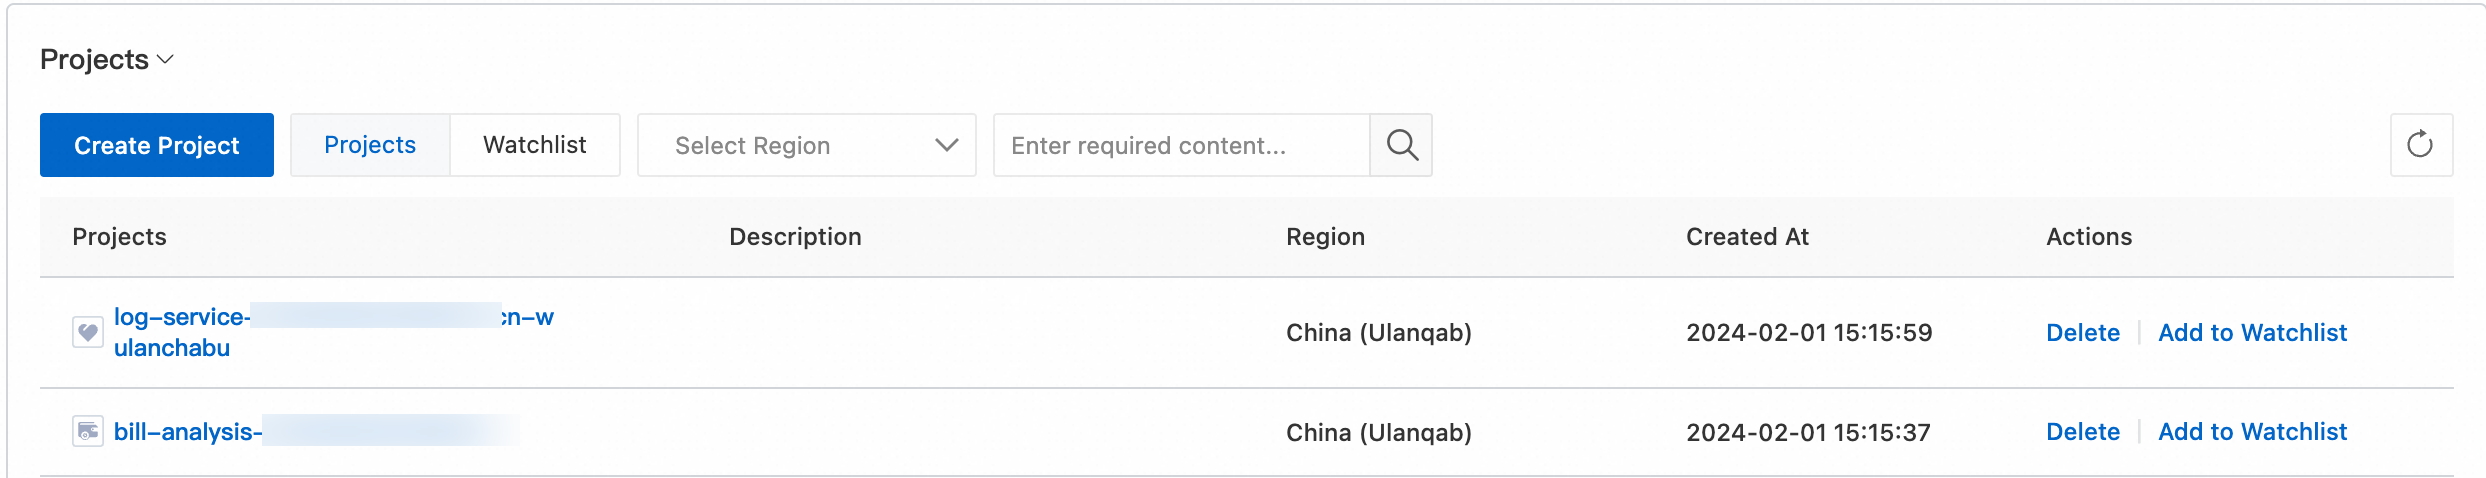
Projects bölümünde istediğiniz projeyi tıklayın.
-
sekmesinde istediğiniz LogStore'u tıklayın.
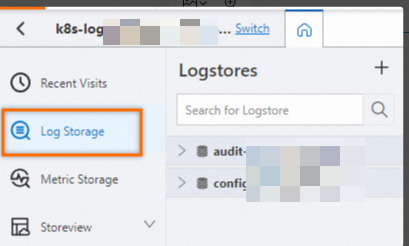
 > SQL Enhancement öğelerini tıklayın.
Varsayılan olarak etkinleştirme
Simple Log Service konsolunda oturum açın.
-
Projects bölümünde istediğiniz projeyi tıklayın.
-
 simgesini tıklayın.
Proje listesine dönmek veya Projeler arasında geçiş yapmak için üst gezinme çubuğundaki Home simgesini tıklayın.
CUs of SQL-dedicated Instance üzerine gelin ve Settings öğesini tıklayın.
Modify CUs of SQL-dedicated Instance panelinde Enable by Default anahtarını açın ve ardından OK öğesini tıklayın.
API
Tek bir sorgu için etkinleştirme
-
GetLogs (sıkıştırılmamış sonuçlar döndürür) - LogStore'da günlükleri sorgulama
Aşağıdaki parametrelerden birini yapılandırın.
powerSqlparametresi: SQL Geliştirme için true, Standart SQL için false (varsayılan) olarak ayarlayın.queryparametresi: SQL ifadenizin başınaset session parallel_sql=true;ekleyin. Örneğin,* | select count(*) as pvifadesi* | set session parallel_sql=true; select count(*) as pvhaline gelir.
-
GetLogsV2 (sıkıştırılmış sonuçlar döndürür) - LogStore'da günlük verilerini sorgulama
Aşağıdaki parametrelerden birini yapılandırın.
powerSqlparametresi: SQL Geliştirme için true, Standart SQL için false (varsayılan) olarak ayarlayın.queryparametresi: SQL ifadenizin başınaset session parallel_sql=true;ekleyin. Örneğin,* | select count(*) as pvifadesi* | set session parallel_sql=true; select count(*) as pvhaline gelir.
Varsayılan olarak etkinleştirme
Özel SQL örneği oluşturma işleminde, Project için SQL Geliştirme'yi varsayılan olarak etkinleştirmek üzere useAsDefault=true değerini ayarlayın.
SDK
Aşağıdaki örnekler Java SDK'yı kullanmaktadır.
Ön koşullar
Tek bir sorgu için etkinleştirme
-
GetLogs() yöntemi
Aşağıdaki parametrelerden birini yapılandırın.
powerSqlparametresi: SQL Geliştirme için true, Standart SQL için false (varsayılan) olarak ayarlayın.queryparametresi: SQL ifadenizin başınaset session parallel_sql=true;ekleyin. Örneğin,* | select count(*) as pvifadesi* | set session parallel_sql=true; select count(*) as pvhaline gelir.
import com.aliyun.openservices.log.Client;
import com.aliyun.openservices.log.exception.LogException;
import com.aliyun.openservices.log.response.GetLogsResponse;
import java.util.Date;
public class CreateSqlInstance {
    public static void main(String[] args) throws LogException {
        // This example shows how to obtain an AccessKey ID and an AccessKey secret from environment variables.
        String accessId = System.getenv("ALIBABA_CLOUD_ACCESS_KEY_ID");
        String accessKey = System.getenv("ALIBABA_CLOUD_ACCESS_KEY_SECRET");
        // The endpoint for Simple Log Service. This example uses the endpoint for the China (Hangzhou) region. Replace it with the actual endpoint.
        String host = "https://cn-hangzhou.log.aliyuncs.com";
        // Create a Simple Log Service client.
        Client client = new Client(host, accessId, accessKey);
        // The Project name.
        String projectName = "aliyun-project-test";
        // The Logstore name.
        String logstore = "request_log";
        // Specifies whether to enable SQL Enhancement by default. Default value: false.
        boolean useAsDefault = true;
        // The SQL query statement.
        String query = "* | select count(1)";
        // The maximum number of logs to return. This parameter is valid only when the query parameter is a search statement. Value range: 0 to 100. Default value: 100.
        int line = 3;
        // The line number from which to start the query. This parameter is valid only when the query parameter is a search statement. Default value: 0.
        int offset = 0;
        // Specifies whether to return logs in reverse chronological order of log timestamps, accurate to the minute.
        // true: Returns logs in reverse chronological order.
        // false (default): Returns logs in chronological order.
        boolean reverse = false;
        // Specifies whether to use SQL Enhancement.
        // true: Use SQL Enhancement.
        // false (default): Use Standard SQL.
        boolean powerSql = true;
        int from = (int) (new Date().getTime() / 1000 - 600);
        int to = (int) (new Date().getTime() / 1000);
        GetLogsResponse getLogsResponse = client.GetLogs(projectName, logstore, from, to, "", query, line, offset, reverse, powerSql);
        System.out.println(getLogsResponse.getCpuSec());
    }
}
Varsayılan olarak etkinleştirme
Project için SQL Geliştirme'yi varsayılan olarak etkinleştirmek amacıyla boolean useAsDefault = true değerini ayarlayın.
import com.aliyun.openservices.log.Client;
import com.aliyun.openservices.log.exception.LogException;
import com.aliyun.openservices.log.request.CreateOrUpdateSqlInstanceRequest;
public class CreateSqlInstance {
    public static void main(String[] args) throws LogException {
        // This example shows how to obtain an AccessKey ID and an AccessKey secret from environment variables.
        String accessId = System.getenv("ALIBABA_CLOUD_ACCESS_KEY_ID");
        String accessKey = System.getenv("ALIBABA_CLOUD_ACCESS_KEY_SECRET");
        // The Project name.
        String projectName = "aliyun-test-project";
        // The endpoint for Simple Log Service. This example uses the endpoint for the China (Hangzhou) region. Replace it with the actual endpoint.
        String host = "https://cn-hangzhou.log.aliyuncs.com";
        // Create a Simple Log Service client.
        Client client = new Client(host, accessId, accessKey);
        int cu = 100;
        boolean useAsDefault = true;
        client.createSqlInstance(new CreateOrUpdateSqlInstanceRequest(projectName, cu, useAsDefault));
    }
}SSS
-
CPU süresini nasıl kontrol edebilirim?
Bir sorgu çalıştırdıktan sonra, CPU süresini görüntülemek için Analysis Results üzerine gelin. Sağ üstteki istatistik panelindeki Consumed CPU Time alanı CPU süresini saniye cinsinden gösterir.
-
Özel SQL sorgusunun maliyeti
Maliyet, veri hacmine ve sorgu karmaşıklığına göre değişir.
Sorgu ifadesi
Veri hacmi (satır)
Çalıştırma başına maliyet (USD)
* | select avg(double_0) from stress_s1_mil14 milyar
0.004435
* | select avg(double_0), sum(double_0), max(double_0), min(double_0), count(double_0) from stress_s1_mil14 milyar
0.006504
* | select avg(double_0), sum(double_1), max(double_2), min(double_3), count(double_4) from stress_s1_mil14 milyar
0.013600
* | select key_0 , avg(double_0) as pv from stress_s1_mil1 group by key_0 order by pv desc limit 10004 milyar
0.011826
* | select long_0, avg(double_0) as pv from stress_s1_mil1 group by long_0 order by pv desc limit 10004 milyar
0.011087
* | select long_0, long_1, avg(double_0) as pv from stress_s1_mil1 group by long_0,long_1 order by pv desc limit 1000300 milyon
0.010791
* | select avg(double_0) from stress_s1_mil1 where key_0='key_987'4 milyar
0.00007