Bir Tair (OSS ile uyumlu Redis) örneği bellek yetersizliği yaşadığında sık anahtar tahliyesi, artan yanıt süreleri ve kararsız QPS gibi sorunlar ortaya çıkabilir; bu durum iş süreçlerinizi etkiler. Örneğinizin belleği dolduysa veya bellek uyarıları alıyorsanız bellek kullanımının sürekli yüksek olup olmadığını, ani artış gösterip göstermediğini veya çarpık dağılıp dağılmadığını belirlemek için bu konuyu kullanın. Ardından büyük anahtarları bölerek, sona erme ilkesi belirleyerek veya örnek teknik özelliklerini yükselterek sorunu çözebilirsiniz.
Yüksek bellek kullanımına ilişkin senaryolar
Yüksek bellek kullanımı genellikle aşağıdaki üç senaryodan birine girer:
Bellek kullanımı uzun süre yüksek seviyede kalır. Genel kural olarak bellek kullanımı %95'i aştığında müdahale etmeniz gerekir.
Bellek kullanımı tutarlı şekilde düşüktür ancak ani şekilde yüksek seviyelere çıkar hatta zaman zaman %100'e ulaşır.
Örneğin genel bellek kullanımı düşüktür ancak belirli bir veri düğümünün bellek kullanımı %100'e yakındır.
Bellek kullanımını azaltmak için senaryonuzla eşleşen çözümü uygulayın.
Sürekli yüksek bellek kullanımı için çözümler
Mevcut anahtarların iş gereksinimlerinizi karşılayıp karşılamadığını kontrol edin ve gereksiz anahtarları derhal temizleyin.
-
Büyük anahtarların dağılımını ve anahtarlar için TTL sona erme ilkelerini analiz etmek üzere önbellek analizi özelliğini kullanabilirsiniz. Daha fazla bilgi için bkz. Çevrimdışı anahtar analizi.
-
Anahtarın makul bir TTL ilkesine sahip olup olmadığını analiz edin.
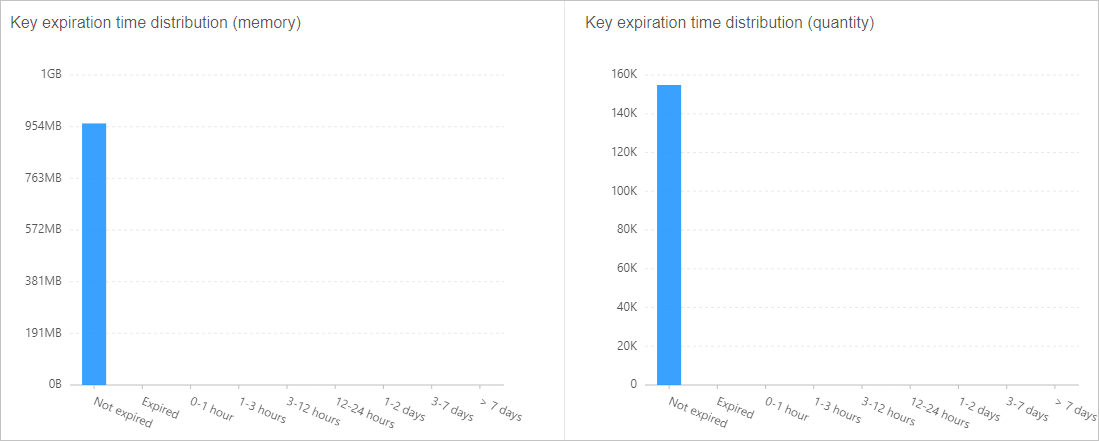
NotAşağıdaki örnekte hiçbir anahtar için sona erme süresi ayarlanmamıştır. İş ihtiyaçlarınızı değerlendirerek istemci tarafında uygun sona erme süreleri ayarlamanızı öneririz.
Şekil 1. Anahtar sona erme süresi dağılımı örneği
-
Büyük anahtarı değerlendirin ve uygulama tarafında bölün.
Önbellek analizi sayfasında ayrıntıları görüntülemek için Large Key Analysis sekmesine tıklayın. Tablo anahtar adı, anahtar türü ve veri boyutu gibi bilgileri gösterir. Analiz sonuçlarını yerel makinenize indirmek için Export düğmesine tıklayabilirsiniz.
-
-
İş gereksinimlerinize göre maxmemory-policy parametresini yapılandırarak uygun bir tahliye ilkesi belirleyin. Özel talimatlar için bkz. Parametreleri ayarlama.
NotBir örnek için varsayılan tahliye ilkesi volatile-lru değeridir. Daha fazla bilgi için bkz. Tahliye ilkeleri.
-
hz parametresinin değerini ayarlayarak iş ihtiyaçlarınıza göre süresi dolmuş anahtarların etkin şekilde silinmesi için makul bir çalıştırma sıklığı belirleyin. Özel talimatlar için bkz. Zamanlanmış görevlerin çalıştırma sıklığını ayarlama.
Nothz parametresini 100'den küçük bir değere ayarlamanızı öneririz. Daha büyük bir değer CPU kullanımını önemli ölçüde etkileyebilir. Örneğiniz Redis 5.0 veya sonraki sürümlerle uyumluysa otomatik ayarlamayı da etkinleştirebilirsiniz. Daha fazla bilgi için bkz. Arka plan görevleri için dinamik frekans kontrolünü etkinleştirme.
-
Önceki optimizasyonlardan sonra bile bellek kullanımı hala yüksekse daha fazla veriyi işlemek ve performansı artırmak için daha fazla belleğe sahip bir teknik özelliğe yükseltmeyi düşünün. Daha fazla bilgi için bkz. Örnek yapılandırmasını değiştirme.
NotÖrneğinizi yükseltmeden önce hedef teknik özelliklerin iş yükü gereksinimlerinizi karşılayıp karşılamadığını test etmek için kullandıkça öde bir örnek satın alabilirsiniz. Test tamamlandıktan sonra örneği serbest bırakabilirsiniz. Bir örneği nasıl serbest bırakacağınız hakkında bilgi için bkz. Kullandıkça öde örneklerini serbest bırakma.
Ani bellek artışları için çözümler
Nedenler
Bellek kullanımındaki ani artış şu nedenlerden kaynaklanabilir:
Ani bellek artışının dört nedeni vardır. Hangisinin geçerli olduğunu belirlemek için her satırdaki temel göstergeleri kullanın.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Yazılan büyük hacimli yeni veriler
Yeni verilerin hızla gelmesi bellek tüketimini doğrudan artırır.
Tanılama
Performance Monitor sayfasında gelen trafiği ve saniye başına yazma sorgularını (QPS) kontrol edin. Her iki ölçüm de bellek kullanımıyla aynı eğilimi izliyorsa artış büyük hacimli yeni verilerden kaynaklanıyor demektir.
Çözüm
Artık ihtiyaç duyulmayan verilerin otomatik olarak süresinin dolması için anahtarlarda uygun time-to-live (TTL) değerleri belirleyin. Alternatif olarak gereksiz anahtarları manuel olarak silin.
Örneğin bellek kapasitesini artırın. Ayrıntılar için bkz. Bir örneğin yapılandırmalarını değiştirme.
Örneğiniz standart bir örnekse ve kapasiteyi artırdıktan sonra bile bellek kullanımı yüksek kalıyorsa küme örneğine yükseltin. Küme örnekleri verileri birden çok parçaya dağıtarak her bir parçadaki bellek baskısını azaltır. Ayrıntılar için bkz. Bir örneğin yapılandırmalarını değiştirme.
Yeni bağlantılardaki ani artış
Her istemci bağlantısı giriş ve çıkış arabellekleri için bellek ayırır. Bağlantılardaki ani artış toplam bellek kullanımında buna paralel bir yükselişe neden olur.
Tanılama
Performance Monitor sayfasında bağlantı sayısını kontrol edin. Bağlantı sayısı bellek kullanımıyla birlikte keskin şekilde artıyorsa artışın nedeni bağlantı artışıdır.
Çözüm
Uygulamanızda bağlantı sızıntısı olup olmadığını kontrol edin.
Boştaki bağlantıları otomatik olarak kapatmak için bir bağlantı zaman aşımı yapılandırın. Ayrıntılar için bkz. İstemci bağlantıları için zaman aşımı süresi belirtme.
Ani trafikte arabellek birikimi
Ani erişim örneğin ağ bant genişliğini aşan trafik oluşturduğunda gelen ve giden veriler giriş ve çıkış arabelleklerinde birikir. Bu arabellek birikimi normal veri depolamanın üzerine ek bellek tüketir.
Tanılama
Gelen ve giden trafik kullanımının %100'e ulaşıp ulaşmadığını kontrol edin.
-
MEMORY STATSkomutunu çalıştırın veclients.normaldeğerinin aşırı miktarda bellek kaplayıp kaplamadığını kontrol edin.Notclients.normaltüm normal istemci bağlantılarındaki giriş ve çıkış arabelleklerinin tükettiği toplam belleği bildirir. Buradaki yüksek değer arabellek birikiminin bellek artışını tetiklediğini doğrular.
Çözüm
Trafik artışının nedenini belirleyin.
Örneğin ağ bant genişliğini artırın. Ayrıntılar için bkz. Bir örneğin bant genişliğini manuel olarak artırma ve Bant genişliği otomatik ölçeklendirmeyi etkinleştirme.
Yeterli arabellek kapasitesi sağlamak için örnek teknik özelliklerini yükseltin. Ayrıntılar için bkz. Bir örneğin yapılandırmalarını değiştirme.
Yavaş istemcide çıktı arabelleği birikimi
Bir istemci yanıtları yeterince hızlı tüketemediğinde teslim edilmemiş veriler sunucu tarafındaki çıkış arabelleğinde birikir. Redis kuyruğa alınan her yanıt için bellek ayırır; bu da istemciler geride kaldığında büyük boyutlara ulaşabilir.
Tanılama
redis-cli içinde MEMORY DOCTOR komutunu çalıştırın ve big_client_buf değerini kontrol edin. big_client_buf değeri 1 ise en az bir istemcinin önemli miktarda bellek tüketen aşırı büyük bir çıkış arabelleği vardır.
Çözüm
CLIENT LIST komutunu çalıştırın ve yüksek omem değerine sahip istemcileri arayın. omem alanı bir istemcinin çıkış arabelleği tarafından kullanılan belleği bildirir. Belirlenen istemcinin yanıtları yeterince hızlı tüketmesini engelleyen performans sorunları olup olmadığını kontrol edin.
Bir veri düğümünde yüksek bellek için çözümler
Belirtiler
Küme mimarisine sahip örneklerde belirli bir veri düğümündeki yüksek bellek kullanımı aşağıdaki belirtilerle gösterilir:
CloudMonitor'dan bir bellek kullanımı uyarısı alırsınız. Uyarı mesajı belirli bir veri düğümünün bellek kullanımının eşiği aştığını gösterir.
Örnek tanılama raporu bellek kullanımı çarpıklığı gösterir.
Performans izleme sayfasında genel örnek bellek kullanımının düşük olduğunu ancak belirli bir veri düğümünün bellek kullanımının yüksek olduğunu fark edersiniz.
Neden
Genel örnek bellek kullanımı düşükken belirli bir veri düğümünün kullanımı yüksekse bu durum bellek kullanımı çarpıklığını gösterir.
Çözümler
Büyük anahtarları kontrol edin ve bölün
Büyük anahtarları bulma
Var olan büyük anahtarları bulmak için çevrimdışı anahtar analizi özelliğini kullanın.
Büyük anahtarları bulmanın diğer yöntemleri için bkz. Büyük anahtarlar ve sıcak anahtarlar.
Büyük anahtarları bölme
Örneğin on binlerce üyeye sahip bir HASH anahtarını her biri makul sayıda üyeye sahip olacak şekilde birden çok küçük HASH anahtarına bölün. Bir küme örneğinde büyük anahtarları bölmek veri parçaları arasındaki bellek kullanımını dengelemeye önemli ölçüde yardımcı olabilir.
Hash etiketi kullanımını kontrol edin
Veri yoğunlaşmasına neden olan bir hash etiketi kullanıyorsanız uygulama mantığınıza göre bunu birden çok hash etiketine bölmeyi düşünün. Bu verilerin farklı veri parçalarına daha eşit şekilde dağıtılmasına yardımcı olur.
Örnek teknik özelliklerini yükseltin
Örnek teknik özelliklerini yükseltmek her bir parçanın kullanabileceği belleği artırır ve bellek çarpıklığı için geçici bir çözüm olabilir. Ayrıntılı adımlar için bkz. Örnek yapılandırmasını değiştirme.
Sistem örnek teknik özellikleri değişikliği sırasında veri çarpıklığı için ön kontrol başlatır. Seçtiğiniz örnek türü veri çarpıklığı sorununu yönetemiyorsa sistem bir hata bildirir. Daha yüksek teknik özelliklere sahip bir örnek türü seçin ve tekrar deneyin.
Örnek teknik özelliklerini yükselttikten sonra bellek kullanımı çarpıklığı hafifleyebilir. Ancak çarpıklık bant genişliği ve CPU kaynaklarında da ortaya çıkabilir.
Ek 1: Redis bellek kullanımı
Bir Redis örneğinin belleği üç ana bileşenden oluşur:
Bellek bileşeni | Açıklama |
Bağlantı belleği (dinamik) | Bu giriş arabelleği çıkış arabelleği JIT ek yükü sahte Lua bağlantıları ve Lua yürütme önbelleği için belleği içerir. Çıktının Clients bölümündeki istemci önbellek bilgilerini kontrol etmek için INFO komutunu çalıştırabilirsiniz. Not Giriş ve çıkış arabellekleri her istemci bağlantısıyla ilişkilendirilir ve genellikle küçüktür. Ancak aralık tabanlı işlemler gerçekleştirdiğinizde veya büyük anahtarlar yavaş aktarıldığında bu arabellekler tarafından kullanılan bellek artabilir; bu durum veri alanını etkiler ve potansiyel olarak bellek yetersizliği (OOM) hatasına neden olabilir. |
Veri belleği | Bu gerçek değer bilgilerini depolayan kullanıcı veri alanıdır. Genellikle analizin temel odağıdır. |
Yönetim belleği (statik) | Bu alan küçüktür ve başlatmadan sonra nispeten sabittir. Veri yönetimi karma tablolarından çoğaltma arabelleğinden ve AOF arabelleğinden (yaklaşık 32 MB ila 64 MB) kaynaklanan bellek ek yükünden oluşur. Not Çok sayıda anahtar için (örneğin yüz milyonlarca) bu alan önemli miktarda bellek tüketebilir. |
Etkisiz dinamik bellek yönetimi çoğu OOM senaryosuna neden olur. Örneğin hız sınırlama sırasında istek kuyruğa alınması dinamik belleğin hızla artmasına neden olabilir. Aşırı karmaşık veya kötü yazılmış Lua betikleri de OOM'a yol açabilir. Bu sorunları önlemek için dinamik bellek üzerinde gelişmiş kontrol sağlayan Tair (Enterprise Edition) kullanmanızı öneririz.