Bu konu, IVFFlat veya HNSW algoritmasına dayanan PASE eklentisini kullanarak RDS for PostgreSQL'de vektör aramasının nasıl verimli bir şekilde yapılacağını açıklar.
PASE eklentisi artık bakım almamaktadır. Bunun yerine pgvector eklentisini kullanmanızı öneririz.
Ön koşullar
Örneğiniz RDS for PostgreSQL 11 ila 16 sürümünü çalıştırıyor olmalıdır.
Arka plan bilgileri
Son yıllarda derin öğrenme alanındaki temel teknolojilerden biri olan temsil öğrenimi önemli ilerlemeler kaydetmiştir. Reklam teslimatı, yüz tanıma ile ödeme, görüntü ve konuşma tanıma gibi endüstriyel uygulamalarda yaygın olarak kullanılmaktadır. Bu senaryolarda veriler yüksek boyutlu vektörlere gömülür ve benzer öğeleri bulmak için vektör araması kullanılır.
PASE (PostgreSQL ANN search extension), PostgreSQL için geliştirilmiş yüksek performanslı bir vektör arama dizini eklentisidir. Yaklaşık en yakın komşu (ANN) arama algoritmaları arasında yer alan IVFFlat ve HNSW gibi olgun, kararlı ve verimli algoritmaları kullanarak son derece hızlı vektör sorguları yapmanızı sağlar. PASE, özellik vektörlerinin çıkarılmasını veya oluşturulmasını desteklemez. Varlıklarınız için özellik vektörlerini oluşturmak sizin sorumluluğunuzdadır. PASE, oluşturduğunuz büyük hacimli vektörler üzerinde benzerlik aramaları yapar.
Hedef kitle
Bu konuyu anlamak için makine öğrenimi, arama ve öneri sistemleri hakkında temel bilgilere sahip olmanız gerekir.
Kullanım notları
Dizin şişebilir. Dizin boyutunu kontrol etmek için
select pg_relation_size('index_name');komutunu çalıştırın. Boyutu veri boyutundan önemli ölçüde büyük hale gelirse ve sorgu performansı belirgin şekilde düşerse dizini yeniden oluşturun.Sık veri güncellemeleri sonrası dizin doğruluğu azalabilir. Mutlak doğruluk sağlamak için dizini periyodik olarak yeniden oluşturun.
Dahili merkezlere sahip bir IVFFlat dizini (
clustering_type=1) kullanmak için dizini oluşturmadan önce tabloya bazı veriler eklemeniz gerekir.Bu konudaki SQL örneklerini çalıştırmak için yetkili bir hesap kullanın.
PASE algoritmaları
-
IVFFlat algoritması
IVFFlat, IVFADC'nin basitleştirilmiş bir sürümüdür; yüksek geri çağırma gerektiren ve orta düzeyde sorgu gecikmesini (100 ms aralığında) tolere edebilen senaryolar için uygundur. Diğer algoritmalara kıyasla IVFFlat algoritması aşağıdaki avantajları sunar:
Sorgu vektörü aday veri kümesinin bir parçasıysa IVFFlat %100 geri çağırma sağlayabilir.
Algoritma basittir; bu durum daha hızlı dizin oluşturma ve daha küçük depolama alanı kullanımı sağlar.
Merkezleri belirtebilir ve basit parametreleri ayarlayarak geri çağırmayı kontrol edebilirsiniz.
Algoritmanın parametreleri yüksek derecede yorumlanabilir olup doğruluk üzerinde tam kontrol sağlar.
Aşağıdaki şekil IVFFlat algoritmasının çalışma mantığını göstermektedir.
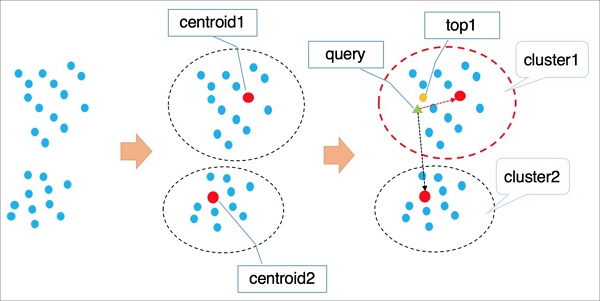
İşlem şu adımlardan oluşur:
Yüksek boyutlu uzaydaki vektörler, k-means gibi bir kümeleme algoritması kullanılarak kümeler halinde gruplandırılır. Her kümenin bir merkezi bulunur.
Arama sırasında algoritma öncelikle tüm kümelerin merkezlerini dolaşarak hedef vektöre en yakın olan
nkümeyi bulur.Algoritma ardından bu
nküme içindeki tüm öğeleri dolaşır ve nihaiken yakın vektörü bulmak için genel bir sıralama yapar.
NotMerkezler aranırken uzak kümeler otomatik olarak dışlanarak sorgu hızlandırılır. Ancak bu durum, en iyi ilk
kvektörün tamamının seçilennküme içinde olacağının garanti edilmediği anlamına gelir; bu da doğruluğu azaltabilir. IVFFlat algoritmasının doğruluğunu tarama yapılacak küme sayısı olanndeğerini ayarlayarak kontrol edebilirsiniz. Daha büyük birndeğeri doğruluğu artırır ancak hesaplama yükünü de yükseltir.IVFFlat ve IVFADC'nin ilk aşaması aynıdır. Temel fark ikinci hesaplama aşamasında yatar. IVFADC, kapsamlı hesaplamadan kaçınmak için ürün kuantizasyonunu kullanır; bu durum belirli bir doğruluk kaybına yol açar. Buna karşılık IVFFlat, hesaplamayı yönetilebilir tutarken bu kaybı önlemek için doğrudan hesaplama (brute-force) yöntemi kullanır.
-
HNSW algoritması
Hiyerarşik Navigable Small World (HNSW) algoritması çok büyük ölçekli vektör veri kümeleri (on milyonlarca veya daha fazla) ve sıkı sorgu gecikmesi gereksinimleri (10 ms aralığında) olan senaryolar için uygundur.
HNSW, potansiyel yakın komşuları bulmak için bir yakınlık grafiğinde hızla dolaşan grafik tabanlı bir algoritmadır. HNSW algoritmasının performans iyileştirmesi, diğer algoritmalara kıyasla büyük veri kümelerinde daha belirgindir. Ancak komşu noktaların saklanması ek depolama alanı tüketir ve yalnızca parametre ayarlamasıyla geri çağırmayı iyileştirme konusunda azalan getiriler söz konusudur.
Aşağıdaki şekil HNSW algoritmasının çalışma mantığını göstermektedir.
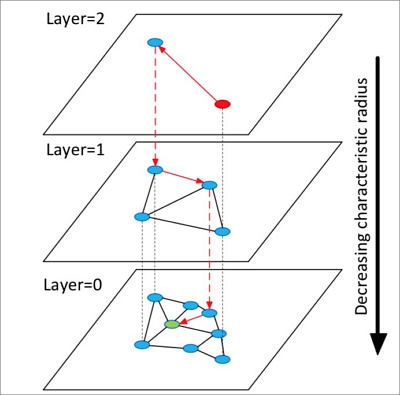
İşlem şu adımlardan oluşur:
Algoritma çok katmanlı bir grafik oluşturur; her katman altındaki katmanın daha seyrek bir versiyonudur ve alt katman için ekspres yol sistemi benzeri bir atlama listesi görevi görür.
Arama üst katmandan rastgele seçilen bir noktadan başlar.
Algoritma başlangıç noktasının komşularını bulur ve bunları hedefe olan uzaklıklarına göre sıralanmış sabit boyutlu dinamik bir listede saklar. Sonraki adımlarda listeden noktalar alır, bunların komşularını bulur ve yeni keşfedilen komşuları tekrar listeye ekler. Her eklemeden sonra liste yeniden sıralanır ve yalnızca ilk
knokta korunur. Liste stabilize olana kadar bu süreç yinelemeli olarak devam eder. Stabilize olmuş listedeki ilk nokta daha sonra bir alt katman için giriş noktası olarak kullanılır.Arama en alt katmana ulaşana kadar bu işlem her katman için tekrarlanır.
NotHNSW algoritması, NSW algoritmasının tek katmanlı grafiğini temel alarak çok katmanlı bir grafik oluşturur. Bu grafikte en yakın komşuları aramak, kümeleme tabanlı algoritmalara göre daha yüksek bir hızlanma oranı elde etmenizi sağlar.
Her algoritmanın belirli kullanım durumları vardır. Örneğin IVFFlat algoritması yüksek hassasiyetli görüntü karşılaştırma için uygunken HNSW algoritması arama ve öneri senaryolarındaki geri getirme işlemleri için idealdir.
PASE kullanımı
Yordam
-
PASE eklentisini oluşturun. Aşağıdaki komutu çalıştırın:
CREATE EXTENSION pase; -
Vektör benzerliğini hesaplayın. Vektör benzerliğini hesaplamak için iki yapıcı yöntemden birini kullanabilirsiniz:
-
PASE veri türü yapıcısını kullanma
Örnekler
SELECT ARRAY[2, 1, 1]::float4[] <?> pase(ARRAY[3, 1, 1]::float4[]) AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> pase(ARRAY[3, 1, 1]::float4[], 0) AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> pase(ARRAY[3, 1, 1]::float4[], 0, 1) AS distance;Not<?>operatörü sol taraftaki vektör (float4[]) ile sağ taraftaki vektör (pase) arasındaki benzerliği hesaplar.pasetürü, eklenti içinde tanımlanan bir veri türüdür. Örneklerde gösterildiği gibi üç yapıcı yöntemi vardır.pase(ARRAY[3, 1, 1]::float4[], 0, 1)örneğini ele alalım: İlk parametrefloat4[]türündedir ve sağ vektörü temsil eder. İkinci parametre bu bağlamda kullanılmaz ve 0 olarak ayarlanabilir. Üçüncü parametre benzerlik hesaplama yöntemini belirtir:0Öklid mesafesi,1ise nokta çarpımı (iç çarpım) içindir.Sol ve sağ vektörlerin boyutları eşit olmalıdır. Aksi takdirde hesaplama başarısız olur.
-
Dize yapıcısını kullanma
Örnekler
SELECT ARRAY[2, 1, 1]::float4[] <?> '3,1,1'::pase AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> '3,1,1:0'::pase AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> '3,1,1:0:1'::pase AS distance;NotHem dize yapıcısı hem de PASE veri türü yapıcısı iki vektör arasındaki benzerliği hesaplar. Fark, dize yapıcısının sınırlayıcı olarak iki nokta (
:) kullanmasıdır.'3,1,1:0:1'örneğini ele alalım: İlk kısım sağ vektörü temsil eder. İkinci kısım bu bağlamda kullanılmaz ve 0 olarak ayarlanabilir. Üçüncü kısım benzerlik hesaplama yöntemini belirtir:0Öklid mesafesi,1ise nokta çarpımı (iç çarpım) içindir.
-
-
Dizin oluşturun. İki algoritmadan birini kullanarak dizin oluşturabilirsiniz:
NotBenzerlik ölçüsü olarak Öklid mesafesi kullanılan bir PASE vektör diziniyle çalışırken orijinal vektörleri işlemeye gerek yoktur. Ancak iç çarpım veya kosinüs benzerliğini ölçü olarak kullanmak istiyorsanız vektörler üzerinde normalleştirme yapmanız gerekir. Orijinal vektör
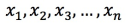 ise
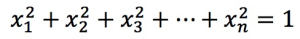 koşulunu sağlamalıdır. Normalleştirme sonrası iç çarpım ve kosinüs benzerliği değerleri sıralama açısından eşdeğerdir.
-
IVFFlat algoritmasını kullanarak dizin oluşturma
CREATE INDEX ivfflat_idx ON table_name
USING
  pase_ivfflat(column_name)
WITH
  (clustering_type = 1, distance_type = 0, dimension = 256, base64_encoded = 0, clustering_params = "10.100");
Aşağıdaki tabloda parametreler açıklanmaktadır.
Parametre
Açıklama
clustering_type
IVFFlat algoritması için kümeleme yöntemi. Bu parametre zorunludur. Geçerli değerler:
-
0: Harici kümeleme. clustering_params parametresi tarafından belirtilen harici merkez dosyasını yükler. -
1: Dahili kümeleme. Dizin oluşturma sırasında k-means algoritmasını kullanarak dahili olarak bir kümeleme işlemi yapar. Bu işlem clustering_params parametresi tarafından kontrol edilir.
Yeni kullanıcılar için dahili kümeleme kullanmanızı öneririz.
distance_type
Benzerlik hesaplama yöntemi. Varsayılan:
0. Geçerli değerler:-
0: Öklid mesafesi. -
1: Nokta çarpımı (iç çarpım). Bu yöntemi kullanmak için vektörler üzerinde normalleştirme yapmanız gerekir. Bu durumda nokta çarpımı (iç çarpım) değerlerinin sıralaması, Öklid mesafesi değerlerinin sıralamasının tersidir.
Şu anda dizin oluşturma için yalnızca Öklid mesafesi doğrudan desteklenmektedir. Nokta çarpımı (iç çarpım) kullanmak için vektörleri normalleştirmeniz ve Ek bölümünde sağlanan yöntemi kullanmanız gerekir.
dimension
Vektör boyutu. Bu parametre zorunludur. Desteklenen maksimum boyut 512'dir.
base64_encoded
Verilerin Base64 kodlamalı olup olmadığını belirtir. Varsayılan:
0. Geçerli değerler:-
0: Vektör türüfloat4[]. -
1: Vektör türü, bir float dizisinin Base64 kodlamalı dizesidir.
clustering_params
Harici kümeleme için bu parametre merkez dosyasının yolunu belirtir. Dahili kümeleme için kümeleme parametrelerini
"clustering_sample_ratio,k"biçiminde belirtir. Bu parametre zorunludur.-
clustering_sample_ratio: Paydası 1000 olan kümeleme örnek oranı. Geçerli aralık(0, 1000]aralığında bir tamsayıdır. Örneğin,1değeri tablodaki verilerin 1/1000'inin k-means kümelemesi için örneklendiği anlamına gelir. Daha büyük bir değer sorgu doğruluğunu artırır ancak dizin oluşturma süresini uzatır. Toplam örneklenen veri noktası sayısının 100.000'i aşmamasını öneririz. -
k: Merkez sayısı. Daha büyük bir değer sorgu doğruluğunu artırır ancak dizin oluşturma süresini uzatır.[100, 1000]aralığında bir değer önerilir.
-
-
HNSW algoritmasını kullanarak dizin oluşturma
CREATE INDEX hnsw_idx ON table_name
USING
  pase_hnsw(column_name)
WITH
  (dim = 256, base_nb_num = 16, ef_build = 40, ef_search = 200, base64_encoded = 0);
Aşağıdaki tabloda parametreler açıklanmaktadır.
Parametre
Açıklama
dim
Vektör boyutu. Zorunludur. Değer aralığı
[8.512].base_nb_num
Grafikteki her düğüm için komşu sayısı. Bu parametre zorunludur. Daha yüksek bir değer sorgu doğruluğunu artırır ancak dizin oluşturma süresini ve dizin boyutunu büyütür. Önerilen değer aralığı
[16-128].ef_build
Dizin oluşturma süreci için yığın uzunluğu. Bu parametre zorunludur. Daha büyük bir değer daha iyi sonuçlar verir ancak oluşturma sürecini yavaşlatır. Önerilen değer aralığı
[40.400].ef_search
Sorgu için yığın uzunluğu. Bu zorunlu bir parametredir. Daha büyük bir değer sonuç kalitesini artırır ancak sorgu performansını düşürür. Değer
[10.400]aralığında olmalıdır.base64_encoded
Verilerin Base64 kodlamalı olup olmadığını belirtir. Varsayılan:
0. Geçerli değerler:-
0: Vektör türüfloat4[]. -
1: Vektör türü, bir float dizisinin Base64 kodlamalı dizesidir.
-
-
-
Sorgu çalıştırın. Verileri her iki dizin türünü kullanarak da sorgulayabilirsiniz:
-
IVFFlat dizini kullanarak sorgulama
SELECT id, vector <#> '1,1,1'::pase as distance FROM table_name ORDER BY vector <#> '1,1,1:10:0'::pase ASC LIMIT 10;Not<#>operatörü IVFFlat dizinini sorgulamak için kullanılır.Vektör dizini
ORDER BYyan tümcesi tarafından etkinleştirilir. Artan sıralama düzenini (ASC) destekler.pase veri türü iki nokta (:) ile ayrılmış üç bölümden oluşur. Örneğin
1,1,1:10:0ifadesinde ilk bölüm sorgu vektörüdür. İkinci bölüm IVFFlat için bir sorgu parametresidir ve değer aralığı(0,1000]şeklindedir. Daha büyük bir değer daha yüksek sorgu doğruluğu ancak daha düşük sorgu performansı sağlar. Optimal değeri gerçek verilerinize göre hata ayıklama yaparak belirlemeniz önerilir. Üçüncü bölüm sorgu için benzerlik hesaplama yöntemini belirtir; burada 0 Öklid mesafesini, 1 ise nokta çarpımını (iç çarpım) ifade eder. Nokta çarpımı (iç çarpım) yöntemini kullanırsanız vektör normalleştirmesi yapmanız gerekir. Bu durumda nokta çarpımı (iç çarpım) değerlerinin sırası, Öklid mesafesi değerlerinin sırasının tersidir.
-
HNSW dizini kullanarak sorgulama
SELECT id, vector <?> '1,1,1'::pase as distance FROM table_name ORDER BY vector <?> '1,1,1:100:0'::pase ASC LIMIT 10;Not<?>operatörü HNSW dizinini sorgulamak için kullanılır.Vektör dizini
ORDER BYyan tümcesi tarafından etkinleştirilir. Artan sıralama düzenini (ASC) destekler.paseveri türü iki nokta (:) ile ayrılmış üç bölümlü bir formata sahiptir.1,1,1:100:0örneğinde ilk bölüm sorgu vektörüdür. İkinci bölüm HNSW sorgu etki parametresidir ve değer aralığı(0,∞)şeklindedir. Daha büyük bir değer daha yüksek sorgu doğruluğu ancak daha düşük sorgu performansı sağlar. Bu değeri gerçek verilerinizle hata ayıklama yaparak belirlemenizi ve başlangıç değeri olarak 40 kullanmanızı öneririz. Üçüncü bölüm sorgu için benzerlik hesaplama yöntemini belirtir; burada 0 Öklid mesafesini, 1 ise nokta çarpımını (iç çarpım) ifade eder. Nokta çarpımı (iç çarpım) yöntemini kullandığınızda vektör normalleştirmesi gereklidir. Bu durumda nokta çarpımı (iç çarpım) değerlerinin sırası, Öklid mesafesi değerlerinin sırasının tersidir.
-
Örnek
Bu örnek, IVFFlat dizini kullanarak verilerin nasıl sorgulanacağını göstermektedir.
-
PASE eklentisini oluşturun. Aşağıdaki komutu çalıştırın:
CREATE EXTENSION pase; -
Test tablosu oluşturun ve test verilerini ekleyin.
Test tablosu oluşturun.
CREATE TABLE vectors_table ( id SERIAL PRIMARY KEY, vector float4[] NOT NULL );Test verilerini ekleyin.
INSERT INTO vectors_table (vector) VALUES ('{1.0, 0.0, 0.0}'), ('{0.0, 1.0, 0.0}'), ('{0.0, 0.0, 1.0}'), ('{0.0, 0.5, 0.0}'), ('{0.0, 0.5, 0.0}'), ('{0.0, 0.6, 0.0}'), ('{0.0, 0.7, 0.0}'), ('{0.0, 0.8, 0.0}'), ('{0.0, 0.0, 0.0}'); -
IVFFlat algoritmasını kullanarak dizin oluşturun.
CREATE INDEX ivfflat_idx ON vectors_table USING pase_ivfflat(vector) WITH (clustering_type = 1, distance_type = 0, dimension = 3, base64_encoded = 0, clustering_params = "10.100"); -
IVFFlat dizinini kullanarak verileri sorgulayın.
SELECT id, vector <#> '1,1,1'::pase as distance
FROM vectors_table
ORDER BY
vector <#> '1,1,1:10:0'::pase
ASC LIMIT 10;
Ek
-
Nokta çarpımı (iç çarpım) hesaplama örneği
Bu örnek bir HNSW algoritma dizini kullanır. Aşağıdaki kod bir işlevin nasıl oluşturulacağını göstermektedir:
CREATE OR REPLACE FUNCTION inner_product_search(query_vector text, ef integer, k integer, table_name text) RETURNS TABLE (id integer, uid text, distance float4) AS $$ BEGIN RETURN QUERY EXECUTE format(' select a.id, a.vector <?> pase(ARRAY[%s], %s, 1) AS distance from (SELECT id, vector FROM %s ORDER BY vector <?> pase(ARRAY[%s], %s, 0) ASC LIMIT %s) a ORDER BY distance DESC;', query_vector, ef, table_name, query_vector, ef, k); END $$ LANGUAGE plpgsql;NotNormalleştirilmiş vektörler için iç çarpım kosinüs benzerliğine eşittir. Bu nedenle kosinüs benzerliğini hesaplamak için aynı yöntemi kullanabilirsiniz.
-
IVFFlat dizini için özel merkez dosyası
Bu gelişmiş bir özelliktir. Bu özelliği kullanmak için bir merkez dosyasını sunucuda belirtilen bir yola yükleyin ve dizini oluşturmak için bunu bir dizin parametresi olarak kullanın. Parametrelerle ilgili daha fazla bilgi için IVFFlat dizin parametrelerine bakın. Dosya biçimi aşağıdaki gibidir:
vector_dimension|number_of_centroids|set_of_centroid_vectorsÖrnek
3|2|1,1,1,2,2,2
İlgili belgeler
-
Product Quantization for Nearest Neighbor Search
Hervé Jégou, Matthijs Douze ve Cordelia Schmid.
-
Yu. A. Malkov ve D. A. Yashunin.