ChatGPT'nin ortaya çıkışı, büyük dil modellerinin (LLM) ve üretken yapay zekanın birçok alandaki potansiyelini göstermiştir. Bu alanlar arasında içerik yazma, görüntü oluşturma, kod optimizasyonu ve bilgi arama yer alır. LLM'ler bireyler ve işletmeler için güçlü araçlar haline gelerek süper uygulamalara dönüşmüş ve yeni ekosistemler yaratmıştır. Bu konuda ApsaraDB RDS for PostgreSQL kullanarak özel bir sohbet robotunun nasıl oluşturulacağı açıklanmaktadır.
Arka Plan
Daha fazla işletme ve birey, belirli alanlarına yönelik yapay zeka destekli ürünler oluşturmak için LLM'leri ve üretken yapay zekayı kullanmak istemektedir. LLM'ler genel sorunlarda iyi performans gösterir ancak uzmanlaşmış bilgi ve gerçek zamanlı bilgilerle ilgilenirken sınırlamaları vardır. Bu durum eğitim verileri ve yanıt oluşturma biçimlerinden kaynaklanır. Bilgi çağında işletmeler bilgi tabanlarını sık sık günceller. Belgeler, görüntüler ve ses/video dosyalarını içeren bu dikey alan bilgi tabanları özel veya gizli olabilir. Bir LLM üzerinde alana özgü bir yapay zeka ürünü oluşturmak için işletmenin modeli kendi bilgi tabanı ile sürekli olarak eğitmesi gerekir.
İki yaygın yöntem mevcuttur:
İnce ayar: Mevcut bir modelin ağırlıklarını ince ayarlamak için yeni veri kümeleri sağlayın. İstenilen sonucu elde etmek için girdiyi sürekli olarak güncelleyebilir ve çıktıyı ayarlayabilirsiniz. Bu yöntem küçük veri kümeleri veya belirli görev türleri ya da stiller üzerinde eğitim yapmak için uygundur. Ancak eğitim maliyeti yüksektir.
İstem ayarlama: Çıktıyı ayarlamak için model ağırlıklarını değiştirmek yerine girdi istemlerini ayarlayın. İnce ayara kıyasla istem ayarlama daha düşük hesaplama maliyetine sahiptir, daha az kaynak ve daha az eğitim süresi gerektirir ve daha esnektir.
ApsaraDB RDS for PostgreSQL üzerinde bir sohbet robotu oluşturmanın avantajları şunlardır:
ApsaraDB RDS for PostgreSQL bir pgvector eklentisine sahiptir. Gerçek zamanlı içeriği veya alana özgü bilgiyi vektör gömülmesine dönüştürmek için bu eklentiyi kullanabilirsiniz. Bu gömmelerin ApsaraDB RDS for PostgreSQL içinde depolanması vektör aramalarını hızlandırır. Bu durum özel verileriniz için soru-cevap doğruluğunu artırır.
Gelişmiş bir açık kaynaklı işlemesel işleme (TP) motoru olarak ApsaraDB RDS for PostgreSQL çevrimiçi kullanıcı etkileşimlerini ve veri depolama görevlerini aynı anda yönetir. Örneğin konuşma geçmişini, etkileşim kayıtlarını ve sohbet zaman damgalarını yönetebilir. ApsaraDB RDS for PostgreSQL'in çok yönlülüğü özel iş hizmetleri oluşturma sürecini basitleştirir ve mimariyi hafifletir.
pgvector eklentisi geliştirici topluluğunda ve açık kaynak PostgreSQL veritabanlarında yaygın olarak kullanılmaktadır. ChatGPT Retrieval Plugin gibi araçlar da PostgreSQL desteğini hızla eklemiştir. Bu durum ApsaraDB RDS for PostgreSQL'in güçlü bir ekosistem desteğine ve vektör alma için geniş bir uygulama tabanına sahip olduğunu gösterir ve kullanıcılara birçok araç ve kaynak sunar.
Bu konu size özel bir sohbet robotunun nasıl oluşturulacağını göstermek için ApsaraDB RDS for PostgreSQL için açık kaynaklı vektör dizini eklentisi olan pgvector ve OpenAI'nin gömme yeteneklerini kullanır.
Önkoşullar
-
Aşağıdaki koşulları karşılayan bir RDS PostgreSQL örneği oluşturulmuştur:
Örnek PostgreSQL 14 veya sonraki bir sürümü çalıştırır.
Örneğin küçük motor sürümü 20230430 veya sonraki bir sürümdür.
NotDaha fazla bilgi için bkz. Ana motor sürümünü yükseltin ve Küçük motor sürümünü güncelleyin.
Bu konudaki özel sohbet robotu ApsaraDB RDS for PostgreSQL için açık kaynaklı pgvector eklentisine dayanır. Kullanımını ve temel kavramlarını tamamen anladığınızdan emin olun. Daha fazla bilgi için bkz. pgvector kullanıcı kılavuzu.
Bu konudaki özel sohbet robotu OpenAI yeteneklerini kullanır. Bir
Secret API Keysahibi olduğunuzdan ve ağ ortamınızın OpenAI'ye erişebildiğinden emin olun. Bu konudaki kod örnekleri Singapur bölgesindeki bir ECS örneğine dağıtılır.Bu konudaki örnek kod Python kullanır. Bir Python geliştirme ortamınız olduğundan emin olun. Bu örnekte Python
3.11.4ve PyCharm2023.1.2kullanılır.
İlgili kavramlar
Gömme (Embedding)
Gömme yüksek boyutlu verileri düşük boyutlu bir temsille eşleme sürecidir. Makine öğrenimi ve doğal dil işleme (NLP) alanında gömme genellikle ayrık sembolleri veya nesneleri sürekli bir vektör uzayındaki noktalar olarak temsil etmek için kullanılır.
NLP'de kelime gömme yaygın bir tekniktir. Bilgisayarların metni daha iyi anlamasını ve işlemesini sağlamak için kelimeleri reel sayı vektörlerine eşler. Kelime gömme sayesinde kelimeler arasındaki anlamsal ve dilbilgisel ilişkiler vektör uzayında temsil edilebilir.
OpenAI bir Embeddings özelliği sağlar.
Uygulama ilkeleri
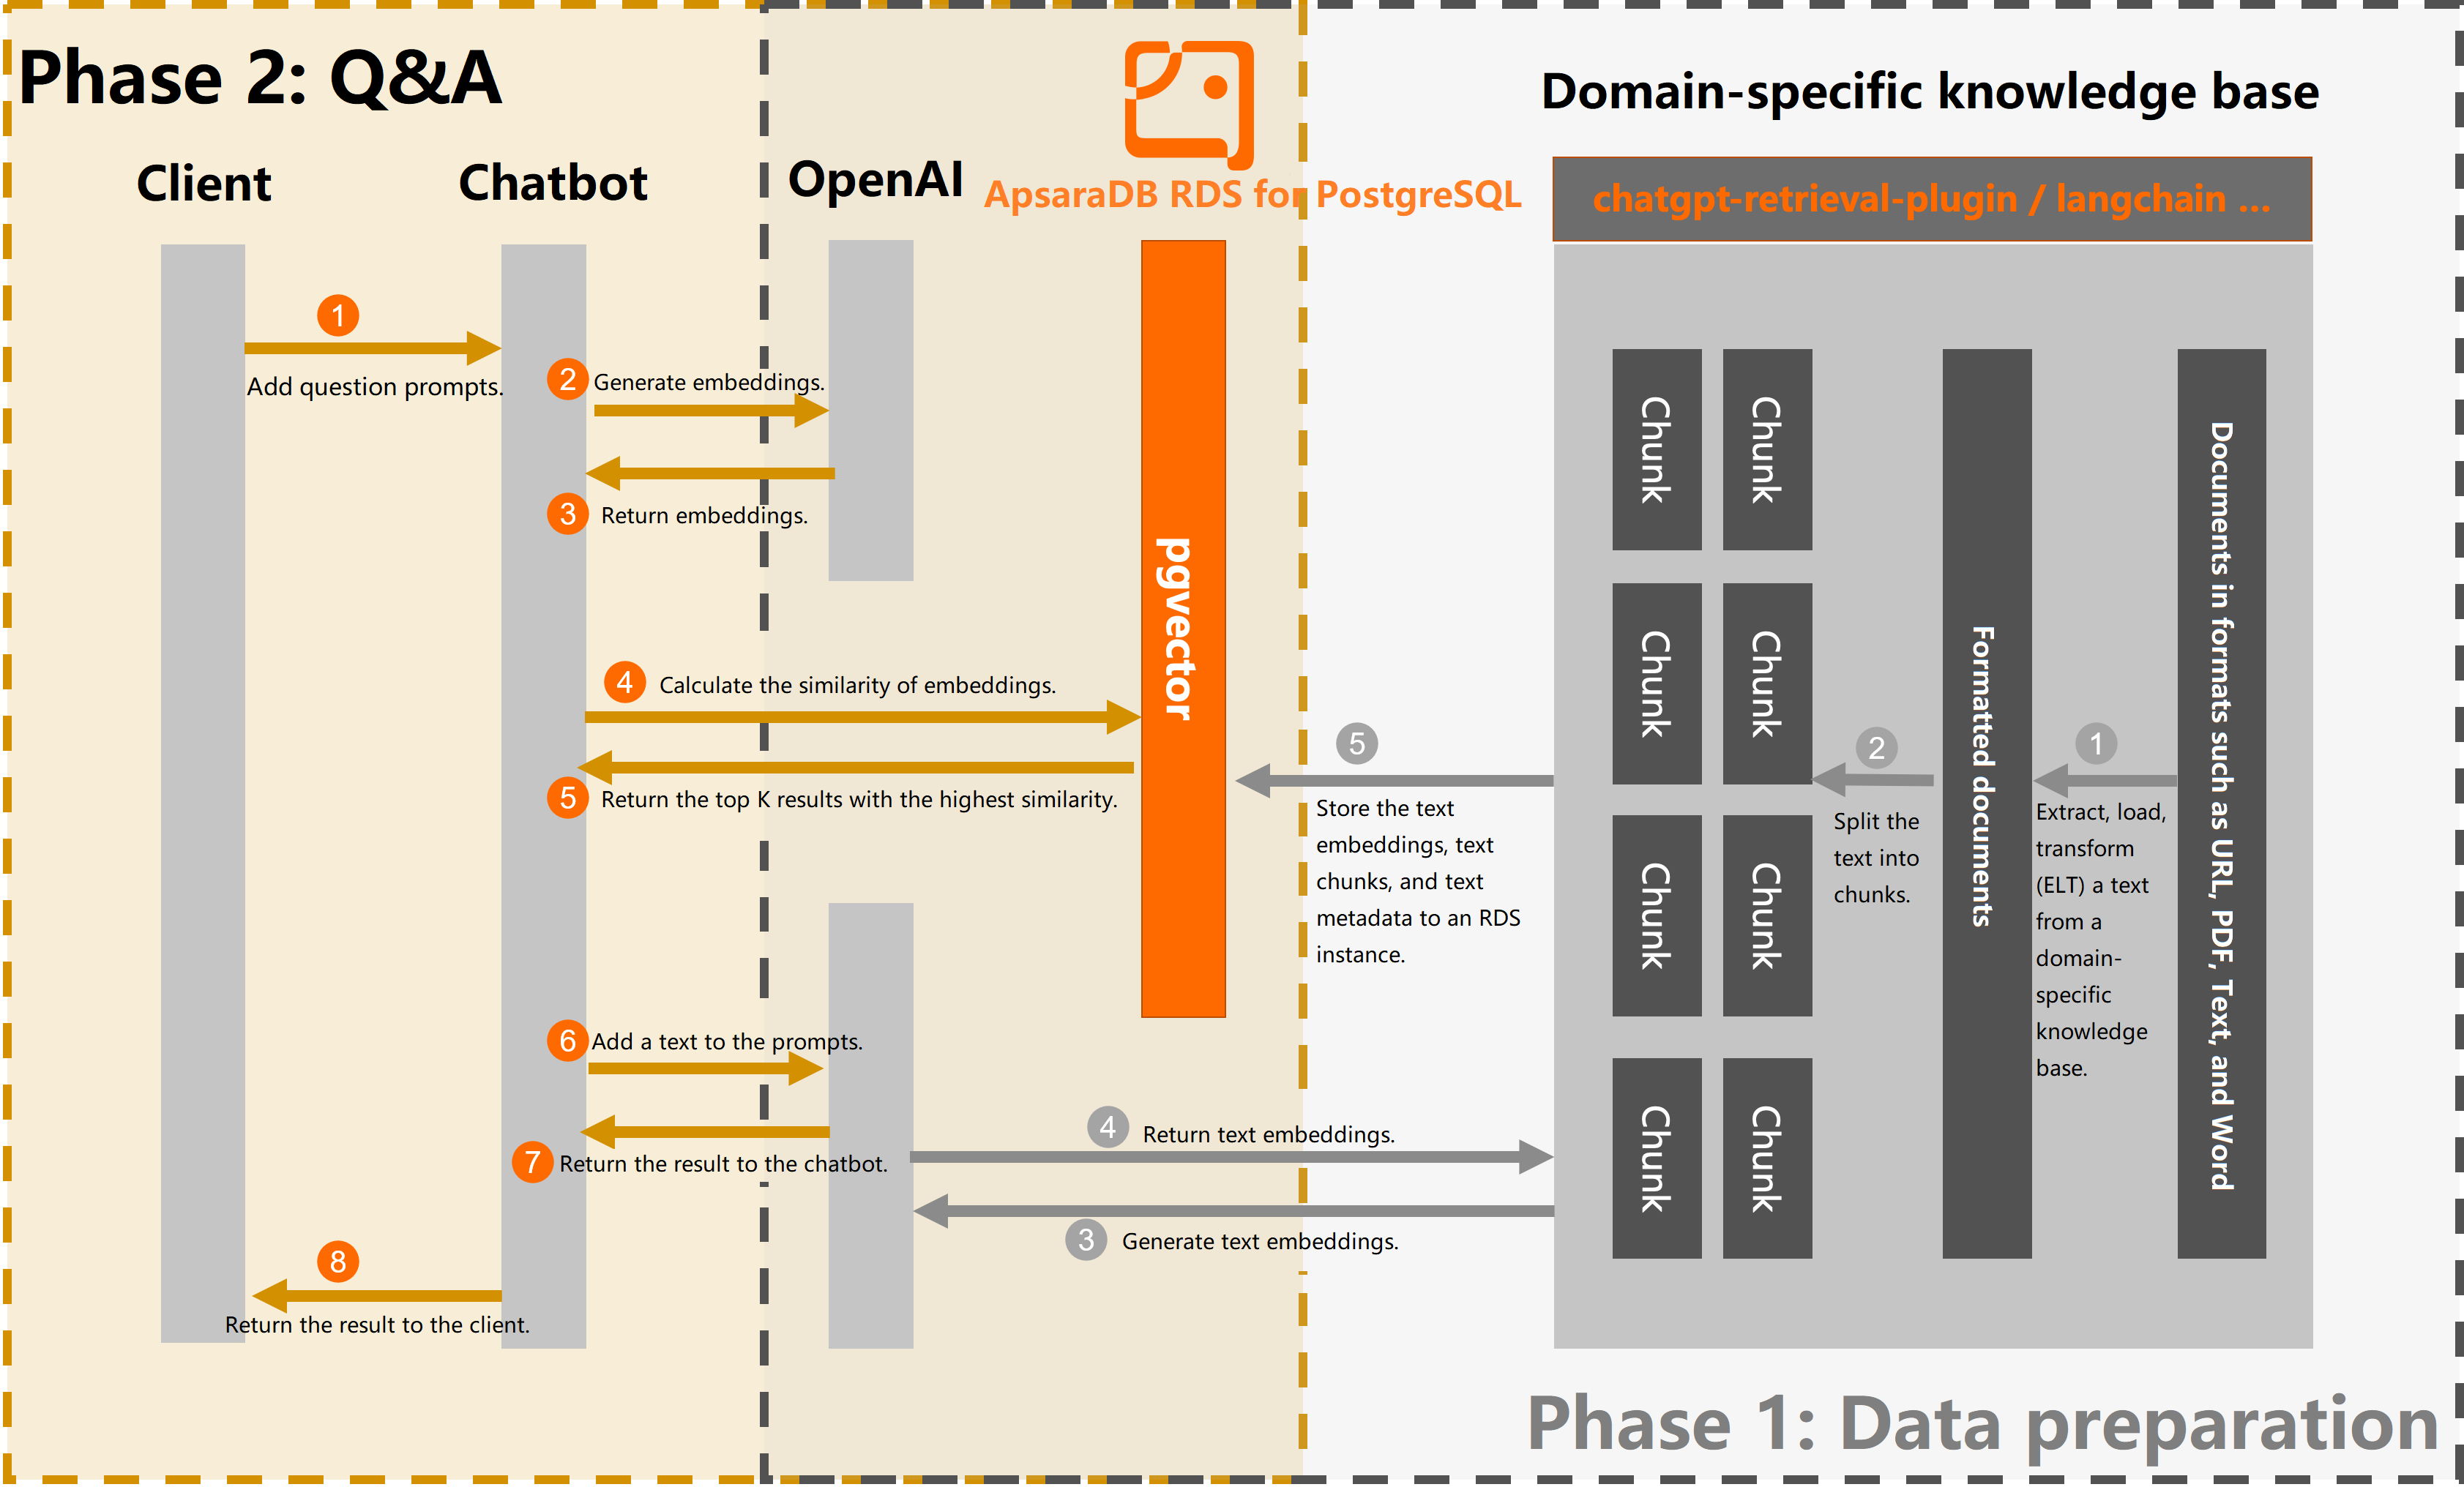
Özel sohbet robotunu oluşturma süreci iki aşamadan oluşur:
Aşama 1: Veri hazırlığı
Bilgi tabanından bilgileri çıkarın ve parçalara ayırın: Alan bilgi tabanından ilgili metni çıkarın ve parçalara işleyin. Bu süreç uzun metinleri paragraflara veya cümlelere bölmeyi ya da anahtar kelimeleri veya varlıkları çıkarmayı içerebilir. Bu süreç bilgi tabanı içeriğini düzenlemeye ve yönetmeye yardımcı olur.
Gömmeleri oluşturmak için bir LLM arayüzünü çağırın: OpenAI gibi bir LLM tarafından sağlanan bir arayüz kullanarak metin parçalarını girdi olarak verin ve karşılık gelen metin gömmelerini oluşturun. Bu gömmeler metnin anlamsal ve bağlamsal bilgilerini yakalar ve sonraki arama ve eşleştirme için bir temel sağlar.
Gömme bilgilerini depolayın: Oluşturulan metin gömmelerini, metin parçalarını ve ilişkili meta verileri ApsaraDB RDS for PostgreSQL veritabanında depolayın.
Aşama 2: Soru-cevap
Bir kullanıcı bir soru sorar.
OpenAI tarafından sağlanan gömme arayüzünü kullanarak soru için bir gömme oluşturun.
Belirli bir eşiğin üzerinde benzerlik puanına sahip belge parçalarını ApsaraDB RDS for PostgreSQL veritabanında filtrelemek için pgvector kullanın ve sonuçları döndürün.
Aşağıdaki akış şeması süreci göstermektedir:
Yordam
Aşama 1: Veri hazırlığı
Bu konu örnek olarak RDS for PostgreSQL örneği oluşturun belgesindeki metin içeriğini kullanır. İçerik bölünür ve bir ApsaraDB RDS for PostgreSQL veritabanında depolanır. Kendi alana özgü bilgi tabanınızı hazırlamanız gerekir.
Veri hazırlığı aşamasının anahtarı alana özgü bilgiyi metin gömmelerine dönüştürmek ve bu bilgileri etkili bir şekilde depolamak ve eşleştirmektir. LLM'lerin güçlü anlamsal anlama yeteneklerini kullanarak belirli alanınızla ilgili yüksek kaliteli yanıtlar ve öneriler alabilirsiniz. LangChain ve OpenAI'nin açık kaynaklı ChatGPT Retrieval Plugin gibi bazı mevcut açık kaynak çerçeveler URL, Markdown, PDF ve Word gibi formatlardaki bilgi tabanı dosyalarını kolayca yüklemenize ve ayrıştırmanıza olanak tanır. Hem LangChain hem de ChatGPT Retrieval Plugin arka uç vektör veritabanı olarak pgvector uzantısına sahip PostgreSQL'i zaten destekler. Bu durum ApsaraDB RDS for PostgreSQL örneğinizle entegrasyonu kolaylaştırır. Bu entegrasyon sayesinde Aşama 1'de alan bilgi tabanınız için veri hazırlığını tamamlayabilirsiniz. Ayrıca pgvector'un vektör dizine alma ve benzerlik arama özelliklerini verimli metin eşleştirme ve sorgular için tamamen kullanabilirsiniz.
-
Bir test veritabanı oluşturun. Bu örnekte
rds_pgvector_testkullanılır.CREATE DATABASE rds_pgvector_test; -
Test veritabanına bağlanın ve pgvector eklentisini oluşturun.
CREATE EXTENSION IF NOT EXISTS vector; -
Bilgi tabanı içeriğini depolamak için bir test tablosu oluşturun. Bu örnekte
rds_pg_help_docskullanılır.CREATE TABLE rds_pg_help_docs ( id bigserial PRIMARY KEY, title text, -- Document title description text, -- Description doc_chunk text, -- Document chunk token_size int, -- Token count of the document chunk embedding vector(1536)); -- Text embedding information -
Sorguları optimize etmek ve hızlandırmak için embedding sütununda bir dizin oluşturun.
CREATE INDEX ON rds_pg_help_docs USING ivfflat (embedding vector_cosine_ops) WITH (lists = 100);NotVektör sütununda dizin oluşturma hakkında daha fazla bilgi için bkz. pgvector kullanıcı kılavuzu.
-
PyCharm'da bir proje oluşturun, Terminal'i açın ve gerekli bağımlılıkları yüklemek için aşağıdaki komutu çalıştırın.
pip install openai psycopg2 tiktoken requests beautifulsoup4 numpy -
Bilgi tabanı belgesini bölmek ve veritabanında depolamak için bir
.pydosyası oluşturun. Bu örnekteknowledge_chunk_storage.pykullanılır. Örnek kod aşağıdaki gibidir:NotAşağıdaki örnek kodda özel bölme yöntemi bilgi tabanı belgesini yalnızca sabit sayıda karaktere göre böler. Bölme işlemi için LangChain ve OpenAI'nin açık kaynaklı ChatGPT Retrieval Plugin gibi açık kaynak çerçeveler tarafından sunulan yöntemleri kullanabilirsiniz. Bilgi tabanındaki belgelerin kalitesi ve bölme sonuçları nihai çıktı üzerinde önemli bir etkiye sahiptir.
import openai
import psycopg2
import tiktoken
import requests
from bs4 import BeautifulSoup

EMBEDDING_MODEL = "text-embedding-ada-002"
tokenizer = tiktoken.get_encoding("cl100k_base")

# Connect to the RDS for PostgreSQL database
conn = psycopg2.connect(database="<database_name>",
                        host="<instance_endpoint>",
                        user="<username>",
                        password="<password>",
                        port="<port>")
conn.autocommit = True

# OpenAI API key
openai.api_key = '<Secret API Key>'

# Custom splitting method (for example only)
  def get_text_chunks(text, max_chunk_size):
    chunks_ = []
    soup_ = BeautifulSoup(text, 'html.parser')

    content = ''.join(soup_.strings).strip()

    length = len(content)
    start = 0
    while start < length:
        end = start + max_chunk_size
        if end >= length:
            end = length

        chunk_ = content[start:end]
        chunks_.append(chunk_)

        start = end

    return chunks_

# Specify the web page to split
url = 'https://www.alibabacloud.com/help/document_detail/148038.html'

response = requests.get(url)
if response.status_code == 200:
    # Get the web page content
    web_html_data = response.text
    soup = BeautifulSoup(web_html_data, 'html.parser')
    # Get the title (H1 tag)
    title = soup.find('h1').text.strip()

    # Get the description (content of the p tag with class='shortdesc')
    description = soup.find('p', class_='shortdesc').text.strip()

    # Split and store
    chunks = get_text_chunks(web_html_data, 500)
    for chunk in chunks:
        doc_item = {
            'title': title,
            'description': description,
            'doc_chunk': chunk,
            'token_size': len(tokenizer.encode(chunk))
        }

        query_embedding_response = openai.Embedding.create(
            model=EMBEDDING_MODEL,
            input=chunk,
        )

        doc_item['embedding'] = query_embedding_response['data'][0]['embedding']

        cur = conn.cursor()
        insert_query = '''
        INSERT INTO rds_pg_help_docs
            (title, description, doc_chunk, token_size, embedding) VALUES (%s, %s, %s, %s, %s);
        '''

        cur.execute(insert_query, (
            doc_item['title'], doc_item['description'], doc_item['doc_chunk'], doc_item['token_size'],
            doc_item['embedding']))

        conn.commit()

else:
    print('Failed to fetch web page')
Python programını çalıştırın.
-
Veritabanında oturum açın ve bilgi tabanı içeriğinin bölünüp vektör verileri olarak depolanıp depolanmadığını kontrol etmek için aşağıdaki komutu çalıştırın.
SELECT * FROM rds_pg_help_docs;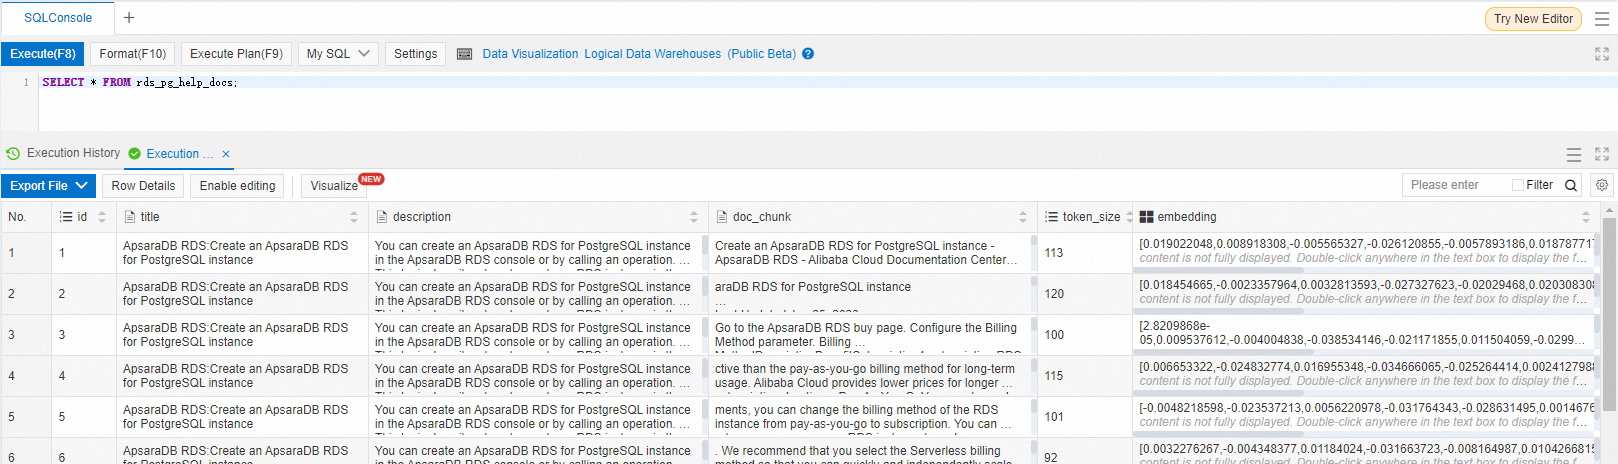
Aşama 2: Soru-cevap
-
Python projesinde bir soru oluşturmak, bunun veritabanındaki bilgi tabanı içeriğiyle benzerliğini karşılaştırmak ve sonucu döndürmek için bir
.pydosyası oluşturun. Bu örnektechatbot.pykullanılır.import openai import psycopg2 from psycopg2.extras import DictCursor GPT_MODEL = "gpt-3.5-turbo" EMBEDDING_MODEL = "text-embedding-ada-002" GPT_COMPLETIONS_MODEL = "text-davinci-003" MAX_TOKENS = 1024 # OpenAI API key openai.api_key = '<Secret API Key>' prompt = 'How to create an RDS for PostgreSQL instance' prompt_response = openai.Embedding.create( model=EMBEDDING_MODEL, input=prompt, ) prompt_embedding = prompt_response['data'][0]['embedding'] # Connect to the RDS for PostgreSQL database conn = psycopg2.connect(database="<database_name>", host="<instance_endpoint>", user="<username>", password="<password>", port="<port>") conn.autocommit = True def answer(prompt_doc, prompt): improved_prompt = f""" Answer the following question based on the provided document and steps: (1) First, analyze the content of the document to see if it is relevant to the question. (2) Second, use only the content from the document for the reply. Be as detailed as possible and output in markdown format. (3) Finally, if the question is not related to RDS for PostgreSQL, reply with "I am not very knowledgeable about topics other than RDS for PostgreSQL." Document: \"\"\" {prompt_doc} \"\"\" Question: {prompt} """ response = openai.Completion.create( model=GPT_COMPLETIONS_MODEL, prompt=improved_prompt, temperature=0.2, max_tokens=MAX_TOKENS ) print(f"{response['choices'][0]['text']}\n") similarity_threshold = 0.78 max_matched_doc_counts = 8 # Filter out document chunks with a similarity greater than a certain threshold using pgvector similarity_search_sql = f''' SELECT doc_chunk, token_size, 1 - (embedding <=> '{prompt_embedding}') AS similarity FROM rds_pg_help_docs WHERE 1 - (embedding <=> '{prompt_embedding}') > {similarity_threshold} ORDER BY id LIMIT {max_matched_doc_counts}; ''' cur = conn.cursor(cursor_factory=DictCursor) cur.execute(similarity_search_sql) matched_docs = cur.fetchall() total_tokens = 0 prompt_doc = '' print('Answer: \n') for matched_doc in matched_docs: if total_tokens + matched_doc['token_size'] <= 1000: prompt_doc += f"\n---\n{matched_doc['doc_chunk']}" total_tokens += matched_doc['token_size'] continue answer(prompt_doc,prompt) total_tokens = 0 prompt_doc = '' answer(prompt_doc,prompt) -
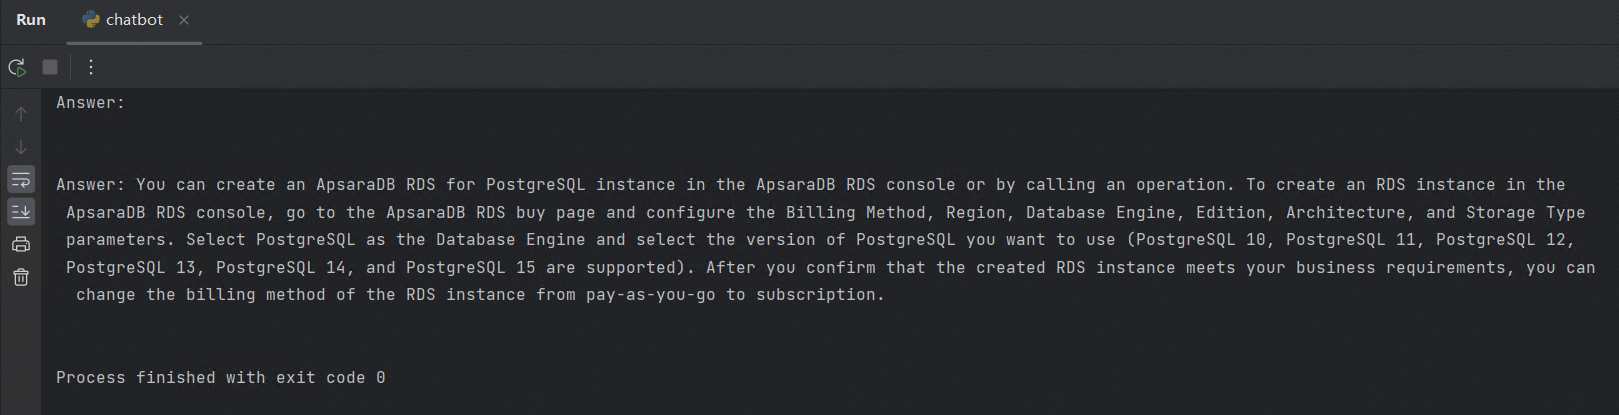
Python programını çalıştırdıktan sonra çalışma penceresinde aşağıdakine benzer bir yanıt görünür:
NotDaha doğru ve eksiksiz yanıtlar almak için bölme yöntemini ve soru istemini optimize edebilirsiniz. Bu konu yalnızca bir örnek sağlar.
Özet
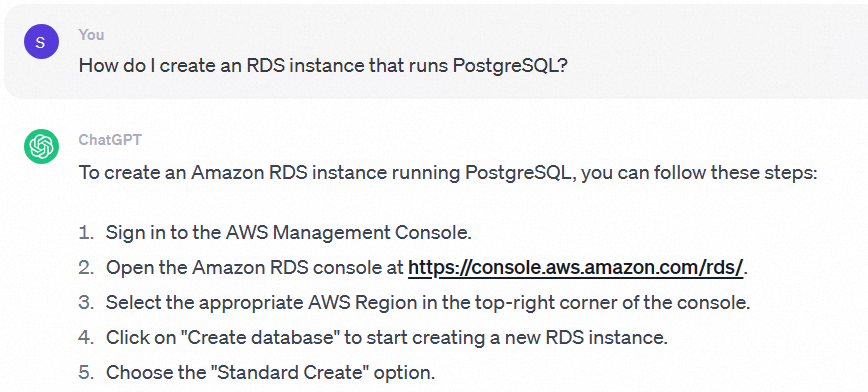
Özel bir bilgi tabanı bağlı değilse OpenAI'nin "Bir RDS for PostgreSQL örneği nasıl oluşturulur?" sorusuna verdiği yanıt genellikle Alibaba Cloud ile ilgili değildir. Örneğin:
ApsaraDB RDS for PostgreSQL veritabanında depolanan özel bilgi tabanına bağlandıktan sonra "Bir RDS for PostgreSQL örneği nasıl oluşturulur?" sorusuna verilen yanıt Alibaba Cloud'un ApsaraDB RDS for PostgreSQL hizmetine özgü olacaktır.
Yukarıdaki örneğe dayanarak ApsaraDB RDS for PostgreSQL'in dikey bir alan için LLM tabanlı bir bilgi tabanı oluşturma konusunda tamamen yeterli olduğu açıktır.