Büyük PolarDB tablolarında analitik sorgular çalıştırdığınızda, varsayılan davranış tam tablo taramasıdır: IMCI veri paketlerini diskten yükler, sıkıştırılmış veriyi açar ve her satırı değerlendirir. Yüz milyonlarca satır içeren tablolar için bu işlem yavaştır ve en son kullanılan (LRU) önbelleği üzerinde baskı oluşturarak saniye başına toplam sorgu sayısını (QPS) düşürür.
PolarDB'nin Bellek İçi Sütun Dizini (IMCI) özelliği, budama tekniği ile bu sorunu çözer. Budama, sorgu verilerin üzerine gelmeden önce tüm veri paketlerini filtreleyerek dışarıda bırakır. Budama, disk G/Ç işlemlerini, hesaplama yükünü ve LRU önbellek dönüşümünü azaltır. 100 GB'lık TPC-H kıyaslamasında, budama sayısal aralık sorguları için sorgu süresini %50'ye kadar azaltır ve bitmap dizinleri düşük kardinalli eşitlik sorguları için sorgu süresini saniyelerden milisaniyelere indirir.
Bu konuda, her bir budama yönteminin nasıl çalıştığı, ne zaman kullanılması gerektiği, sınırlamaları ve gerekli kurulum adımları açıklanmaktadır.
IMCI verileri nasıl düzenler
IMCI, sütun verilerini yaklaşık 64.000 satırlık satır gruplarına ayırarak sıralama anahtarı olmadan ekleme sırasına göre saklar. Verilerin doğal bir sıralaması olmadığından, IMCI kayıtları InnoDB'nin sıralı dizinleri kadar hassas bir şekilde filtreleyemez. Budama yapılmadığında, her sorgu ilgili tüm veri paketlerini yükler.
Bir IMCI budayıcı bir veri paketini değerlendirdikten sonra, paket üç durumdan birine girer:
| Durum | Anlamı | Faydası |
|---|---|---|
| Kabul (AC) | Tüm satırlar eşleşiyor | Satır bazlı değerlendirmeyi atlayın; hesaplama yükünü azaltın |
| Reddet (RE) | Hiçbir satır eşleşmiyor | Paketi diskten yüklemeyi atlayın; G/Ç işlemini azaltın |
| Kısmi kabul (PA) | Bazı satırlar eşleşebilir | Eşleşmeleri bulmak için paketteki her satırı tarayın |
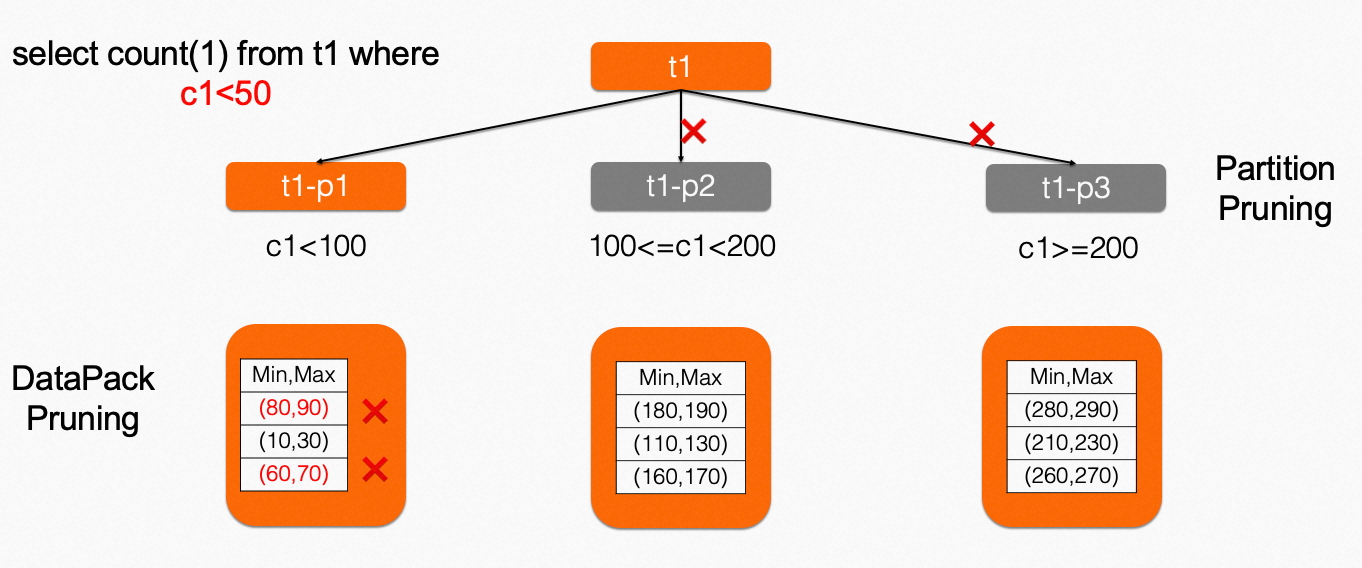
IMCI dört budama yöntemini destekler: bölüm budama, istatistik budama (minmax dizinleri ve Bloom filtreleri), Çalışma Zamanı filtreleri ve bitmap dizinleri.
Budama yöntemi seçme
Verilerinize ve sorgu türünüzüne göre bir yöntem seçmek için aşağıdaki tabloyu kullanın.
| Yöntem | En uygun olduğu durum | Veri özelliği | Sorgu türü | Gerekli kurulum |
|---|---|---|---|---|
| Bölüm budama | Bölümlenmiş tablolar | Veriler zaman veya kategoriye göre örtüşmeyen aralıklara ayrılır | WHERE yan tümcesinde bölüm anahtarı bulunan sorgular | Bölümlenmiş tablo oluşturmak için DDL |
| Minmax dizini | Sürekli sayısal veya zaman damgası değerleri | Sıralı veya kümelenmiş veriler (örneğin, sırayla eklenen zaman damgaları) | Aralık sorguları (>, <, BETWEEN) |
Otomatik |
| Bloom filtresi | Yüksek kardinalli ayrıksı değerler | Rastgele dağıtılmış kimlikler veya kodlar | Nokta sorguları (=, IN) |
Otomatik |
| Çalışma zamanı filtresi | Çoklu tablo birleştirmeleri | Büyük gerçek tabloya birleştirilen küçük boyut tablosu | JOIN, GROUP BY, ORDER BY |
Kurulum gerekmez; sorgu zamanında oluşturulur |
| Bitmap dizini | İstatistik budamanın etkisiz olduğu düşük kardinalli sütunlar | Değerlerin veri paketlerine eşit dağılması | Birden çok sütunda AND, OR yüklemeleri; COUNT(*) toplamaları |
Sütun başına açıkça oluşturma |
Minmax dizinleri ve Bloom filtreleri, IMCI tarafından desteklenen sütun türleri için otomatik olarak oluşturulur. Bölüm budama ve bitmap dizinleri açık kurulum gerektirir. Çalışma zamanı filtreleri kurulum gerektirmez ve sorgu sırasında dinamik olarak oluşturulur.
Bölüm budama
Bölüm budama, herhangi bir veri okumadan önce tüm bölümleri filtreler. Bir WHERE yan tümcesi bölüm anahtarını içerdiğinde, IMCI eşleşen bölümleri belirlemek için bölüm meta verilerini kullanır ve diğerlerinin tümünü atlar.
IMCI üç bölümlendirme yöntemini destekler:
RANGE: Tanımlı sınır noktalarıyla bir tabloyu aralıklara böler. IMCI, eşleşen bölümü bulmak için ikili arama kullanır.
LIST: Ayrık değerleri
<value, part_id>demetlerini kullanarak bölümlere eşler; bu demetler de ikili arama ile aranır.HASH: Olası giriş değerlerini numaralandırır, bunları hash'ler ve her birinin hangi bölüme düştüğünü belirler. Yalnızca az sayıda farklı değere sahip tamsayı alanları için etkilidir.

Örnek: sipariş tarihine göre aralık bölümlendirmesi
orders tablosu aya göre bölümlendirilmişse, aşağıdaki sorgu yalnızca Ocak 2022 bölümüne erişir:
SELECT * FROM orders WHERE order_date = '2022-01-01';IMCI, birleştirmeler arasında denklik çıkarımı yoluyla bölüm budamayı da uygular. Örneğin, hem R hem de S a sütununda bölümlendirilmişse, R.a = S.a AND R.a > 10 koşulu IMCI'nin S.a > 10 sonucunu çıkarmasına ve S bölümlerini de budamasına olanak tanır.
Ne zaman kullanılır:
Çoğu sorgu bölüm anahtarında filtreleme yapar.
Veri yaşam döngüsünü bölüm bazında yönetirsiniz; örneğin, satırları silmek yerine eski bölümleri kaldırabilirsiniz.
İş gereksinimlerinize göre 1. veya 2. düzey bölümlere ihtiyacınız vardır.
Ne zaman kullanılmaz:
Sorguların WHERE yan tümcesinde nadiren bölüm anahtarı bulunur. Bu durumda budamanın hiçbir etkisi olmaz.
Tablo büyüktür ve DDL işlemlerini yoğun olmayan saatlerde gerçekleştiremezsiniz. Mevcut büyük tablolarda DDL işlemleri maliyetlidir.
İstatistik budama
İstatistik budama, bir veri paketinin atlanıp atlanamayacağını belirlemek için bellekte saklanan hafif sütun başı meta verileri kullanır. İstatistikler bellekte bulunduğundan, bunların değerlendirilmesi disk G/Ç işlemi gerektirmez. Bu yaklaşım, ClickHouse'taki veri atlama dizinlerine ve Infobright'ın Knowledge Grid yapısına benzer.
IMCI iki istatistik tabanlı budayıcı sağlar: minmax dizinleri ve Bloom filtreleri. Her ikisi de otomatik olarak oluşturulur.
Minmax dizini
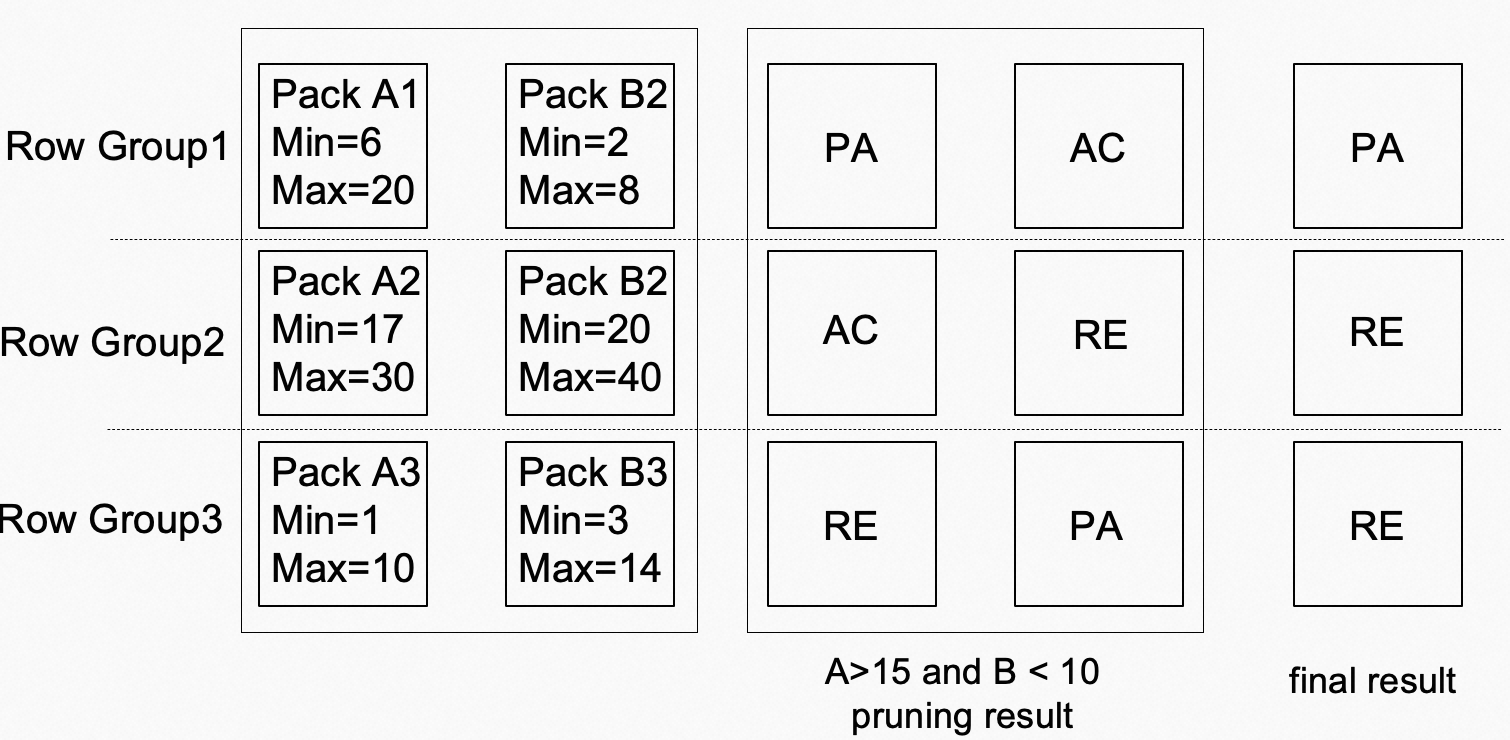
Bir minmax dizini, bir sütun için her veri paketinin minimum ve maksimum değerini saklar. Sorgu sırasında, IMCI sorgunun aralık yüklemesini bu sınırlarla karşılaştırır. Sorgu aralığı bir paketin [min, maks] aralığı ile örtüşmüyorsa, paket diskten yüklenmeden reddedilir.
Örnek: A > 15 AND B < 10 koşulu ve sütun başına üç veri paketi ile bir minmax dizini, üç paketten ikisini reddeder ve tarama iş yükünü üçte iki oranında azaltır.
Ne zaman kullanılır:
Sütunlar zaman damgaları, tarihler veya sayısal aralıklar gibi sürekli değerler içerir.
Veriler kabaca sıralı bir düzende eklendiğinden, paket başına min/maks aralıkları dar ve örtüşmez.
Ne zaman kullanılmaz:
Sütun değerleri tüm paketlere eşit olarak dağıtılır. Örtüşen min/maks aralıkları dizini etkisiz hale getirir.
Bloom filtresi
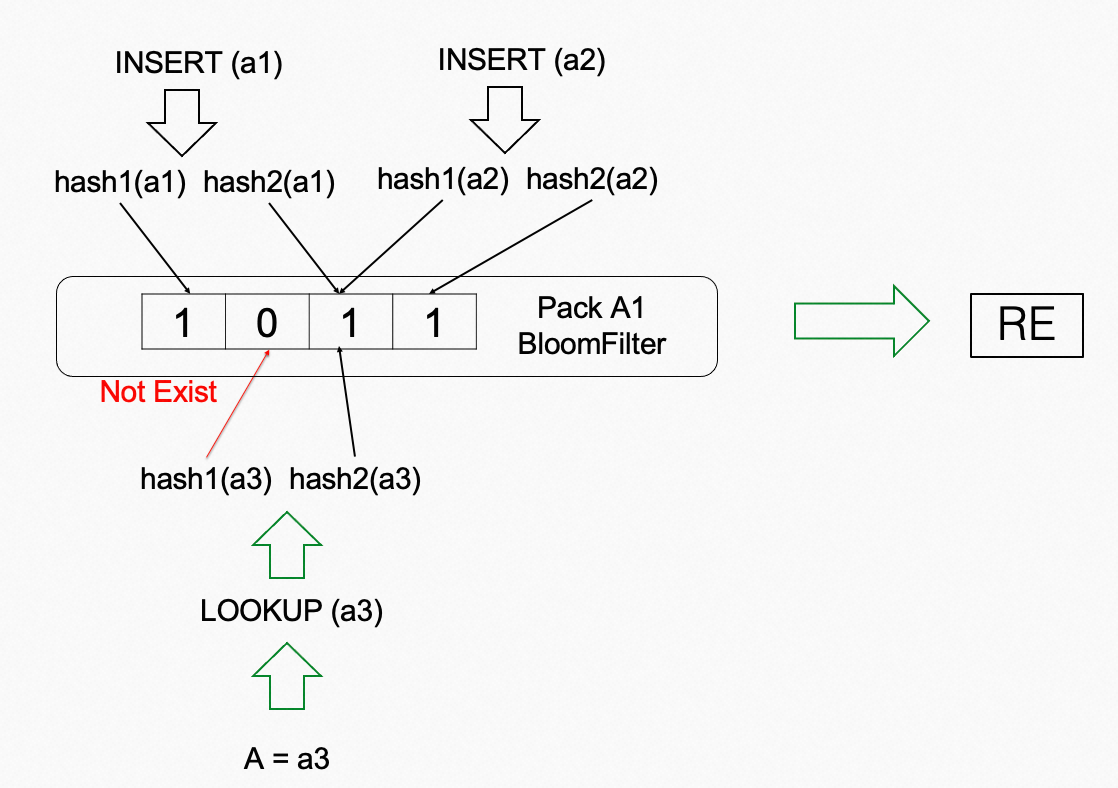
Bloom filtresi, bir bit dizisi ve birden çok hash fonksiyonu kullanarak küme üyeliğini kontrol eden olasılıksal bir veri yapısıdır. IMCI bir veri paketi için Bloom filtresi oluşturduğunda, her değeri birkaç bite eşler. Sorgu zamanında, eşlenen bitlerden herhangi biri 0 ise, değer kesinlikle yoktur ve paket reddedilir.
Bloom filtreleri yanlış pozitif sonuçlar üretebilir; yani, aslında mevcut olmayan bir değerin var olduğunu bildirebilir.
Ne zaman kullanılır:
Sütunlar rastgele oluşturulan kimlikler, sipariş numaraları veya ürün kodları gibi yüksek kardinalli ayrıksı değerler içerir.
Sorgular eşitlik (
=) veyaINyüklemelerini kullanır.
Ne zaman kullanılmaz:
Sütun değerleri paketlere eşit şekilde yayılır. Yanlış pozitifler artar ve filtreleme etkinliği düşer.
Minmax dizinleri ve Bloom filtrelerini birleştirme
IMCI her iki budayıcıyı birlikte değerlendirir. En az bir budayıcı bir veri paketini reddederse, paket atlanır. Bunları birlikte kullanmak, tek başlarına kullanmaya kıyasla budama kapsamını iyileştirir.
Boş bırakılabilir sütun desteği
IMCI, boş bırakılabilir sütunlarda minmax dizinleri ve Bloom filtreleri oluşturmanıza olanak tanır; IS NULL, IS NOT NULL, >, < ve = gibi yüklemeleri destekler.
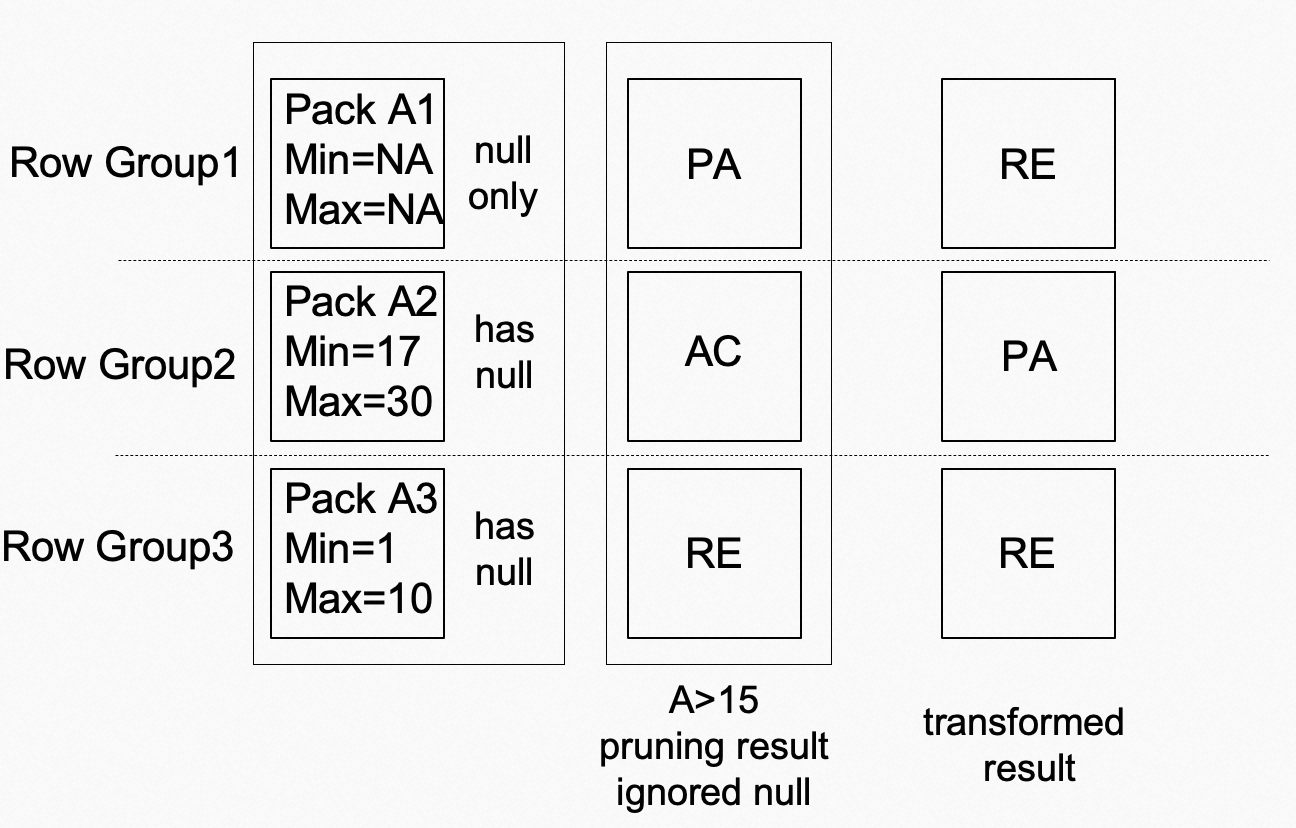
Bir budayıcı oluştururken, IMCI null değerlerini min/maks hesaplamalarından hariç tutar. {1, 2, 3, NULL} içeren bir paketin min=1 ve maks=3 değerleri vardır. Sorgu zamanında, sonuçlar null değerleri yok sayarak hesaplanır ve ardından her paketin null içerip içermediğine göre ayarlanır:
Yalnızca null değerler içeren bir paket, değer yüklemeleri tarafından budanamaz.
Kısmen null değerler içeren bir paket, null olmayan min/maks aralığına dayanarak yine de budanabilir.
Örnek: A > 15 koşulu ve üç paketle; Paket A1 yalnızca null değerler içerirken, Paket A2 ve Paket A3 kısmen null değerler içerir:
Null değerler olmadan değerlendirin:
[PA, AC, RE]Null varlığına göre ayarlayın: Paket A1 (yalnızca null) filtreleneemez —
REolarak dönüştürün.Sonuç:
[RE, PA, RE]. Paket A1 ve A3 budanır.
Eşit dağıtılmış verilerde budama etkinliğini artırma
Değerler veri paketlerine eşit olarak dağıtıldığında, min/maks aralıkları örtüştüğü ve Bloom filtreleri daha fazla yanlış pozitif ürettiği için istatistik budama daha az etkilidir.
Etkinliği artırmak için:
Veri paketi boyutunu küçültün: Daha küçük paketler daha ince taneli dizinler ve daha dar min/maks aralıkları üretir. Daha küçük paketlerin daha fazla bellek tükettiğini unutmayın.
Sıralama anahtarı kullanın: IMCI'nin sıralama anahtarı özelliği, istatistikleri oluşturmadan önce verileri yeniden sıralayarak benzer değerleri aynı paketlerde kümeler ve budama doğruluğunu artırır.
Budayıcıları devre dışı bırakın: İstatistik budama, sorgu performansını iyileştirmeden ek yük getiriyorsa — örneğin, düzgün dağıtılmış sütunlarda — bu sorgular için ilgili budayıcıları devre dışı bırakın.
Çalışma zamanı filtreleri
Çalışma zamanı filtresi, bir sorgu yürütülürken dinamik olarak oluşturulur. Bir birleştirmenin bir tarafındaki (genellikle daha küçük boyut tablosu) sonuç kümesini yakalar ve bunu gerçek tablo taraması başlamadan önce diğer tarafa (genellikle daha büyük gerçek tablo) filtre olarak iletir. Sorgu ilerledikçe ve filtre sıkılaştıkça — örneğin, bir TopK sorgusu daha iyi adaylar bulup minimum eşiği yükselttikçe — daha fazla paket dinamik olarak budanır.
IMCI iki tür Çalışma zamanı filtresini destekler:
Minmax Çalışma zamanı filtresi: Oluşturma tarafı sonuç kümesinin min ve maks değerlerinden bir aralık ifadesi (örneğin,
id > 1 AND id < 100) oluşturur.Bloom filtresi Çalışma zamanı filtresi: STRING türündeki sütunların eşitlik tabanlı filtrelenmesi için oluşturma tarafı sonuç kümesi üzerinde bir Bloom filtresi oluşturur.
Bloom filtresi Çalışma zamanı filtreleri bellek yükünü artırır ve büyük sonuç kümeleri için uygun değildir.
Örnek: hash birleştirmesini hızlandırma
SELECT * FROM sales JOIN items ON sales.item_id = items.id WHERE items.price > 1000Burada items boyut tablosu (küçük) ve sales gerçek tablodur (büyük). IMCI, price > 1000 koşulunu sağlayan item_id değerlerinden bir Çalışma zamanı filtresi oluşturur. Elde edilen kimlikler 1 ile 100 arasındaysa, IMCI id > 1 AND id < 100 veya IN(id1, id2, id3 ...) oluşturur ve bunu sales taramasına iletir, böylece herhangi bir birleştirme probu gerçekleşmeden önce satırlar budanır.
Filtrelenen sütunda bir minmax budayıcı varsa, IMCI Çalışma zamanı filtresini kullanarak veri paketlerini daha da budar ve hem taranan satır sayısını hem de yüklenen paket sayısını azaltır.
Çalışma zamanı filtreleri GROUP BY ve ORDER BY sorgularına da uygulanır. Massively Parallel Processing (MPP) senaryolarında, düğümler arasında karıştırılan veri hacmini azaltırlar.

Bitmap dizinleri
Bir bitmap dizini, bir sütundaki her farklı değer için bir bit vektörü atar. Her bit, o değerin belirli bir satırda görünüp görünmediğini temsil eder. Bir filtre yüklemesini değerlendirmek için, IMCI ilgili bit vektörlerinde bitsel AND/OR işlemleri gerçekleştirir ve tam veri paketlerini yüklemeden doğrudan eşleşen satır numaralarını alır.
Bitmap dizinleri şu durumlarda en etkilidir:
Sütunların düşük kardinalliği vardır (örneğin, durum, kategori, pazar segmenti) ve değerler veri paketlerine eşit şekilde yayılır, bu da istatistik budamayı etkisiz hale getirir.
Sorgular birden çok filtre yüklemesini
ANDveyaORile birleştirir.Sorgular, tek tek satırları somutlaştırmadan toplama yapar; örneğin,
SELECT COUNT(*) FROM t WHERE ....
B-tree dizinleriyle karşılaştırıldığında, bitmap dizinleri düşük kardinalli sütunlar için daha az depolama alanı kullanır. Ancak, global bitmap dizinleri satır güncellemelerinde tüm tablonun kilitlenmesini gerektirir, bu da onları en çok okuma ağırlıklı iş yükleri için uygun hale getirir.

Performans kıyaslaması
Aşağıdaki sonuçlar, bellek içi depolama kullanarak eşzamanlılık 1'de 100 GB'lık TPC-H verisi üzerinde budayıcı ve bitmap dizini hızlandırmalarını ölçer. G/Ç odaklı iş yükleri daha büyük iyileşme gösterir.
Budayıcı hızlandırması (Q1–Q5)
Q1–Q3, partsupp.ps_suppkey (sayısal aralık) üzerinde minmax dizini hızlandırmasını test eder. Q4–Q5, orders.o_clerk (dize eşitliği ve IN) üzerinde Bloom filtresi hızlandırmasını test eder.
| Sorgu | Budayıcılar olmadan (sn) | Budayıcılarla (sn) |
|---|---|---|
Q1: ps_suppkey = 41164 |
0.11 | 0.05 |
Q2: ps_suppkey IN (41164, 58321) |
0.14 | 0.07 |
Q3: ps_suppkey BETWEEN 40000 AND 50000 |
0.13 | 0.06 |
Q4: o_clerk = 'Clerk#000068170' |
0.89 | 0.43 |
Q5: o_clerk IN ('Clerk#000068170', 'Clerk#000087784') |
1.85 | 1.35 |
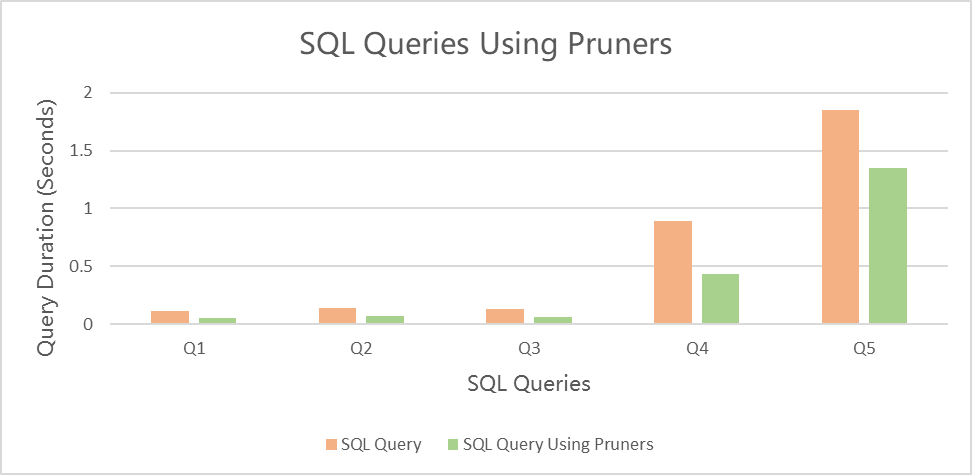
Hızlandırma oranı, filtrelenen veri paketi sayısıyla orantılıdır.
Bitmap dizini hızlandırması (Q6–Q9)
customer.c_mktsegment sütunu eşit dağıtılmış değerlere sahiptir, bu nedenle yalnızca budayıcılar (Q6–Q8) herhangi bir fayda sağlamaz. Bitmap dizinleri eklemek sorgu süresini önemli ölçüde azaltır.
| Sorgu | Budayıcılar olmadan (sn) | Yalnızca budayıcılarla (sn) | Budayıcılar + bitmap dizinleriyle (sn) |
|---|---|---|---|
Q6: c_mktsegment = 'AUTOMOBILE' |
1.43 | 1.43 | 0.03 |
Q7: c_mktsegment IN ('AUTOMOBILE', 'FURNITURE', 'BUILDING') |
3.49 | 3.49 | 0.07 |
Q8: c_mktsegment = 'AUTOMOBILE' OR c_phone = '18-338-906-3675' |
2.48 | 2.48 | 1.09 |
Q9: c_mktsegment = 'AUTOMOBILE' AND c_phone = '18-338-906-3675' |
1.25 | 0.05 | 0.05 |
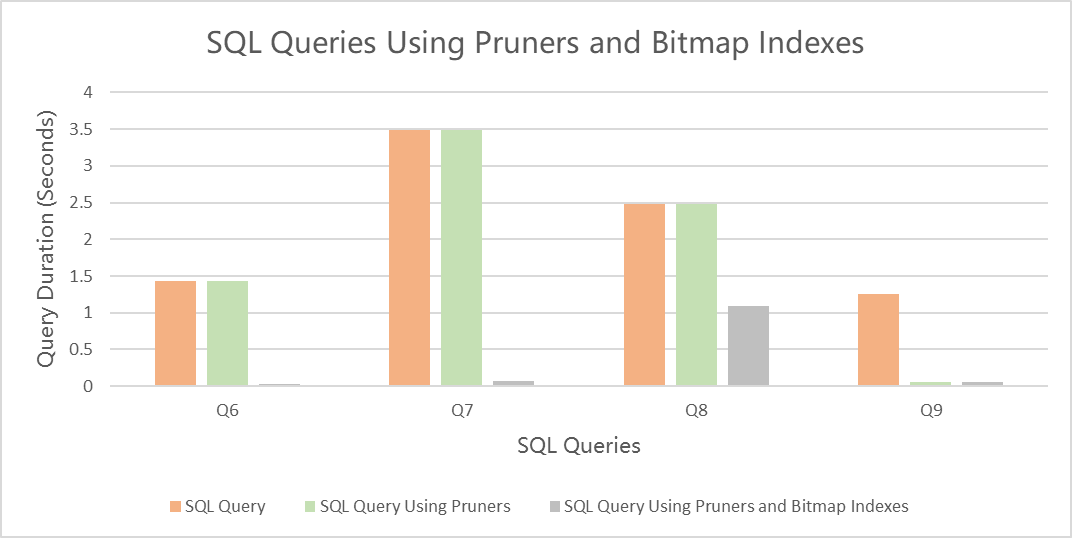
Q9, yalnızca budayıcılardan faydalanır çünkü AND yüklemi, en az bir sütunda minmax veya Bloom filtresi budamasına olanak tanır. Q8 (OR), her iki sütunun da filtreyi bağımsız olarak geçmesini gerektirir ki bunu yalnızca bitmap dizinleri etkili bir şekilde halleder.
Sonraki adımlar
IMCI'de TopK operatörü uygulaması — IMCI'nin ORDER BY ... LIMIT desenine sahip TopK sorgularını hızlandırmak için istatistikleri nasıl kullandığını ve Çalışma zamanı filtrelerinin sorgu yürütülürken dinamik olarak nasıl sıkılaştığını açıklar.