PolarDB for MySQL 8,0, esnek paralel sorgu (ePQ) özelliğini sunar. Sorgulanan veri miktarı belirtilen eşiği aştığında ePQ özelliği otomatik olarak etkinleşir ve bu sayede sorgu çalıştırma süresi önemli ölçüde azalır.
Giriş
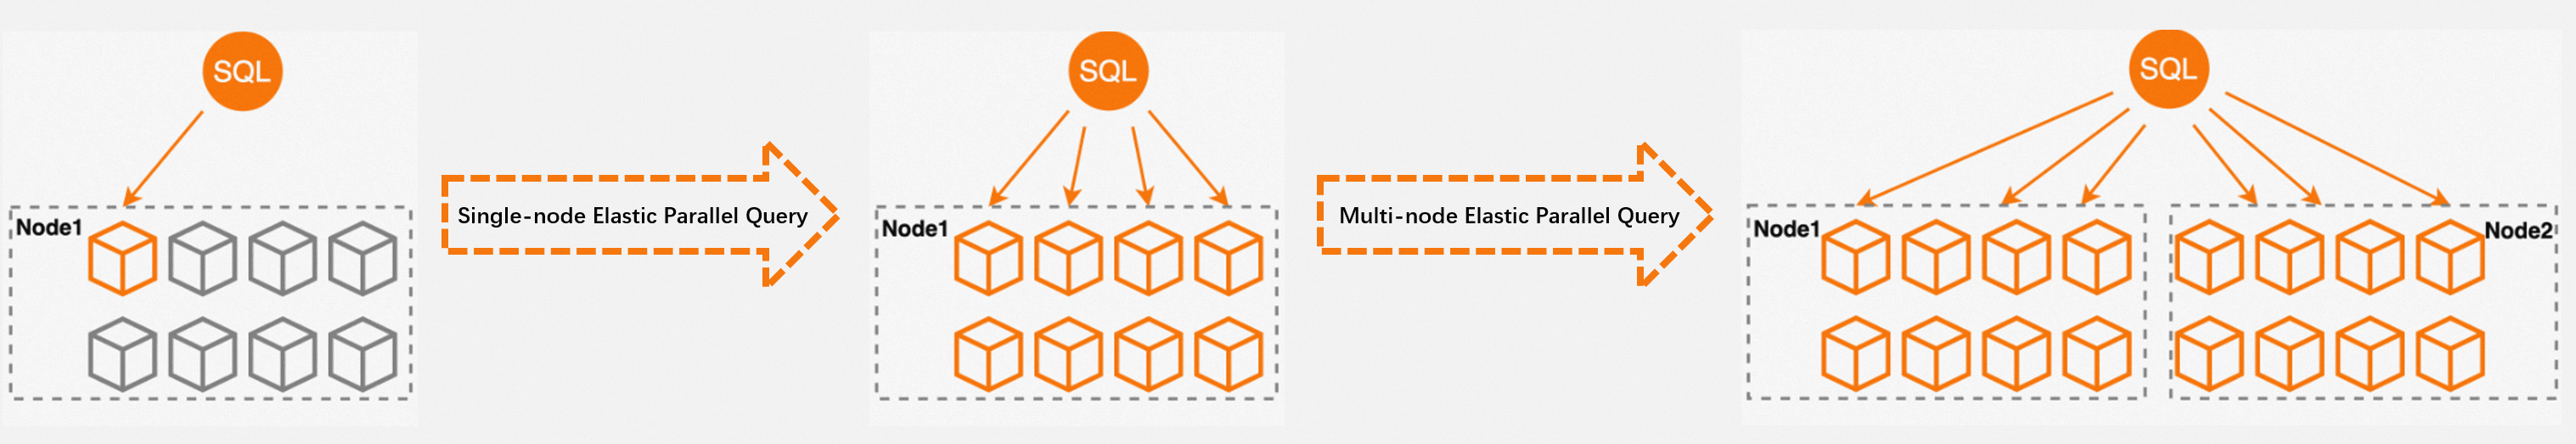
ePQ özelliği iki paralel altyapıyı destekler: tek düğümlü esnek paralel sorgu ve çok düğümlü esnek paralel sorgu. Tek düğümlü esnek paralel sorgu, orijinal paralel sorgu özelliğine eşdeğerdir. Çok düğümlü esnek paralel sorgu ise bir küme içindeki düğümler arasında uyarlamalı zamanlamayı destekler.
PolarDB for MySQL 8,0.1 yalnızca tek düğümlü esnek paralel sorguyu destekler. Sorgu verileri depolama katmanında farklı iş parçacıklarına bölünür. İş parçacıkları paralel olarak çalışır ve sonuçları lider iş parçacığına döndürür. Ardından lider iş parçacığı sonuçları birleştirir ve nihai sonucu kullanıcılara iletir. Bu yaklaşım sorgu verimliliğini artırır.
PolarDB for MySQL 8,0.2 hem tek düğümlü hem de çok düğümlü esnek paralel sorguyu destekler. Çok düğümlü esnek paralel sorgu, doğrusal hızlandırma yeteneklerini önemli ölçüde iyileştirir ve çok düğümlü dağıtılmış paralel hesaplamayı uygular. Maliyet tabanlı optimizasyon sayesinde yürütme planları esnek hale gelir ve paralel çalışabilir. Bu durum, tek düğümlü esnek paralel sorgularda ortaya çıkan potansiyel lider darboğazlarını ve çalışan yük dengesizliklerini giderir. Ayrıca tek bir düğümün CPU, bellek ve G/Ç darboğazlarının üstesinden gelir. Çok düğümlü kaynak görünümleri ve paralel hesaplama görevlerinin uyarlamalı zamanlanması, paralel hesaplama yeteneklerini büyük ölçüde artırır, sorgu gecikme süresini azaltır, düğümlerin kaynak yüklerini dengeler ve kümenin genel kaynak kullanımını iyileştirir.
ePQ özelliği, küme içindeki çok çekirdekli CPU'ların paralel işleme yeteneklerinden tam yararlanarak cloud tabanlı kullanıcı örneklerinde düşük ve dengesiz CPU kaynağı kullanım sorununu çözebilir. Aşağıdaki şekilde, 8 çekirdekli ve 32 GB PolarDB for MySQL kümesinde (özel teknik özellikler) süreç gösterilmektedir.
Ön koşullar
PolarDB for MySQL kümesi aşağıdaki gereksinimleri karşılamalıdır:
-
Tek düğümlü esnek paralel sorgu:
Veritabanı motoru: Düzeltme sürümü 8,0.1.0.5 veya sonraki bir sürüm olan 8,0.1.
Veritabanı sürümü: Enterprise Edition .
-
Tek düğümlü esnek paralel sorgu:
Veritabanı motoru: Düzeltme sürümü 8,0.2.1.4.1 veya sonraki bir sürüm olan 8,0.2.
Veritabanı sürümü: Enterprise Edition.
-
Çok düğümlü esnek paralel sorgu:
Veritabanı motoru: Düzeltme sürümü 8,0.2.2.6 veya sonraki bir sürüm olan 8,0.2.
Veritabanı sürümü: Enterprise Edition.
Bir kümenin sürümünü görüntüleme hakkında bilgi için bkz. Motor sürümünü sorgulama.
Senaryolar
ePQ özelliği, büyük tablolar üzerindeki sorgular, JOIN deyimleri kullanan çoklu tablo sorguları ve büyük miktarda veri içeren sorgular gibi çoğu SELECT deyimi için uygundur. Özellik, kısa süreli sorgular için önemli faydalar sağlamaz. Çeşitli paralel yöntemler, özelliği aşağıdaki senaryolar için uygun kılar:
-
Büyük veri hacimli analitik sorgular
Orta veya büyük miktarda veri söz konusu olduğunda, analitik sorgular için kullanılan SQL deyimleri genellikle karmaşıktır ve zaman alır. Yanıt süresini doğrusal olarak azaltmak için ePQ özelliğini etkinleştirebilirsiniz.
-
Dengesiz kaynak yükleri
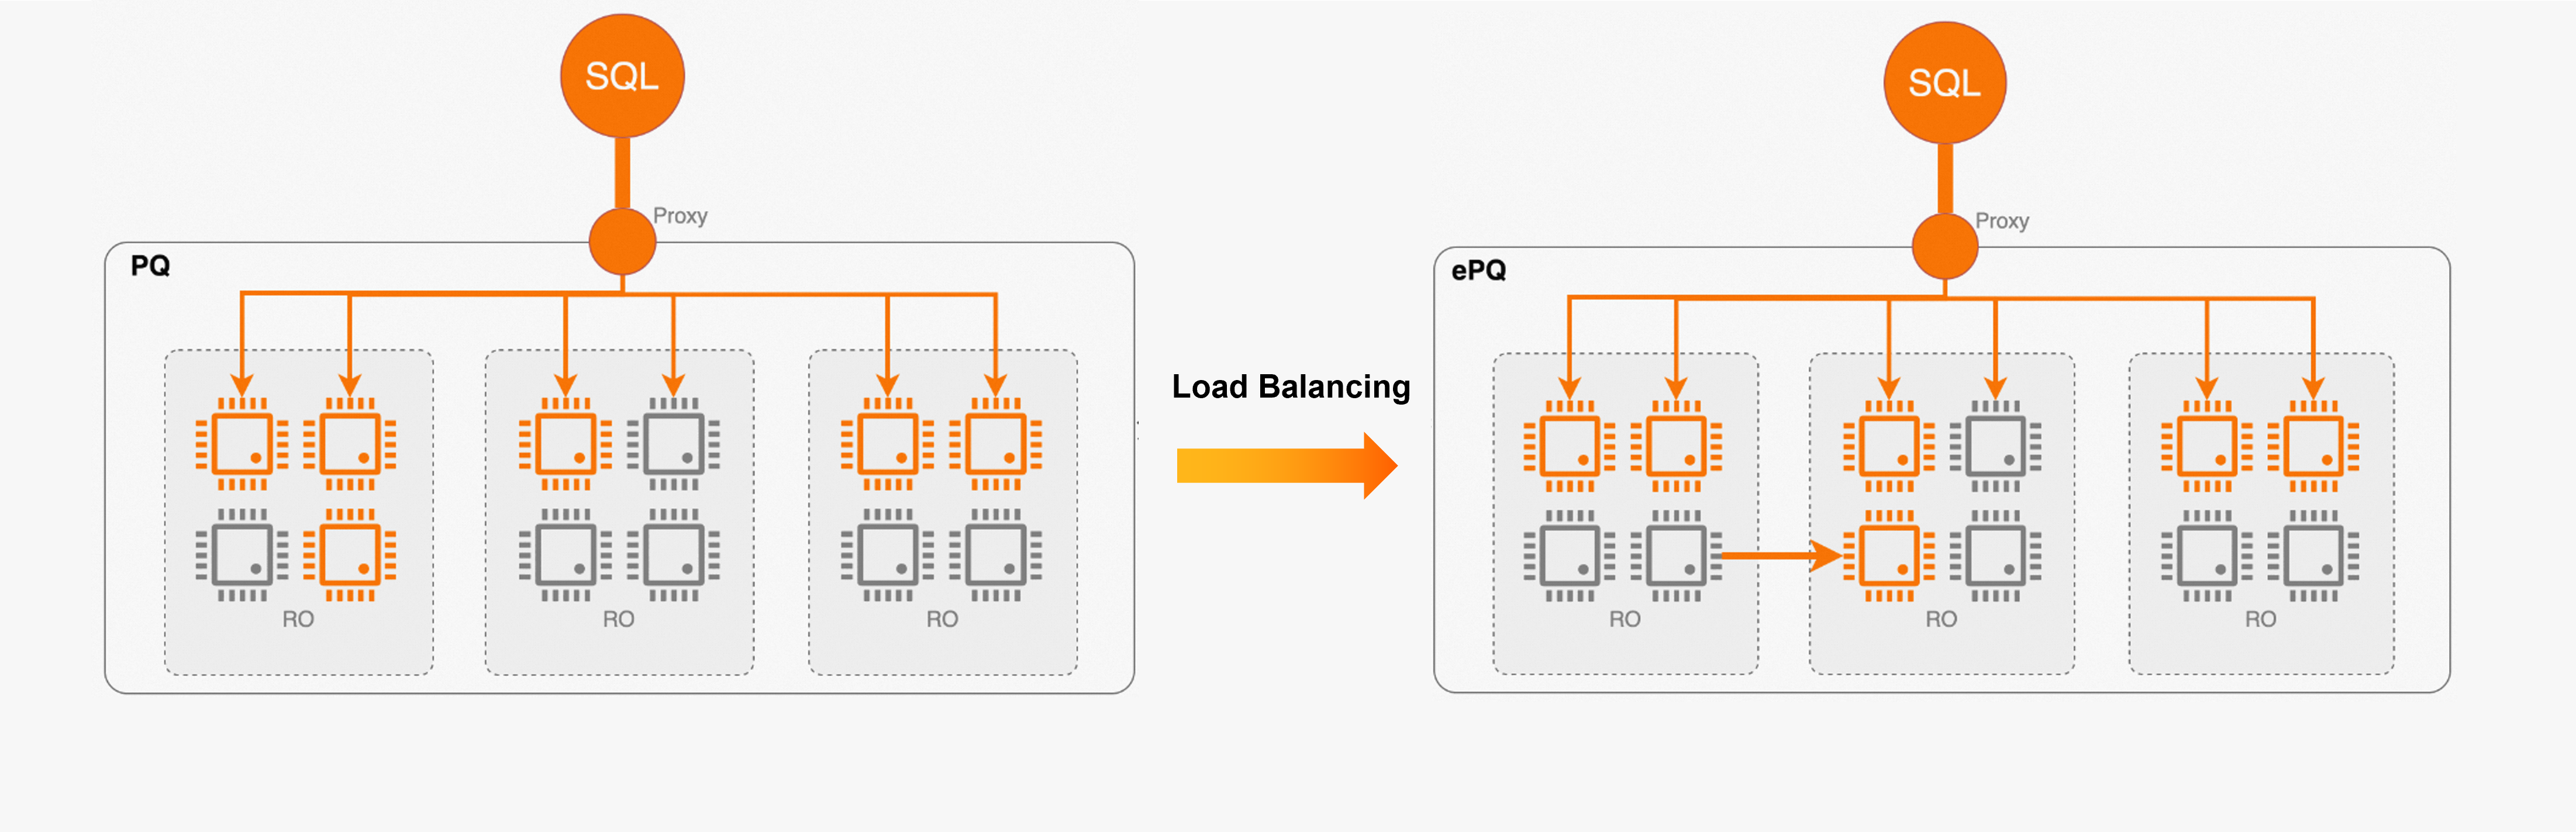
PolarProxy'nin yük dengeleme yetenekleri, bir kümedeki düğümler için benzer sayıda bağlantı oluşturulmasını sağlamaya yardımcı olabilir. Ancak, sorgulardaki hesaplama karmaşıklığı ve kaynak kullanımı farklılıkları nedeniyle, bağlantı tabanlı yük dengeleme düğümler arasındaki yük dengesizliğini tamamen önleyemez. Diğer dağıtılmış veritabanlarında olduğu gibi,热点 (hotspot) düğümler PolarDB üzerinde olumsuz etki yaratır:
Bir hotspot salt-okunur düğüm yavaş sorgulara neden olursa, birincil düğüm undo loglarını temizleyemeyebilir ve bu durum disk şişmesine yol açar.
Bir hotspot salt-okunur düğüm yavaş redo apply işlemlerine neden olursa, birincil düğüm verileri flush edemeyebilir ve bu durum yazma aktarım hızı performansının düşmesine neden olur.
ePQ özelliği, genel kaynak görünümlerini ve görünümlere dayalı uyarlamalı görev zamanlamasını tanıtır. Her düğümün resource usage ve data affinity değerlerine göre, bazı veya tüm sorgu görevleri boşta kalan kaynaklara sahip düğümlere zamanlanır. Bu sayede istenen paralellik derecesi (DOP) ve küme içinde dengeli kaynak kullanımı sağlanır.
-
Esnek hesaplama
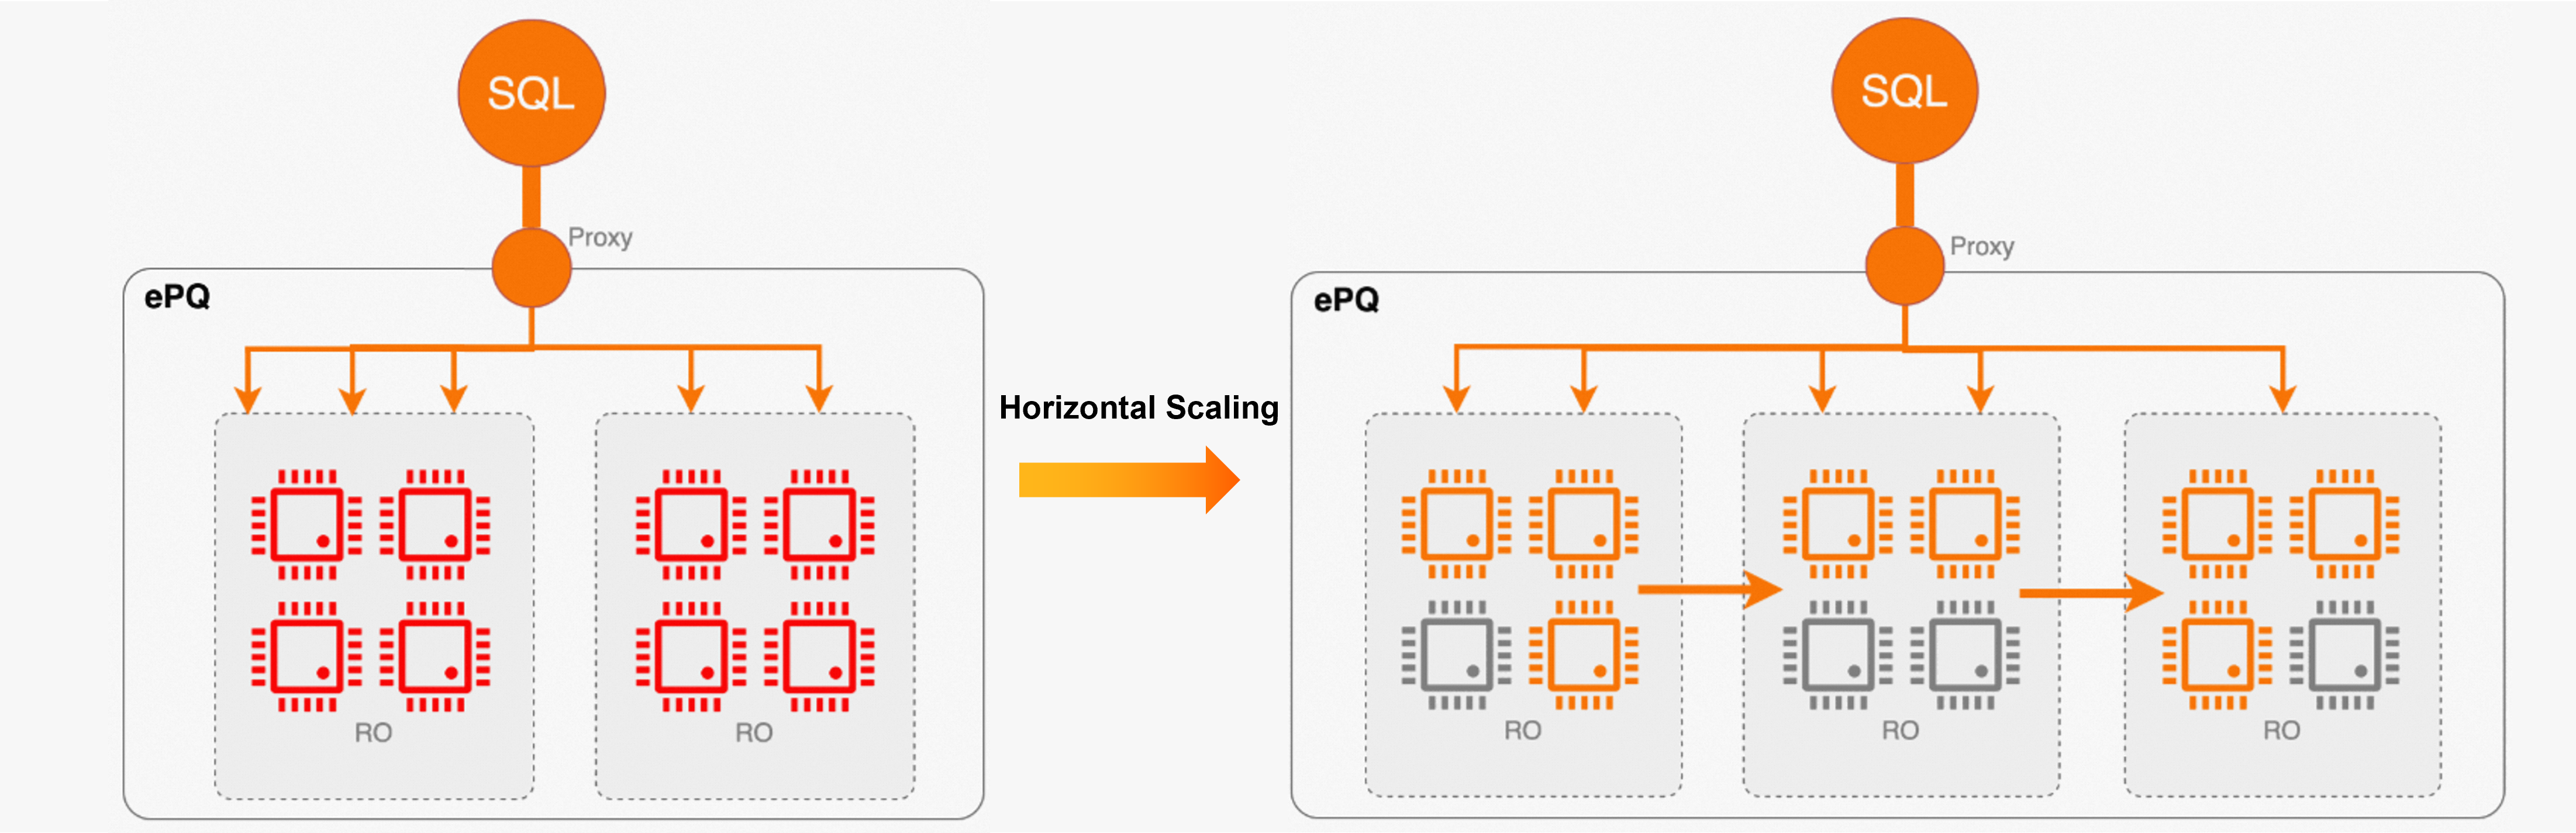
Esneklik, PolarDB'nin temel yeteneklerinden biridir. Otomatik ölçeklendirme, kısa süreli sorgular için uygun esneklik sağlar. Ancak, büyük ölçekli sorgu senaryolarında tek bir sorguya ek düğümler eklenerek hızlandırılamayacağından karmaşık analitik sorgular için uygun değildir. Bir küme için ePQ özelliği etkinleştirildiğinde, yeni ölçeklendirilmiş düğümler kümeye otomatik olarak eklenerek hesaplama kaynaklarını paylaşır ve esnekliği artırır.
-
Çevrimiçi ve çevrimdışı hizmetlerin kombinasyonu
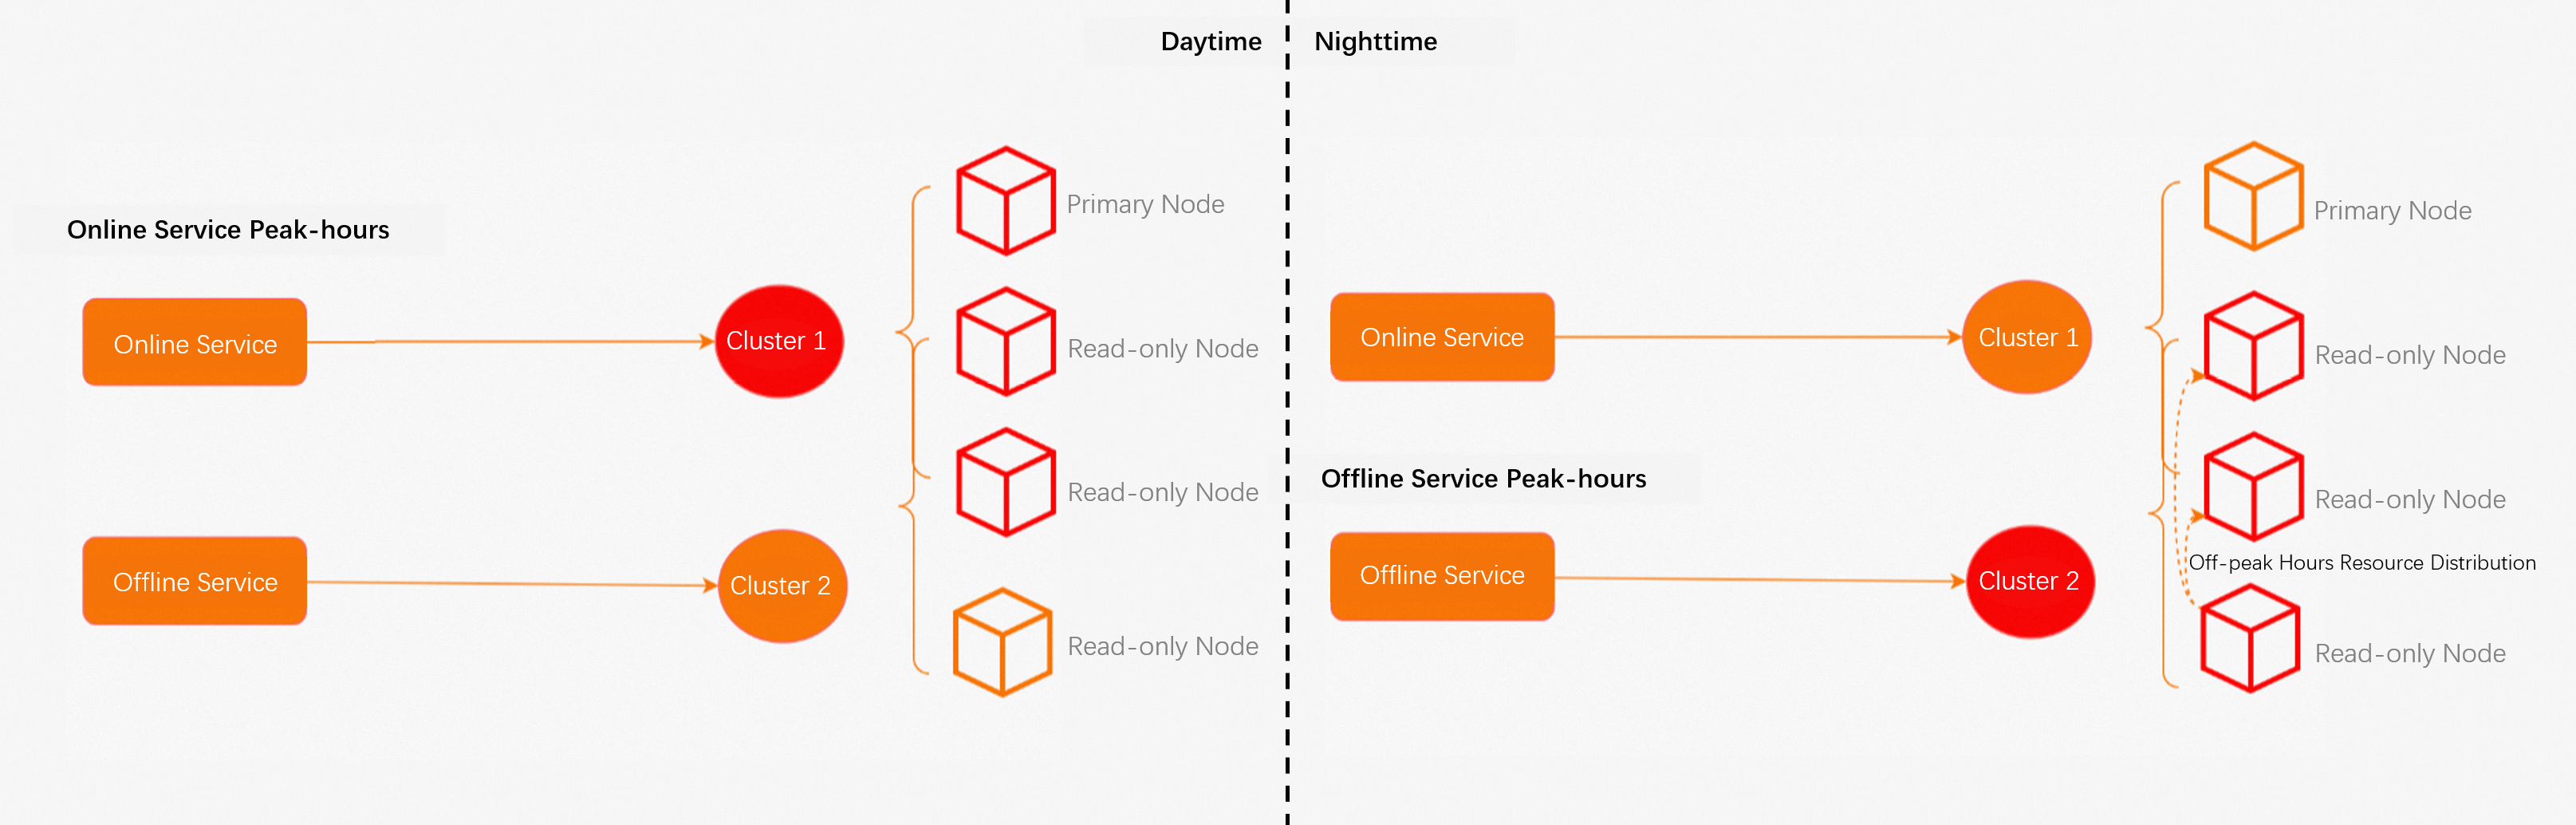
En etkili yalıtım yöntemi, çevrimiçi işlem hizmetini ve çevrimdışı analitik hizmeti farklı düğüm kümelerine yönlendirmektir. Ancak bu yöntem maliyeti artırır. Çoğu durumda, çevrimiçi işlem hizmeti ile çevrimdışı analitik hizmetin yoğunluk saatleri farklıdır. Ekonomik bir yöntem, çevrimiçi işlem hizmeti ile çevrimdışı analitik hizmet arasında küme kaynaklarını paylaşmak ve hizmetleri farklı küme uç noktalarına yönlendirmektir. ePQ özelliği etkinleştirildikten sonra, çevrimiçi işlem hizmetinin yoğun olmayan saatlerinde boşta kalan kaynaklar çevrimdışı analitik hizmete dağıtılarak maliyetler düşürülür ve verimlilik artırılır.
Kullanım notları
ePQ özelliğinin nasıl kullanılacağı hakkında bilgi için bkz. Başlangıç.
Performans metrikleri
Aşağıdaki test, TPC Benchmark H (TPC-H) temel alınarak oluşturulan 100 GB veriyi kullanarak bir PolarDB for MySQL 8,0 kümesinin performansını inceler. Testte, PolarDB kümesi, 32 CPU çekirdeği ve 256 GB belleğe sahip (Dedicated) dört düğümden oluşur. Tek düğümlü esnek paralel sorgu için max_parallel_degree parametresi sırasıyla 32 ve 0 olarak ayarlanmıştır. Seri sorgu, DOP değeri 32 olan tek düğümlü esnek paralel sorgu ve DOP değeri 128 olan dört düğümlü esnek paralel sorgu performans verilerini karşılaştırın. Daha fazla bilgi için bkz. Paralel sorgu performansı.
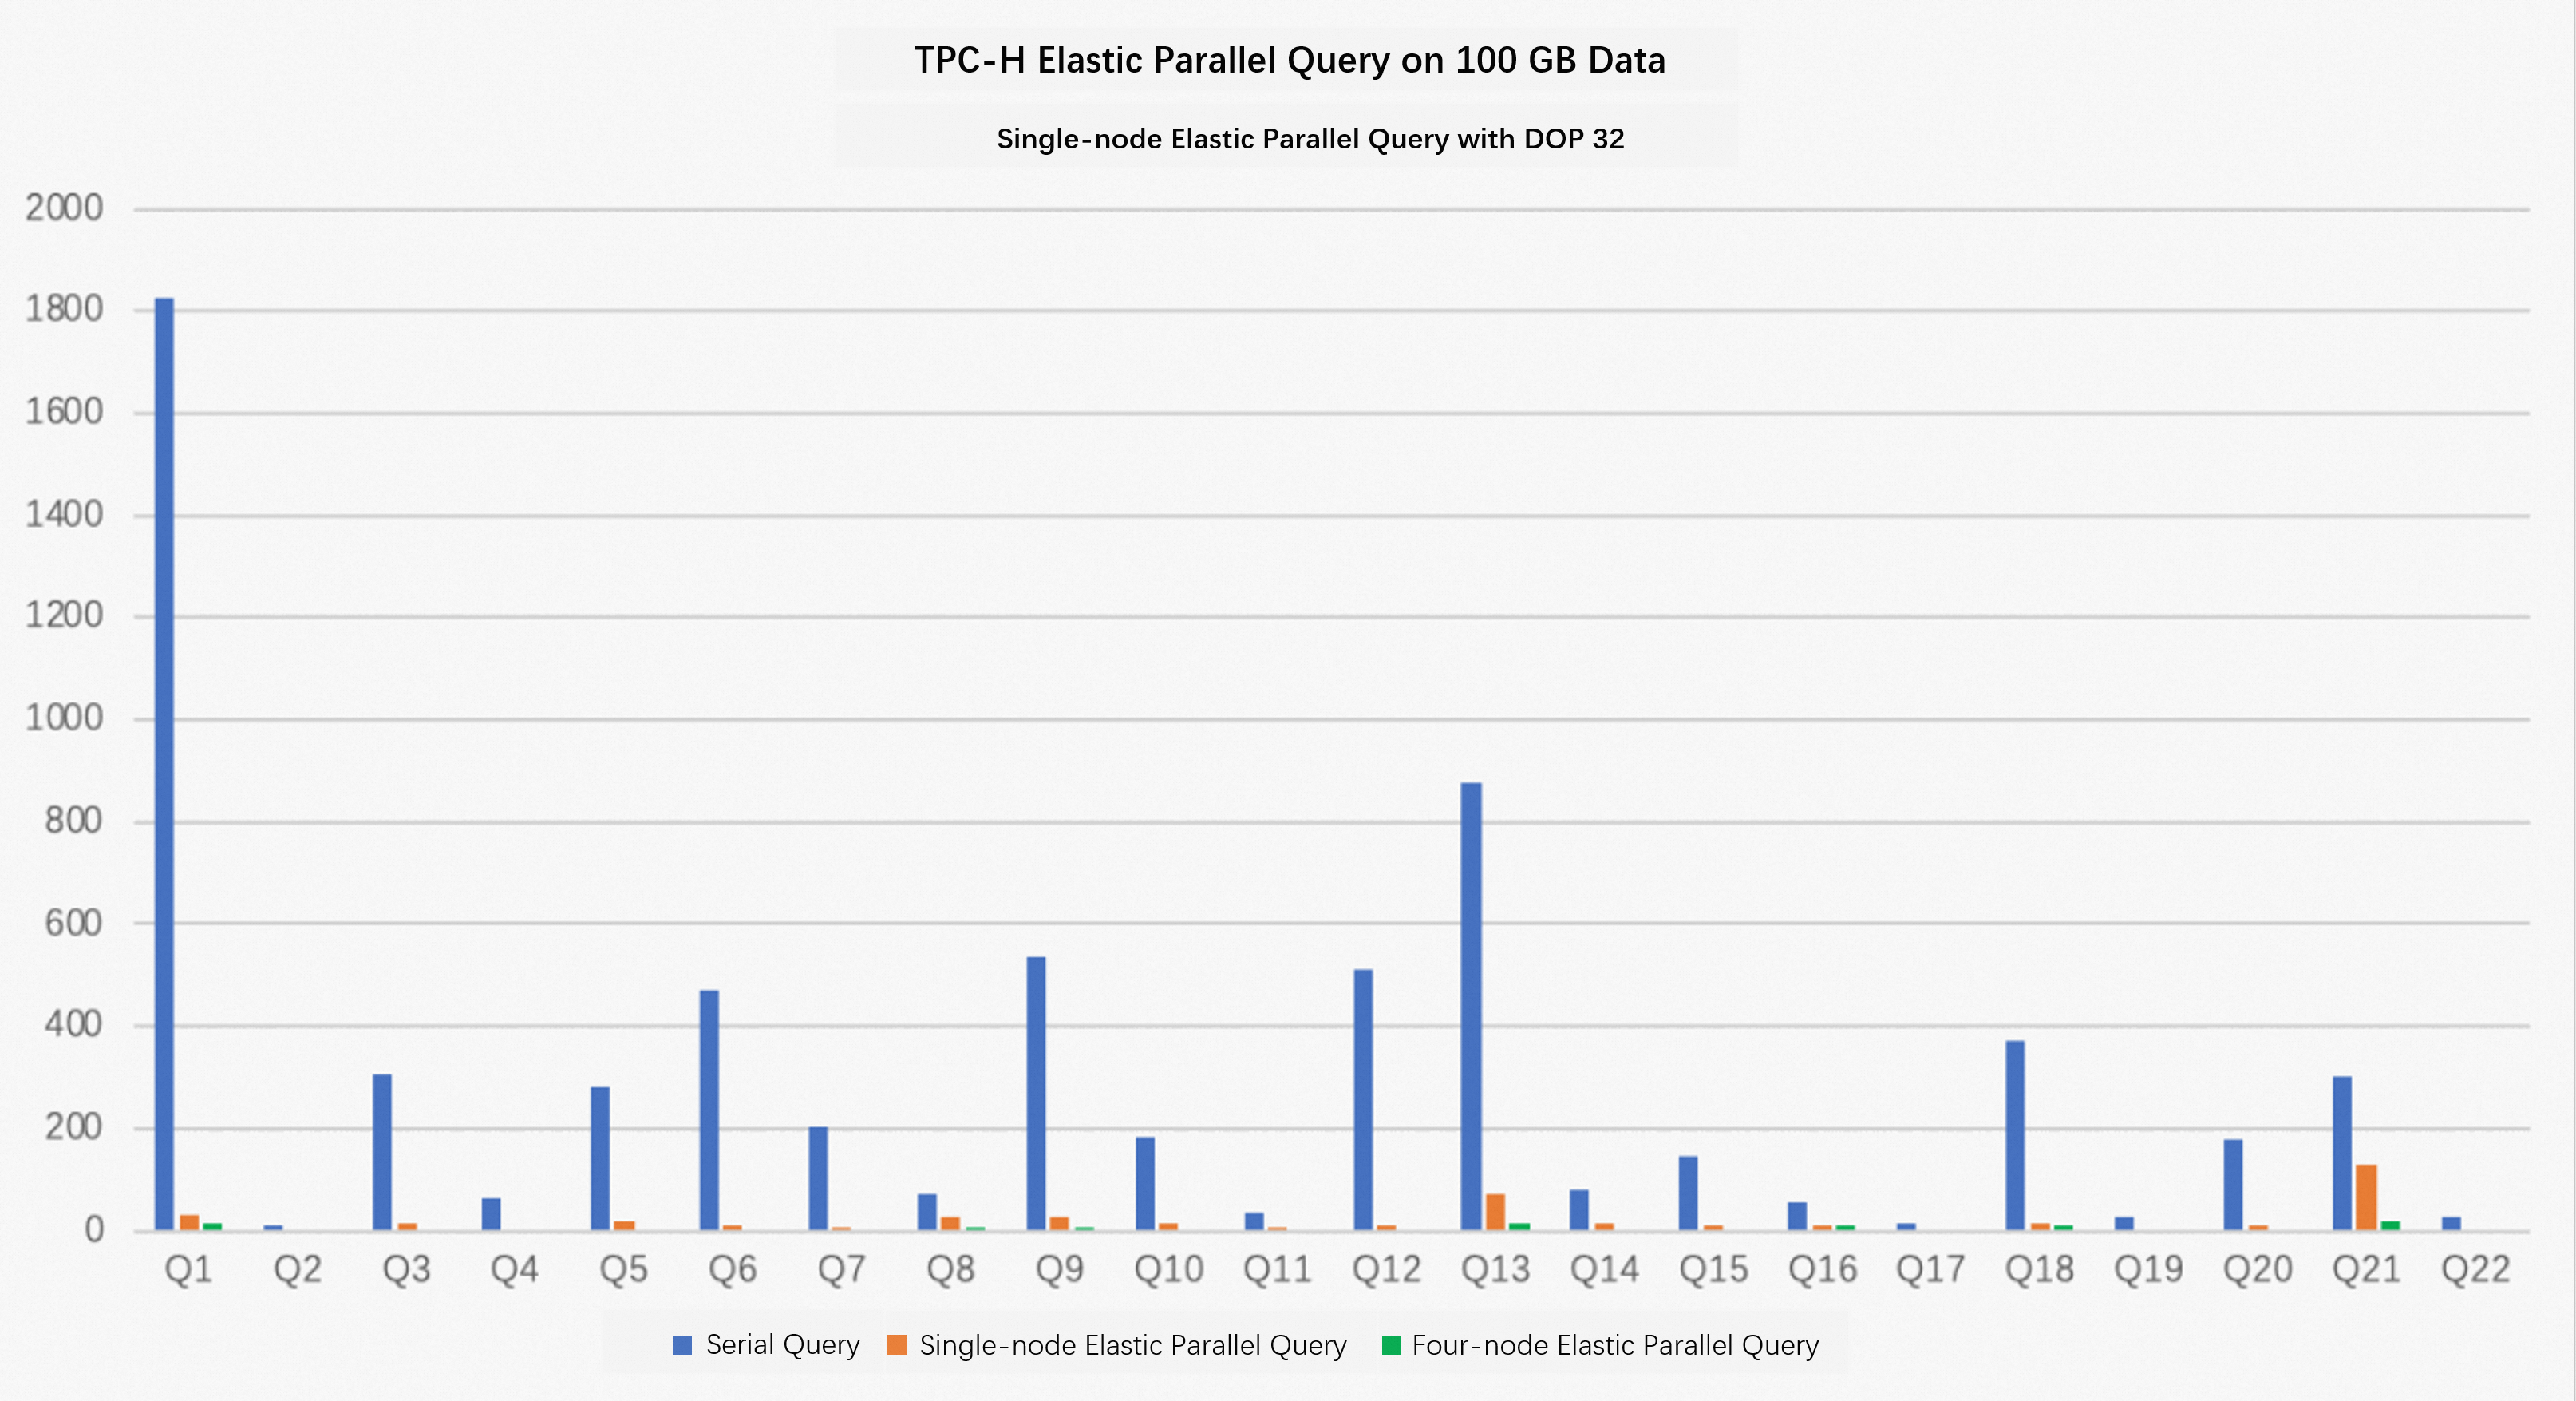
Yukarıdaki test sonuçları, TPC-H'deki SQL sorgularının %100'ünün hızlandırıldığını göstermektedir. Sorgu hızı ortalama olarak 17 kat, maksimumda ise 56 kat daha hızlıdır.
When multi-node elastic parallel query is enabled, the query speed is 59 times faster on average and 159 times faster at maximum.
Bu konudaki TPC-H uygulaması TPC-H kıyaslamasına dayanmaktadır. Testler tüm TPC-H gereksinimlerini tam olarak karşılamadığından, bu test sonuçları yayınlanan TPC-H kıyaslama sonuçlarıyla karşılaştırılamaz.
Esnek paralel sorgu yürütme planlarını görüntüleme
Yürütme planlarında esnek paralel sorgu bilgilerini görüntülemek üzere EXPLAIN deyimini nasıl çalıştıracağınız hakkında bilgi için bkz. Paralel sorgu planlarını görüntülemek için EXPLAIN kullanma.
Terimler
-
Paralel tarama
Paralel taramada, çalışanlar bir tablonun verilerini paralel olarak tarar. Her çalışan kısmi bir sonuç üretir ve bu sonucu lider iş parçacığına döndürür. Lider iş parçacığı, gather düğümünü kullanarak sonuçları toplar ve nihai sonucu istemci tarafına döndürür.
-
Birden çok tabloda paralel birleşim (join)
ePQ özelliği etkinleştirildiğinde, çoklu tablo birleşim işlemi paralel işlemek üzere çalışanlara aktarılır. PolarDB optimizer, paralel tarama için en uygun tabloyu seçer ancak diğer tablolar için paralel tarama gerçekleştirmez. Her çalışan kısmi bir sonuç üretir ve bu sonucu lider iş parçacığına döndürür. Lider iş parçacığı, gather düğümünü kullanarak sonuçları toplar ve nihai sonucu istemciye döndürür.
-
Paralel sıralama
PolarDB optimizer, ORDER BY işlemini paralel sıralama için tüm çalışanlara aktarır. Her çalışan kısmi bir sonuç üretir ve bu sonucu lider iş parçacığına döndürür. Lider iş parçacığı, gather merge düğümünü kullanarak tüm kısmi sonuçları toplar, birleştirir ve sıralar, ardından nihai sıralama sonucunu istemci tarafına döndürür.
-
Paralel gruplama
PolarDB optimizer, GROUP BY işlemini paralel işlemek üzere çalışanlara aktarır. Her çalışan, verilerin bir bölümü üzerinde GROUP BY işlemini gerçekleştirir. Her çalışan, GROUP BY'nin kısmi bir sonucunu üretir ve bu sonucu lider iş parçacığına döndürür. Lider iş parçacığı, gather düğümünü kullanarak tüm çalışanlardan gelen sonuçları toplar. PolarDB optimizer, sorgu planına bağlı olarak lider iş parçacığında tekrar GROUP BY işlemi yapıp yapmayacağını belirler. Örneğin, bir GROUP BY deyimi gevşek dizin taraması kullanılarak yürütülüyorsa, lider iş parçacığı GROUP BY işlemi gerçekleştirmez. Gevşek dizin taraması kullanılmıyorsa, lider iş parçacığı GROUP BY işlemi gerçekleştirir ve nihai sonucu istemci tarafına döndürür.
-
Paralel toplama (aggregation)
ePQ özelliği etkinleştirildiğinde, toplama işlevi paralel toplama için tüm çalışanlara gönderilir. Optimizer, maliyete bağlı olarak seri yürütme, tek aşamalı toplama veya iki aşamalı toplama yapılıp yapılmayacağını belirler.
Tek aşamalı toplama: Optimizer, toplama işlemini çalışanlara dağıtır. Her çalışan, gruplardaki tüm verileri içerir. Bu nedenle ikinci aşama toplama hesaplamasına gerek yoktur. Her çalışan, lider iş parçacığının ikinci bir toplama işlemi gerçekleştirmesini önlemek amacıyla grupların nihai toplama sonuçlarını doğrudan hesaplar.
İki aşamalı toplama: İlk aşamada, esnek paralel sorguya dahil olan her çalışan toplamayı gerçekleştirir. İkinci aşamada, gather düğümü veya gather merge düğümü her çalışan tarafından üretilen sonuçları lider iş parçacığına döndürür. Ardından lider iş parçacığı, tüm çalışanlardan gelen sonuçları toplayarak nihai sonucu oluşturur.
İki aşamalı karıştırma (shuffle) toplaması: İlk aşamada, esnek paralel sorgudaki her çalışan toplamayı gerçekleştirir. İkinci aşamada, repartition düğümü her çalışan tarafından üretilen sonucu gruplanmış sütunlara göre birden çok çalışana dağıtır. Çalışanlar, nihai toplama hesaplamalarını paralel olarak tamamlar. Son olarak, toplama sonuçları lider iş parçacığında özetlenir.
PolarDB optimizer, belirli toplama yöntemini maliyete göre belirler.
-
Paralel pencere işlevi
PolarDB optimizer, maliyetlere göre hesaplama yapar ve pencere işlevlerini paralel yürütme için çalışanlara dağıtır. Her çalışan, verilerin bir bölümünü hesaplar. Dağıtım yöntemi, pencere işlevlerindeki PARTITION BY yan tümcesinin anahtarı tarafından belirlenir. Pencere işlevleri PARTITION BY yan tümcesi içermiyorsa, seri hesaplama gerçekleştirilir. Paralel hesaplama daha sonraki bir zamanda gerçekleştirilebiliyorsa, maksimum paralelleştirmeyi sağlamak amacıyla maliyete göre sonraki hesaplama görevleri yürütülmek üzere birden çok çalışana dağıtılır.
-
Alt sorgular için destek
Esnek paralel sorguda alt sorguları çalıştırmak için aşağıdaki ilkelerden birini kullanabilirsiniz:
-
Lider iş parçacığında seri yürütme
Alt sorgular paralel işlemeyi desteklemiyorsa, lider iş parçacığındaki alt sorgular sırayla gerçekleştirilir. Örneğin, iki tablo kullanıcı tanımlı işlevler (UDF) referans alan bir JOIN yan tümcesi kullanılarak birleştiriliyorsa, alt sorgular sırayla gerçekleştirilir.
-
Lider iş parçacığında paralel yürütme (başka bir çalışan grubu kullanılır)
Esnek paralel sorgu planı oluşturulduktan sonra, lider iş parçacığının yürütme planı paralel işlemeyi destekleyen alt sorgular içeriyorsa, bu paralel alt sorgular önceden çalıştırılamaz veya paylaşılan erişim ilkesine göre paralel çalıştırılamaz. Örneğin, alt sorgular pencere işlevleri içeriyorsa, alt sorgular paylaşılan erişim ilkesine göre paralel çalıştırılamaz.
-
Paylaşılan erişim
Esnek paralel sorgu planı oluşturulduktan sonra, çalışanların yürütme planları paralel işlemeyi destekleyen alt sorgulara referans veriyorsa, PolarDB optimizer paralel alt sorguları önceden çalıştırır. Bu sayede çalışanlar, alt sorguların sonuçlarına doğrudan erişebilir.
-
Aşağı itme (Push down)
Esnek paralel sorgu planı oluşturulduktan sonra, çalışanların yürütme planları ilişkili alt sorgulara referans veriyorsa, çalışanlar ilişkili alt sorguları çalıştırır.
-