Adalet analizi, yapay zeka modellerindeki yanlılığı tespit eder ve cinsiyet veya ırk gibi niteliklere dayalı haksız sonuçların önlenmesine yardımcı olur. PAI DSW içinde responsible-ai-toolbox entegrasyonunu kullanarak model performansının hassas özellikler arasında nasıl değiştiğini değerlendirebilirsiniz.
Nasıl çalışır?
Adalet analizi, yapay zeka sistemlerindeki yanlılığı tespit edip düzeltir ve kararların ilgisiz faktörlerden etkilenmemesini sağlar. Temel ilkeler şunlardır:
Yanlılıktan kaçının: Veri setlerinde ve algoritmalardaki yanlılığı belirleyip azaltarak yapay zeka sistemlerinin cinsiyet, ırk veya yaş gibi kişisel niteliklere dayalı haksız kararlar vermesini önleyin.
Temsil edici veri: Tüm kullanıcı gruplarını doğru şekilde yansıtan ve azınlıkların marjinalleşmesini önleyen temsil edici veri setleri üzerinde yapay zeka modelleri eğitin.
Şeffaflık ve açıklanabilirlik: Kullanıcıların ve karar vericilerin bir modelin belirli tahminleri neden yaptığını anlamasına yardımcı olan açıklanabilir yapay zeka teknikleriyle yapay zeka sistemi şeffaflığını artırın.
Sürekli izleme ve değerlendirme: Zamanla ortaya çıkan yanlılığı tespit etmek ve düzeltmek için yapay zeka sistemlerini düzenli olarak izleyin ve değerlendirin.
Çeşitlilik ve kapsayıcılık: Sorunların farklı geçmişlerden ve bakış açılarından ele alındığından emin olmak için yapay zeka sistemi tasarımı ve geliştirmesine çeşitli perspektifleri dahil edin.
Uyumluluk ve etik: Yapay zeka uygulamalarının zarar veya adaletsizliğe yol açmamasını sağlamak için yönetmeliklere ve etik standartlara uyun.
Aşağıdaki örnek, bir gelir tahmin modelinin cinsiyet ve ırk bazında adaletini değerlendirir. Model, yıllık gelirin 50.000 USD'yi aşıp aşmadığını tahmin eder. Bu örnek, PAI DSW'de adalet analizi için responsible-ai-toolbox'ın nasıl kullanılacağını gösterir.
Ön koşullar
-
Bir DSW örneği. Henüz sahip değilseniz bkz. DSW örneği oluşturma. Önerilen yapılandırma:
Örnek türü: ecs.gn6v-c8g1.2xlarge
Görüntü: Python 3.9 veya üzeri. Bu konuda aşağıdaki resmi görüntü kullanılır: tensorflow-pytorch-develop:2.14-pytorch2.1-gpu-py311-cu118-ubuntu22.04
Model çerçevesi: responsible-ai-toolbox, scikit-learn, PyTorch ve TensorFlow ile oluşturulan regresyon ve ikili sınıflandırma modellerini destekler.
Eğitim veri seti: Kendi veri setinizi kullanın. Bunun yerine örnek veri setini kullanmak için 3. Adım: Veri setini hazırlama bölümünü takip edin.
Eğitilmiş model: Kendi modelinizi kullanın. Bunun yerine örnek modeli kullanmak için 5. Adım: Modeli eğitme bölümünü takip edin.
1. Adım: DSW Galerisi'ni açın
PAI konsolu üzerinde oturum açın.
Sol üst köşeden bir bölge seçin.
Sol gezinme bölmesinde QuickStart > Notebook Gallery seçeneğini belirleyin. Responsible AI - Fairness Analysis ifadesini aratın ve ilgili kartta Open in DSW seçeneğine tıklayın.
Bir DSW örneği seçin ve Open Notebook seçeneğine tıklayın. Responsible AI - Fairness Analysis not defteri açılır.
2. Adım: Bağımlılıkları yükleyin
Adalet değerlendirmesi için responsible-ai-toolbox paketini (raiwidgets) yükleyin.
!pip install raiwidgets==0.34.13. Adım: Veri setini hazırlayın
Bu konudaki örnek için OpenML veri seti 1590 öğesini yüklemek üzere aşağıdaki betiği çalıştırın.
from raiutils.common.retries import retry_function
from sklearn.datasets import fetch_openml

class FetchOpenml(object):
    def __init__(self):
        pass
    # Fetch the OpenML dataset with data_id = 1590
    def fetch(self):
        return fetch_openml(data_id=1590, as_frame=True)

fetcher = FetchOpenml()
action_name = "Dataset download"
err_msg = "Failed to download openml dataset"
max_retries = 5
retry_delay = 60
data = retry_function(fetcher.fetch, action_name, err_msg,
                      max_retries=max_retries,
                      retry_delay=retry_delay)
Kendi veri setinizi de yükleyebilirsiniz. Aşağıdaki kod bir CSV dosyasını yükler:
import pandas as pd

# Load your own dataset in CSV format
# Use pandas to read the CSV file
data = pd.read_csv(filename)
4. Adım: Verileri ön işleyin
Özellik değişkenlerini ve hedef değişkeni alın
Hedef değişken, modelin tahmin ettiği gerçek sonuçtur. Özellik değişkenleri ise her bir veri örneğindeki diğer tüm değişkenlerdir. Bu örnekte:
class: Yıllık gelirin 50.000 USD'yi aşıp aşmadığı
sex: Cinsiyet
race: Irk
age: Yaş
Özellik değişkenlerini X_raw içine yüklemek ve ilk beş satırı önizlemek için aşağıdaki betiği çalıştırın:
# Get the feature variables, excluding the target variable.
X_raw = data.data
# Display the first 5 rows of feature variables, excluding the target variable.
X_raw.head(5)
Hedef değişkeni kodlamak ve dağılımını görüntülemek için aşağıdaki betiği çalıştırın. 1 değeri gelirin >50K olduğunu, 0 değeri ise gelirin <=50K olduğunu gösterir.
from sklearn.preprocessing import LabelEncoder

# Convert the target variable to a binary classification target
# data.target is the target variable "class"
y_true = (data.target == '>50K') * 1
y_true = LabelEncoder().fit_transform(y_true)

import matplotlib.pyplot as plt
import numpy as np

# View the distribution of the target variable
counts = np.bincount(y_true)
classes = ['<=50K', '>50K']
plt.bar(classes, counts)
Hassas özellikleri belirleyin
Cinsiyet ve ırkı hassas özellikler olarak tanımlamak ve verileri önizlemek için aşağıdaki betiği çalıştırın. responsible-ai-toolbox, model tahminlerinin bu hassas özelliklere göre yanlı olup olmadığını değerlendirir. Uygulamada hassas özellikleri iş gereksinimlerinize göre ayarlayın.
# Define "sex" and "race" as sensitive attributes
# First, select the columns related to sensitive attributes from the dataset to form a new DataFrame `sensitive_features`
sensitive_features = X_raw[['sex','race']]
sensitive_features.head(5)
Hassas özellikleri X_raw içinden kaldırmak ve sonucu önizlemek için aşağıdaki betiği çalıştırın:
# Remove the sensitive features from the feature variables
X = X_raw.drop(labels=['sex', 'race'],axis = 1)
X.head(5)
Özellikleri kodlayın ve ölçeklendirin
Verileri responsible-ai-toolbox için uygun bir biçime dönüştürmek amacıyla one-hot kodlama ve özellik ölçeklendirmesi uygulamak için aşağıdaki betiği çalıştırın.
import pandas as pd
from sklearn.preprocessing import StandardScaler

# One-hot encoding
X = pd.get_dummies(X)

# Perform feature scaling on the dataset X
sc = StandardScaler()
X_scaled = sc.fit_transform(X)
X_scaled = pd.DataFrame(X_scaled, columns=X.columns)

X_scaled.head(5)
Eğitim ve test verilerini ayırın
Verilerin %20'sini test veri setine, kalan %80'ini eğitim veri setine ayırmak için aşağıdaki betiği çalıştırın.
from sklearn.model_selection import train_test_split

# Split the feature variables X and target variable y into training and test sets according to the `test_size` ratio
X_train, X_test, y_train, y_test = \
    train_test_split(X_scaled, y_true, test_size=0.2, random_state=0, stratify=y_true)

# Use the same random seed to split the sensitive features into training and test sets, ensuring consistency with the above split
sensitive_features_train, sensitive_features_test = \
    train_test_split(sensitive_features, test_size=0.2, random_state=0, stratify=y_true)
Her bir veri setinin boyutunu kontrol edin:
print("Training set size:", len(X_train))
print("Test set size:", len(X_test))
Her iki veri setinin dizinlerini sıfırlayın:
# Reset the DataFrame index to avoid index errors
X_train = X_train.reset_index(drop=True)
sensitive_features_train = sensitive_features_train.reset_index(drop=True)
X_test = X_test.reset_index(drop=True)
sensitive_features_test = sensitive_features_test.reset_index(drop=True)
5. Adım: Modeli eğitin
Aşağıdaki örnek, eğitim verileri üzerinde lojistik regresyon modeli eğitmek için scikit-learn kullanır.
scikit-learn
from sklearn.linear_model import LogisticRegression

# Create a logistic regression model
sk_model = LogisticRegression(solver='liblinear', fit_intercept=True)
# Train the model
sk_model.fit(X_train, y_train)
PyTorch
import torch
import torch.nn as nn
import torch.optim as optim

# Define logistic regression model
class LogisticRegression(nn.Module):
    def __init__(self, input_size):
        super(LogisticRegression, self).__init__()
        self.linear = nn.Linear(input_size, 1)

    def forward(self, x):
        outputs = torch.sigmoid(self.linear(x))
        return outputs

# Instantiate the model
input_size = X_train.shape[1]
pt_model = LogisticRegression(input_size)

# Loss function and optimizer
criterion = nn.BCELoss()
optimizer = optim.SGD(pt_model.parameters(), lr=5e-5)

# Train the model
num_epochs = 1
X_train_pt = X_train
y_train_pt = y_train
for epoch in range(num_epochs):
    # Forward pass
    # Convert DataFrame to Tensor
    if isinstance(X_train_pt, pd.DataFrame):
        X_train_pt = torch.tensor(X_train_pt.values)
        X_train_pt = X_train_pt.float()
    outputs = pt_model(X_train_pt)
    outputs = outputs.squeeze()
    # Convert ndarray to Tensor
    if isinstance(y_train_pt, np.ndarray):
        y_train_pt = torch.from_numpy(y_train_pt)
        y_train_pt = y_train_pt.float()
    loss = criterion(outputs, y_train_pt)

    # Backward pass and optimization
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
TensorFlow
import tensorflow as tf
from tensorflow.keras import layers

# Define the logistic regression model
tf_model = tf.keras.Sequential([
    layers.Dense(units=1, input_shape=(X_train.shape[-1],), activation='sigmoid')
])

# Compile the model using binary cross-entropy loss and stochastic gradient descent optimizer
tf_model.compile(optimizer='sgd', loss='binary_crossentropy', metrics=['accuracy'])

# Train the model
tf_model.fit(X_train, y_train, epochs=1, batch_size=32, verbose=0)
6. Adım: Modeli değerlendirin
Test veri seti üzerinde tahminler oluşturmak ve bir adalet değerlendirme raporu üretmek için responsible-ai-toolbox içindeki Fairness Dashboard'u kullanın.
Fairness Dashboard, tahminleri ve gerçek sonuçları hassas özellik değerlerine göre gruplar. Model performansının nasıl değiştiğini ortaya çıkarmak için gruplar arasındaki tahmin edilen ve gerçek sonuçları karşılaştırır.
Örneğin, "sex" hassas özelliği için Fairness Dashboard, tahminleri (y_pred) ve gerçek sonuçları (y_test) cinsiyete göre sınıflandırır; ardından "Male" ve "Female" için seçim oranı, doğruluk ve diğer ölçümleri hesaplayıp karşılaştırır.
Aşağıdaki örnek scikit-learn modelini değerlendirir:
scikit-learn
from raiwidgets import FairnessDashboard
import os
from urllib.parse import urlparse
# Generate prediction results on the test dataset
y_pred_sk = sk_model.predict(X_test)

# Use responsible-ai-toolbox to compute data information for each sensitive group
metric_frame_sk = FairnessDashboard(sensitive_features=sensitive_features_test,
                  y_true=y_test,
                  y_pred=y_pred_sk, locale = 'zh-Hans')

# Set the URL redirect link
metric_frame_sk.config['baseUrl'] =  'https://{}-proxy-{}.dsw-gateway-{}.data.aliyuncs.com'.format(
    os.environ.get('JUPYTER_NAME').replace("dsw-",""),
    urlparse(metric_frame_sk.config['baseUrl']).port,
    os.environ.get('dsw_region') )
print(metric_frame_sk.config['baseUrl'])
PyTorch
from raiwidgets import FairnessDashboard
import torch
import os
from urllib.parse import urlparse
# Test the model and evaluate fairness
pt_model.eval()  # Set model to evaluation mode
X_test_pt = X_test
with torch.no_grad():
    X_test_pt = torch.tensor(X_test_pt.values)
    X_test_pt = X_test_pt.float()
    y_pred_pt = pt_model(X_test_pt).numpy()

# Use responsible-ai-toolbox to compute metrics for each sensitive group
metric_frame_pt = FairnessDashboard(sensitive_features=sensitive_features_test,
                           y_true=y_test,
                           y_pred=y_pred_pt.flatten().round(),locale='zh-Hans')

# Set the URL redirect link
metric_frame_pt.config['baseUrl'] =  'https://{}-proxy-{}.dsw-gateway-{}.data.aliyuncs.com'.format(
    os.environ.get('JUPYTER_NAME').replace("dsw-",""),
    urlparse(metric_frame_pt.config['baseUrl']).port,
    os.environ.get('dsw_region') )
print(metric_frame_pt.config['baseUrl'])
TensorFlow
from raiwidgets import FairnessDashboard
import os
from urllib.parse import urlparse
# Test the model and evaluate fairness
y_pred_tf = tf_model.predict(X_test).flatten()

# Use responsible-ai-toolbox to compute data information for each sensitive group
metric_frame_tf = FairnessDashboard(
                           sensitive_features=sensitive_features_test,
                           y_true=y_test,
                           y_pred=y_pred_tf.round(),locale='zh-Hans')

# Set the URL redirect link
metric_frame_tf.config['baseUrl'] =  'https://{}-proxy-{}.dsw-gateway-{}.data.aliyuncs.com'.format(
    os.environ.get('JUPYTER_NAME').replace("dsw-",""),
    urlparse(metric_frame_tf.config['baseUrl']).port,
    os.environ.get('dsw_region') )
print(metric_frame_tf.config['baseUrl'])
Temel parametreler:
sensitive_features: Hassas nitelikler.
y_true: Test veri setinden alınan gerçek sonuçlar.
y_pred: Model tahminleri.
locale (isteğe bağlı): Değerlendirme panosu için görüntüleme dili. Basitleştirilmiş Çince ("zh-Hans") ve Geleneksel Çince ("zh-Hant") dillerini destekler. Varsayılan dil İngilizcedir ("en").
7. Adım: Değerlendirme raporunu görüntüleyin
Değerlendirme tamamlandıktan sonra tam değerlendirme raporunu görüntülemek için URL'ye tıklayın.
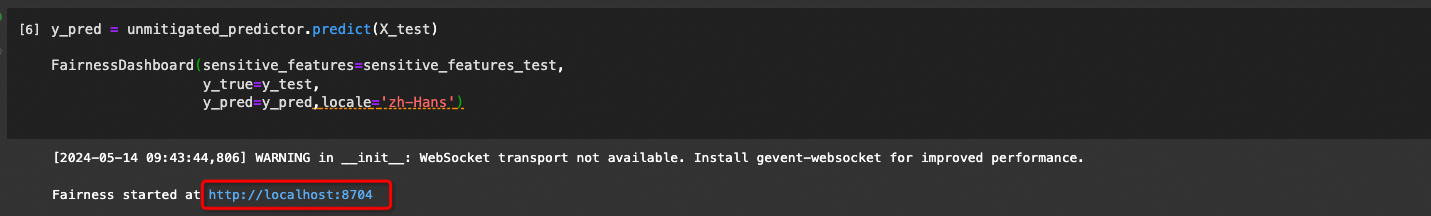
Değerlendirme sayfası "Calculating" durumunda takılı kalırsa çözüm için SSS bölümüne bakın.
Fairness dashboard sayfasında Get Started seçeneğine tıklayın. Aşağıda açıklandığı gibi hassas özelliği, performans ölçümünü ve adalet ölçümünü yapılandırarak modellere ait ölçümleri hassas özellik grupları arasında karşılaştırın.
Hassas özellik: cinsiyet
Hassas özellik: sex
Performans ölçümü: Accuracy
Adalet ölçümü: Demographic parity difference
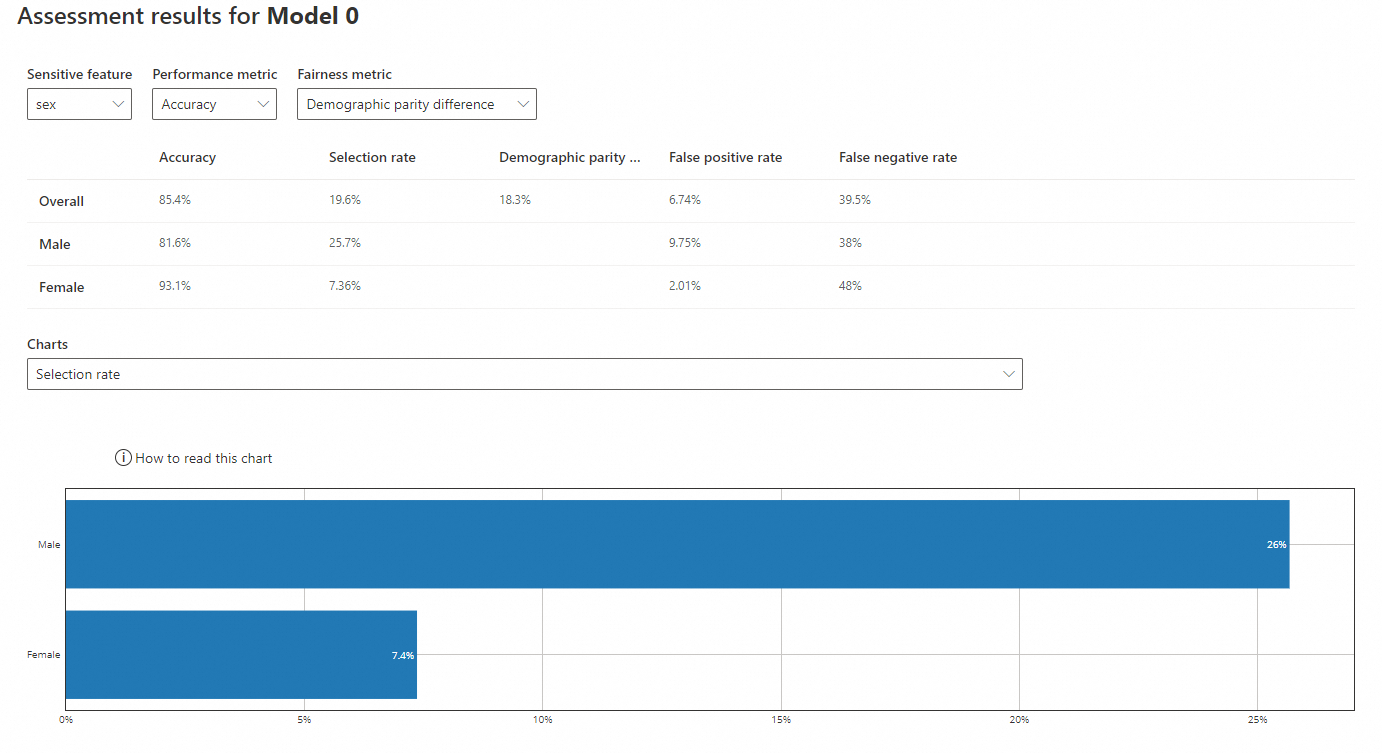
Accuracy: Toplam örnek sayısı içinde doğru tahmin edilen örneklerin oranı. Model, erkek gelirini %81,6 doğrulukla, kadın gelirini ise %93,1 doğrulukla tahmin eder. Her iki değer de genel doğruluk olan %85,4'e yakındır.
Selection rate: Modelin olumlu sonucu (gelir >50K) tahmin etme olasılığı. Model, erkekler için %25,7, kadınlar için ise %7,36 seçim oranı tahmin eder. Kadınlar için seçim oranı, genel oran olan %19,6'nın oldukça altındadır.
Demographic parity difference: Korunan gruplar arasında olumlu tahmin alma olasılığındaki fark. 0'a daha yakın bir değer, gruplar arasında daha az yanlılık olduğunu gösterir. Genel demographic parity difference değeri %18,3'tür.
Hassas özellik: ırk
Hassas özellik: race
Performans ölçümü: Accuracy
Adalet ölçümü: Demographic parity difference
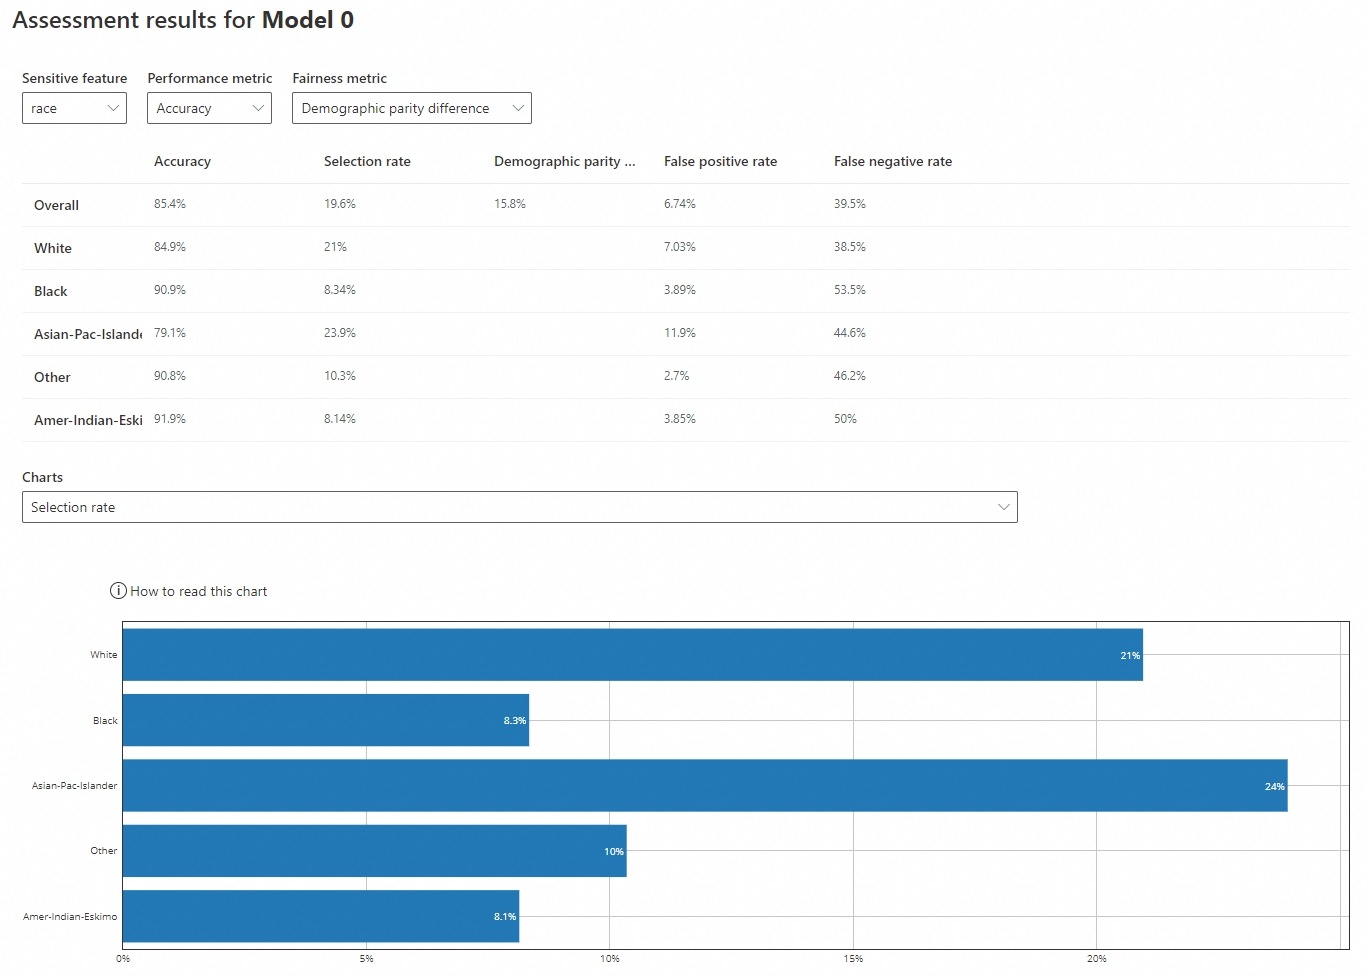
Accuracy: Toplam örnek sayısı içinde doğru tahmin edilen örneklerin oranı. Model, "White" ve "Asian-Pac-Islander" için sırasıyla %84,9 ve %79,1 doğrulukla gelir tahmini yaparken "Black", "Other" ve "Amer-Indian-Eskimo" için bu oranlar %90,9, %90,8 ve %91,9'dur. Tüm grupların doğruluk değerleri genel doğruluk olan %85,4'e yakındır.
Selection rate: Modelin olumlu sonucu (gelir >50K) tahmin etme olasılığı. "White" (%21) ve "Asian-Pac-Islander" (%23,9) için seçim oranları, "Black" (%8,34), "Other" (%10,3) ve "Amer-Indian-Eskimo" (%8,14) için olanlardan daha yüksektir. Bu düşük oranlar, genel seçim oranı olan %19,6'nın oldukça altındadır.
Demographic parity difference: Korunan gruplar arasında olumlu tahmin alma olasılığındaki fark. 0'a daha yakın bir değer, gruplar arasında daha az yanlılık olduğunu gösterir. Genel demographic parity difference değeri %15,8'dir.
SSS
S: Fairness Dashboard "Calculating" durumunda takılı kalırsa ne yapmalıyım?
DSW ortamında, çapraz kaynak istekleri kimlik doğrulama kimlik bilgilerini taşımadığı için Fairness Dashboard "Calculating" durumunda takılı kalabilir. Bunu düzeltmek için karşılama sayfasında tarayıcı konsolunu açın (F12 tuşuna basıp Console sekmesine geçin) ve aşağıdaki kodu çalıştırın:
const _fetch = window.fetch;
window.fetch = function(url, opts = {}) {
  if (String(url).includes('/metrics') || String(url).includes(location.host)) {
    opts.credentials = 'include';
  }
  return _fetch.call(this, url, opts);
};