Giriş
Alibaba Cloud, 6 Mart'ta Qwen ailesinden bir çıkarım modeli olan QwQ-32B'yi açık kaynak olarak yayınladı. Büyük ölçekli pekiştirmeli öğrenmeye dayanan bu model, matematik, kodlama ve genel yeteneklerde çığır açan gelişmeler sunar. Genel performansı DeepSeek-R1 ile karşılaştırılabilir düzeydeyken dağıtım maliyetlerini önemli ölçüde azaltır.
Matematik alanındaki AIME24 kıyaslamasında ve kodlama alanındaki LiveCodeBench'te QwQ-32B, DeepSeek-R1 ile eşdeğer performans gösterir ve benzer boyuttaki o1-mini ile R1-distilled modellerini önemli ölçüde geride bırakır.
Meta Baş Bilim İnsanı Yann LeCun'un liderliğindeki "en zor LLM değerlendirme liderlik tablosu" LiveBench'te, Google ve diğerleri tarafından önerilen talimat izleme testi IFEval'de ve UC Berkeley ile diğerleri tarafından önerilen işlev çağrısı doğruluğu testi BFCL'de QwQ-32B, DeepSeek-R1'den daha yüksek puan alır.
QwQ-32B, ajan yeteneklerini entegre ederek araçları kullanırken eleştirel düşünmesini sağlar ve ortamdan gelen geri bildirimlere dayanarak akıl yürütme sürecini ayarlar.
PAI-Model Gallery artık QwQ-32B için tek tıkla dağıtım, ince ayar ve değerlendirme işlemlerini tam olarak destekler. Modelin dağıtımı için 96 GB GPU belleğine sahip bir GPU gerekir. QwQ-32B-GGUF ve QwQ-32B-AWQ gibi kuantize sürümler de desteklenir ve tek bir A10 kartı gibi daha düşük maliyetli GPU'larda dağıtılabilir.
Model dağıtımı
-
PAI-Model Gallery sayfasına gidin.
PAI konsolu üzerinde oturum açın ve sol üst köşeden bir bölge seçin. Kullanılabilir hesaplama kaynaklarını bulmak için bölgeler arasında geçiş yapabilirsiniz.
Sol gezinme bölmesinde Workspaces seçeneğini belirleyin ve ardından bir çalışma alanının adına tıklayarak bu alana girin.
Sol gezinme bölmesinde QuickStart > Model Gallery seçeneklerini belirleyin.
PAI-Model Gallery sayfasında QwQ-32B model kartını bulun ve model ayrıntıları sayfasını açmak için üzerine tıklayın.
-
Sağ üst köşedeki Deploy seçeneğine tıklayın. Bir dağıtım çerçevesi seçin, çıkarım hizmeti için bir ad yapılandırın ve dağıtım için kaynakları belirtin. Bu işlem, modeli Elastic Algorithm Service (EAS) üzerine dağıtır. Platform; SGLang, vLLM ve PAI tarafından geliştirilen yüksek performanslı bir çıkarım çerçevesi olan BladeLLM dahil olmak üzere çeşitli dağıtım çerçevelerini destekler.
Dağıtım yöntemi olarak Single-Node - Standard Instance veya Single-Node - GP7V Instance seçeneklerinden birini belirleyebilirsiniz. Hizmet oluşturma aşamasında New Service veya Update Existing Service seçeneklerini kullanarak hizmeti oluşturabilir, grubunu ve etiketlerini yapılandırabilirsiniz. Desteklenen kaynak türleri arasında Public Resources, EAS Resource Group ve Resource Quota bulunur.
-
Çıkarım hizmetini kullanın. Dağıtım başarılı olduktan sonra hizmet sayfasına gidin ve uç nokta ile belirteci almak için View Call Information seçeneğine tıklayın. Hizmetin nasıl çağrılacağını öğrenmek için önceden eğitilmiş model bağlantısına tıklayarak model ayrıntıları sayfasına dönün ve talimatları görüntüleyin.
Hizmet oluşturma sırasında, dağıtım ilerlemesini izlemek için Status alanının yanındaki View Deployment Events seçeneğine tıklayabilirsiniz. Durum mesajı
Waiting task server to be readyşeklinde görüntülenir.Ayrıca, Elastic Algorithm Service (EAS) içinde dağıtılan QwQ-32B model hizmetini çevrimiçi olarak hata ayıklayabilirsiniz.
Online Debugging sayfasında Chat sekmesini seçin. HTTP yöntemi POST olup istek yolu
/api/predict/quickstart_qwq32b/v1/chat/completionsşeklindedir. Body bölümündeki JSON örneğindemodeldeğeriQwQ-32Bolarak,messagesiçeriğirole: uservecontent: Please introduce yourselfolarak,max_tokensdeğeri ise1024olarak ayarlanmıştır. Send Request seçeneğine tıkladığınızda 200 durum kodu döndürülür, yanıt gövdesichat.completiontüründe bir çıkarım sonucu içerir ve asistan rolüne ait içerik<think>etiketleri içine alınmış bir düşünme süreci barındırır.
Model ince ayarı
PAI-Model Gallery, QwQ-32B için denetimli ince ayar (SFT) algoritması sunar. Hem LoRA ince ayarını hem de tam parametreli ince ayarı desteklediğinden modeli kutudan çıkar çıkmaz ince ayara tabi tutabilirsiniz.
-
Eğitim verilerini hazırlayın. SFT algoritması, JSONL gibi formatlardaki eğitim veri kümelerini destekler. Format gereksinimleri hakkında daha fazla bilgi için model belgelerine bakın. Aşağıda JSONL formatında bir eğitim veri kümesi örneği verilmiştir:
{"messages": [{"role": "system", "content": "You are a helpful and harmless assistant."}, {"role": "user", "content": "Who are you?"}, {"role": "assistant", "content": "I am Xiaopai, an AI assistant trained by PAI. My goal is to provide users with useful, accurate, and timely information and to help them communicate effectively in various ways. How can I help you?"}]} {"messages": [{"role": "system", "content": "You are a helpful and harmless assistant."}, {"role": "user", "content": "Who are you!"}, {"role": "assistant", "content": "Hello! I am an AI language model developed by PAI, named Xiaopai. I can answer your questions, provide information, engage in conversation, and help you solve problems. If you have any questions or need assistance, please feel free to let me know!"}]} -
Eğitim parametrelerini yapılandırın. Verileri hazırladıktan sonra Object Storage Service (OSS) içindeki bir pakete yükleyin. 32B modeli büyük olduğundan algoritma en az 96 GB GPU belleğine sahip GPU kaynakları gerektirir. Kaynak kotanızın yeterli hesaplama kaynağı sağladığından emin olun.
Algoritma aşağıdaki hiperparametreleri destekler. Bu parametreleri veri kümenize ve hesaplama kaynaklarınıza göre ayarlayabilir veya varsayılan değerleri kullanabilirsiniz.
Parametre
Açıklama
Daha fazla bilgi
learning_rate
Model ağırlık ayarlamalarının büyüklüğünü kontrol eden öğrenme oranı.
Çok yüksek bir öğrenme oranı, kayıp değerinin şiddetli dalgalanmasına ve yakınsamamasına neden olarak eğitim kararsızlığına yol açabilir. Çok düşük bir oran ise kaybın yavaş azalmasına ve yakınsamanın uzun sürmesine neden olur. Uygun bir öğrenme oranı, modelin optimal bir çözüme hızlı ve kararlı bir şekilde yakınsamasını sağlar.
num_train_epochs
Eğitim veri kümesi üzerinden yapılan geçiş sayısı.
Çok az epoch yetersiz öğrenmeye, çok fazla epoch ise aşırı öğrenmeye neden olabilir. Örneklem boyutu küçükse yetersiz öğrenmeyi önlemek için epoch sayısını artırabilirsiniz. Daha düşük bir öğrenme oranı genellikle daha fazla epoch gerektirir.
per_device_train_batch_size
Tek bir eğitim iterasyonunda her bir GPU tarafından işlenen örnek sayısı.
Daha büyük bir toplu iş boyutu eğitim hızını artırabilir ancak GPU belleği talebini de yükseltir. İdeal toplu iş boyutu genellikle GPU belleği taşmasına neden olmayan maksimum değerdir. Eğitim ayrıntılarındaki görev izleme sayfasından GPU belleği kullanımını kontrol edebilirsiniz.
gradient_accumulation_steps
Gradyan biriktirme adım sayısı.
Küçük bir toplu iş boyutu, gradyan tahmininin varyansını artırarak yakınsama hızını etkiler. Gradyan biriktirme, modelin belirli sayıda toplu işten gelen gradyanları biriktirdikten sonra ağırlıkları güncellemesine olanak tanır.
gradient_accumulation_stepsdeğerinin GPU sayısının katı olduğundan emin olun.max_length
Modelin tek bir eğitim adımında işlediği giriş verilerinin maksimum token uzunluğu.
Bir tokenizer, eğitim verilerini işleyerek bir token dizisi üretir. Eğitim verilerinizdeki metin uzunluğunu tahmin etmek için bir token tahmin aracını kullanabilirsiniz.
lora_rank
LoRA boyutu.
lora_alpha
LoRA ağırlığı.
LoRA ölçeklendirme faktörü; genellikle
lora_rank * 2olarak ayarlanır.lora_dropout
LoRA eğitimi için bırakma oranı. Eğitim sırasında nöronları rastgele devre dışı bırakarak aşırı öğrenmeyi önlemeye yardımcı olur.
lorap_lr_ratio
LoRA+ öğrenme oranı oranı (λ = ηB/ηA); burada ηA ve ηB sırasıyla adaptör matrisleri A ve B için öğrenme oranlarıdır.
LoRA'ya kıyasla LoRA+, işlemdeki kritik bölümler için farklı öğrenme oranları kullanarak hesaplama gereksinimlerini artırmadan daha iyi performans ve daha hızlı ince ayar sağlayabilir.
lorap_lr_ratio0 olarak ayarlandığında eğitim, LoRA+ yerine standart LoRA kullanır.advanced_settings
Yukarıdaki parametrelere ek olarak, bu alanda
--key1 value1 --key2 value2formatını kullanarak diğer parametreleri özelleştirebilirsiniz. Gerekmiyorsa bu alanı boş bırakın.-
save_strategy: Model kontrol noktası kaydetme stratejisi. Seçeneklersteps,epochvenoşeklindedir. Varsayılan:steps. -
save_steps: Model kaydetme aralığı. Varsayılan: 500. -
save_total_limit: Kaydedilecek maksimum kontrol noktası sayısı. Sistem, bu sınır içinde kalmak için eski kontrol noktalarını siler. Varsayılan: 2.Noneise sistem tüm kontrol noktalarını kaydeder. -
warmup_ratio: Öğrenme oranı ısınma fazını kontrol eden bir hiperparametre. Bu başlangıç fazında öğrenme oranı küçük bir değerden başlangıçta ayarlanan değere kademeli olarak artar.warmup_ratio, bu fazın tüm eğitim sürecindeki oranını belirler. Varsayılan: 0.
-
Eğitimi başlatmak için Train düğmesine tıklayın. Eğitim işi durumunu ve günlüklerini görüntüleyebilirsiniz. Ayrıca ince ayar yapılmış modeli çevrimiçi bir hizmet olarak dağıtabilirsiniz.
Model değerlendirme
PAI-Model Gallery, önceden eğitilmiş ve ince ayar yapılmış modelleri kutudan çıkar çıkmaz değerlendirmenize olanak tanıyan yerleşik değerlendirme algoritmaları içerir. Değerlendirme, model performansını ölçmenize yardımcı olur ve kullanım durumunuz için en uygun modeli seçmenizi destekleyen yan yana karşılaştırmalar sunar.
Model değerlendirmesini iki farklı yerden başlatabilirsiniz:
|
|
|
|
|
|
Model değerlendirme, hem özel hem de ortak veri kümelerini destekler.
New Evaluation Task sayfasında, hakem modeli değerlendirmesi gibi gelişmiş özellikleri destekleyen profesyonel moda geçmek için sayfa başlığının yanındaki Switch to professional mode seçeneğine tıklayın. Formda Task Name, Model, Output Path, Dataset Source, Resource Type, Resource Group Type, Resource Configuration Method, Task Resources, VPC Configuration ve Internet gateway parametrelerini yapılandırın.
-
Özel veri kümesi değerlendirmesi
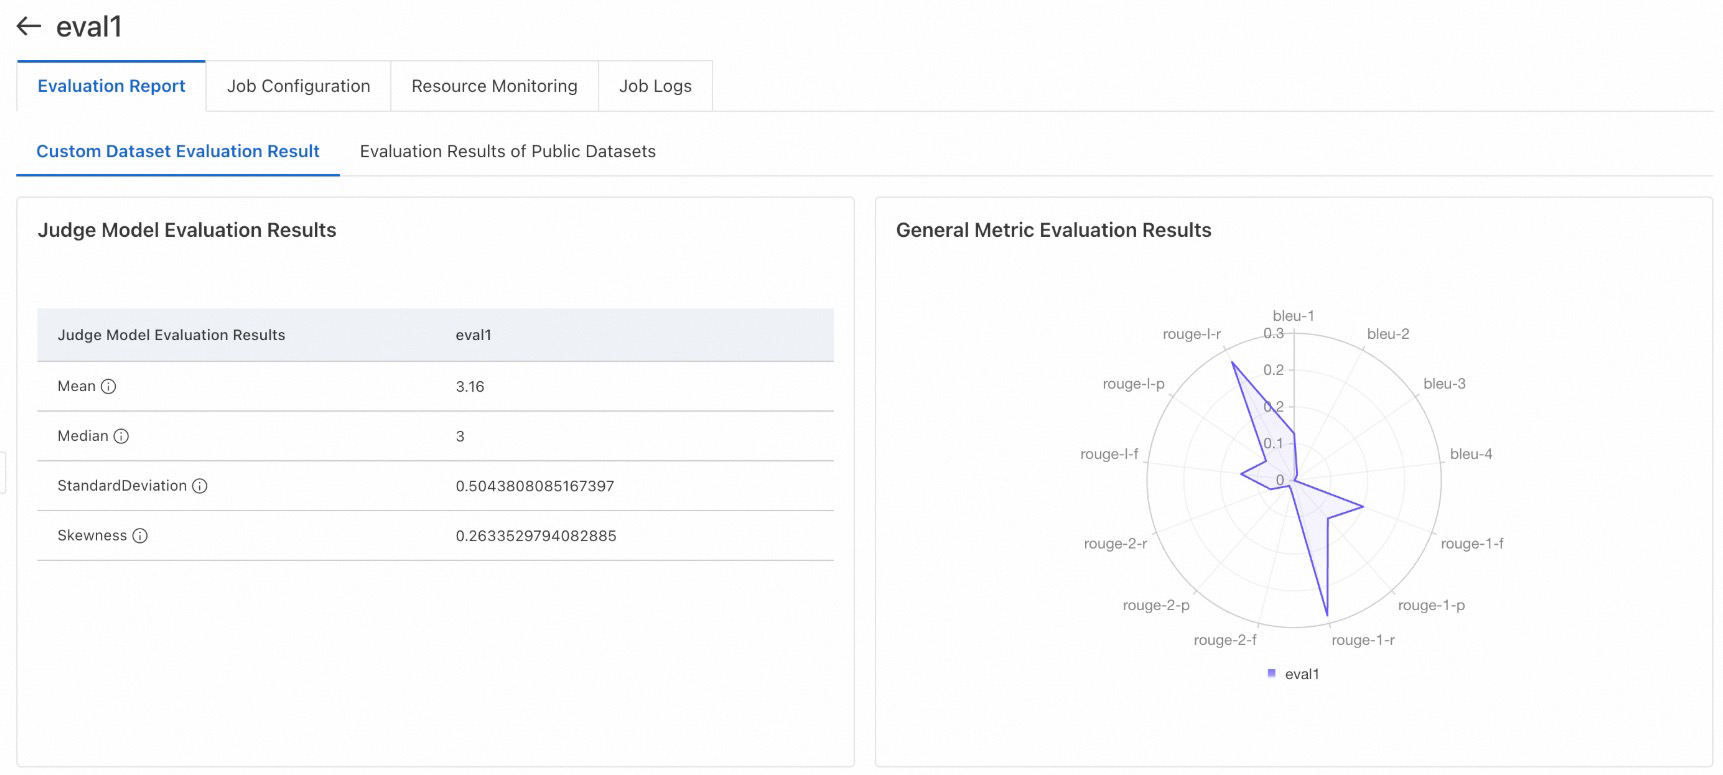
Model değerlendirme; BLEU ve ROUGE gibi yaygın NLP metin eşleştirme ölçümlerinin yanı sıra hakem modeli değerlendirmesini destekler. Yalnızca professional mode içinde kullanılabilen bu özellik, başka bir LLM'yi değerlendirmek için bir hakem LLM kullanarak puan ve gerekçelendirme sağlar. Seçtiğiniz modelin uygun olup olmadığını belirlemek için senaryonuzla özgün verileri kullanabilirsiniz.
Değerlendirme, her satırı bir JSON nesnesi olan JSONL formatında bir değerlendirme seti dosyası gerektirir. Soru sütununu tanımlamak için
questionve cevap sütunu içinanswerkullanın. Örnek dosya: evaluation_test.jsonl. -
Ortak veri kümesi değerlendirmesi
Alanlara göre gruplandırılmış açık kaynak değerlendirme veri kümelerini kullanarak büyük modellerin kapsamlı bir değerlendirmesini sağlar. PAI şu anda CMMLU, GSM8K, TriviaQA, MMLU, C-Eval, TruthfulQA ve HellaSwag gibi veri kümelerini sürdürmektedir; bu kümeler matematik, bilgi ve akıl yürütme dahil olmak üzere birden fazla alanı kapsar. Düzenli olarak daha fazla ortak veri kümesi eklenir. Not: GSM8K, TriviaQA ve HellaSwag veri kümelerindeki değerlendirmeler zaman alıcıdır. Bunları yalnızca gerektiğinde seçin.
Ardından, değerlendirme sonuçları için bir çıkış yolu seçin, önerilen hesaplama kaynaklarını belirleyin ve değerlendirme görevini gönderin. Görev tamamlandıktan sonra değerlendirme sonuçlarını görev sayfasında görüntüleyin. Birden fazla veri kümesi seçerseniz model değerlendirmeleri bunlar için sırayla çalıştırır; bu durum bekleme süresini artırabilir. Görevin ilerlemesini görmek için günlükleri kontrol edebilirsiniz.
Değerlendirme raporunu görüntüleyin: Aşağıdaki görseller, özel ve ortak veri kümeleri için örnek değerlendirme sonuçlarını göstermektedir.
Bize ulaşın
PAI-Model Gallery'i takip etmeye ve kullanmaya davet ediyoruz. Platformu sürekli olarak SOTA modellerle güncelliyoruz. Herhangi bir model talebiniz varsa bizimle iletişime geçmekten çekinmeyin. DingTalk group numarası 79680024618'i arayarak PAI-Model Gallery kullanıcı topluluğuna katılabilirsiniz.