Qwen3, Alibaba Cloud'taki Qwen ekibinin en son büyük dil modeli serisidir. Seri, iki MoE (Uzman Karışımı) modeli ve altı yoğun modeli içerir; akıl yürütme, talimat izleme, ajan yetenekleri ve çok dilli destek açısından iyileştirmeler sunar. PAI-Model Gallery, Base ve FP8 sürümleri dahil olmak üzere tüm 22 modeli sağlar. Bu konu, Model Gallery'de bu serideki modellerin nasıl dağıtılacağını, çağrılacağını, ince ayar yapılacağını ve değerlendirileceğini göstermek için Qwen3-235B-A22B modelini örnek olarak kullanır.
Modeli dağıtma ve çağırma
Modeli dağıtma
Bu örnekte Qwen3-235B-A22B modeli SGLang ile dağıtılmaktadır.
-
Model Gallery sayfasına gidin.
PAI console adresinde oturum açın ve sol üst köşeden bir bölge seçin. Kullanılabilir hesaplama kaynaklarını bulmak için bölgeler arasında geçiş yapın.
Sol gezinme bölmesinde Workspaces öğesini seçin ve hedef çalışma alanınızın adına tıklayarak alanı açın.
Sol gezinme bölmesinde QuickStart > Model Gallery yolunu izleyin.
Model Gallery sayfasının sağ tarafındaki model listesinde, model ayrıntıları sayfasını açmak için Qwen3-235B-A22B model kartına tıklayın.
-
Sağ üst köşede Deploy öğesine tıklayın. Aşağıdaki parametreleri yapılandırın ve diğerleri için varsayılan değerleri koruyarak modeli EAS çıkarım hizmeti platformuna dağıtın.
Deployment Method: Inference Engine değerini SGLang, Deployment Template değerini ise Single-Node olarak ayarlayın.
-
Resource Information: Resource Type için genel kaynakları seçin. Sistem uygun bir örnek türü önerir. Her model için minimum yapılandırma bilgileri için bkz. Ek: Hesaplama kaynakları ve token sınırları.
ÖnemliKullanılabilir örnek teknik özellikleri yoksa, o bölgedeki genel kaynaklar stokta yoktur. Aşağıdaki seçenekleri değerlendirin:
Bölgeleri değiştirin. Çin (Ulanqab) daha fazla Lingjun öncelikli kaynak (ml.gu7ef.8xlarge-gu100, ml.gu7xf.8xlarge-gu108, ml.gu8xf.8xlarge-gu108, ml.gu8tf.8.40xlarge) sağlar. Öncelikli kaynaklar geri alınabileceğinden teklifinizi dikkatli belirleyin.
Bir EAS kaynak grubu kullanın. EAS özel kaynaklarını satın almak için EAS dedicated resources subscription sayfasına gidin.
Çevrimiçi hata ayıklama
Service details sayfasının alt kısmında çevrimiçi hata ayıklamaya tıklayın. Aşağıdaki şekil bir örneği göstermektedir.

API'yi çağırma
-
Hizmet uç noktasını ve belirteci edinin.
Model Gallery > Job Management > Deployment Jobs bölümünde, dağıtılan hizmetin hizmet ayrıntıları sayfasını açmak için hizmet adına tıklayın.
-
İnternet Uç Noktasını ve belirteci elde etmek için View Call Information öğesine tıklayın.

-
SGLang ile dağıtılan bir hizmet için
/v1/chat/completionssohbet API'sine örnek çağrı.curl -X POST \ -H "Content-Type: application/json" \ -H "Authorization: <EAS_TOKEN>" \ -d '{ "model": "<model_name, obtained from the /v1/models API>", "messages": [ { "role": "system", "content": "You are a helpful assistant." }, { "role": "user", "content": "hello!" } ] }' \ <EAS_ENDPOINT>/v1/chat/completionsfrom openai import OpenAI ##### API configuration ##### # Replace <EAS_ENDPOINT> with the service endpoint and <EAS_TOKEN> with the service token. openai_api_key = "<EAS_TOKEN>" openai_api_base = "<EAS_ENDPOINT>/v1" client = OpenAI( api_key=openai_api_key, base_url=openai_api_base, ) models = client.models.list() model = models.data[0].id print(model) stream = True chat_completion = client.chat.completions.create( messages=[ {"role": "user", "content": "Hello, could you please introduce yourself"} ], model=model, max_completion_tokens=2048, stream=stream, ) if stream: for chunk in chat_completion: print(chunk.choices[0].delta.content, end="") else: result = chat_completion.choices[0].message.content print(result)<EAS_ENDPOINT> yerine hizmet uç noktasını ve <EAS_TOKEN> yerine hizmet belirtecini yazın.
Çağrı yöntemleri dağıtım yöntemine göre değişir. Daha fazla çağrı yöntemi için bkz. Dağıtılan LLM hizmeti için API çağırma.
Üçüncü taraf entegrasyonu
Chatbox, Dify veya Cherry Studio'ya bağlanmak için bkz. Üçüncü taraf istemcilerle entegrasyon.
Gelişmiş yapılandırma
Hizmetin JSON yapılandırmasını düzenleyerek token sınırını ayarlama ve araç çağrısını (Function Calling) etkinleştirme gibi gelişmiş özellikleri açın.
Yordam: Dağıtım sayfasında, Service Configuration bölümündeki JSON'u düzenleyin. Hizmet zaten dağıtılmışsa, dağıtım sayfasına erişmek için hizmeti güncelleyin.

Token sınırını değiştirme
Qwen3 modelleri yerel olarak 32.768 token destekler. RoPE ölçeklendirmesi bu sınırı 131.072'ye çıkarır, ancak performans biraz düşebilir. Hizmet yapılandırma JSON'undaki containers.script alanını değiştirin:
-
vLLM:
vllm serve ... --rope-scaling '{"rope_type":"yarn","factor":4.0,"original_max_position_embeddings":32768}' --max-model-len 131072 -
SGLang:
python -m sglang.launch_server ... --json-model-override-args '{"rope_scaling":{"rope_type":"yarn","factor":4.0,"original_max_position_embeddings":32768}}'
Araç çağrılarını ayrıştırma
vLLM ve SGLang, model tarafından oluşturulan araç çağrısı içeriğini yapılandırılmış mesajlara ayrıştırabilir. Hizmet yapılandırma JSON'undaki containers.script alanını değiştirin:
-
vLLM:
vllm serve ... --enable-auto-tool-choice --tool-call-parser hermes -
SGLang:
python -m sglang.launch_server ... --tool-call-parser qwen25
Düşünme modunu kontrol etme
Qwen3 varsayılan olarak düşünme modunu kullanır. Sert anahtar düşünmeyi tamamen devre dışı bırakır; yumuşak anahtar ise modelin düşünmesi gerekip gerekmediğine ilişkin talimatlarınızı izlemesini sağlar.
Yumuşak anahtar/no_think kullanma
Aşağıdaki örnek istek gövdesini gösterir:
{
  "model": "<MODEL_NAME>",
  "messages": [
    {
      "role": "user",
      "content": "/no_think Hello!"
    }
  ],
  "max_tokens": 1024
}
Sert anahtar
-
API parametrelerini kullanarak kontrol etme (vLLM ve SGLang): API çağrısına
chat_template_kwargsparametresini ekleyin. Örnek:curl -X POST \ -H "Content-Type: application/json" \ -H "Authorization: <EAS_TOKEN>" \ -d '{ "model": "<MODEL_NAME>", "messages": [ { "role": "user", "content": "Give me a short introduction to large language models." } ], "temperature": 0.7, "top_p": 0.8, "max_tokens": 8192, "presence_penalty": 1.5, "chat_template_kwargs": {"enable_thinking": false} }' \ <EAS_ENDPOINT>/v1/chat/completionsfrom openai import OpenAI # # Replace <EAS_ENDPOINT> with the service endpoint and <EAS_TOKEN> with the service token. openai_api_key = "<<EAS_TOKEN>" openai_api_base = "<EAS_ENDPOINT>/v1" client = OpenAI( api_key=openai_api_key, base_url=openai_api_base, ) chat_response = client.chat.completions.create( model="<MODEL_NAME>", messages=[ {"role": "user", "content": "Give me a short introduction to large language models."}, ], temperature=0.7, top_p=0.8, presence_penalty=1.5, extra_body={"chat_template_kwargs": {"enable_thinking": False}}, ) print("Chat response:", chat_response)<EAS_ENDPOINT> yerine hizmet uç noktasını, <EAS_TOKEN> yerine belirteci ve <MODEL_NAME> yerine
/v1/modelsAPI'sinden alınan model adını yazın. -
Hizmet yapılandırmasını değiştirerek devre dışı bırakma (BladeLLM): Modelin başlangıçta düşünme içeriği oluşturmasını engelleyen bir sohbet şablonu kullanın.
-
Model Gallery'deki model sayfasında, BladeLLM için düşünme modunu devre dışı bırakmaya yönelik bir yöntem sağlanıp sağlanmadığını kontrol edin. Örneğin, Qwen3-8B ile düşünme modunu devre dışı bırakmak için hizmet yapılandırma JSON'undaki
containers.scriptalanını değiştirin:blade_llm_server ... --chat_template /model_dir/no_thinking.jinja -
no_thinking.jinjagibi kendi sohbet şablonunuzu yazın, OSS'ten bağlayın ve hizmet yapılandırma JSON'undakicontainers.scriptalanını güncelleyin.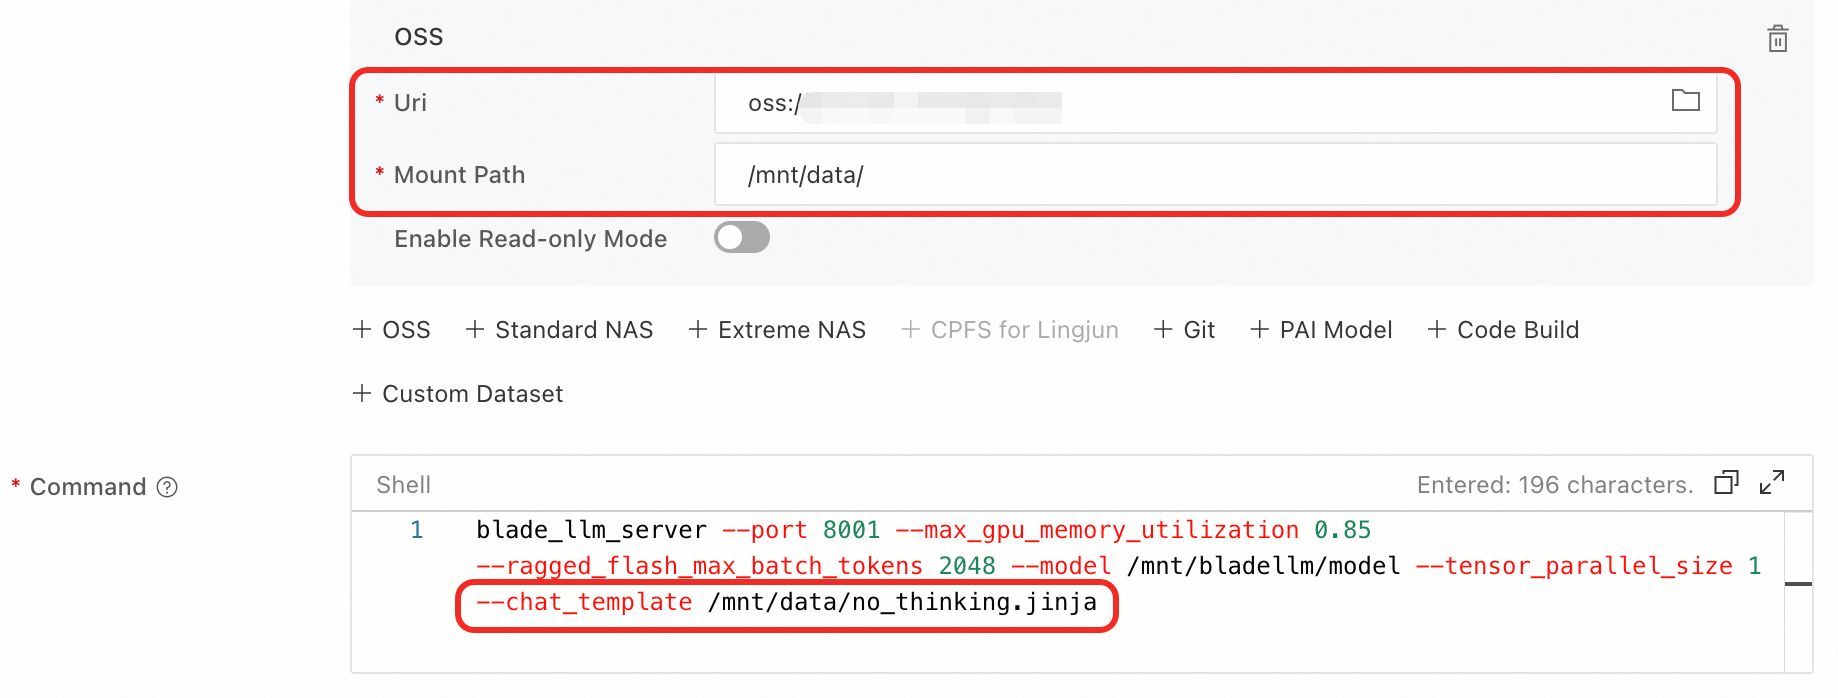
-
Düşünme içeriğini ayrıştırma
Think içeriğini ayrı olarak çıkarmak için hizmet yapılandırma JSON'undaki containers.script alanını değiştirin:
-
vLLM:
vllm serve ... --enable-reasoning --reasoning-parser qwen3 -
SGLang:
python -m sglang.launch_server ... --reasoning-parser deepseek-r1
Modelde ince ayar yapma
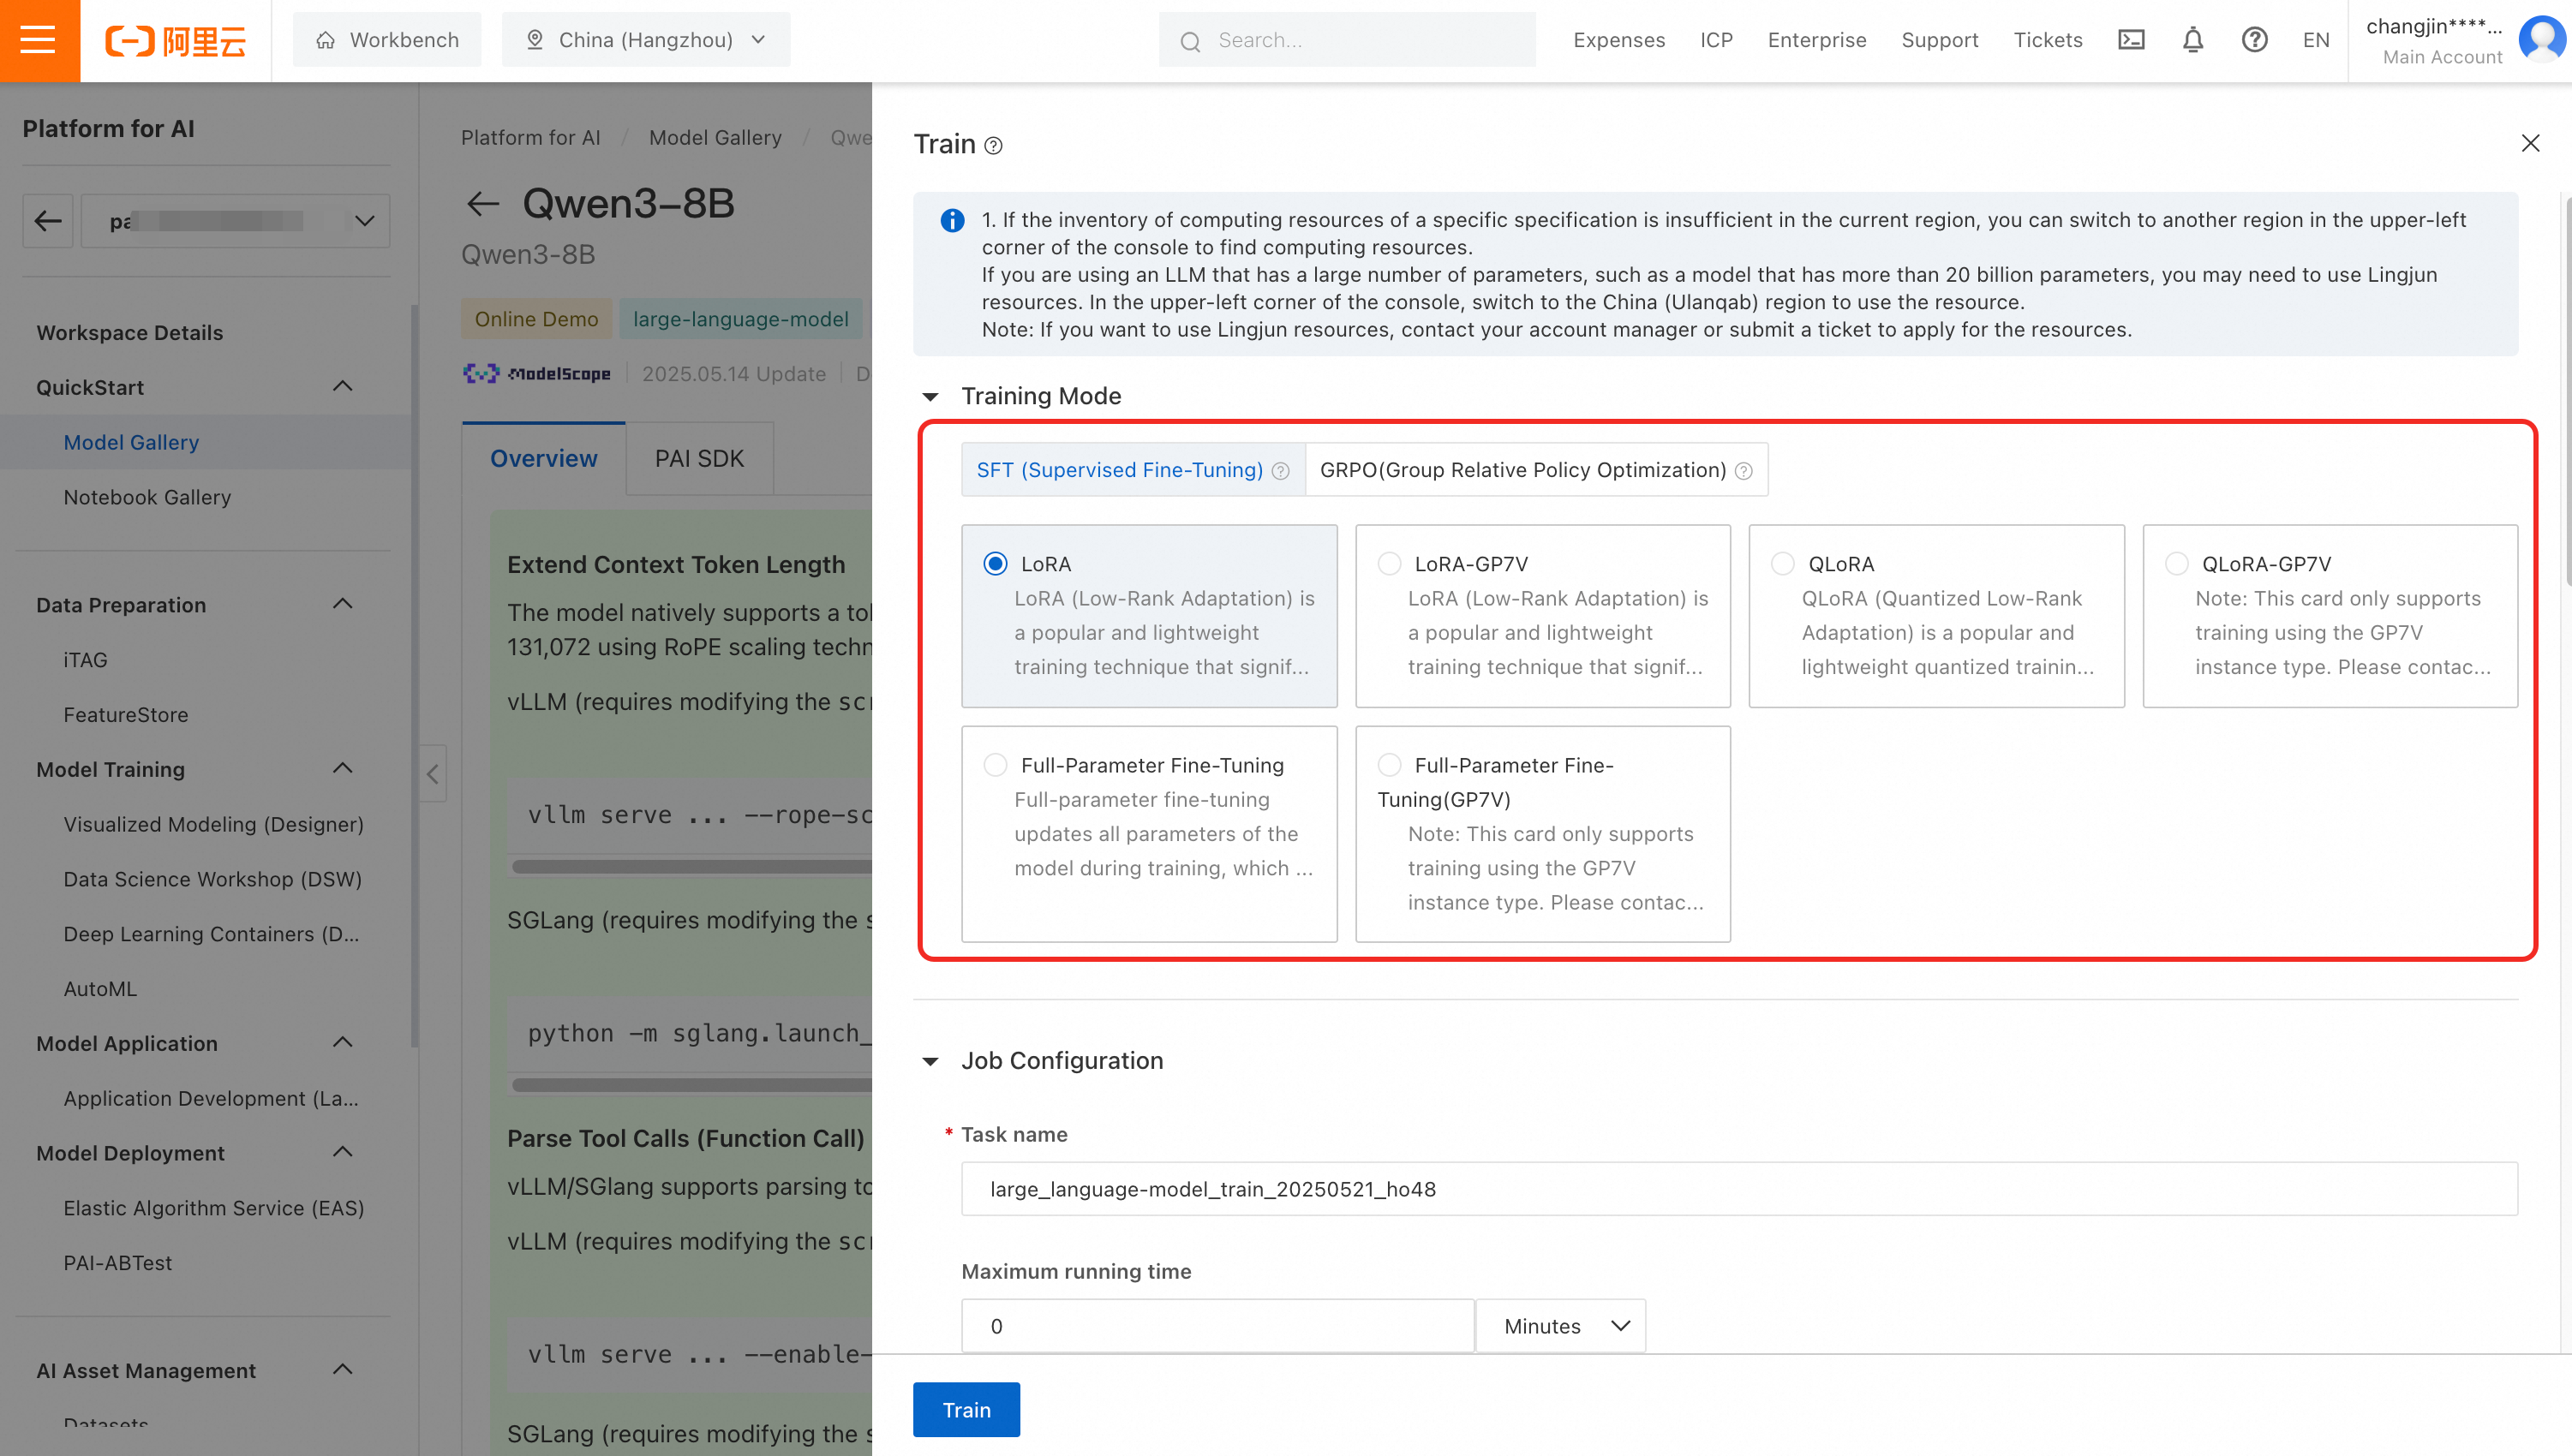
Qwen3-32B, 14B, 8B, 4B, 1.7B ve 0.6B, SFT (tam parametre, LoRA ve QLoRA ince ayarı) ve GRPO eğitimini destekler.
Kurumsal iş senaryolarınız için özel bir model eğitmek amacıyla tek tıklamayla eğitim görevi gönderimini kullanın.

Modeli değerlendirme
Model değerlendirmesine ilişkin ayrıntılı talimatlar için bkz. Model değerlendirme ve LLM değerlendirme için en iyi uygulamalar.
Ek: Hesaplama kaynakları ve token sınırları
Aşağıdaki tabloda her Qwen3 modelinin minimum dağıtım yapılandırması ve her örnek türünün farklı çıkarım çerçeveleri altında desteklediği maksimum token sayısı listelenmiştir.
FP8 modelleri arasında yalnızca Qwen3-235B-A22B, orijinal modelinden daha az hesaplama gücü gerektirir. Diğer FP8 modelleri, FP8 olmayan sürümleriyle aynı hesaplama gücünü gerektirdiğinden tabloda listelenmemiştir. Örneğin, Qwen3-30B-A3B-FP8 tarafından gereken hesaplama gücü için Qwen3-30B-A3B'ye bakın.
Model | Maksimum token (giriş + çıkış) | Minimum yapılandırma | |
SGLang hızlandırılmış dağıtım | vLLM hızlandırılmış dağıtım | ||
Qwen3-235B-A22B | 32.768 (RoPE ölçeklendirmesi ile: 131.072) | 32.768 (RoPE ölçeklendirmesi ile: 131.072) | 8 × GPU H / GU120 (8 × 96 GB VARM) |
Qwen3-235B-A22B-FP8 | 32.768 (RoPE ölçeklendirmesi ile: 131.072) | 32.768 (RoPE ölçeklendirmesi ile: 131.072) | 4 × GPU H / GU120 (4 × 96 GB VARM) |
Qwen3-30B-A3B Qwen3-30B-A3B-Base Qwen3-32B | 32.768 (RoPE ölçeklendirmesi ile: 131.072) | 32.768 (RoPE ölçeklendirmesi ile: 131.072) | 1 × GPU H / GU120 (96 GB VARM) |
Qwen3-14B Qwen3-14B-Base | 32.768 (RoPE ölçeklendirmesi ile: 131.072) | 32.768 (RoPE ölçeklendirmesi ile: 131.072) | 1 × GPU L / GU60 (48 GB VARM) |
Qwen3-8B Qwen3-4B Qwen3-1.7B Qwen3-0.6B Qwen3-8B-Base Qwen3-4B-Base Qwen3-1.7B-Base Qwen3-0.6B-Base | 32.768 (RoPE ölçeklendirmesi ile: 131.072) | 32.768 (RoPE ölçeklendirmesi ile: 131.072) | 1 × A10 / GU30 (24 GB VARM) Önemli RoPE ölçeklendirmeli 8B model 48 GB VARM gerektirir. |
SSS
S: PAI'da dağıtılan model hizmetleri, birden çok istekte bağlamı koruyan oturumları destekler mi?
Hayır. PAI'da dağıtılan model hizmeti API'leri durumsuzdur. Her çağrı tamamen bağımsızdır ve sunucu istekler arasında bağlam veya oturum durumu tutmaz.
Çok turlu konuşmaları uygulamak için istemcinin konuşma geçmişini saklaması ve her isteğe eklemesi gerekir. Bir istek örneği için bkz. Çok turlu konuşma nasıl uygulanır?