PyAlink Betiği bileşeni, kod yazarak herhangi bir Alink algoritmasını çağırmanıza olanak tanır. Bu bileşeni sınıflandırma, regresyon ve öneri gibi görevlerde kullanabilirsiniz. PyAlink Betiği, Machine Learning Designer'daki diğer bileşenlerle sorunsuz entegre olur; böylece uçtan uca iş akışları oluşturabilir ve doğrulayabilirsiniz. Bu konuda PyAlink Betiği bileşeninin nasıl kullanılacağı açıklanmaktadır.
Arka Plan
PyAlink Betiği bileşeni iki şekilde kullanılabilir: tek başına veya diğer Machine Learning Designer bileşenleriyle birlikte. Yüzlerce Alink bileşenine erişim sağlar ve kod aracılığıyla veri türlerinden okuma ve bu türlere yazma işlemlerini destekler. Ayrıca, bileşen tarafından oluşturulan bir PipelineModel'i EAS hizmeti olarak dağıtabilirsiniz. Daha fazla bilgi için bkz. Örnek: PyAlink Betiği ile oluşturulan bir modeli EAS hizmeti olarak dağıtma.
Temel kavramlar
PyAlink Betiği bileşenini kullanmaya başlamadan önce aşağıdaki temel kavramlara aşina olun.
|
Kavram |
Açıklama |
|
operator |
Alink'te operator, bir algoritma işlevini temsil eder. Operatörler toplu iş (batch) veya akış (stream) operatörleri olarak sınıflandırılır. Örneğin, lojistik regresyon aşağıdaki operatörleri içerir:
Operatörler, Her operatörün parametreleri vardır. Örneğin, lojistik regresyon aşağıdaki parametreleri içerir.
Bir parametreyi yapılandırmak için Veri kaynakları ve hedefleri (sink), özel operatör türleridir. Bunlar tanımlandıktan sonra,  Alink, yaygın akış ve toplu iş veri kaynaklarını içerir. Aşağıdaki kod buna bir örnektir. |
|
pipeline |
Alink algoritmalarını bir işlem hattında da kullanabilir, veri işlemeyi, özellik oluşturmayı ve model eğitimini tek bir işlem hattında birleştirerek eğitim, tahmin ve çevrimiçi hizmetler için kullanabilirsiniz. Aşağıdaki kod buna bir örnektir. |
|
vector |
Alink'te iki formatı destekleyen özel bir veri türüdür:
Not
Alink'te, bir sütun vector türündeyse parametre adı genellikle |
PyAlink Betiği tarafından desteklenen Alink bileşenleri
PyAlink Betiğinde, veri işleme, özellik mühendisliği ve model eğitimi için kullanılan bileşenler dahil olmak üzere yüzlerce Alink bileşenini kullanabilirsiniz.
PyAlink Betiği bileşeni şu anda işlem hattı (pipeline) ve toplu iş (batch) bileşenlerini desteklemektedir ancak akış (stream) bileşenlerini desteklememektedir.
Yöntem 1: PyAlink Betiğini tek başına kullanma
Bu konuda, ItemCf modeli ile movielens veri kümesinin puanlanması örneği kullanılarak, Machine Learning Designer platformu ve Alibaba Cloud kaynakları kullanılarak PyAlink Betiği ile uygulanan bir iş akışının nasıl çalıştırılacağı açıklanmaktadır. Prosedür şu şekildedir.
Machine Learning Designer sayfasına gidin ve boş bir işlem hattı oluşturun. Daha fazla bilgi için bkz. Prosedür.
İşlem hattı listesinde, oluşturduğunuz boş işlem hattını seçin ve Open seçeneğine tıklayın.
Soldaki bileşen listesinin arama kutusunda PyAlink Script öğesini arayın ve PyAlink Script öğesini sağ taraftaki tuvale sürükleyin. Tuvalde otomatik olarak PyAlink Script-1 adlı bir işlem hattı düğümü oluşturulur.
-
Tuvalde PyAlink Script-1 düğümünü seçin. Sağ bölmede, Parameter Settings ve Execution tuning sekmelerindeki parametreleri yapılandırın.
-
Parameter Settings sekmesinde kodunuzu yazın. Aşağıdaki kod bir örnektir.
from pyalink.alink import *
def main(sources, sinks, parameter):
    PATH = "http://alink-test.oss-cn-beijing.aliyuncs.com/yuhe/movielens/"
    RATING_FILE = "ratings.csv"
    PREDICT_FILE = "predict.csv"
    RATING_SCHEMA_STRING = "user_id long, item_id long, rating int, ts long"
    ratingsData = CsvSourceBatchOp() \
            .setFilePath(PATH + RATING_FILE) \
            .setFieldDelimiter("\t") \
            .setSchemaStr(RATING_SCHEMA_STRING)
    predictData = CsvSourceBatchOp() \
            .setFilePath(PATH + PREDICT_FILE) \
            .setFieldDelimiter("\t") \
            .setSchemaStr(RATING_SCHEMA_STRING)
    itemCFModel = ItemCfTrainBatchOp() \
            .setUserCol("user_id").setItemCol("item_id") \
            .setRateCol("rating").linkFrom(ratingsData);
    itemCF = ItemCfRateRecommender() \
            .setModelData(itemCFModel) \
            .setItemCol("item_id") \
            .setUserCol("user_id") \
            .setReservedCols(["user_id", "item_id"]) \
            .setRecommCol("prediction_score")
    result = itemCF.transform(predictData)
    result.link(sinks[0])
    BatchOperator.execute()
Bir PyAlink Betiği dört çıkış bağlantı noktasını destekler. Betikte, verileri ilk çıkış bağlantı noktasına yazmak için
result.link(sinks[0])ifadesini kullanın. Aşağı akış bileşenleri, bu ilk çıkış bağlantı noktasına bağlanarak betikten verileri okuyabilir. Daha fazla bilgi için bkz. PyAlink Betiğinde farklı veri türlerini okuma ve yazma. -
Execution tuning sekmesinde, çalışma modunu ve düğüm teknik özelliklerini ayarlayın.
Parametre
Açıklama
Select job running mode
Aşağıdaki modlar desteklenir:
-
DLC (Single-machine, multi-concurrency): Küçük veri kümelerine sahip görevler ve hata ayıklama/doğrulama amaçları için önerilir.
-
MaxCompute (Distributed): Büyük veri kümelerine sahip görevler veya üretim görevleri için önerilir.
-
Fully-managed Flink: Görevi, çalışma alanına bağlı Fully-managed Flink kümesinde yürütür.
Number of workers
Bu parametre yalnızca job running mode MaxCompute (Distributed) veya Fully-managed Flink (Distributed) olduğunda gereklidir. Bu parametre, yürütme düğümlerinin sayısını belirtir. Bu parametreyi boş bırakırsanız sistem, görev verilerine göre düğümleri otomatik olarak ayırır. Varsayılan olarak bu parametre boştur.
Memory per worker (MB)
Bu parametreyi yalnızca running mode of the job MaxCompute (Distributed) veya Fully-managed Flink (Distributed) olarak ayarlandığında yapılandırmanız gerekir. Parametre, tek bir düğümün bellek boyutunu MB cinsinden belirtir. Değer pozitif bir tamsayı olmalıdır ve varsayılan değer 8192'dir.
CPU cores per worker
Bu parametre yalnızca Job running mode MaxCompute (distributed) veya Fully-managed Flink (distributed) olarak ayarlandığında gereklidir. Bu parametre, tek bir düğüm için CPU çekirdeği sayısını belirtir. Değer pozitif bir tamsayı olmalıdır ve varsayılan olarak boştur.
Select node specification to run script
DLC düğümünün kaynak türü. Varsayılan değer 2 vCPU + 8 GB Mem-ecs.g6.large'dır.
-
-
Tuvalin üst kısmında Save seçeneğine tıklayın ve ardından PyAlink Betiğini çalıştırmak için Çalıştır simgesine
 tıklayın.
-
Görev tamamlandığında, tuvaldeki PyAlink Script-1 düğümüne sağ tıklayın ve sonuçları görmek için seçeneğini belirleyin.
Sütun adı
Açıklama
user_id
Kullanıcı kimliği.
item_id
Film kimliği.
prediction_score
Kullanıcının filme olan tercihini gösterir. Bu puan, öneriler için referans olarak kullanılır.
Yöntem 2: PyAlink Betiğini diğer bileşenlerle birleştirme
PyAlink Betiği bileşeninin giriş ve çıkış bağlantı noktaları, Machine Learning Designer'daki diğer algoritma bileşenleriyle aynıdır. Birleşik bir işlem hattı oluşturmak için bunları aşağıdaki şekilde gösterildiği gibi bağlayabilirsiniz.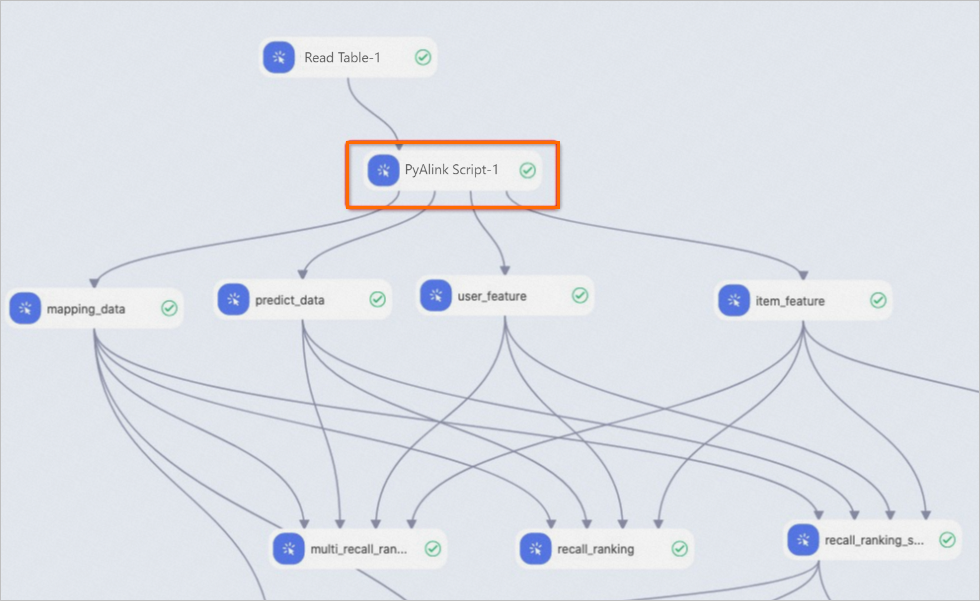
PyAlink Betiğinde veri okuma ve yazma
-
Veri okuma.
-
MaxCompute tablosundan okuma: Betik, bir giriş bağlantı noktası aracılığıyla yukarı akış bileşeninden geçirilen verileri okur. Aşağıdaki kod buna bir örnektir.
train_data = sources[0]
test_data = sources[1]
Kodda,
sources[0]ilk giriş bağlantı noktasına bağlı MaxCompute tablosunu vesources[1]ikinci giriş bağlantı noktasına bağlı tabloyu temsil eder. Bileşen en fazla dört giriş bağlantı noktasını destekler. -
Ağ dosya sisteminden okuma: Betik, kod içinde
CsvSourceBatchOpveAkSourceBatchOpgibi Alink'in source bileşenlerini kullanarak verileri okur. Aşağıdaki dosya türlerini okuyabilirsiniz:-
HTTP üzerinden ağdan paylaşılan bir dosyayı okuma. Aşağıdaki kod buna bir örnektir:
ratingsData = CsvSourceBatchOp() \ .setFilePath(PATH + RATING_FILE) \ .setFieldDelimiter("\t") \ .setSchemaStr(RATING_SCHEMA_STRING) -
OSS dosyasını okuma. İlk olarak, pipeline properties sekmesinde işlem hattı için geçici veri depolama yolunu bulun. Bu yol, OSS okuma/yazma işlemleri için kullanılan
oss://<bucket-name>/<path>biçimindedir. Aşağıdaki kod buna bir örnektir.model_data = AkSourceBatchOp().setFilePath("oss://xxxxxxxx/model_20220323.ak")
-
-
-
Veri yazma.
-
MaxCompute tablosuna yazma: Betik, bir çıkış bağlantı noktası aracılığıyla verileri aşağı akış bileşenine yazar. Aşağıdaki kod buna bir örnektir.
result0.link(sinks[0]) result1.link(sinks[1]) BatchOperator.execute()result0.link(sinks[0])satırı verileri yazar ve bunların ilk çıkış bağlantı noktası üzerinden erişilebilir olmasını sağlar. En fazla dört sonuç tablosuna, karşılık gelen dört çıkış bağlantı noktasına yazabilirsiniz. -
OSS dosyasına yazma. pipeline properties sekmesinde bulunan işlem hattının temporary data storage path alanında tanımlanan OSS yolunu kullanın. Aşağıdaki kod buna bir örnektir.
result.link(AkSinkBatchOp() \
            .setFilePath("oss://xxxxxxxx/model_20220323.ak") \
            .setOverwriteSink(True))
BatchOperator.execute()
-
Örnek: Bir modeli EAS hizmeti olarak dağıtma
-
Dağıtılacak modeli oluşturun.
Bir modeli EAS hizmeti olarak yalnızca PyAlink Betiği bileşeni tarafından oluşturulan bir PipelineModel ise dağıtabilirsiniz. Bir PipelineModel dosyası oluşturmak için aşağıdaki kodu kullanın. Betiğin nasıl çalıştırılacağına ilişkin talimatlar için bkz. Yöntem 1: PyAlink Betiği bileşenini tek başına kullanma.
from pyalink.alink import * def main(sources, sinks, parameter): PATH = "http://alink-test.oss-cn-beijing.aliyuncs.com/yuhe/movielens/" RATING_FILE = "ratings.csv" PREDICT_FILE = "predict.csv" RATING_SCHEMA_STRING = "user_id long, item_id long, rating int, ts long" ratingsData = CsvSourceBatchOp() \ .setFilePath(PATH + RATING_FILE) \ .setFieldDelimiter("\t") \ .setSchemaStr(RATING_SCHEMA_STRING) predictData = CsvSourceBatchOp() \ .setFilePath(PATH + PREDICT_FILE) \ .setFieldDelimiter("\t") \ .setSchemaStr(RATING_SCHEMA_STRING) itemCFModel = ItemCfTrainBatchOp() \ .setUserCol("user_id").setItemCol("item_id") \ .setRateCol("rating").linkFrom(ratingsData); itemCF = ItemCfRateRecommender() \ .setModelData(itemCFModel) \ .setItemCol("item_id") \ .setUserCol("user_id") \ .setReservedCols(["user_id", "item_id"]) \ .setRecommCol("prediction_score") model = PipelineModel(itemCF) model.save().link(AkSinkBatchOp() \ .setFilePath("oss://<your_bucket_name>/model.ak") \ .setOverwriteSink(True)) BatchOperator.execute()<your_bucket_name>ifadesini OSS paketinizin adıyla değiştirin.ÖnemliPATH içinde yapılandırılan veri kümesi yolu için okuma izniniz olduğundan emin olun. Aksi takdirde bileşen çalıştırılamaz.
-
Bir EAS yapılandırma dosyası oluşturun.
Çıktıyı bir
config.jsondosyasına yazmak için aşağıdaki betiği çalıştırın.# EAS configuration file import json # Generate EAS model configuration model_config = {} # Schema of the data that EAS receives model_config['inputDataSchema'] = "id long, movieid long" model_config['modelVersion'] = "v0.2" eas_config = { "name": "recomm_demo", "model_path": "http://xxxxxxxx/model.ak", "processor": "alink_outer_processor", "metadata": { "instance": 1, "memory": 2048, "region":"China (Beijing)" }, "model_config": model_config } print(json.dumps(eas_config, indent=4))config.jsondosyasındaki anahtar parametreler:name: Dağıtılan model hizmetinin adı.model_path: PipelineModel dosyasının depolandığı OSS yolu. Bunu, model dosyanızın gerçek OSS yoluyla değiştirmeniz gerekir.
config.jsondosyasındaki diğer parametrelerin açıklaması için bkz. Komut referansı. -
Modeli EAS hizmeti olarak dağıtın.
Modeli eascmd istemcisini kullanarak dağıtın. İstemci kurulum talimatları için bkz. İstemciyi indirip yapılandırma. Örneğin, 64 bit Windows sisteminde şu komutu çalıştırın:
eascmdwin64.exe create config.json