LangStudio; akış kontrolü, LLM'ler, ajanlar, veri alımı, belge ayrıştırma, konuşma tanıma ve Python betiği için önceden oluşturulmuş iş akışı düğümleri sağlar.
Akış kontrolü
Başlat
Bir uygulama akışı yalnızca tek bir Başlat düğümüne sahip olabilir.
Başlat düğümü, yürütmenin başladığı yeri işaretler ve uygulama akışı için giriş parametrelerini tanımlar.
-
Konuşma tabanlı akışlar için sistem varsayılan olarak iki alan sunar: konuşma geçmişi ve kullanıcı girişi. Gerektiğinde özel değişkenler ekleyin. Kullanıcı tarafından yüklenen dosyaları kabul etmek için dosya türünde bir giriş değişkeni tanımlayın. Ayrıntılar için bakınız: Dosya türü girdisi ve çıktısı.
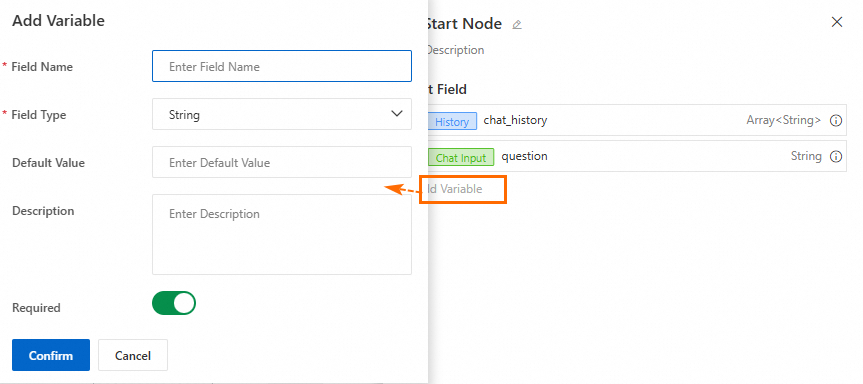
-
Uygulama akışını çalıştırdığınızda mevcut oturumun giriş parametrelerini konuşma panelinde yapılandırın.
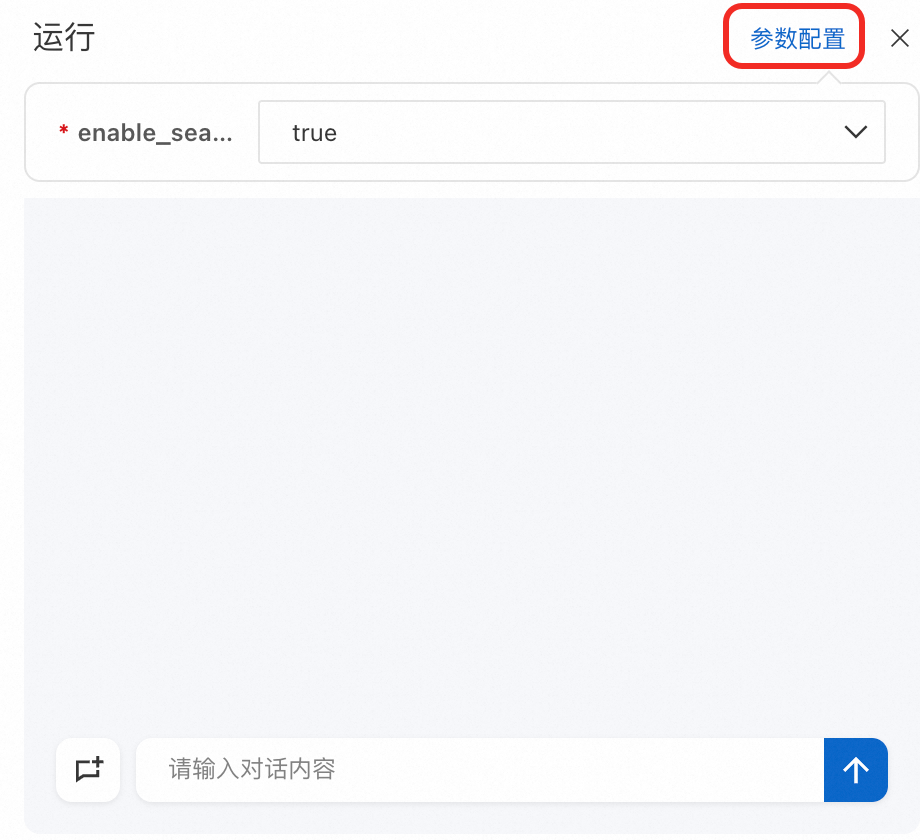
Koşullu dal
Bu düğüm, akış kontrolü için if-else mantığını uygular. Koşulları değerlendirir ve yürütmeyi ilk eşleşen dala yönlendirir. Hiçbir koşul true (doğru) değilse else dalı çalışır. Farklı dallardan gelen sonuçları birleştirmek için bu düğümü Değişken toplayıcı düğümüyle birlikte kullanın.
-
Yapılandırma
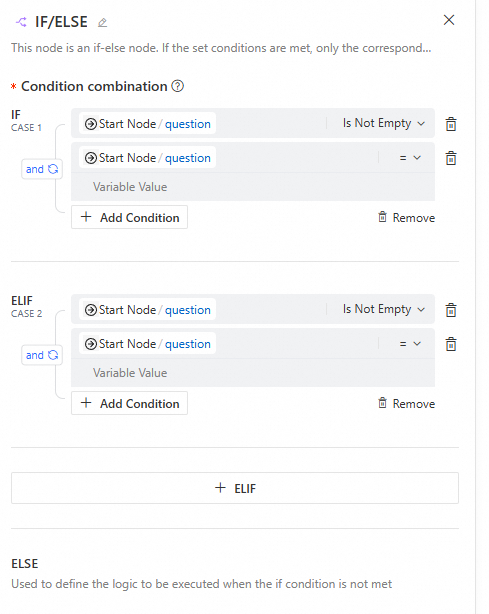
-
Giriş
Dal koşullarını yapılandırırken aşağıdaki hususlara dikkat edin:
Her dal bir yürütme yolunu temsil eder. Son dal else dalıdır; diğer hiçbir koşul eşleşmediğinde çalışır ve düzenlenemez.
Her dal birden fazla koşul içerebilir; bu koşullar and/or (ve/veya) mantığıyla birleştirilebilir.
Doğru ve geçerli koşullar sağlamak amacıyla yukarı akış düğümlerinden gelen çıktıları, operatörleri (örneğin
=,≠,is emptyvedoes not include) ve değerleri doğrulayın.
-
Çıktı
Bu düğüm çıktı üretmez.
-
Kullanım örneği
Koşullu dal düğümünü aşağı akış düğümlerine bağladığınızda her dalın karşılık gelen bir bağlantı noktası bulunur. Bir dal koşulu sağlandığında sistem o daldaki aşağı akış düğümlerini çalıştırır ve diğer dalları atlar. Aktif daldan gelen yürütme sonuçlarını toplamak için Değişken toplayıcı düğümünü kullanın.
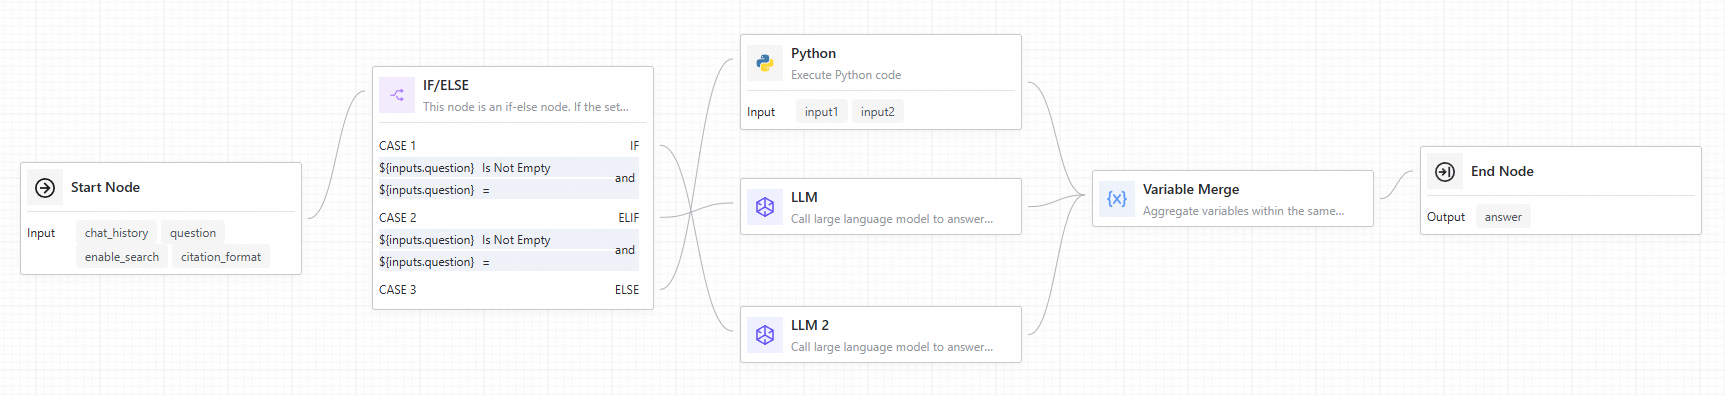
Değişken toplayıcı
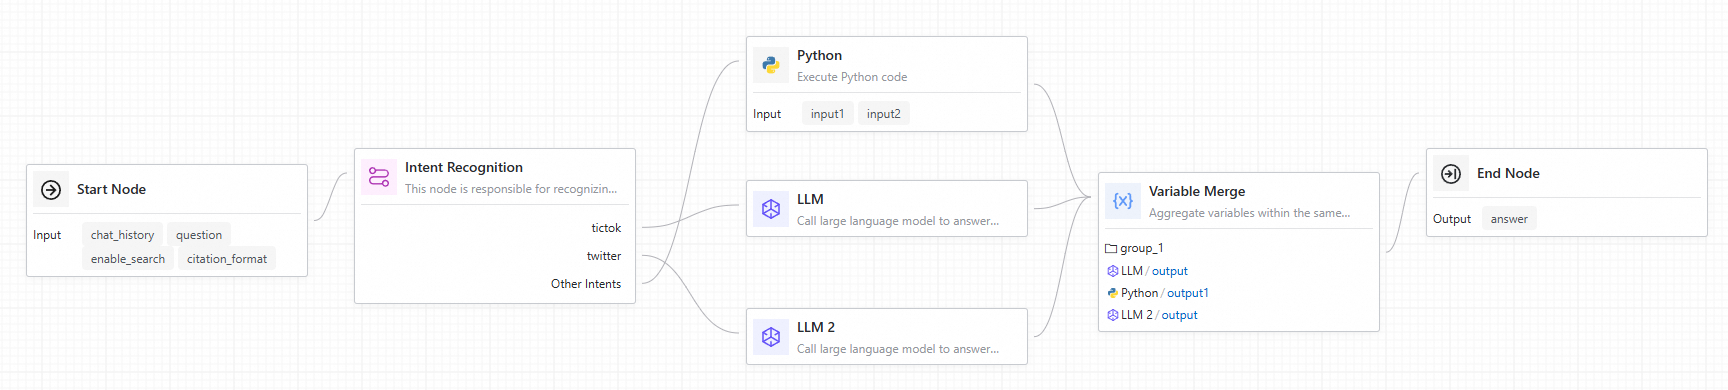
Bu düğüm, farklı dallardan gelen çıktı sonuçlarını tek bir değişkende birleştirir. Koşullu dal veya Niyet tanıma düğümü çalıştığında yalnızca tek bir dal yürütülür. Bu düğüm sayesinde hangi dalın çalıştığından bağımsız olarak aşağı akış düğümleri tek bir toplanmış değişkene başvurabilir; böylece gereksiz mantık tekrarlarından kaçınılır.
-
Yapılandırma
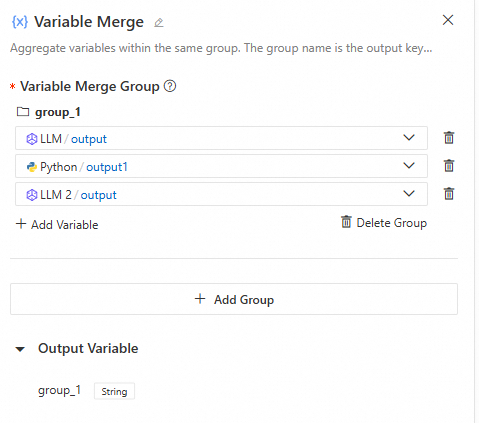
-
Giriş
Değişken gruplarını yapılandırırken aşağıdaki hususlara dikkat edin:
Yukarı akış düğümleri genellikle bir Koşullu dal veya Niyet tanıma düğümü tarafından oluşturulan birden çok yürütme dalından oluşur.
Aynı gruptaki değişkenler aynı türde olmalıdır. O grup için çıktı olarak ilk boş olmayan değer kullanılır.
Yalnızca tek bir yukarı akış dalı çalıştığından her grupta en fazla bir boş olmayan değer bulunur. Değişken toplayıcı düğümü, aşağı akış düğümlerinin kullanabilmesi için bu değeri ayıklar.
Her dalda toplanacak birden çok çıktı varsa her bir karşılık gelen çıktı değerini ayıklamak için birden çok grup ekleyebilirsiniz.
-
Çıktı
Düğümün çıktı değişkenleri yapılandırılan gruplara bağlıdır. Birden çok grup varsa düğüm her grup için bir anahtar-değer çifti çıktılar; burada anahtar grup adı, değer ise o gruptaki ilk boş olmayan değişkendir.
-
Kullanım örneği
Koşullu dal düğümünün kullanım senaryosuna bakınız.
Döngü
Döngü düğümü, her yinelemenin önceki sonuca bağlı olduğu tekrarlayan görevleri çalıştırır. Döngü, bir çıkış koşulu karşılanana veya maksimum yineleme sayısı aşılmaya kadar devam eder. Döngü düğümü içinde sistemin döngü değişkenine göre tekrar tekrar çalıştırdığı bir alt akış yapılandırın.
-
Yapılandırma
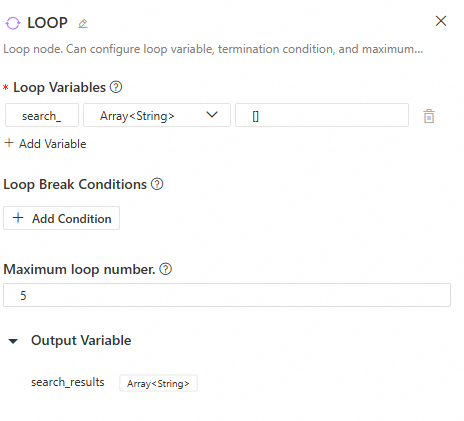
-
Giriş
Döngü değişkenleri: Yinelemeler arasında veri aktarımı sağlar. Döngü tamamlandıktan sonra son değerleri aşağı akış düğümleri kullanmaya devam eder. Değerleri elle girilebilen veya yukarı akış düğüm çıktılarından seçilebilen birden çok döngü değişkeni yapılandırın.
Döngü çıkış koşulu: Döngü değişkenlerine dayalı bir çıkış koşulu yapılandırabilirsiniz. Belirtilen bir döngü değişkeni önceden ayarlanmış koşulu karşıladığında döngü sonlanır.
Maksimum yineleme sayısı: Sonsuz döngüleri önlemek amacıyla döngü yürütmelerinin üst sınırını belirler.
-
Çıktı
Düğümün çıktısı, son yinelemeden sonraki döngü değişkenlerinin değeridir. Döngü değişkenleri yalnızca bir Değişken Atayıcı düğümü tarafından güncellenebilir. Bu düğüm olmadan yineleme sayısından bağımsız olarak döngünün çıktısı ilk girdisiyle aynı kalır.
-
İlgili düğümler
Döngüyle ilgili düğümler yalnızca bir döngü içinde kullanılabilir. Döngü içindeki bir düğümün sağındaki + simgesine tıklayarak aşağıdaki ilgili düğümleri ekleyin:
-
Döngüyü Kes
Döngüden hemen çıkar. Bu işlem genellikle bir Koşullu dal düğümünden önce gelir.
-
Değişken Atayıcı
Döngü içindeki düğümlerin çıktısını döngü değişkenlerine atayarak döngünün durumunu ilerletir.
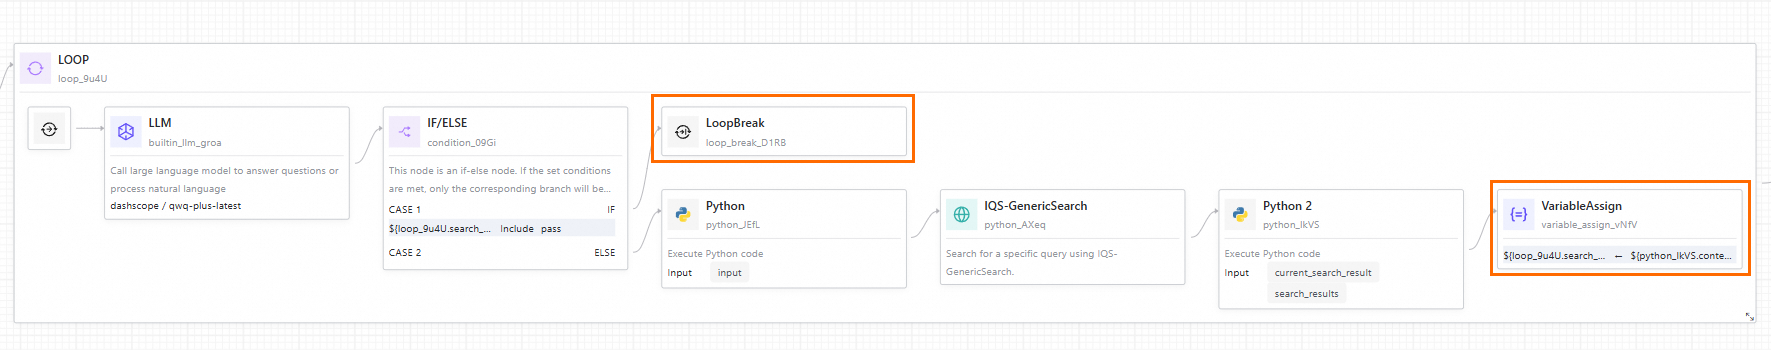
-
Doğrudan çıktı
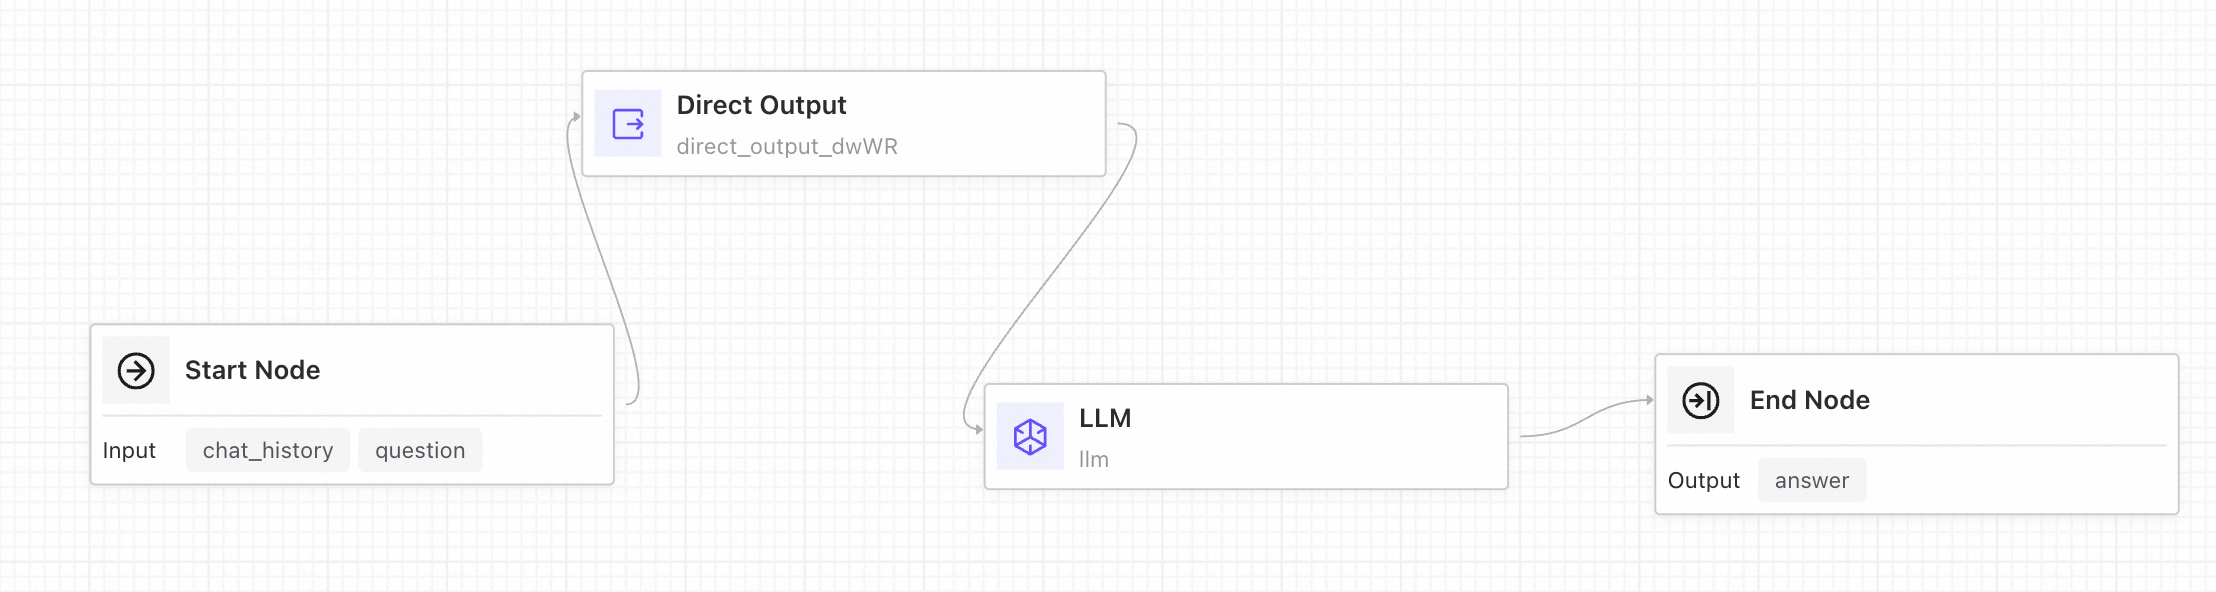
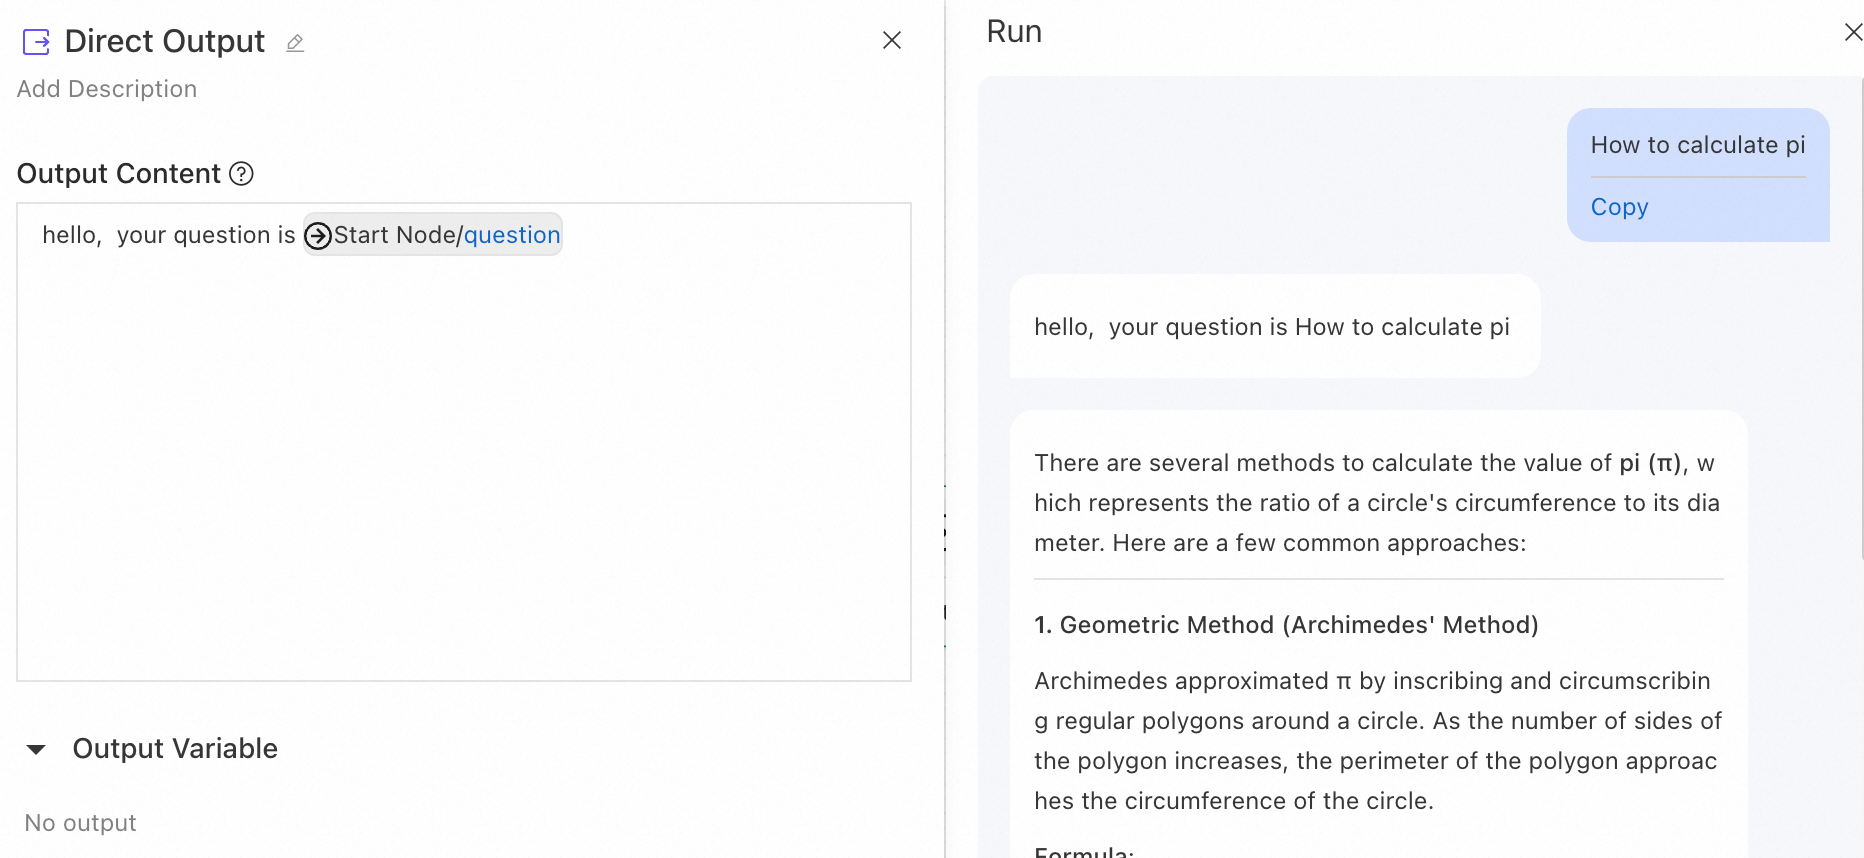
Doğrudan çıktı düğümü, bir çıktı şablonu kullanarak doğrudan yanıt içeriğini yapılandırır. {{node.variable}} sözdizimiyle yukarı akış düğüm çıktılarına başvurmayı ve akışlı (streaming) çıktıyı destekler.
Örnek: Ana görev işlenirken kullanıcıya "Düşünüyor..." gibi bir ilk mesaj göndermek için bir LLM düğümünden önce bir Doğrudan çıktı düğümü ekleyin.
Toplu işleme
Toplu işleme düğümü liste verilerini paralel olarak işler. Aynı alt akışı listedeki her öğeye uygulayarak verimliliği önemli ölçüde artırır. Her adımın öncekine bağlı olduğu yinelenen görevler için bunun yerine Döngü düğümünü kullanın.
Giriş
Giriş listesi: İşlenecek veri listesi. Düğüm her öğeyi bağımsız bir madde olarak yürütülmek üzere alt akışa gönderir.
Çıktı alanı: Alt akış içindeki bir düğümün, her maddenin görev sonucu olarak hizmet edecek çıktı değişkenini seçin.
Paralellik sayısı: İsteğe bağlı. Aynı anda yürütülen görev sayısını kontrol eder. Varsayılan değer 4'tür; geçerli aralık 1 ile 10 arasındadır.
Çıktı
result: Tüm toplu iş görevlerinden alınan çıktı sonuçlarını giriş listesiyle aynı sırada içeren bir liste. Girişte belirtilen "Çıktı alanı"nın gerçek çıktı değerlerini toplar.
İlgili düğümler
Toplu Başlat
Toplu Başlat düğümü, toplu işleme alt akışının giriş noktasıdır. Alt akıştaki sonraki düğümler tarafından referans alınabilecek aşağıdaki çıktı değişkenlerini sağlar:
item: Şu anda işlenen veri maddesi; giriş listesindeki bir öğeye karşılık gelir.
index: Giriş listesindeki mevcut veri maddesinin dizini (0'dan başlar).
Toplu Kes
Toplu Kes düğümü, belirli bir koşul karşılandığında mevcut veri maddesinin işlenmesini erken sonlandırmak için kullanılır.
Not: Toplu Kes düğümü yalnızca geçerli yinelemeyi sonlandırır ve diğer veri maddelerinin işlenmesini etkilemez.
Kullanım örneği
Toplu belge ayrıştırma ve akıllı işleme
Senaryo: Bir kuruluşun birden çok belge dosyasını toplu olarak ayrıştırması, başarıyla ayrılmış belgeler için içerik işleme amacıyla bir LLM çağırması ve ayrıştırılamayanları otomatik olarak atlaması gerekir.
Toplu işleme düğümü yapılandırması:
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
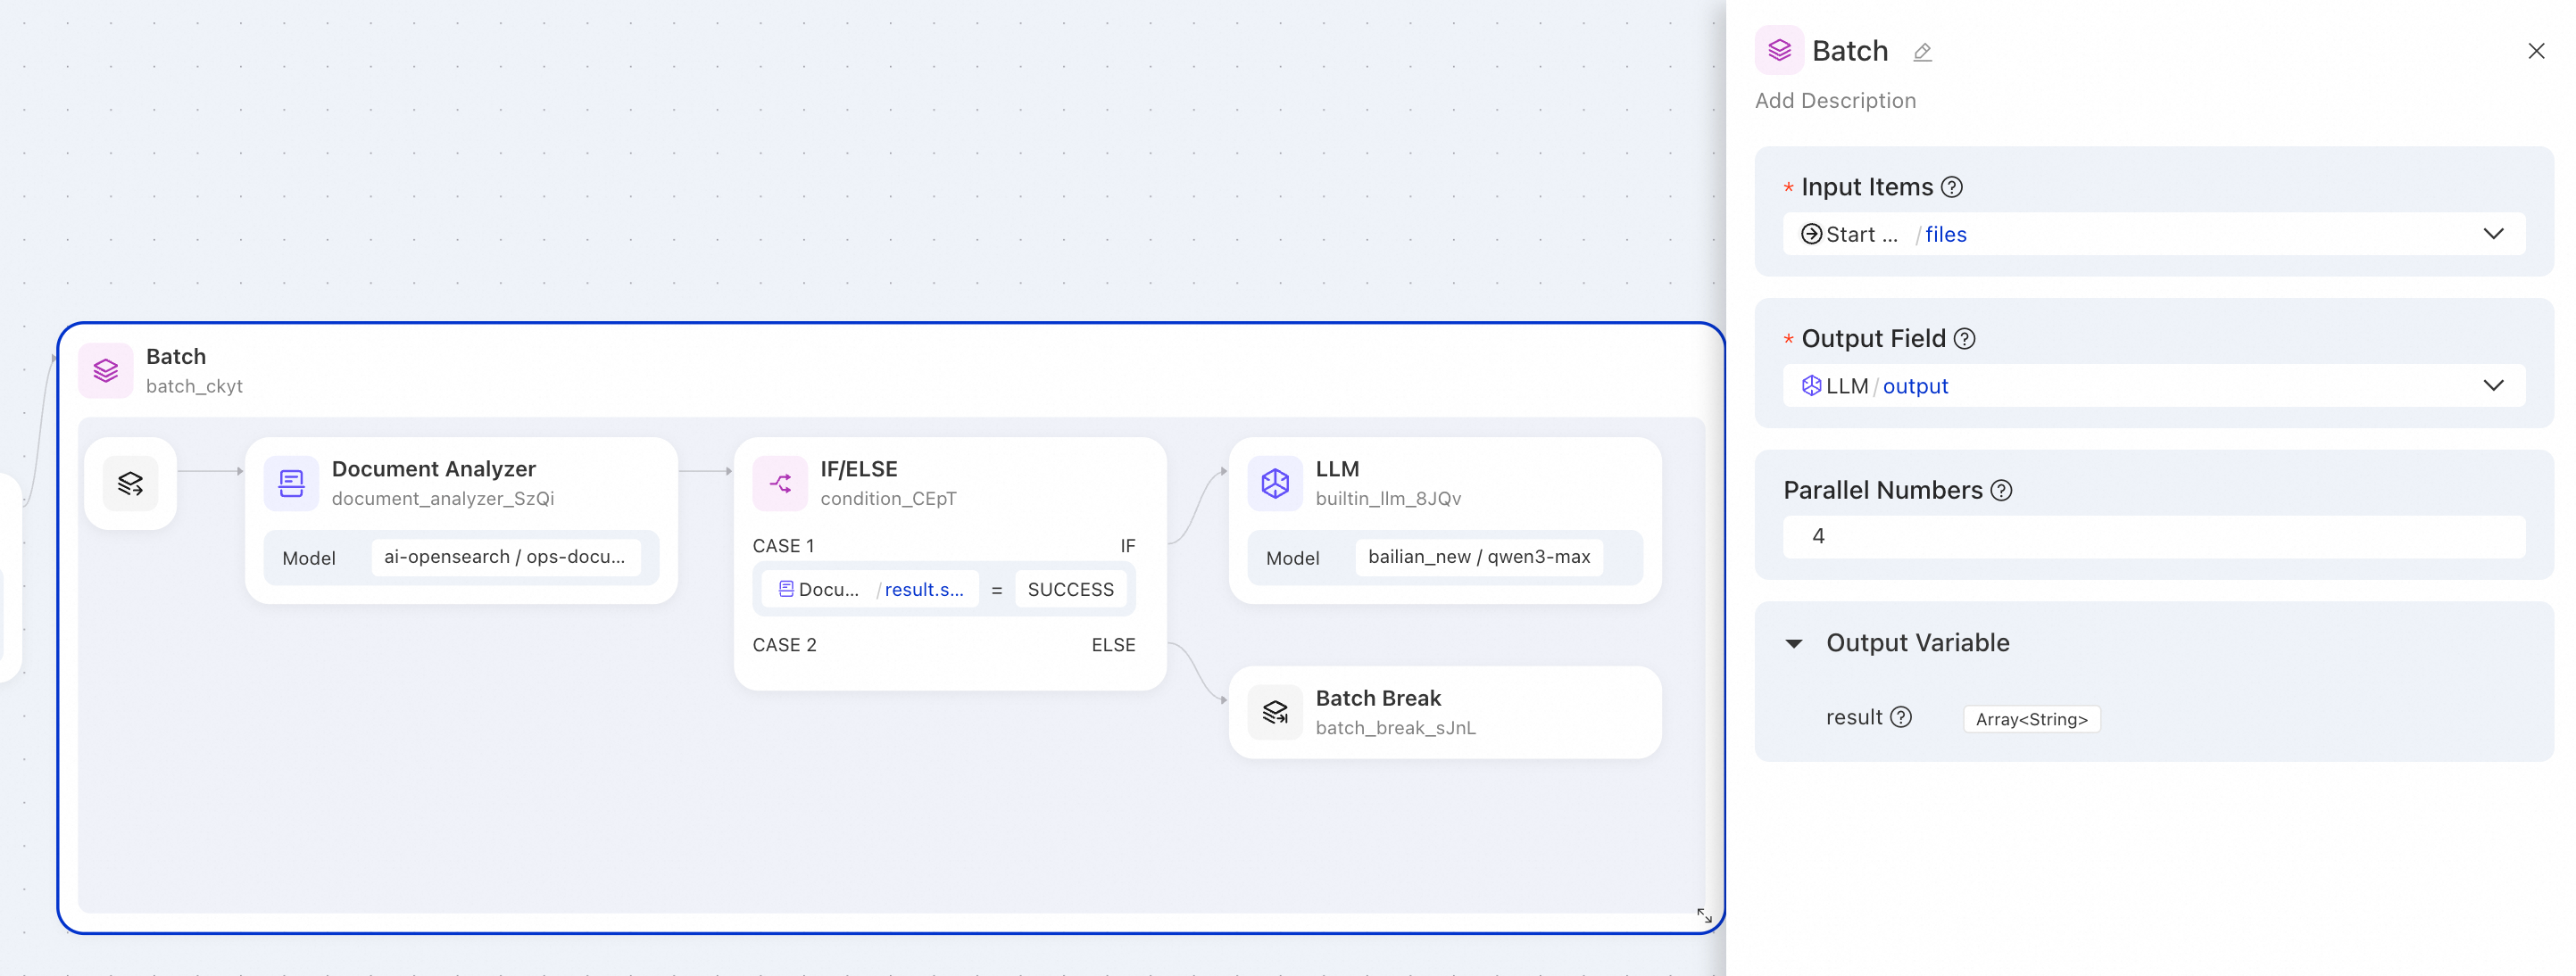
Örnek çıktı:
{
  "result": [
    "This document is the user manual for product XX, which includes product feature introductions, installation steps...",
    "This is a software service procurement contract with a term of 12 months...",
    null,
    "Value-added tax ordinary invoice, dated January 15, 2026..."
  ]
}Not: Çıktıda yer alan null değeri, dosyanın ayrıştırılamadığını ve Toplu Kes düğümünün sonraki işlemleri atladığını gösterir.
Notlar
Sonuç sırası garantisi: Çıktı listesinin sırası, giriş listesinin sırasıyla tutarlıdır.
Alt akış esnekliği: Alt akış içinde farklı veri maddeleri farklı yürütme yollarını tetikleyebilir.
Null değer işleme: Bir maddenin yürütme akışı erken sonlanırsa veya çıktısı boşsa çıktı listesindeki karşılık gelen konum null olur.
Son
Son düğümü, bir uygulama akışının tamamlandığını işaretler ve çıktı parametrelerini tanımlar. Bir uygulama akışı yalnızca tek bir Son düğümüne sahip olabilir.
-
Çıktı parametresi yapılandırması
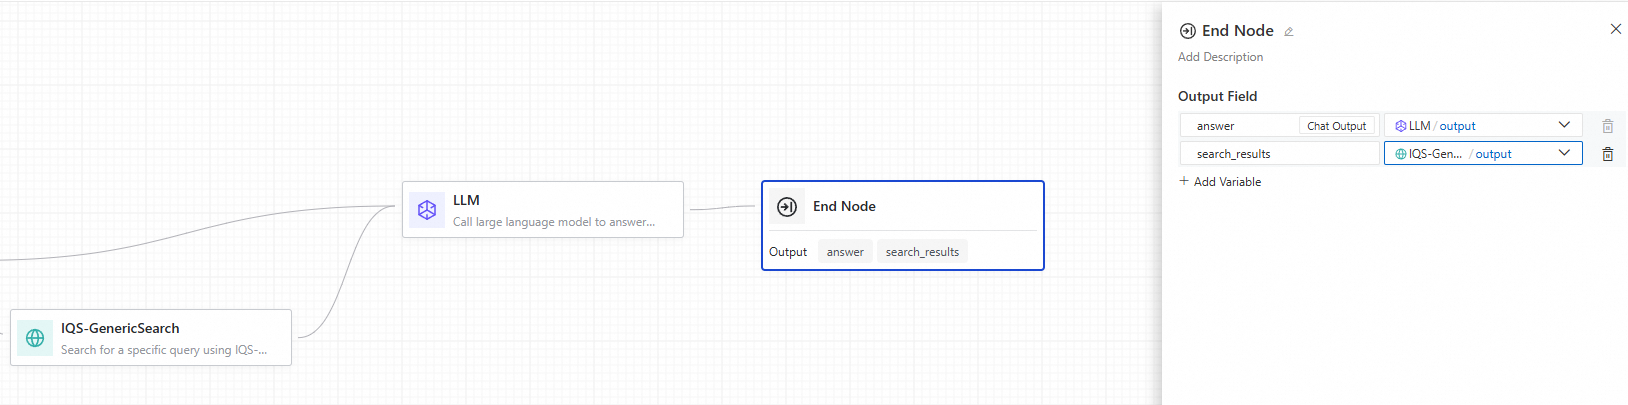
Uygulama akışının çıktısı herhangi bir yukarı akış düğümünün çıktısına başvurabilir. Örneğin aşağıdaki örnekte uygulama akışının 'answer' çıktısı LLM düğümünün çıktısını kullanırken 'search_results' arama düğümünün çıktısını kullanır.
 Not
Konuşma tabanlı bir akışta uygulama akışının konuşma çıktısı olarak hizmet veren varsayılan bir 'Chat' çıktı alanı bulunur.
Bir uygulama akışı Başlat ve Son düğümlerini içermelidir. Yalnızca bunların arasında bağlı olan düğümler yürütülür; izole düğümler yok sayılır.
AI yetenekleri
LLM
LLM düğümü, metin oluşturma, soru yanıtlama ve karmaşık giriş işleme gibi doğal dil görevleri için bir büyük dil modeli çağıran bir uygulama akışının temel bileşenidir. Model parametrelerini ayarlama, konuşma geçmişini yönetme ve istemleri özelleştirme için yapılandırma seçenekleri sunar.
-
Kullanım senaryoları
Metin oluşturma: Konulara ve anahtar kelimelere dayalı metin içeriği oluşturun.
İçerik sınıflandırma: E-posta türlerini (örneğin bilgi talebi, şikayet veya spam) otomatik olarak sınıflandırın.
Metin çevirisi: Metni belirtilen dile çevirin.
RAG: Alınan bilgiyi modelin akıl yürütmesiyle birleştirerek kullanıcı sorularını yanıtlayın.
-
Yapılandırma
-
Giriş
-
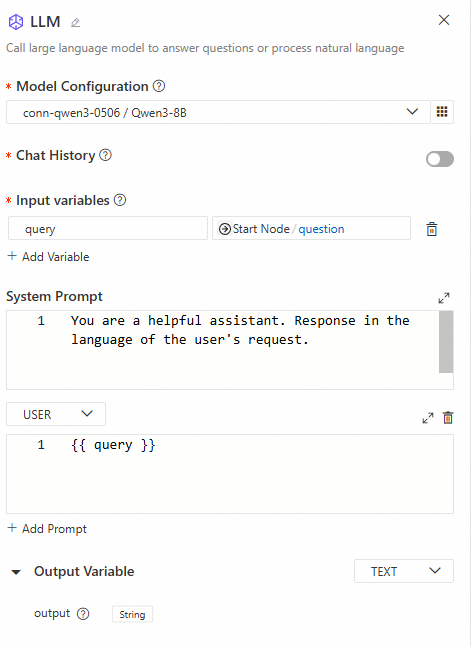
Model ayarları: ModelGallery'den dağıtılan modelleri, özel olarak dağıtılan model hizmetlerini ve Dashscope ile DeepSeek gibi sağlayıcılardan gelen modelleri destekler. En iyi performans için yüksek yetkinliğe sahip bir model seçin. Aşağıdaki model parametrelerini yapılandırın:
Sıcaklık (Temperature): Genellikle 0 ile 1 arasında bir değerdir; çıktı rastgeleliğini kontrol eder. 0'a yakın değerler daha deterministik çıktılar üretirken 1'e yakın değerler daha çeşitli sonuçlar verir.
Top P: Çekirdek örnekleme eşiği. Model kümülatif olasılığı P eşiğini aşan en küçük token kümesinden örnekleme yapar; bu da çıktının çeşitliliğini etkiler.
Top K: Aday tokenları en olası K tanesiyle sınırlar. Rastgeleliği azaltarak çıktıyı daha odaklı hale getirir ve yaratıcılığı Top P'ye göre daha doğrudan kısıtlar.
Varlık cezası (Presence penalty): Aynı varlıkların veya bilgilerin tekrarlanmasını azaltır. Oluşturulan metinde zaten bulunan tokenlara ceza uygular. Daha yüksek değerler tekrarı daha agresif şekilde azaltır.
Frekans cezası (Frequency penalty): Tokenlara oluşturulan metindeki frekanslarına göre ceza uygular; aşırı sık kullanılan kelime veya ifadeleri azaltır. Daha yüksek değerler daha fazla sözcük çeşitliliğini teşvik eder.
Maksimum token: Çalıştırma başına maksimum çıktı uzunluğu (token cinsinden). Daha düşük değerler çıktıyı kesebilir, daha yüksek değerler ise daha uzun yanıtlara izin verir.
Seed (Tohum): Belirtildiğinde model deterministik örnekleme yapmaya çalışır. Aynı seed ve parametrelerle yapılan tekrarlanan istekler aynı sonucu vermelidir ancak tam determinizm garanti edilmez. Değişiklikleri izlemek için system_fingerprint yanıt parametresine bakınız.
Durdurma dizileri (Stop sequences): Modelin daha fazla çıktı üretmeyi durdurmasını sağlayan en fazla dört dizi. Model bu dizilerden biriyle karşılaştığında token üretmeyi bırakır. Dönen metin durdurma dizisini içermez.
Konuşma geçmişi: Etkinleştirildiğinde uygulama akışının sohbet geçmişi otomatik olarak isteme eklenir.
Giriş değişkenleri: Değişkenler tüm önceki düğümlerin çıktılarına başvurabilir.
İstem (Prompt): Sistem (SYSTEM), Kullanıcı (USER) veya Asistan (ASSISTANT) için özel içerik barındırır. İstem, çift süslü parantez
{{}}kullanarak giriş değişkenlerine başvurabileceğiniz bir Jinja2 şablonudur.
-
-
Çıktı
Düğüm varsayılan olarak String çıktı üretir ancak JSON'u da destekler. JSON türü özel çıktı değişkenlerini destekler; model değişken adlarına göre çıktı oluşturur.
-
Kullanım senaryoları
Niyet tanıma
Niyet tanıma düğümü öncelikle akış kontrolü içindir. Kullanıcı niyetini analiz etmek için büyük bir dil modeli kullanır ve sonuca göre yürütmeyi ilgili dala yönlendirir. Çoklu niyet yapılandırmasını ve konuşma geçmişini destekler.
-
Yapılandırma
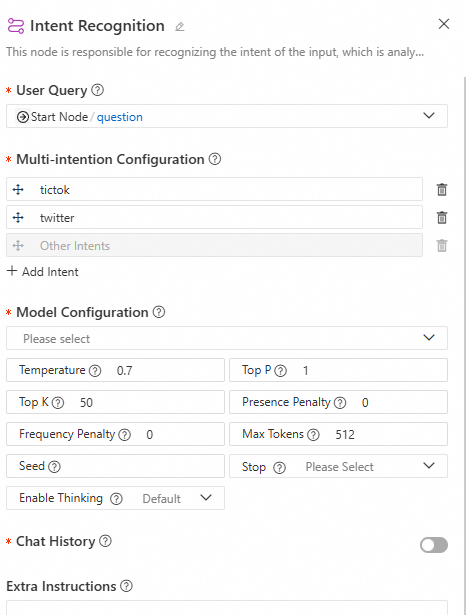
-
Giriş
Kullanıcı girişi: Niyet tanımada kullanılacak kullanıcı girişini seçin.
Çoklu niyet yapılandırması: Niyetleri gerektiği gibi ayarlayın; her niyetin açıklamasının net olduğundan ve farklı niyetler arasında anlamsal örtüşme olmadığından emin olun. Son niyet varsayılan olarak "Diğer"dir; başka hiçbir niyet uygulanmadığında eşleşir ve düzenlenemez.
Model ayarları: Niyet tanıma için büyük dil modelini yapılandırın. Daha iyi performans için qwen-max gibi daha yetkin bir model seçin.
Konuşma geçmişi: Etkinleştirildiğinde büyük dil modeli akıl yürütme sırasında uygulama akışının sohbet geçmişini otomatik olarak isteme ekler.
Ek istem: Modelin niyet tanımını daha doğru yapmasına yardımcı olmak için sistem istemine eklenir.
-
Çıktı
Bu düğüm çıktı üretmez.
-
Kullanım örneği
Niyet tanıma düğümünü aşağı akış düğümlerine bağlarken her niyet dalının düğümde karşılık gelen bir bağlantı noktası bulunur. Bir niyet tanındığında o dala bağlı aşağı akış düğümleri yürütülür, diğer dallardaki düğümler atlanır. Her daldan gelen yürütme sonuçlarını toplamak için ardından bir Değişken toplayıcı düğümü kullanabilirsiniz.
Ajan
Ajan düğümü, büyük bir dil modelinin (LLM) planlama yapmasını, araç seçmesini ve özerk hareket etmesini sağlar. Akıl yürütme stratejilerini ve araç kullanma yeteneklerini destekler. FunctionCalling ve ReAct gibi stratejileri entegre ederek LLM'nin çalışma zamanında Model Bağlam Protokolü (MCP) uyumlu araçları özerk şekilde çağırmasını ve çok adımlı akıl yürütmeyi gerçekleştirmesini mümkün kılar.
Düğüm parametreleri
-
Ajan stratejisi: İstenen ajan akıl yürütme stratejisini seçin. Şu anda FunctionCalling ve ReAct stratejileri desteklenmektedir.
FunctionCalling
Bu özellik, OpenAI Chat API'sinden yapılandırılmış
tool calltanımına (JSON formatında) dayalı olarak Büyük Dil Modeli (LLM) ile harici araçlar arasında etkileşim kurmayı sağlar. LLM kullanıcının doğal dil talimatlarını analiz ederek niyeti otomatik olarak belirler, uygun aracı seçer ve parametreleri ayıklar. Sistem ardından ilgili aracı çağırır ve sonucu modele döndürerek daha ileri akıl yürütme yapmasını ve nihai yanıtı oluşturmasını sağlar.Kullanım senaryoları ve avantajları:
Yapılandırılmış çağrılar, güçlü uyumluluk: Araç adlarını ve çağrı parametrelerini açıkça tanımlamak için yapılandırılmış veriler kullanır; bu sayede araç çağrısını destekleyen tüm modellerle uyumludur.
Kararlı performans: Hava durumu kontrolü, bilgi arama veya veri sorgulama gibi hedefleri net ve adımları iyi tanımlanmış görevler için uygundur.
ReAct
ReAct (Reasoning + Acting), modeli Thoughts (Düşünceler) ve Actions (Eylemler) açıkça üretmeye yönlendiren istemleri kullanan esnek bir akıl yürütme stratejisidir; bu sayede çok adımlı akıl yürütme ve araç çağrıları için kapalı bir döngü oluşturur. Bu strateji genellikle çağrı sürecini tanımlamak için doğal dil kullanır. "Action=xxx, Action Input=xxx" gibi metinler çıktılararak arka uçta araç yürütmeyi tetikler ve sonuçları modelin akıl yürütme zincirine geri enjekte eder. Bu yöntem API düzeyinde
tool_callsgerektirmez; bu da onu daha genel modeller ve çerçeveler için uygun hale getirir.Kullanım senaryoları ve avantajları:
Gelişmiş akıl yürütme yeteneği: Modeli adım adım düşünmeye yönlendirir; her adım akıl yürütme mantığını açıkça ifade eder.
Şeffaf strateji: Güçlü hata ayıklama ve yorumlanabilirlik gerektiren ajan uygulamaları için idealdir.
Tool Calling desteği gerekmez: Yapılandırılmış çıktıyı desteklemeyen modellerle bile kullanılabilir.
Model ayarları: FunctionCalling stratejisi yerel olarak araç çağrısını destekleyen bir model gerektirir. ReAct stratejisinin bu sınırlaması yoktur ancak güçlü akıl yürütme yeteneklerine sahip bir model seçmenizi öneririz.
Konuşma geçmişi: Konuşma geçmişini etkinleştirmek ajana bağlamsal bellek sağlar. Sistem geçmiş konuşma mesajlarını otomatik olarak isteme dahil eder; böylece ajan konuşmanın önceki kısımlarını anlayabilir ve bunlara başvurabilir. Örneğin konuşma geçmişi etkinleştirilmiş bir ajan kullanıcının bilgileri tekrarlamasına gerek kalmadan zamirleri ("o" veya "bu" gibi) çözebilir.
Görev planlama: Etkinleştirildiğinde sistem ajanın kullanabileceği araçlara yerleşik
write_todosaracını otomatik olarak ekler. Karmaşık kullanıcı soruları için ajanwrite_todosaracını otomatik olarak çağırarak görevi planlar ve adım adım yürütür; planı en son bilgilere göre dinamik olarak günceller.MCP araçları ve araçlar: Hem MCP hem de MCP dışı araçların yapılandırılmasını destekler. Daha fazla bilgi için bakınız: Ajan için araçları yapılandırma.
-
İstem yapılandırması
Giriş Değişkenleri: Bir uygulama akışının yukarı akış düğümünden gelen bir değişkeni istemde referans almak istediğinizde mevcut düğümde karşılık gelen bir giriş değişkeni tanımlamanız ve değerini yukarı akış düğümünün değişkenine başvuru olarak ayarlamanız gerekir. Ardından aşağıdaki İstem bölümünde çift süslü parantezlerle (
{{}}) belirtilen Jinja2 şablon sözdizimini kullanarak bu tanımlı giriş değişkenlerine başvurabilir ve dinamik veri aktarımını etkinleştirebilirsiniz.Sistem istemi: Ajanın görev hedeflerini ve bağlamını belirtmek için kullanılır; modele yanıt oluşturmasını yönlendirmek için gerekli arka planı sağlar. ReAct stratejisi için isteğe bağlıdır.
Kullanıcı istemi: Kullanıcının girdisini veya sorgusunu alır; bu modelin yanıt oluşturması için temel teşkil eder.
-
Döngü sayısı: Ajanın maksimum yürütme döngüsü sayısını 1 ile 99 arasında ayarlar. Ajan aşağıdaki koşullardan biri karşılanana kadar yanıt üretmek için görevi tekrarlar:
LLM eksiksiz bir sonuç oluşturmak için araçları çağırarak yeterli bilgi topladığına karar verir.
Ayarlanan maksimum döngü sayısına ulaşılır.
Makul bir döngü sayısı ayarlamak yanıt bütünlüğü ile yürütme verimliliği arasında denge kurmanıza yardımcı olur. Görev planlama etkinleştirildiyse modelin tüm adımları plandaki gibi tam olarak yürütebilmesini sağlamak için varsayılan maksimum döngü sayısını kullanmanızı öneririz.
-
Çıktı değişkenleri:
intermediate_steps: Ajanın yürütme ara adımlarını içeren bir dize.
text: Ajanın nihai çıktısını içeren bir dize.
İzlemeler ve günlükler
Uygulama akışı sayfasının sağ üst köşesindeki Run öğesine tıkladıktan sonra açılan iletişim kutusunda çalıştırma sonucunun altında izlemeyi veya günlüğü görüntüleyebilirsiniz.
Ara çıktıyı görüntüleyin: İş akışındaki Ajan düğümünün sağ üst köşesindeki çalıştırma durumu simgesine tıklayın. Alt taraftaki çekmecede Çıktı bölümünde
intermediate_stepsöğesini bulup ajanın akıl yürütme sürecini görüntüleyin.İzlemeyi görüntüleyin: Mevcut çalıştırmanın izleme bilgilerini görüntüleyerek modelin her isteği için ajanın girdi ve çıktısını (araç çağrıları ve istek parametreleri dahil), token maliyetlerini ve geçen süreyi anlayın.
Günlüğü görüntüleyin: Bir uygulama akışı hatayla karşılaşırsa düğüm yürütme süreci hakkında daha fazla ayrıntı almak için mevcut çalıştırma günlüğünü görüntüleyebilirsiniz.
Ek olarak uygulama akışı sayfasının sağ üst köşesindeki Run düğmesinin sağındaki simgeye tıklayarak Çalıştırma Geçmişini görüntüleyebilirsiniz. Belirli bir çalıştırma kaydını seçip izlemesini veya günlüğünü görüntüleyin.
Belge ayrıştırma
Sistemin yerleşik akıllı belge ayrıştırıcısını ve AI Search Open Platform belge ayrıştırma hizmetlerini kullanmayı destekler.
Yerleşik ayrıştırıcı: PDF, DOCX, PPTX, TXT, HTML, CSV, XLSX, XLS, JSONL ve MD dahil çeşitli yaygın belge formatlarını destekleyerek belgelerden yapılandırılmış içerik ve meta verileri ayıklar.
AI Search Open Platform: Başlıklar ve paragraflar gibi mantıksal hiyerarşi bilgilerinin yanı sıra metin, tablo ve resim gibi içeriklerin ayıklanmasını destekleyen yüksek hassasiyetli yapılandırılmış belge ayrıştırma sağlar. Bu yaklaşım belge çıkarma etkinliğini ve doğruluğunu artırır. Önce bir AI Search Open Platform model hizmeti bağlantısı yapılandırmanız gerekir. Desteklenen dosya formatları PDF, DOCX, PPTX, TXT ve HTML'dir.
Bu araç RAG, özetleme ve soru yanıtlama senaryolarını destekler. Yapılandırma arayüzü aşağıdaki gibidir: 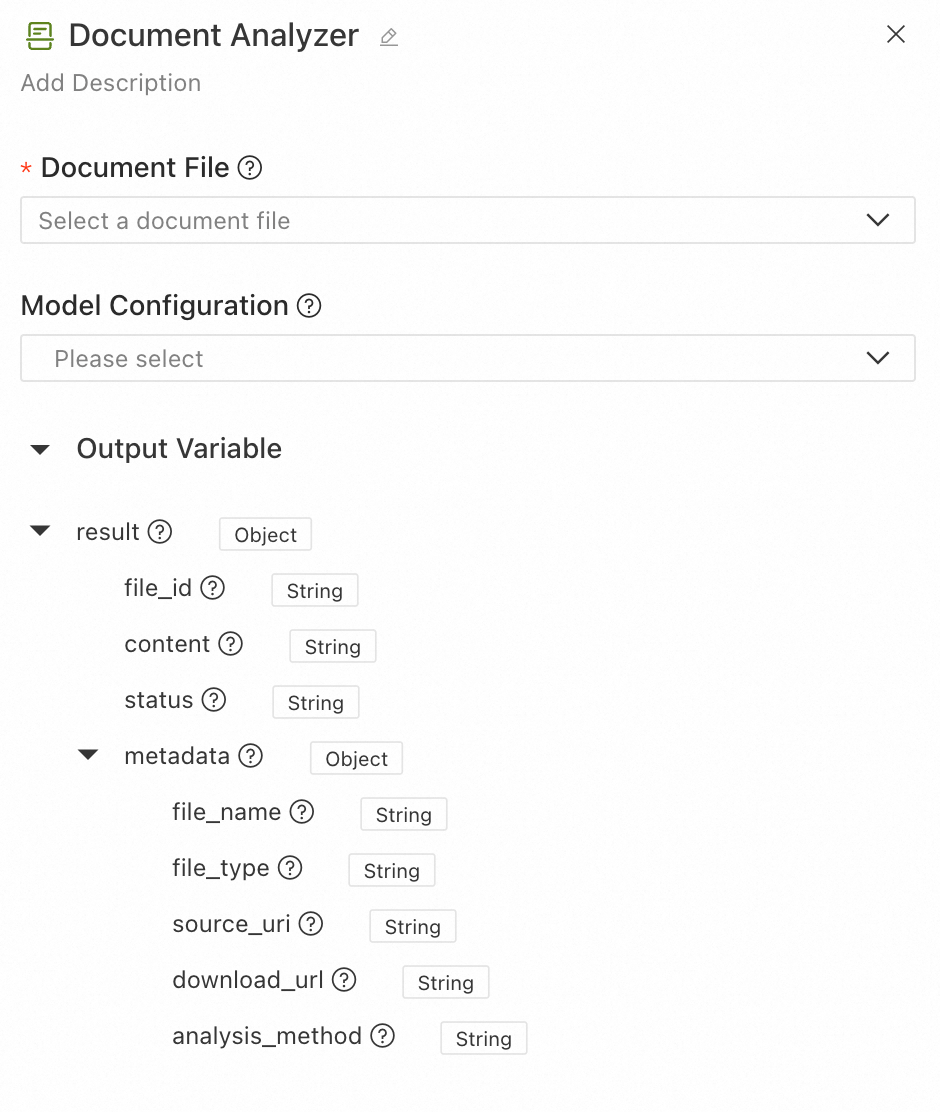
Belge dosyası: Ayrıştırılacak belge dosyası. Yukarı akış düğümden bir dosya türü alanı seçin.
Model ayarları: (İsteğe bağlı) LangStudio'da önceden oluşturulmuş bir AI Search Open Platform model hizmeti bağlantısı seçin. Yapılandırılmazsa sistem varsayılan olarak yerleşik temel ayrıştırma yöntemini kullanır.
-
Çıktı:
file_id: Giriş dosyasının benzersiz tanımlayıcısı.
content: Ayrılmış yapılandırılmış metin içeriği; başlıklar ve paragraflar gibi hiyerarşik bilgileri içerir.
status: Ayrıştırma durumu; SUCCESS veya FAIL olabilir.
-
metadata: Belgenin meta verileri ve ayrıştırma ayrıntıları.
file_name: Dosyanın adı.
file_type: Dosyanın türü.
source_uri: Dosyanın orijinal URI'si.
download_url: Dosyanın indirilebilir URL'si.
analysis_method: Kullanılan ayrıştırma yöntemi. "opensearch", AI Search Open Platform kullanılarak yapılan yapılandırılmış ayrıştırmayı; "builtin" ise yerleşik temel ayrıştırma yönteminin kullanımını gösterir.
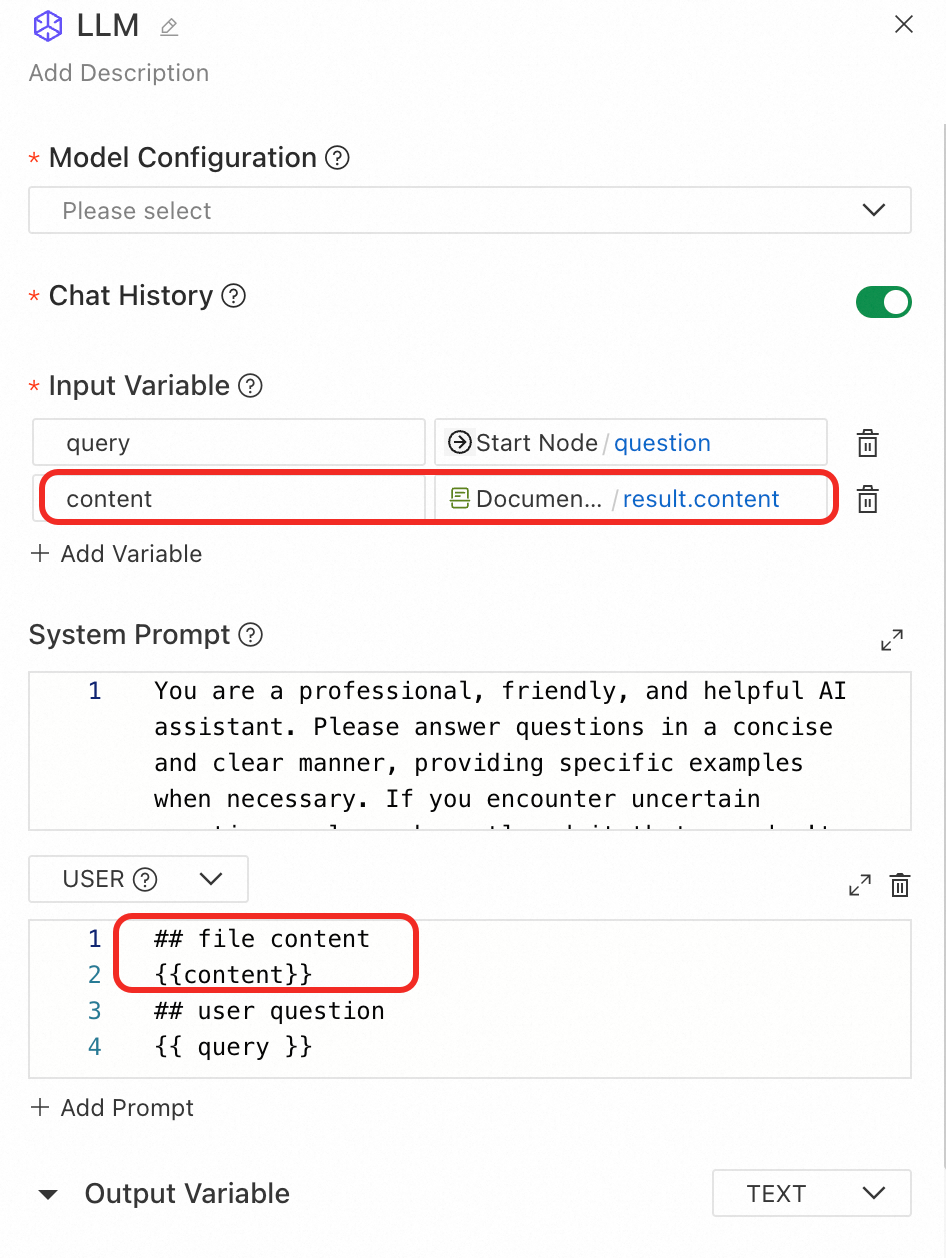
Aşağı akış kullanım örneği: Aşağı akış düğümlerinde belge ayrıştırma düğümünün sonuç alanlarına gerektiği gibi başvurun. Belge ayrıştırma sonuçlarını bir LLM düğümünde kullanmak için aşağıda gösterildiği gibi ayrılmış içeriği kullanıcı istemine dahil edebilirsiniz:
Konuşma tanıma
Ses veya video dosyalarını metne dönüştürmek için Konuşma tanıma düğümünü kullanın. Birden çok ses formatını ve dil tanımayı destekler.
Giriş
Model ayarları: Konuşma tanıma modelini yapılandırın. Şu anda Alibaba Cloud Model Studio tarafından sağlanan konuşma tanıma hizmeti desteklenmektedir. Daha iyi tanıma performansı ve çok dilli destek için
paraformer-v2kullanmanızı öneririz.Ses/video dosyası: Tanınacak ses veya video dosyasını seçin. Desteklenen formatlar için bakınız: Dosya türü girdisi ve çıktısı.
Tanıma Dili: Ses tanıma için dili belirtir. Desteklenen diller Çince, İngilizce, Japonca, Kantonca, Korece, Almanca, Fransızca, Rusça veya otomatik algılamadır. Not: Bu özellik yalnızca
paraformer-v2modeli tarafından desteklenir. Diğer modeller varsayılan olarak otomatik dil algılamasını kullanır.
Çıktı
file_id: Giriş dosyasının benzersiz tanımlayıcısı.
status: Tanıma durumu. Olası değerler
SUCCESSveyaFAIL'dur.content: Aktarılan metin içeriği.
segments: Zaman damgaları, metin parçaları ve diğer ayrıntıları içeren cümle fragmenti bilgilerinin listesi.
-
metadata: Dosyanın meta verileri; şunları içerir:
file_name: Dosyanın adı.
file_type: Dosyanın türü.
source_uri: Dosyanın URI'si.
download_url: Dosyanın indirme URL'si.
Veri alımı
Aşağıdaki düğümleri yapılandırmak için bakınız: Veri alımı düğümü
Bilgi bankası alımı
Alibaba Cloud IQS - web araması
SerpAPI - genel arama
HTTP isteği
Veri işleme
Python geliştirme (Python)
Uygulama akışları karmaşık veri işleme için özel Python kodu içeren düğümleri destekler. Bu düğümler akışlı girdi ve çıktıyı destekler. Yapılandırma sayfası aşağıdaki gibidir:
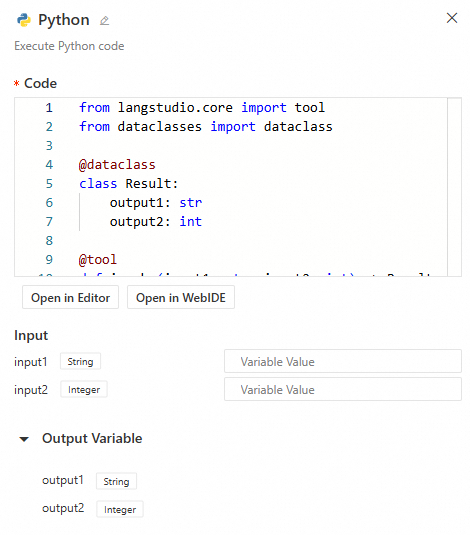
Python kodunu doldurmanız yeterlidir. Girdiler ve çıktılar koddan otomatik olarak ayrıştırılır. Aşağıdaki hususlara dikkat edin:
-
Giriş fonksiyonu düğüm olarak yüklenebilmesi için
@tooldekoratörüyle işaretlenmelidir.NotBir Python düğümü için akışlı girdiyi etkinleştirmek üzere
@tool(properties={"streaming_pass_through": True})yapılandırmanız gerekir. Aksi takdirde LLM gibi kaynaklardan Python düğümüne gelen girdiler akış yerine tam çıktı metni olur. Fonksiyon aşağıdaki girdi/çıktı türlerini destekler: int, float, bool, str, dict, TypedDict, dataclass (yalnızca çıktı), list ve File.
-
Giriş fonksiyonunun parametreleri düğümün girdileri olarak dinamik şekilde ayrıştırılır. Çıktı bir
outputsözlüğüne yerleştirilir ve diğer düğümler tarafından referans alınabilir.ÖnemliBir Python düğümünün girdi ve çıktı parametrelerinin otomatik ayrıştırılması çalışma zamanına bağlıdır. Çalışma zamanı başlatılmamışsa düğümün girdi ve çıktı bilgilerini yapılandıramazsınız.
-
Python kodunuz bağımlılıklar gerektiriyorsa tuvalin sağ üst köşesindeki Install Dependencies seçeneğini belirleyin ve gerekli paketleri girin.
requirements.txtdosyası uygulama akışıyla birlikte kaydedilir. Bağımlılıklar çalışma zamanını başlattığınızda veya hizmeti dağıttığınızda yüklenir.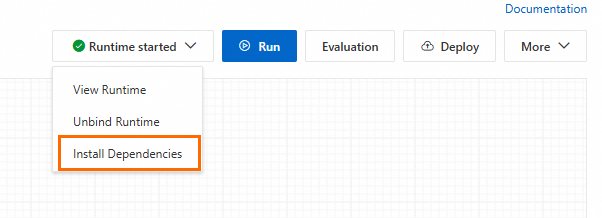
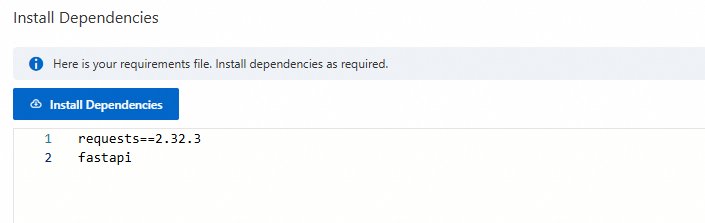
Kullanım senaryosu 1: Kod alanına aşağıdaki kodu girin. Kod düğümün girdilerine ve çıktılarına eşlenir:
from langstudio.core import tool
from dataclasses import dataclass

@dataclass
class Result:
    output1: str
    output2: int

@tool
def invoke(foo: str, bar: int) -> Result:
    return Result(
        output1="hello" + foo,
        output2=bar + 10
    )
Kullanım senaryosu 2: Akışlı girdi ve çıktı. Bir LLM veya ajan düğümünden gelen düşünce süreçlerini içeren bir metin akışını kırpmak için bir Python düğümü kullanın. <think>\n\n</think> bölümü içindeki içeriği atarak sonucun nihai metin akışını elde edebilirsiniz. Aşağıda bir örnek verilmiştir:
import re
from typing import Iterator
from langstudio.core import tool

@tool(properties={"streaming_pass_through": True})
def strip_think(
    stream: Iterator[str],
) -> Iterator[str]:  # The input is a streaming string iterator, and the output is a filtered streaming string iterator.
    # Match the <think>\n...\n</think> structure and capture the text after the closing tag.
    pattern = re.compile(r"<think>\n[\s\S]*\n</think>(.*)")
    in_thinking = True  # Flag to indicate if the current position is inside a <think> block.
    think_buf = ""      # Buffer to store unprocessed content.

    for chunk in stream:
        if in_thinking:
            think_buf += chunk
            m = pattern.search(think_buf)  # Check if the buffer contains a complete thought block.
            if m:
                in_thinking = False
                result_part = m.groups()[0]
                if result_part:
                    yield result_part  # If the result text exists, yield it immediately.
        else:
            yield chunk  # After exiting the thought block, directly yield all subsequent chunks.
Şablon dönüşümü
Şablon dönüşümü aracı esnek metin biçimlendirme ve veri dönüşümü sağlamak için Jinja2 şablon sözdizimini kullanır.
Giriş
Dönüşüm modu Jinja2 modu ve Düğüm referans modunu destekler.
-
Jinja2 modu: Çıktı formatını özelleştirmek için tam Jinja2 şablon sözdizimini kullanır. Bu mod karmaşık yapılandırılmış çıktılar, koşullu mantık ve döngüsel render işlemleri için uygundur.
-
Şablon değişkenleri: Şablonda kullanılan değişkenleri tanımlayın.
ÖnemliDeğişken adları
items,keysveyavaluesgibi Python yerleşik metod adları olamaz.item_listveyaproduct_listgibi belirli alan adları kullanın. -
Şablon içeriği: Jinja2 sözdizimiyle yazılmış bir şablon dizesidir. Değişken değiştirme
{{ variable }}, döngüler{% for %}, koşullu ifadeler{% if %}ve filtreler{{ value | filter }}dahil tam sözdizimini destekler.ÖnemliŞablonda referans verilen tüm değişkenler değişken listesinde tanımlanmalıdır. Aksi takdirde hata oluşur.
-
-
Düğüm referans modu: Yukarı akış düğümlerin çıktısına doğrudan başvurur ve bunları otomatik olarak bir dizede birleştirir. Bu mod basit metin birleştirme senaryoları için uygundur.
Şablon içeriği: Yukarı akış düğümlerin çıktı alanlarını seçin. Sistem bunları sırayla otomatik olarak birleştirir.
Çıktı
output: Şablon render edildikten sonraki metin sonucu. Not: Hem girdi hem de çıktı şablon içeriğinin uzunluğu 100.000 karakterle sınırlıdır. Bu sınırı aşan içerik kısaltılır.
Kullanım örnekleri
Örnek 1: Sipariş onay e-postası oluşturma
Değişken yapılandırması:
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Şablon içeriği:
Dear {{ customer_name }}:

Your order {{ order_id }} has been confirmed. The details are as follows:

{% for product in products %}
- {{ product.name }}: ¥{{ product.price }}
{% endfor %}

Total: ¥{{ total }}

Thank you for your purchase!
Çıktı sonucu:
Dear John Doe:

Your order ORD-2025-001 has been confirmed. The details are as follows:

- Laptop: ¥8999
- Wireless Mouse: ¥199

Total: ¥9198

Thank you for your purchase!
Örnek 2: Bilgi bankası alım sonuçlarını biçimlendirme
Değişken yapılandırması:
|
|
|
|
|
|
Şablon içeriği:
{% for chunk in chunks %}
### Relevance: {{ "%.2f" % chunk.score }}
#### {{ chunk.title }}
{{ chunk.content }}
---
{% endfor %}
Çıktı sonucu:
### Relevance: 0.95
#### Product Introduction
This is a detailed introduction to the product...
---
Liste işlemleri
Liste işlemleri aracı ince taneli veri işleme ve seçim için çeşitli liste veri türlerinde esnek filtreleme ve sıralama yapmanızı sağlar.
Giriş
Giriş listesi: İşlenecek liste verisi. Dizeler, sayılar, Boole değerleri, dosya nesneleri ve sözlükler gibi herhangi bir alt türü destekler.
-
İşlemler: Sırayla yürütülen zincirleme işlemler dizisi. Filtreleme ve sıralama olmak üzere iki işlem türünü destekler.
-
Filtre işlemi (filter): Filtre işlemi giriş listesinin türüne göre dinamik olarak farklı filtreleme yöntemleri sağlar. Not: Tüm filtre işlemleri büyük/küçük harfe duyarlıdır.
Filtre anahtarı
Açıklama
Kapsam
Dizin
Öğenin listedeki konumuna göre filtreler.
Tüm liste türleri için geçerlidir.
Öğe değeri
Öğenin kendi değerine göre filtreler.
Tüm liste türleri için geçerlidir.
Özel nitelik
Özel bir niteliğe göre filtreler.
Yalnızca sözlük listeleri için geçerlidir.
Dosya niteliği
Bir dosyanın niteliklerine göre filtreler.
Yalnızca dosya listeleri için geçerlidir.
-
Sıralama işlemi (sort): Sıralama işlemi giriş listesinin türüne göre farklı sıralama yöntemleri sağlar.
Sıralama anahtarı
Açıklama
Kapsam
Öğe değeri
Öğenin kendi değerine göre sıralar.
Yalnızca dize, sayı veya Boole listeleri için geçerlidir.
Özel nitelik
Özel bir niteliğe göre sıralar.
Yalnızca sözlük listeleri için geçerlidir.
Dosya niteliği
Bir dosyanın niteliklerine göre sıralar.
Yalnızca dosya listeleri için geçerlidir. Kullanılabilir nitelikler filtre işlemiyle aynıdır.
-
Çıktı
result: İşlenmiş liste sonucu.
first_item: Sonuç listesinin ilk öğesi. Liste boşsa değer
Noneolur.last_item: Sonuç listesinin son öğesi. Liste boşsa değer
Noneolur.
Kullanım örnekleri
Örnek 1: Dosya sınıflandırma - Resim dosyalarını filtreleyin, dosya adı uzunluğuna göre sıralayın ve ilk 3'ü alın
Senaryo: Bir kullanıcı çeşitli dosya türlerinden oluşan karışık bir liste yükler. Resim dosyalarını filtrelemeniz, bunları dosya adı uzunluğuna göre sıralamanız ve sonraki resim tanıma işleme için yalnızca ilk 3'ünü tutmanız gerekir.
İşlem yapılandırması:
Operation 1 - Filter (by file category):
  Filter key: item.category
  Filter operator: equals
  Filter value: image

Operation 2 - Sort (by file name length):
  Sort key: item.file_name
  Sort direction: asc

Operation 3 - Filter (take top 3):
  Filter key: index
  Filter operator: less than
  Filter value: 3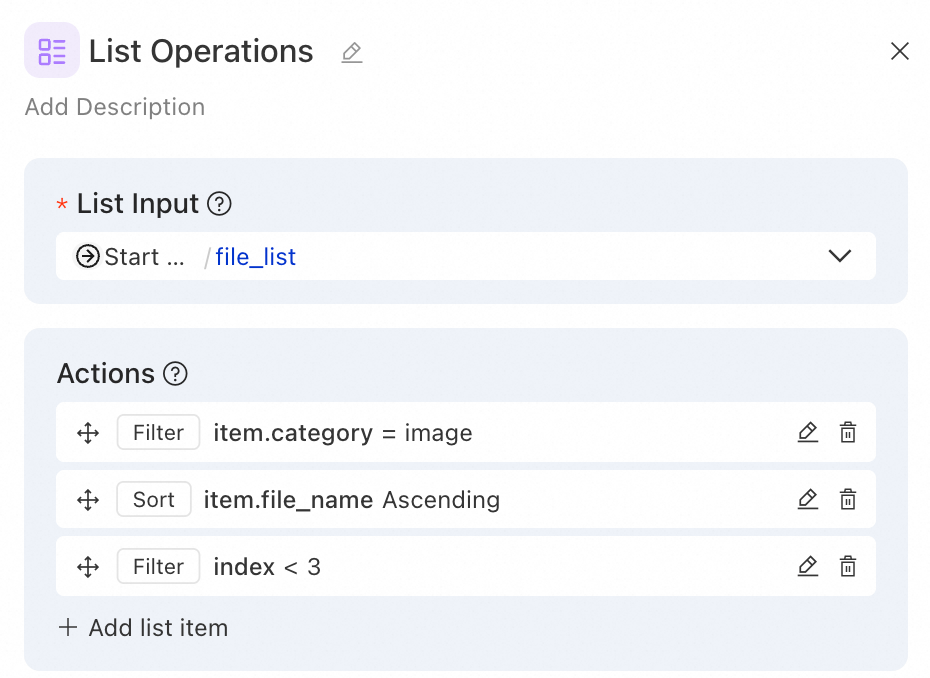
Örnek 2: Veri analizi - Yüksek puanlı kullanıcıları filtreleyin ve ilk 5'i alın
Senaryo: Kullanıcı derecelendirme listesinden puanı 80 veya üzeri olan kullanıcıları filtreleyin, bunları puana göre azalan sırada sıralayın ve ilk 5'i alın.
Giriş listesi:
[
  {"name": "Zhang San", "score": 95, "department": "Tech Dept"},
  {"name": "Li Si", "score": 72, "department": "Marketing Dept"},
  {"name": "Wang Wu", "score": 88, "department": "Tech Dept"},
  {"name": "Zhao Liu", "score": 91, "department": "Product Dept"},
  {"name": "Qian Qi", "score": 65, "department": "Marketing Dept"},
  {"name": "Sun Ba", "score": 98, "department": "Tech Dept"}
]
İşlem yapılandırması:
Operation 1 - Filter (high-scoring users):
  Filter key: item.score
  Filter operator: greater than or equal to
  Filter value: 80

Operation 2 - Sort (by score descending):
  Sort key: item.score
  Sort direction: desc

Operation 3 - Filter (take top 5):
  Filter key: index
  Filter operator: less than
  Filter value: 5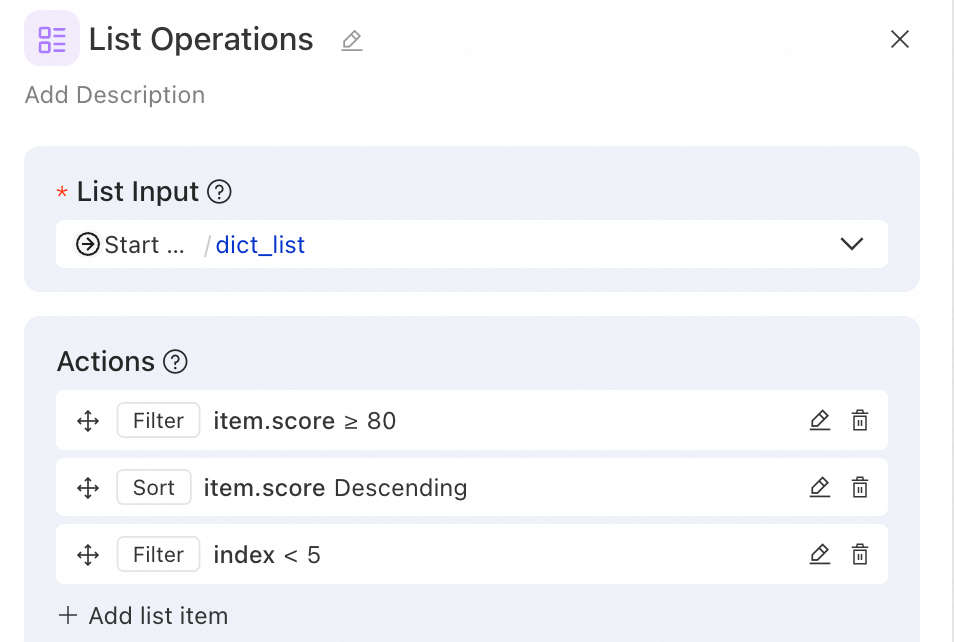
Çıktı sonucu:
[
  {"name": "Sun Ba", "score": 98, "department": "Tech Dept"},
  {"name": "Zhang San", "score": 95, "department": "Tech Dept"},
  {"name": "Zhao Liu", "score": 91, "department": "Product Dept"},
  {"name": "Wang Wu", "score": 88, "department": "Tech Dept"}
]
Notlar:
Aracın girdisi bir Python düğümünde özelleştirilmiş
listtürü çıktı değişkenine başvuruyorsa Python düğümünde liste için açık bir öğe türü tanımlayın; örneğinlist[str]. Bu sayede Liste işlemleri düğümünde operatör eşleşmeleri daha doğru olur.