LangStudio bilgi tabanları, OSS belgelerini retrieval-augmented generation (RAG) için kullanılacak vektör dizinlerine dönüştürür. Bir bilgi tabanını bir kez oluşturun ve birden fazla uygulama akışında yeniden kullanın.
Çalışma mekanizması
Bir bilgi tabanı, OSS dosyalarını üç adımda LLM tarafından getirilebilir içeriğe dönüştürür:
-
Veri okuma ve parçalama: OSS'den kaynak dosyaları okur ve işlenebilir birimlere böler.
Yapılandırılmamış belgeler ayrıştırılır ve daha küçük, anlamsal bütünlüğe sahip metin bloklarına (parçalara) bölünür.
Yapılandırılmış veriler satır bazında parçalanır.
Görüntüler, parçalanmadan bütün olarak işlenir.
Vektörleştirme: Her bir parçayı veya görüntüyü anlamsal anlamını temsil eden sayısal bir vektöre dönüştürmek için bir embedding modeli çağırır.
Depolama ve dizinleme: Vektör verilerini bir vektör veritabanında depolar ve getirme işlemi için bir dizin oluşturur.
Başlarken
Belge türünde bir bilgi tabanı oluşturun ve bunu bir uygulama akışında kullanın:
-
Bilgi tabanı oluşturun. LangStudio adresine gidin ve bir çalışma alanı seçin. Knowledge Base sekmesinde, Create Knowledge Base öğesini tıklayın. Aşağıdaki parametreleri yapılandırın ve OK öğesini tıklayın.
Parametre
Açıklama
Basic Configuration
Name
Bilgi tabanı için özel bir ad girin, örneğin
test_kg.Data Source OSS Path
Kaynak dosyaların depolandığı konum. Örneğin:
oss://examplebucket.oss-cn-hangzhou-internal.aliyuncs.com/test/original/.Output OSS Path
Ara ayrıştırma sonuçlarını ve dizin verilerini depolar. Nihai çıktı, seçilen vektör veritabanı türüne bağlıdır. Örneğin:
oss://examplebucket.oss-cn-hangzhou-internal.aliyuncs.com/test/output/.ÖnemliÇalışma zamanı için Instance RAM Role PAI varsayılan rolü ise, bu parametreyi geçerli çalışma alanı varsayılan depolama yolunun OSS paketindeki bir dizine ayarlayın.
Type
Document öğesini seçin.
Embedding Model and Database
Embedding Type
Alibaba Cloud Model Studio Service öğesini seçin (önce bir bağlantı oluşturun, bkz. Bağlantı Yapılandırması), ardından bağlantıyı ve modeli seçin.
Vector Database Type
Hızlı test için FAISS öğesini seçin.
-
Dosya yükleyin.
Knowledge Base sekmesinde, bilgi tabanını tıklayın. Overview sayfasında, Documents sekmesine geçin. Bu sekme, yapılandırılan OSS veri kaynağındaki belgeleri görüntüler.
-
Upload düğmesini kullanarak dosyalar ekleyin veya güncelleyin ya da dosyaları doğrudan OSS veri kaynağına yükleyin. Örneğin, sayfa üzerinden rag_test_doc.txt dosyasını yükleyin. Desteklenen dosya biçimleri için bkz. Bilgi Tabanı Türleri.

-
Dizini güncelleyin. Dosyaları yükledikten sonra, sağ üst köşede bulunan Update Index öğesini tıklayın. İletişim kutusunda hesaplama kaynaklarını ve ağı yapılandırın. Görev başarılı olduğunda, dosya durumu Indexed olarak değişir. Parçalarını önizlemek için bir dosyayı tıklayın. Görüntü bilgi tabanları için sistem görüntü listelerini döndürür.
NotMilvus'ta depolanan belge parçalarının durumunu tek tek Enabled veya Disabled olarak ayarlayın. Devre dışı bırakılan parçalar aramalar sırasında getirilmez.

-
Getirme testi çalıştırın. Dizini güncelledikten sonra, Recall Test sekmesine geçin. Performansı test etmek için bir sorgu girin ve getirme parametrelerini ayarlayın.

-
Uygulama akışında bilgi tabanını kullanın. Test ettikten sonra, bir uygulama akışından bilgi tabanındaki bilgileri getirin. Bilgi tabanı düğümünde, sorgu yeniden yazma ve sonuç yeniden sıralama özelliklerini etkinleştirin ve yürütme izinde yeniden yazılan sorguyu görüntüleyin.

Sonuç bir
List[Dict]şeklindedir. HerDictiçinde, getirilen parçayı ve sorguyla olan benzerlik puanını temsil edencontentvescoreanahtarları bulunur.[ { "score": 0.8057173490524292, "content": "Due to the uncertainty caused by the pandemic, XX Bank proactively increased provisions for impairment losses on loans, advances, and non-credit assets based on economic trends and forecasts for China or the Chinese mainland. The bank also increased the write-off and disposal of non-performing assets to improve the provision coverage ratio. In 2020, the net profit reached 28.928 billion CNY, a year-on-year increase of 2.6%, and profitability gradually improved.\n(CNY in millions) 2020 2019 Change (%)\nOperating Results and Profitability\nOperating Income 153,542 137,958 11.3\nOperating Profit Before Impairment Losses 107,327 95,816 12.0\nNet Profit 28,928 28,195 2.6\nCost-to-Income Ratio(1)(%) 29.11 29.61 down 0.50 percentage points\nAverage Return on Total Assets (%) 0.69 0.77 down 0.08 percentage points\nWeighted Average Return on Equity (%) 9.58 11.30 down 1.72 percentage points\nNet Interest Margin(2)(%) 2.53 2.62 down 0.09 percentage points\nNote: (1) Cost-to-Income Ratio = Business and management fees / Operating income.", "id": "49f04c4cb1d48cbad130647bd0d75f***1cf07c4aeb7a5d9a1f3bda950a6b86e", "metadata": { "page_label": "40", "file_name": "2021-02-04_XX_Insurance_Group_Co_Ltd_XX_China_XX_2020_Annual_Report.pdf", "file_path": "oss://my-bucket-name/datasets/chatglm-fintech/2021-02-04__XX_Insurance_Group_Co_Ltd__601318__China_XX__2020_Annual_Report.pdf", "file_type": "application/pdf", "file_size": 7982999, "creation_date": "2024-10-10", "last_modified_date": "2024-10-10" } }, { "score": 0.7708036303520203, "content": "7.2 billion CNY, a year-on-year increase of 5.2%.\n2020\n(CNY in millions) Life and Health Insurance Business, Property and Casualty Insurance Business, Banking Business, Trust Business, Securities Business, Other Asset Management Business, Technology Business, Other Business and Consolidation Elimination, Group Consolidated\nNet profit attributable to shareholders of the parent company 95,018 16,083 16,766 2,476 2,959 5,737 7,936 (3,876) 143,099\nMinority interest 1,054 76 12,162 3 143 974 1,567 281 16,260\nNet profit (A) 96,072 16,159 28,928 2,479 3,102 6,711 9,503 (3,595) 159,359\nItems excluded:\n Short-term investment fluctuation(1)(B) 10,308 – – – – – – – 10,308\n Impact of discount rate change (C) (7,902) – – – – – – – (7,902)\n One-time significant items and others excluded by management as not part of daily operating income and expenditure (D) – – – – – – 1,282 – 1,282\nOperating profit (E=A-B-C-D) 93,666 16,159 28,928 2,479 3,102 6,711 8,221 (3,595) 155,670\nOperating profit attributable to shareholders of the parent company 92,672 16,", "id": "8066c16048bd722d030a85ee8b1***36d5f31624b28f1c0c15943855c5ae5c9f", "metadata": { "page_label": "19", "file_name": "2021-02-04_XX_Insurance_Group_Co_Ltd_XXX_China_XX_2020_Annual_Report.pdf", "file_path": "oss://my-bucket-name/datasets/chatglm-fintech/2021-02-04__XX_Insurance_Group_Co_Ltd__601318__China_XX__2020_Annual_Report.pdf", "file_type": "application/pdf", "file_size": 7982999, "creation_date": "2024-10-10", "last_modified_date": "2024-10-10" } } ]
Özellikler
Bilgi tabanı türü
Dosyalarınıza uygun bilgi tabanı türünü seçin:
Documents:
.html,.htm,.pdf,.txt,.docx,.mdve.pptxdosyalarını destekler.Structured data:
.jsonl,.csv,.xlsxve.xlsdosyalarını destekler.Images:
.jpg,.jpeg,.pngve.bmpdosyalarını destekler.
Özel yapılandırmalar:
-
Document türündeki bilgi tabanları için Chunk Configuration öğesini yapılandırın. Bu alanlar gereklidir. Parçalama parametrelerinin ayarlanması hakkında rehberlik için bkz. Parçalama parametresiayarlaması.
Chunk Size: Metin parçası başına maksimum karakter sayısı. Varsayılan: 1024 karakter.
Chunk Overlap: Bağlamsal sürekliliği sağlamak için bitişik parçalar arasındaki örtüşen karakter sayısı. Varsayılan: 200 karakter.
Structured data türündeki bilgi tabanları için Field Settings öğesini yapılandırın. Dizinlemeye ve getirmeye katılacak veri alanlarını belirtmek için bir dosya (örneğin animal.csv) yükleyin veya alanları manuel olarak ekleyin.
Vektör veritabanı seçin
Üretim ortamları: Büyük ölçekli vektör veri işlemeyi destekleyen Milvus veya Elasticsearch kullanın.
-
Test ortamı: Ekstra veritabanı gerektirmeyen FAISS kullanın. Bilgi tabanı dosyaları ve oluşturulan dizin dosyaları Output OSS Path alanında depolanır. FAISS, işlevsel testler veya küçük veri kümeleri için uygundur ancak büyük veri hacimlerinde performans düşebilir.
NotImage türündeki bilgi tabanları FAISS'i desteklemez.
Dizin güncelleme stratejisi
|
Güncelleme yöntemi |
Açıklama |
Notlar |
|
Manuel güncelleme |
Konsolda Update Index öğesini tıklayın. Dosyaların nadiren değiştiği durumlarda en iyisidir. |
Dosyaları tam veya artımlı olarak işler. |
|
Otomatik güncelleme |
OSS dosyaları değiştiğinde dizinlemeyi tetikleyen bir EventBridge kuralı oluşturur. |
Önemli
Otomatik güncellemeler sırasında mesaj ücretleri tahakkuk eder.
|
|
Zamanlanmış güncelleme |
Dizini zamanlanmış olarak (örneğin günlük) güncellemek için bir DataWorks yinelenen görevi kullanır. |
DataWorks'e bağlıdır. Yinelenen görevler T+1 temeline göre etkili olur (bugün yapılan yapılandırmalar yarın çalışır). |
Yapılandırma yöntemleri:
Manuel güncelleme
Update Index öğesini tıklayın. Sistem, dosyaları ön işlemek, parçalamak, vektörleştirmek ve dizinlemek için bir PAI iş akışı görevi gönderir. Görev parametreleri:
|
Parametre |
Açıklama |
|
Hesaplama kaynağı |
İş akışı düğümleri için hesaplama kaynakları. Genel kaynakları kullanın veya kaynak kotaları aracılığıyla Lingjun kaynaklarını ve genel hesaplama kaynaklarını kullanın.
|
|
VPC yapılandırması |
Vektör veritabanına veya Embedding hizmetine dahili ağ üzerinden erişiyorsanız, seçilen VPC'nin bu hizmetlerin VPC'leriyle aynı olduğundan veya iletişim kurabildiğinden emin olun. |
|
Embedding yapılandırması |
|
Otomatik güncelleme
EventBridge konsoluna gidin ve EventBridge'i etkinleştirin.
Otomatik dizin güncellemelerini yapılandırın. Bilgi tabanı ayrıntıları sayfasına gidin. Overview sekmesinde, sağ alt köşedeki Automatic File Indexing bölümünde Modify öğesini tıklayın.
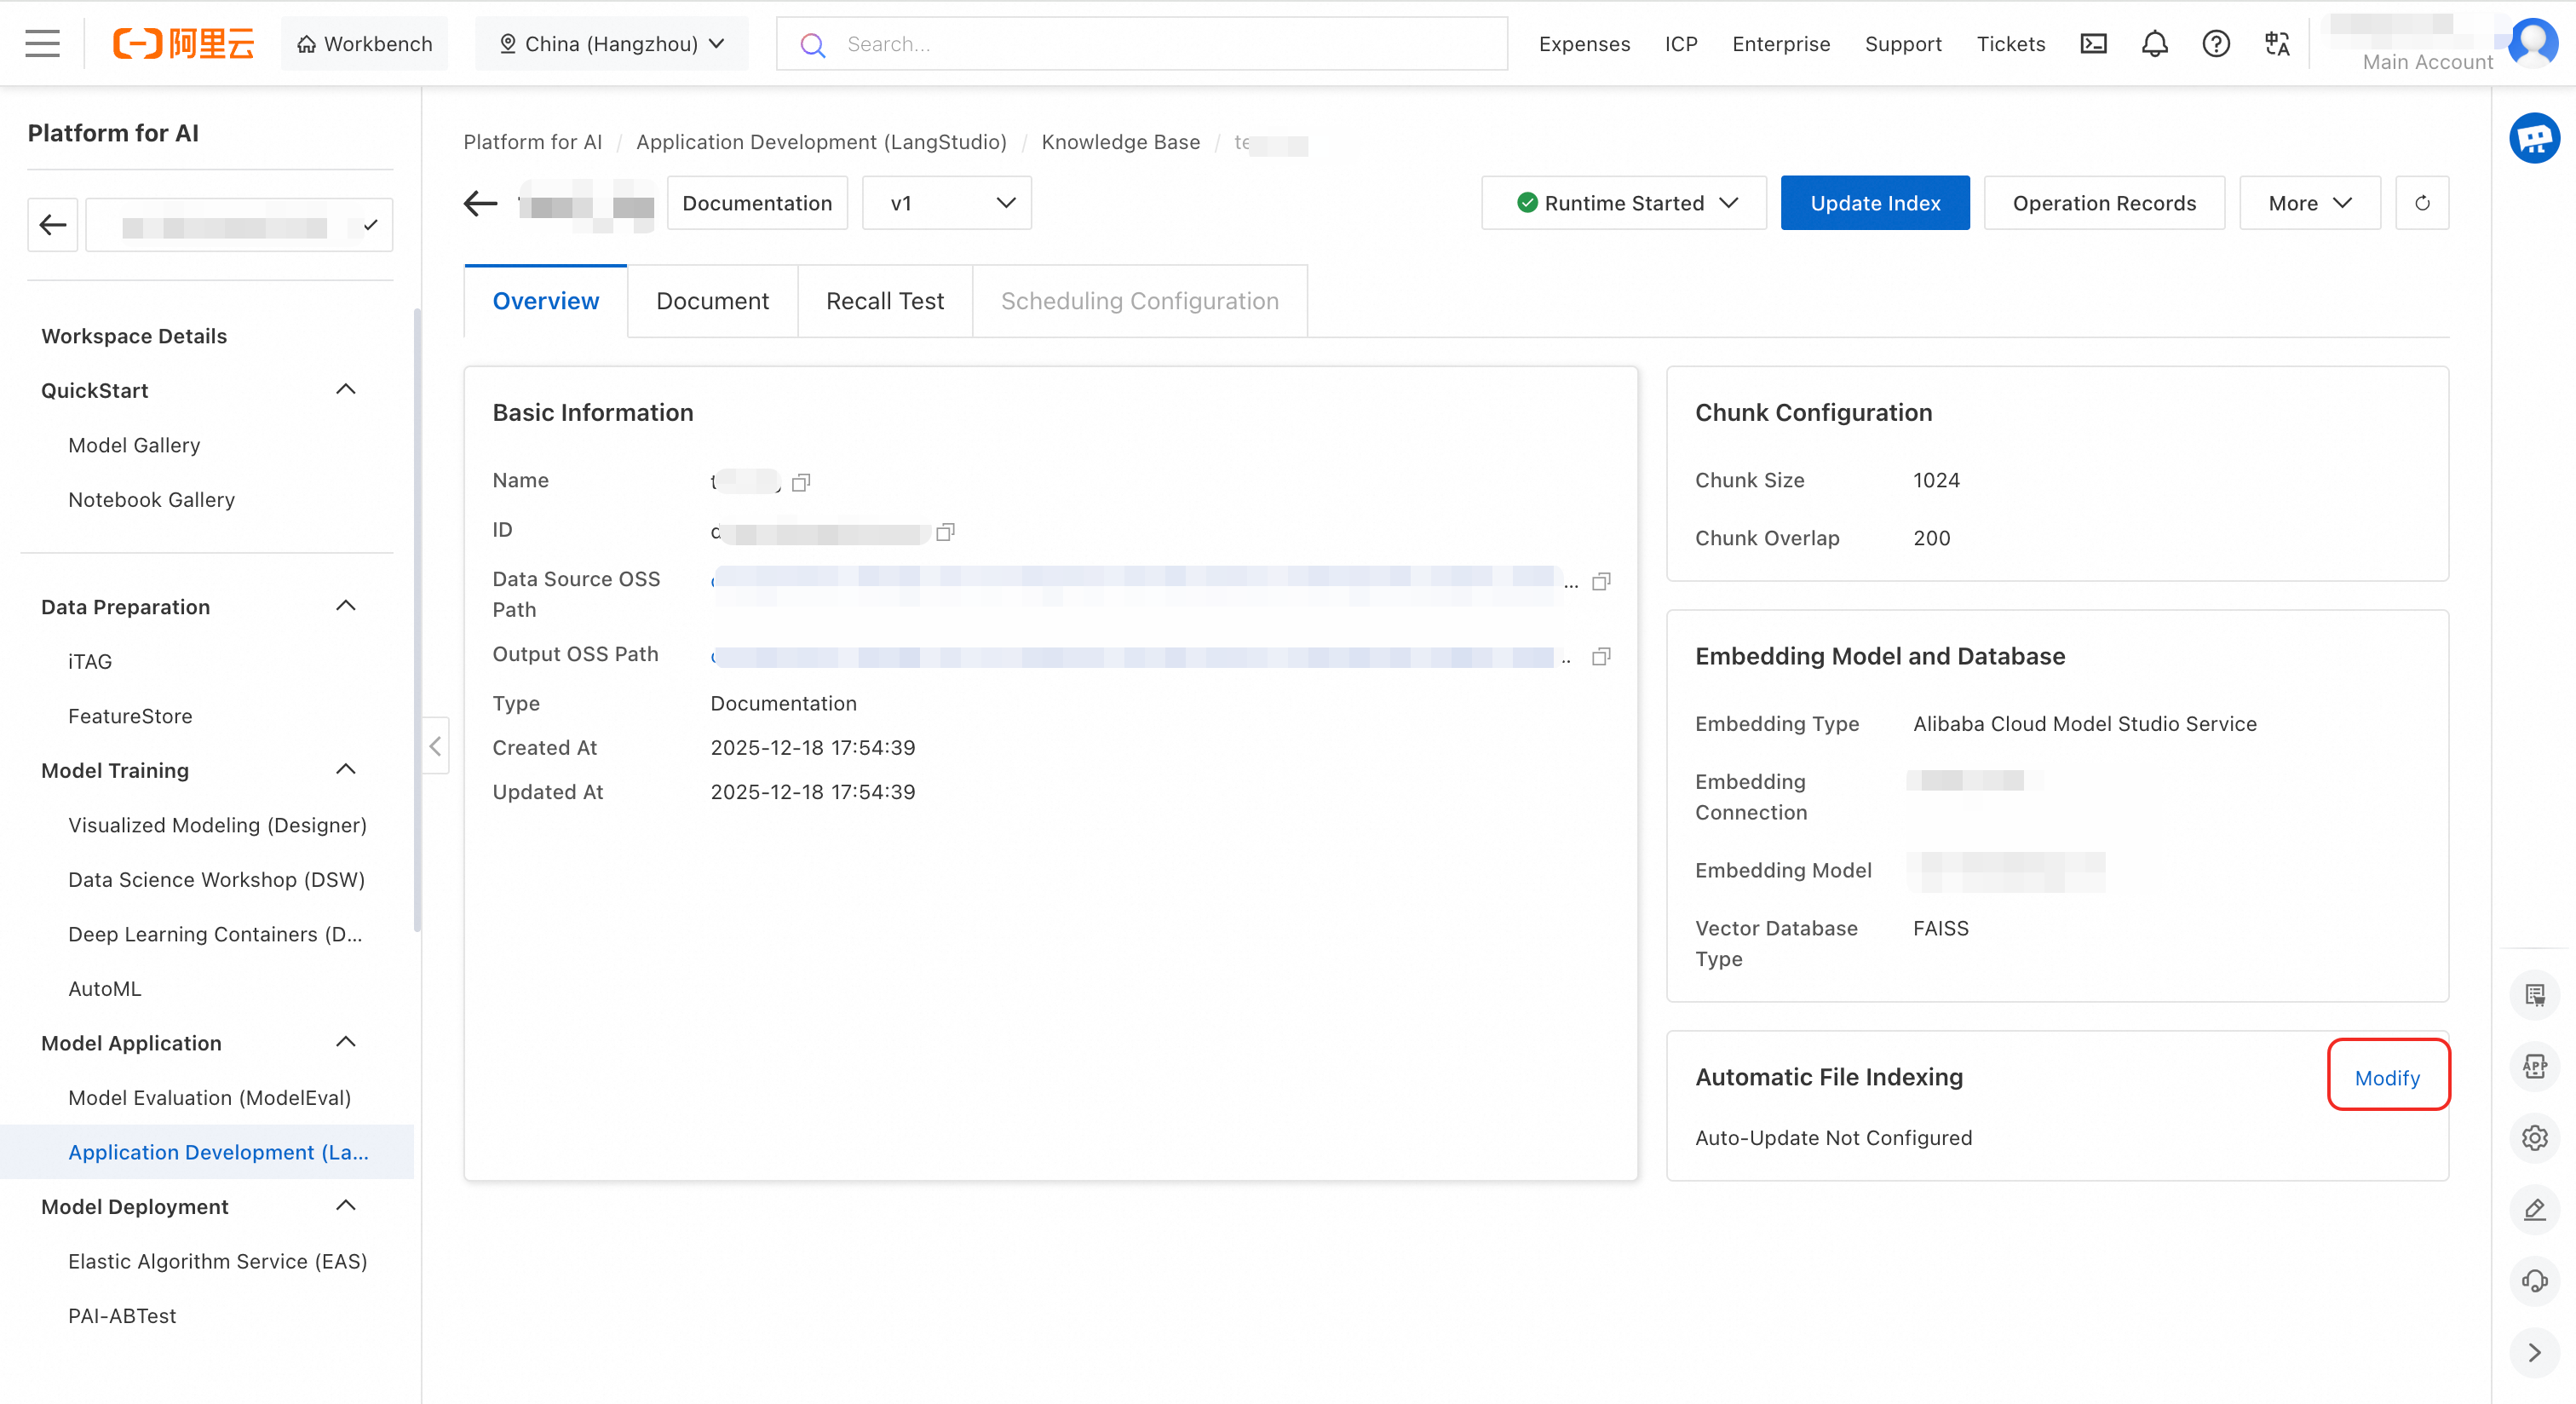
-
Hesaplama kaynaklarını ve VPC'yi yapılandırın, ardından OK öğesini tıklayın. Bundan sonra, dosya değişiklikleri manuel müdahale olmadan dizinleme görevlerini otomatik olarak tetikler.
ÖnemliBurada yapılandırılan hesaplama kaynakları yalnızca dosyalar güncellendiğinde kullanılır. Dosyalar değişmezse kaynak ücreti tahakkuk etmez.
-
OSS dosyalarında değişiklik yapın.
Otomatik dosya güncellemelerini yapılandırdıktan sonra, kuralların etkili olması için birkaç dakikalık bir gecikme olur. Dosyalar üzerinde işlem yapmadan önce en az 3 dakika bekleyin.
Bir dosyayı OSS API kullanarak silmek için, değişiklik olayını tetiklemek üzere bir sürüm belirtin.
-
Konsolda bir dosyayı silmek için dosyayı seçin ve alt kısımdaki Permanently Delete öğesini tıklayın.
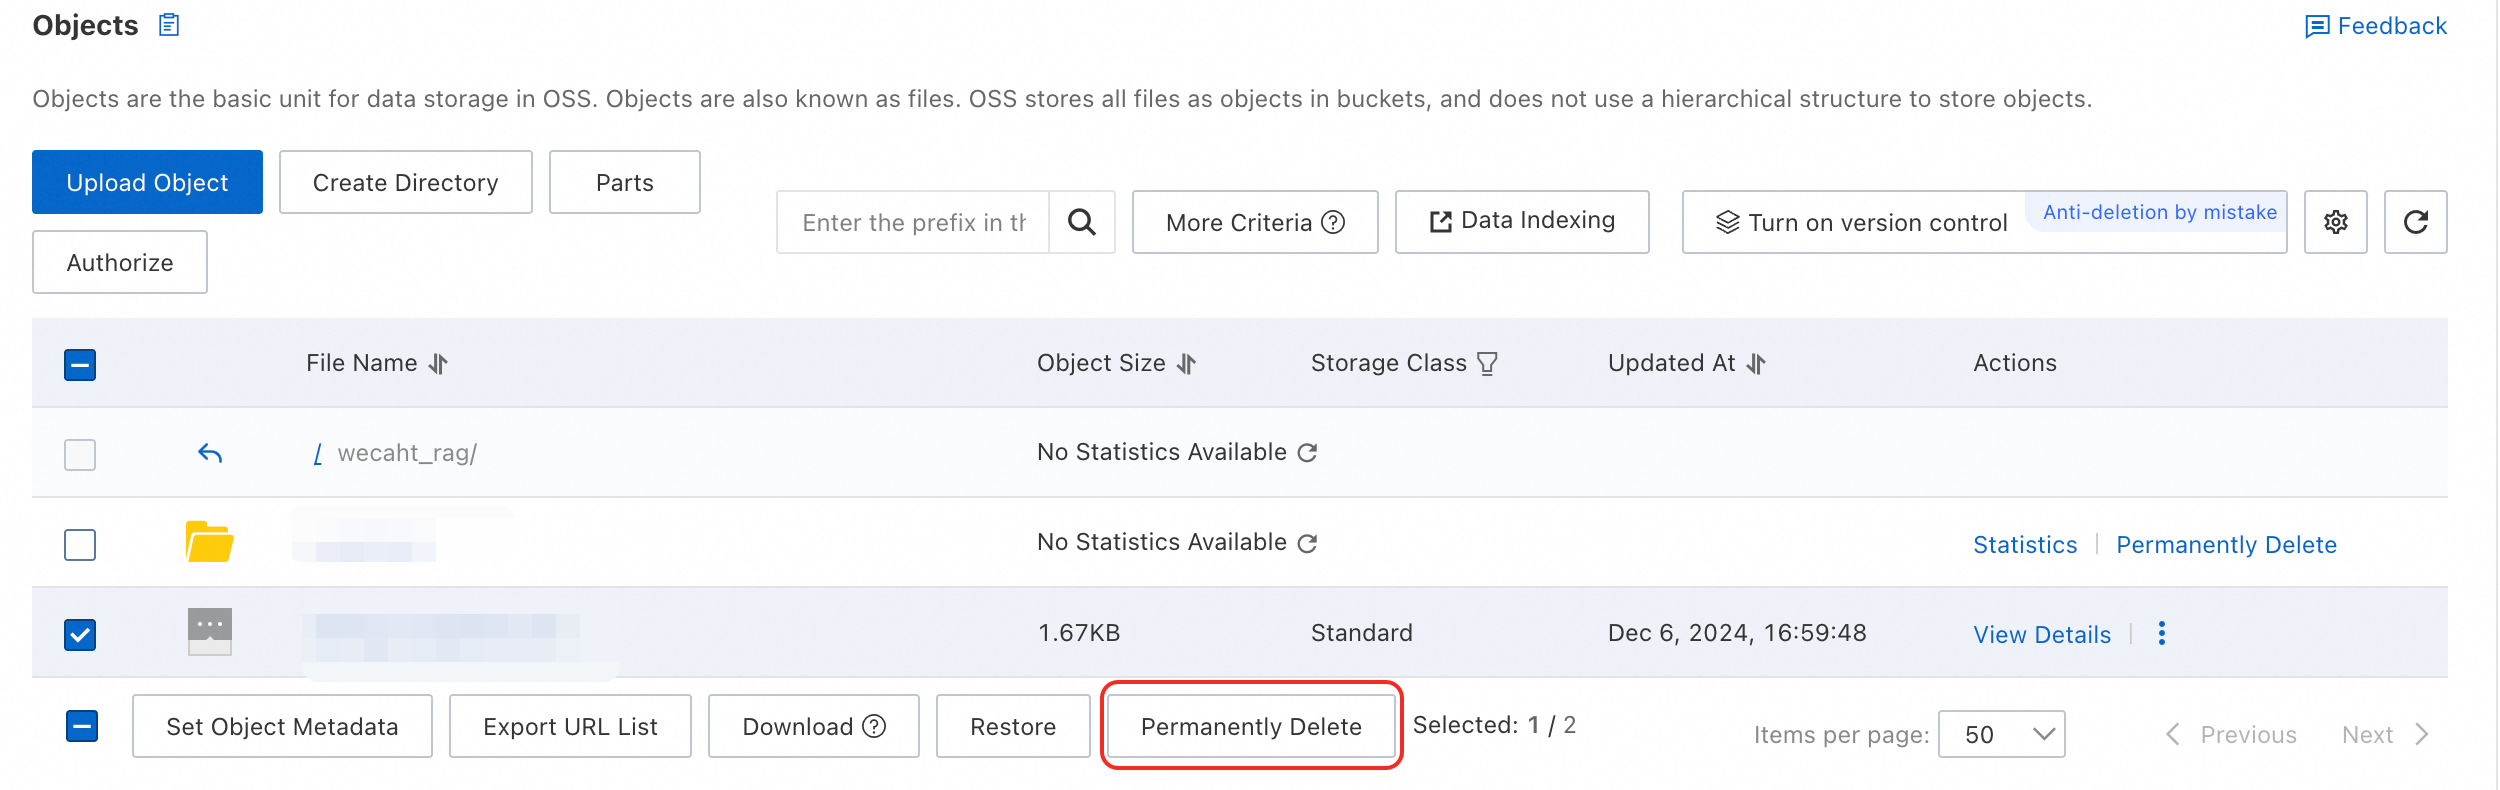
Dizinleme görevlerini görüntüleyin. Bir dosya değiştiğinde yaklaşık 3 dakika bekleyin. Otomatik olarak tetiklenen dizin oluşturma görevi, işlem kayıtları listesinde görünür.
Zamanlanmış güncelleme
Zamanlanmış güncelleme özelliği DataWorks'e bağlıdır. Bu hizmeti etkinleştirdiğinizden emin olun. Etkinleştirmediyseniz bkz. Satın alma kılavuzu.
Bilgi tabanı ayrıntıları sayfasında, sağ üst köşede bulunan öğesini tıklayın, yapılandırmaları tamamlayın ve gönderin.

-
Zamanlama yapılandırmalarını ve yinelenen görevleri görüntüleyin
Sistem, DataWorks DataStudio'da bir iş akışı oluşturur ve bunu DataWorks Operation Center'da yinelenen bir görev olarak yayımlar. Yinelenen görevler T+1 temeline göre etkili olur. Zamanlama yapılandırmasını bilgi tabanı zamanlama yapılandırması sayfasında görüntüleyin.

-
Zamanlanmış yapılandırma parametre açıklamaları:
Zamanlama döngüsü: Düğümün üretimde ne sıklıkla çalıştığı (oluşturulan döngü örneklerinin sayısı ve çalışma zamanları).
Zamanlanmış saat: Düğümün çalıştığı belirli saat.
Zaman aşımı tanımı: Çalışan bir düğümün başarısız olup çıkacağı süre.
Geçerlilik tarihi: Düğümün otomatik zamanlamasına göre çalıştığı zaman aralığı. Bu aralığın dışında, düğüm artık otomatik olarak zamanlanmaz.
-
Zamanlama kaynak grubu: DataWorks zamanlanmış güncellemeleri için kullanılır. Henüz bir DataWorks kaynak grubu oluşturmadıysanız, açılan listede Create Now öğesini tıklayarak oluşturma sayfasına gidin. Oluşturduktan sonra, kaynak grubunu geçerli çalışma alanına bağlayın.

Zamanlama parametreleri Zaman özelliği yapılandırma açıklaması bölümünde açıklanmıştır.
Veri kümesini görüntüleyin
Dizin güncellemesi başarılı olduktan sonra, sistem Output OSS Path alanını bir veri kümesi olarak kaydeder. Bunu AI Asset Management - Datasets alanında görüntüleyin. Veri kümesi, bilgi tabanı adını paylaşır ve dizin oluşturma çıktısını kaydeder.

Çalışma zamanını yapılandırın
Parçaları önizlemek ve getirme testlerini çalıştırmak için bir çalışma zamanı seçin. Bu işlemler vektör veritabanına ve Embedding hizmetine erişir.
Çalışma zamanı gereksinimleri:
Vektör veritabanına veya Embedding hizmetine dahili ağ adresi üzerinden erişiyorsanız, çalışma zamanı VPC'sinin bunlarınkiyle aynı olduğundan veya iletişim kurabildiğinden emin olun.
Instance RAM Role için özel bir rol seçerseniz, o role OSS erişim izinleri verin (
AliyunOSSFullAccessönerilir). RAM rolüne izin verme.
Çalışma zamanı sürümü eskiyse (2.1.4'ten önce), açılan listede görünmeyebilir. Yeni bir çalışma zamanı oluşturun.
Birden fazla sürümü yönetin
Test edilmiş bir bilgi tabanı sürümünü yeni bir resmi sürüm olarak klonlayarak geliştirme ve üretim ortamlarını yalıtır.
Bilgi tabanı ayrıntıları sayfasında türün yanındaki açılan menüyü kullanarak sürümler arasında geçiş yapın. Bir uygulama akışının bilgi tabanı düğümünde istediğiniz sürümü seçin.

Klonlama, işlem kayıtlarında görünen bir iş akışı görevi gönderir.

Getirme parametrelerini yapılandırın
Top K: Getirilecek maksimum ilgili parça sayısı. Aralık: 1 ila 100.
Puan eşiği: Benzerlik puanı eşiği (0 ila 1). Yalnızca bu değerin üzerinde puan alan parçalar döndürülür.
Retrieval Pattern: Varsayılan Dense (vektör)'dür. Hibrit getirme (vektör + anahtar kelime) için Milvus 2.4.x+ veya Elasticsearch gerekir. Bir getirme modu seçin.
Meta veri filtre koşulu: Meta verileri kullanarak arama kapsamını daraltır. Meta veri kullanma.
Sorgu yeniden yazma: Belirsiz veya bağlama bağlı sorguları netleştirmek için bir LLM kullanarak getirme doğruluğunu artırır. Sorgu yeniden yazma.
-
Sonuç Yeniden Sıralama: En ilgili sonuçları en üste yerleştirmek için sonuçları yeniden sıralayan bir yeniden sıralama modeli kullanır. Sonuç Yeniden Sıralama.
NotBir yeniden sıralama modeli gerektirir. Desteklenen bağlantı türleri: Model Studio, AI Search Open Platform Model Service ve General Reranker Model Service.
Getirme performansını optimize edin
Parçalama parametrelerini ayarlayın
Temel ilkeler
Model bağlam sınırı: Parça boyutu, Embedding modeli token sınırını aşmamalıdır.
Bilgi bütünlüğü: Parçalar, fazla gürültü içermeyen eksiksiz anlamsal anlam taşımalıdır. Yapılandırılmış metinler için paragraf bazında parçalamayı düşünün.
Sürekliliği koruyun: Sınırlarda bağlam kaybını önlemek için örtüşmeyi parça boyutunun %10-%20'si olarak ayarlayın.
Tekrarlayan müdahaleden kaçının: Aşırı örtüşme fazlalık getirir ve getirme verimliliğini azaltır.
Hata ayıklama önerileri
Yinelemeli optimizasyon: İlk bir değerle başlayın (örneğin parça boyutu 300 ve örtüşme 50) ve veriniz için en iyi ayarları bulmak üzere getirme ve soru-cevap sonuçlarına dayanarak yineleme yapın.
Doğal dil sınırları: Metninizin net bir yapısı varsa (örneğin bölümlere veya paragraflara ayrılmışsa), anlamsal bütünlüğü korumak için doğal sınırları boyunca bölmeyi düşünün.
Hızlı optimizasyon kılavuzu
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Aşağıdaki tabloda, geçmiş deneyimlere dayalı olarak farklı metin türleri için önerilen parça ve örtüşme boyutları verilmiştir:
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Bir getirme modu seçin
Her getirme modunun farklı senaryolara uygun güçlü yönleri vardır:
Dense (vektör) getirme: Anlamsal anlama konusunda mükemmeldir. Hem sorguyu hem de belgeleri vektörlere dönüştürür ve vektör benzerliğini hesaplayarak anlamsal alaka düzeyini belirler.
Sparse (anahtar kelime) getirme: Tam eşleştirme konusunda mükemmeldir. Geleneksel terim frekansı modellerine (BM25 gibi) dayanır ve bir belgedeki anahtar kelime sıklığı ve konumuna göre alaka düzeyini hesaplar.
Hibrit getirme: Her ikisinin de en iyi yönlerini birleştirir. Vektör araması ve anahtar kelime araması sonuçlarını birleştirir ve Reciprocal Rank Fusion (RRF) veya ağırlıklı birleştirme gibi algoritmalar kullanarak yeniden sıralar.
|
Getirme modu |
Avantajlar ve dezavantajlar |
Senaryolar |
|
Dense (vektör) getirme |
|
|
|
Sparse (anahtar kelime) getirme |
|
|
|
Hibrit getirme |
|
|
Getirmeyi filtrelemek için meta veri kullanın
Meta veri filtrelemenin değeri
Kesin getirme, daha az gürültü: Meta veri, getirme sırasında bir filtre olarak hizmet edebilir. Meta veri ile filtreleme, alakasız belgeleri hariç tutmanızı sağlar ve oluşturma modelinin ilgisiz içerik almasını engeller. Örneğin, bir kullanıcı "Liu Cixin tarafından yazılan bilim kurgu romanlarını bul" diye sorduğunda, sistem
author=Liu Cixinvecategory=science fictionmeta veri koşullarını kullanarak doğrudan en ilgili belgeleri bulabilir.-
Geliştirilmiş kullanıcı deneyimi
Kişiselleştirilmiş öneriler: Kullanıcının geçmiş tercihlerine (örneğin "bilim kurgu" belgelerine olan tercih) dayalı kişiselleştirilmiş öneriler sunmak için meta verileri kullanın.
Geliştirilmiş yorumlanabilirlik: Sonuçlara bir belgenin meta verilerini (yazar, kaynak, tarih gibi) dahil etmek, kullanıcıların güvenilirliğini ve alaka düzeyini değerlendirmesine yardımcı olur.
Çok dilli veya çok modlu genişlemeyi destekler: "Dil" veya "medya türü" gibi meta veriler, birden çok dili veya metin ve görüntü gibi karışık medyayı içeren bilgi tabanlarını yönetmeyi basitleştirir.
Nasıl kullanılır
Özellik sınırlamaları:
Çalışma zamanı görüntü sürümü: 2.1.8 veya sonraki bir sürüm olmalıdır.
Vektör veritabanı: Yalnızca Milvus ve Elasticsearch desteklenir.
Bilgi tabanı türü: Belgeleri veya yapılandırılmış verileri destekler. Görüntüler desteklenmez.
-
Meta veri değişkenlerini yapılandırın. Milvus kullanan bilgi tabanları için, Overview sekmesindeki Metadata bölümünü bulun. Değişkenleri yapılandırmak için Edit öğesini tıklayın (örneğin
authoradlı bir değişken). Ayrılmış alanları kullanmayın.
-
Belgeleri etiketleyin. Belge parçası ayrıntıları sayfasına gidin, Edit Metadata öğesini tıklayın ve meta veri değişkenini ile değerini ekleyin (örneğin
author=Alex). Overview sayfasında meta veri kullanımını ve değer sayısını görüntüleyin.
-
Filtreleme etkisini test edin. Recall Test sekmesinde, bir meta veri filtre koşulu ekleyin ve bir test çalıştırın.

Not: Görüntüde getirilen belgeler 2. adımda etiketlenmiştir.
-
Bir uygulama akışında kullanın. Bilgi tabanı düğümünde meta veri filtre koşulunu yapılandırın.

Sorgu yeniden yazma ve sonuç yeniden sıralama
Sorgu yeniden yazma
Belirsiz, konuşma diline yakın veya bağlama bağlı sorguları, daha iyi getirme için net, bağımsız sorulara yeniden yazar.
-
Önerilen senaryolar:
Kullanıcının sorgusu belirsiz veya eksiktir (örneğin bağlam olmadan "Ne zaman doğdu?").
Çok turlu bir konuşmada, sorgu bağlama bağlıdır (örneğin "Bundan sonra ne yaptı?").
Getirici veya LLM kötü performans gösterir ve sorguyu doğru anlamaz.
Anlamsal getirme yerine geleneksel ters dizin getirme yöntemi (BM25 gibi) kullanılır.
-
Önerilmez:
Kullanıcının sorgusu zaten çok net ve spesifiktir.
LLM çok iyi performans gösterir ve sorguyu güçlü bir şekilde anlar.
Sistem düşük gecikme süresi gerektirir ve yeniden yazmadan kaynaklanan ek gecikmeyi karşılayamaz.
Sonuç yeniden sıralama
En ilgili belgeleri önceliklendirmek için getirme sonuçlarını yeniden sıralar.
-
Önerilen senaryolar:
İlk getirici kararsız sonuçlar sağlar (BM25 veya DPR gibi).
Getirme sonuçlarının sıralaması kritiktir (örneğin arama veya soru-cevap sistemlerinde yüksek Top-1 doğruluğu gerektiren durumlar).
-
Önerilmez:
Sistemin sınırlı kaynakları vardır ve ek çıkarım yükünü karşılayamaz.
İlk getirici performansı zaten yeterince güçlüdür ve yeniden sıralama sınırlı iyileştirme sağlar.
Yanıt süresi kritiktir, örneğin gerçek zamanlı arama senaryolarında.
SSS
Dizin güncelleme veya sürüm klonlama görevi hatalarını nasıl gideririm?
Bir görev başarısız olduğunda şu adımları izleyin:
-
İşlem kayıtlarını görüntüleyin: Bilgi tabanı ayrıntıları sayfasında, Operation Records alanında başarısız görevi bulun ve View Task öğesini tıklayın.

-
Görev günlüklerini kontrol edin: Sistem sizi PAI iş akışı sayfasına yönlendirir. Başarısız düğümün günlüklerini kontrol edin.

Örneğin, Document türündeki bir bilgi tabanının dizinini güncellemeye yönelik iş akışı görevi aşağıdaki üç düğümü içerir. read-oss-file düğümü hariç, her düğüm bir PAI-DLC görevi oluşturur. Günlüklerdeki Job URL aracılığıyla DLC görevi ayrıntılarını da görüntüleyebilirsiniz.
read-oss-file: OSS dosyalarını okur.
rag-parse-chunk: Belge ön işlemesi ve parçalamadan sorumludur.
rag-sync-index: Metin parçalarını embedding yapmak ve bunları vektör veritabanına senkronize etmekten sorumludur.
Bilgi tabanında neden sistem dosyaları (requirements.txt gibi) görünür?
Neden: Bilgi tabanı, yapılandırılan Input OSS Path içindeki tüm dosyaları dizinler. Bunu bir proje kök dizinine ayarlamak, requirements.txt, .DS_Store, .git/, __pycache__/ veya *.pyc gibi sistem dosyalarının istenmeden dizinlenmesine neden olabilir.
Çözüm:
OSS'de yalnızca dizinlemek istediğiniz dosyaları içeren özel bir dizin (örneğin
knowledge-base-docs/) oluşturun.Bilgi tabanı Input OSS Path alanını bu dizini gösterecek şekilde güncelleyin.
Hariç tutulacak yaygın dosyalar:
requirements.txt,.DS_Store,.git/,__pycache__/,*.pyc,*.log.
Yanlışlıkla dizinlenen dosyaları bilgi tabanından nasıl kaldırırım?
Zaten dizinlenmiş bir dosyayı getirme sonuçlarından kaldırmak için:
-
OSS'den silin: Aşağıdaki yöntemlerden birini kullanarak dosyayı kaldırın:
Konsol: Dosyayı seçin ve Permanently Delete öğesini tıklayın.
API: Değişiklik olayını tetiklemek için bir sürüm parametresi belirtin.
-
Otomatik yeniden dizinlemeyi bekleyin: Automatic Update yapılandırdıysanız (bkz. Otomatik güncelleme):
Kuralın etkili olması için en az 3 dakika bekleyin.
Yeniden dizinleme görevinin tamamlandığını doğrulamak için Operation Records sekmesini kontrol edin.
Manuel güncelleme (otomatik güncelleme yapılandırılmadıysa): Tam bir yeniden dizinlemeyi tetiklemek için sağ üst köşede bulunan Update Index öğesini tıklayın.
Kaldırmayı doğrulayın: Dosya durumunun Indexed durumundan kaldırıldığına emin olmak için Documents sekmesini kontrol edin.
Dizin kayıtlarının vektör veritabanına tamamen yayılması birkaç dakika sürebilir. Dosya yeniden dizinlemeden sonra getirmeyi etkilemeye devam ederse, başka bir manuel dizin güncellemesini tetiklemeyi deneyin.