Uygulama akışınızın üretim ortamına dağıtılmadan önceki performansını değerlendirin. LangStudio, uygulamaları önceden tanımlanmış veya özel değerlendirme şablonlarını kullanarak birden çok boyutta puanlar.
Genel Bakış
Bir uygulama akışını değerlendirmek için bir değerlendirme veri kümesi yapılandırın, giriş alanlarını eşleştirin ve bir değerlendirme şablonu seçin. Sistem, her veri kümesi satırını uygulamanız üzerinden toplu iş olarak işler, her çıktıyı yardımcı alanlara göre puanlar ve sonuçları toplar.

Başlamadan önce
Bir uygulama akışı oluşturun ve hata ayıklayın. Uygulama akışı geliştirme.
-
JSONL formatında bir değerlendirme veri kümesi hazırlayın ve OSS'e yükleyin. Örnek:
{"history":[],"query": "Describe the perilous majesty of Mount Hua", "reference": "Mount Hua stands alone, soaring to the clouds; \nSheer cliffs cut the sky, with rugged, handsome crags. \nGreen pines and bamboo vie for beauty on the cliffs; \nMonkeys cry and eagles fly, lit by frosty swords of light. \n\nPerilous peaks like scissors, jagged swords pointing to the sky; \nNarrow paths on steep slopes, where vines are the only way. \nWind and mist intertwine, as clouds emerge from caves; \nA deep fairyland, with a heavenly ladder hard to climb. \n\nJagged ridges cross, like a surging dragon's spine; \nDangerous paths lead onward, twisting toward the heavens. \nFrom lonely pine tops, eagles strike the vast sky; \nAt the summit of Mount Hua, a majestic and heroic sight.", "contexts": ["Mount Hua is one of the Five Great Mountains of China.", "Mount Hua is famous for its precipitous cliffs."]}
{"history":[],"query": "Can you list 5 rare metals? Please rank them by global demand.", "reference": "Rare metals are metallic elements that are scarce in the Earth's crust, unevenly distributed, or difficult to mine. They play a crucial role in high-tech fields and emerging industries. The ranking of global demand can change with time and technological progress, but the following are some rare metals that are typically in high demand. This list is not necessarily ranked by absolute demand, as that can vary at different times.\n\n1. **Cobalt (Co)** - Cobalt is a key component of lithium-ion batteries, especially in electric vehicles and portable electronics. It is also used to manufacture heat-resistant alloys, hard alloys, and catalysts.\n\n2. **Neodymium (Nd)** - Neodymium is a rare-earth metal mainly used to produce strong magnets, such as high-performance permanent magnets. These magnets are widely used in computer hard drives, wind turbines, and the drive motors of electric vehicles.\n\n3. **Lithium (Li)** - Lithium is primarily used to manufacture lithium batteries. As the demand for electric vehicles and portable electronic devices increases, the demand for lithium is rising rapidly.\n\n4. **Silver (Ag)** - Although silver is not as rare as the metals listed above, its industrial demand is huge. It is mainly used in electronics, solar panels, jewelry, and currency manufacturing.\n\n5. **Ruthenium (Ru)** - Ruthenium is a rare precious metal widely used for data storage in hard disk drives and large-capacity servers. It is also used in catalysts and electrochemical cells.\n\nThe demand for these metals is influenced by many factors, such as the global economy, technological development, and policy support. Moreover, as time passes and markets change, other rare metals such as tantalum, indium, rhenium, and other rare-earth metals may also appear on the list of most in-demand rare metals.", "contexts": ["Rare metals are metals with low abundance in the Earth's crust that are complex to mine and extract.", "Lithium (Li): Used in battery manufacturing.", "Cobalt (Co): Used in high-performance alloys and battery manufacturing."]}
Örnek dosya: langstudio_eval_demo.jsonl
-
Değerlendirme için gereken LLM bağlantılarını oluşturun. Bağlantı yapılandırması.
Not: Bazı değerlendirme şablonları bir LLM-as-a-Judge modeli gerektirir. Bu şablonları kullanmadan önce ilgili LLM bağlantılarını yapılandırın.
Faturalama
Uygulama akışı değerlendirmesi, veri kümesi depolaması için OSS ve çevrimdışı görevleri çalıştırmak için PAI-DLC kullanır. Her iki kaynak için de ücretlendirilirsiniz. OSS Faturalama. Deep Learning Containers (DLC) Faturalama.
Değerlendirme görevi oluşturma
Uygulamanızda hata ayıklama işlemini tamamladıktan sonra, bir değerlendirme görevi oluşturmak için sağ üst köşedeki Evaluation öğesini tıklayın.

Temel parametreler:
|
Parametre |
Açıklama |
|
Değerlendirme veri kümesi |
|
|
OSS dosyası |
Değerlendirme veri kümeniz olarak OSS'ten bir JSONL dosyası seçin. Veri kümesi, uygulama girişi olarak bir |
|
Uygulama akışı giriş eşlemesi |
|
|
question/chat_history |
Uygulamanın giriş alanlarını veri kümesi sütunlarıyla eşleştirin. Not: Değerlendirme görevi, sonuçları puanlamadan önce uygulamanızı çıkarım yapmak üzere çalıştırır. Uygulamanızın gerektirdiği giriş alanlarını seçin.
|
|
Değerlendirme yapılandırması |
|
|
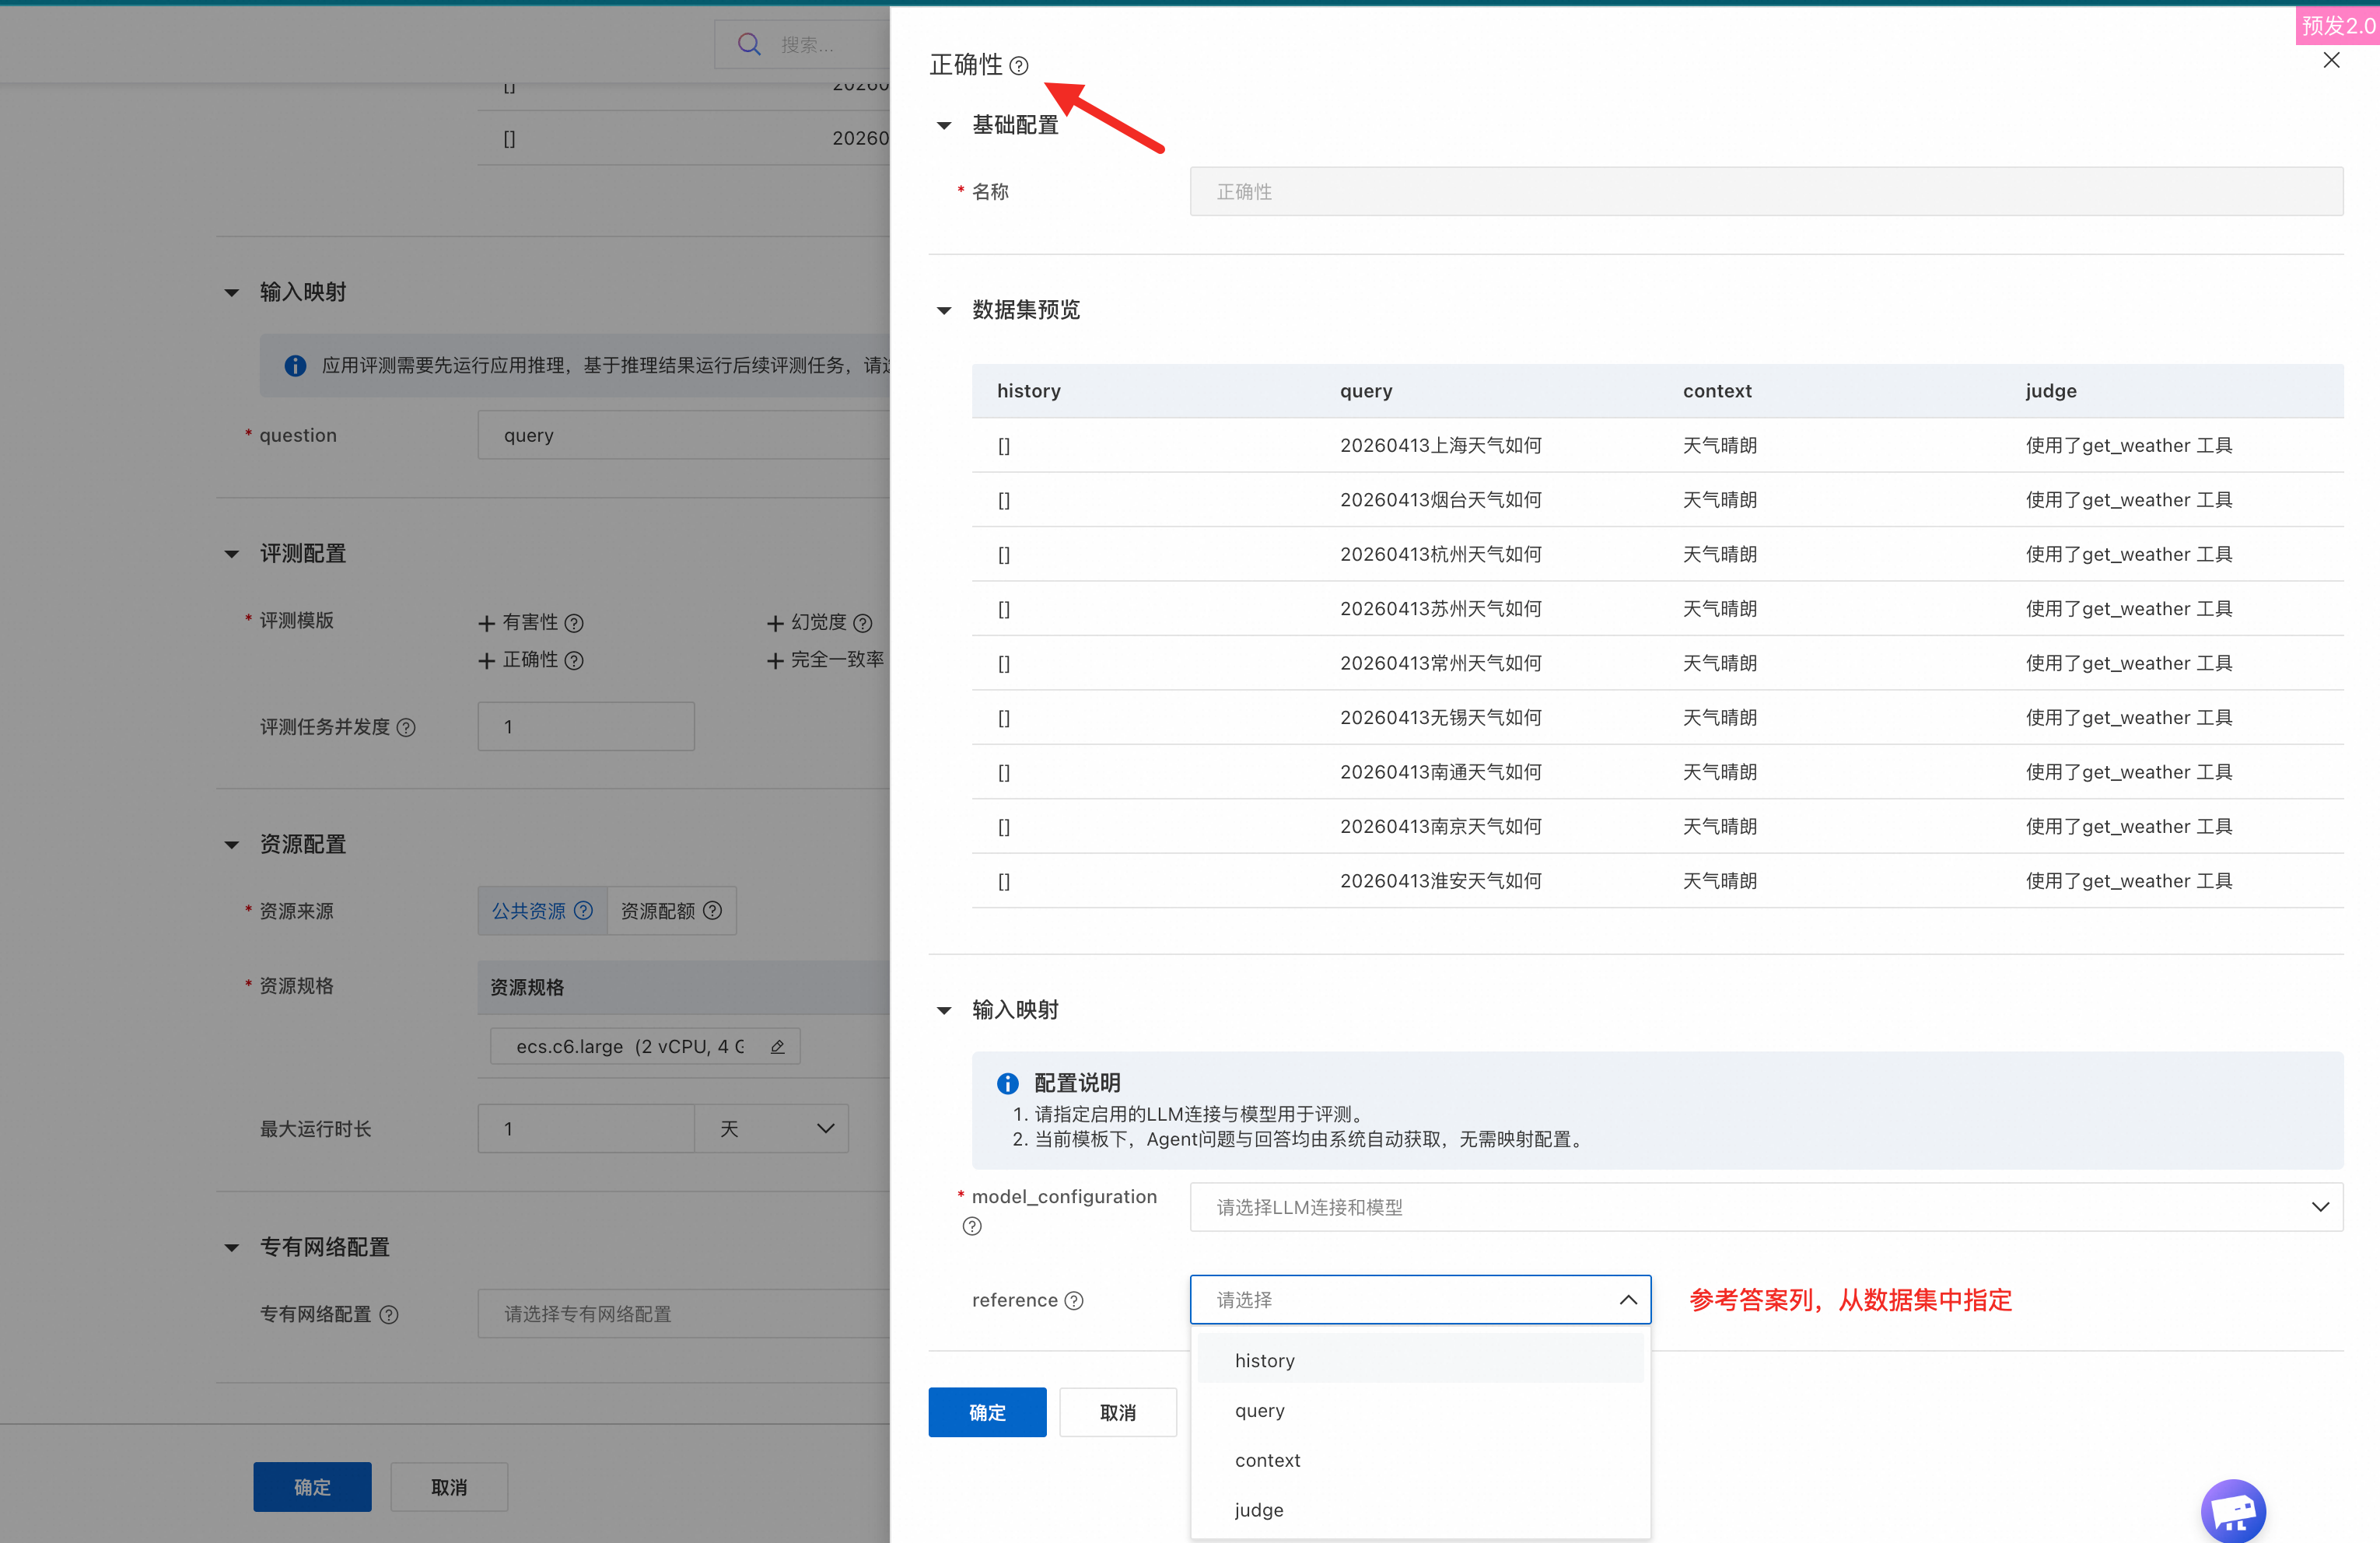
Önceden tanımlanmış şablonla değerlendirme |
Birden çok önceden tanımlanmış şablon mevcuttur. Birden çok şablon seçmek, görev ayrıntıları sayfasında sonuçları toplar. Aşağıdaki örnekte Answer Correctness Evaluation kullanılmıştır:
Temel parametreler:
|
|
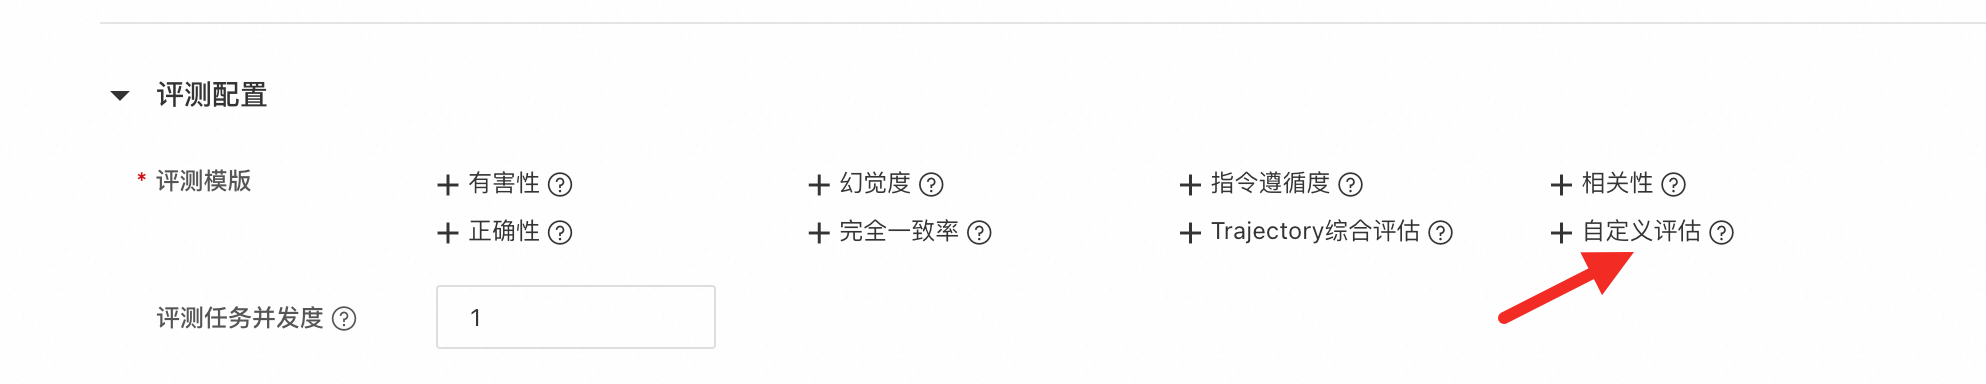
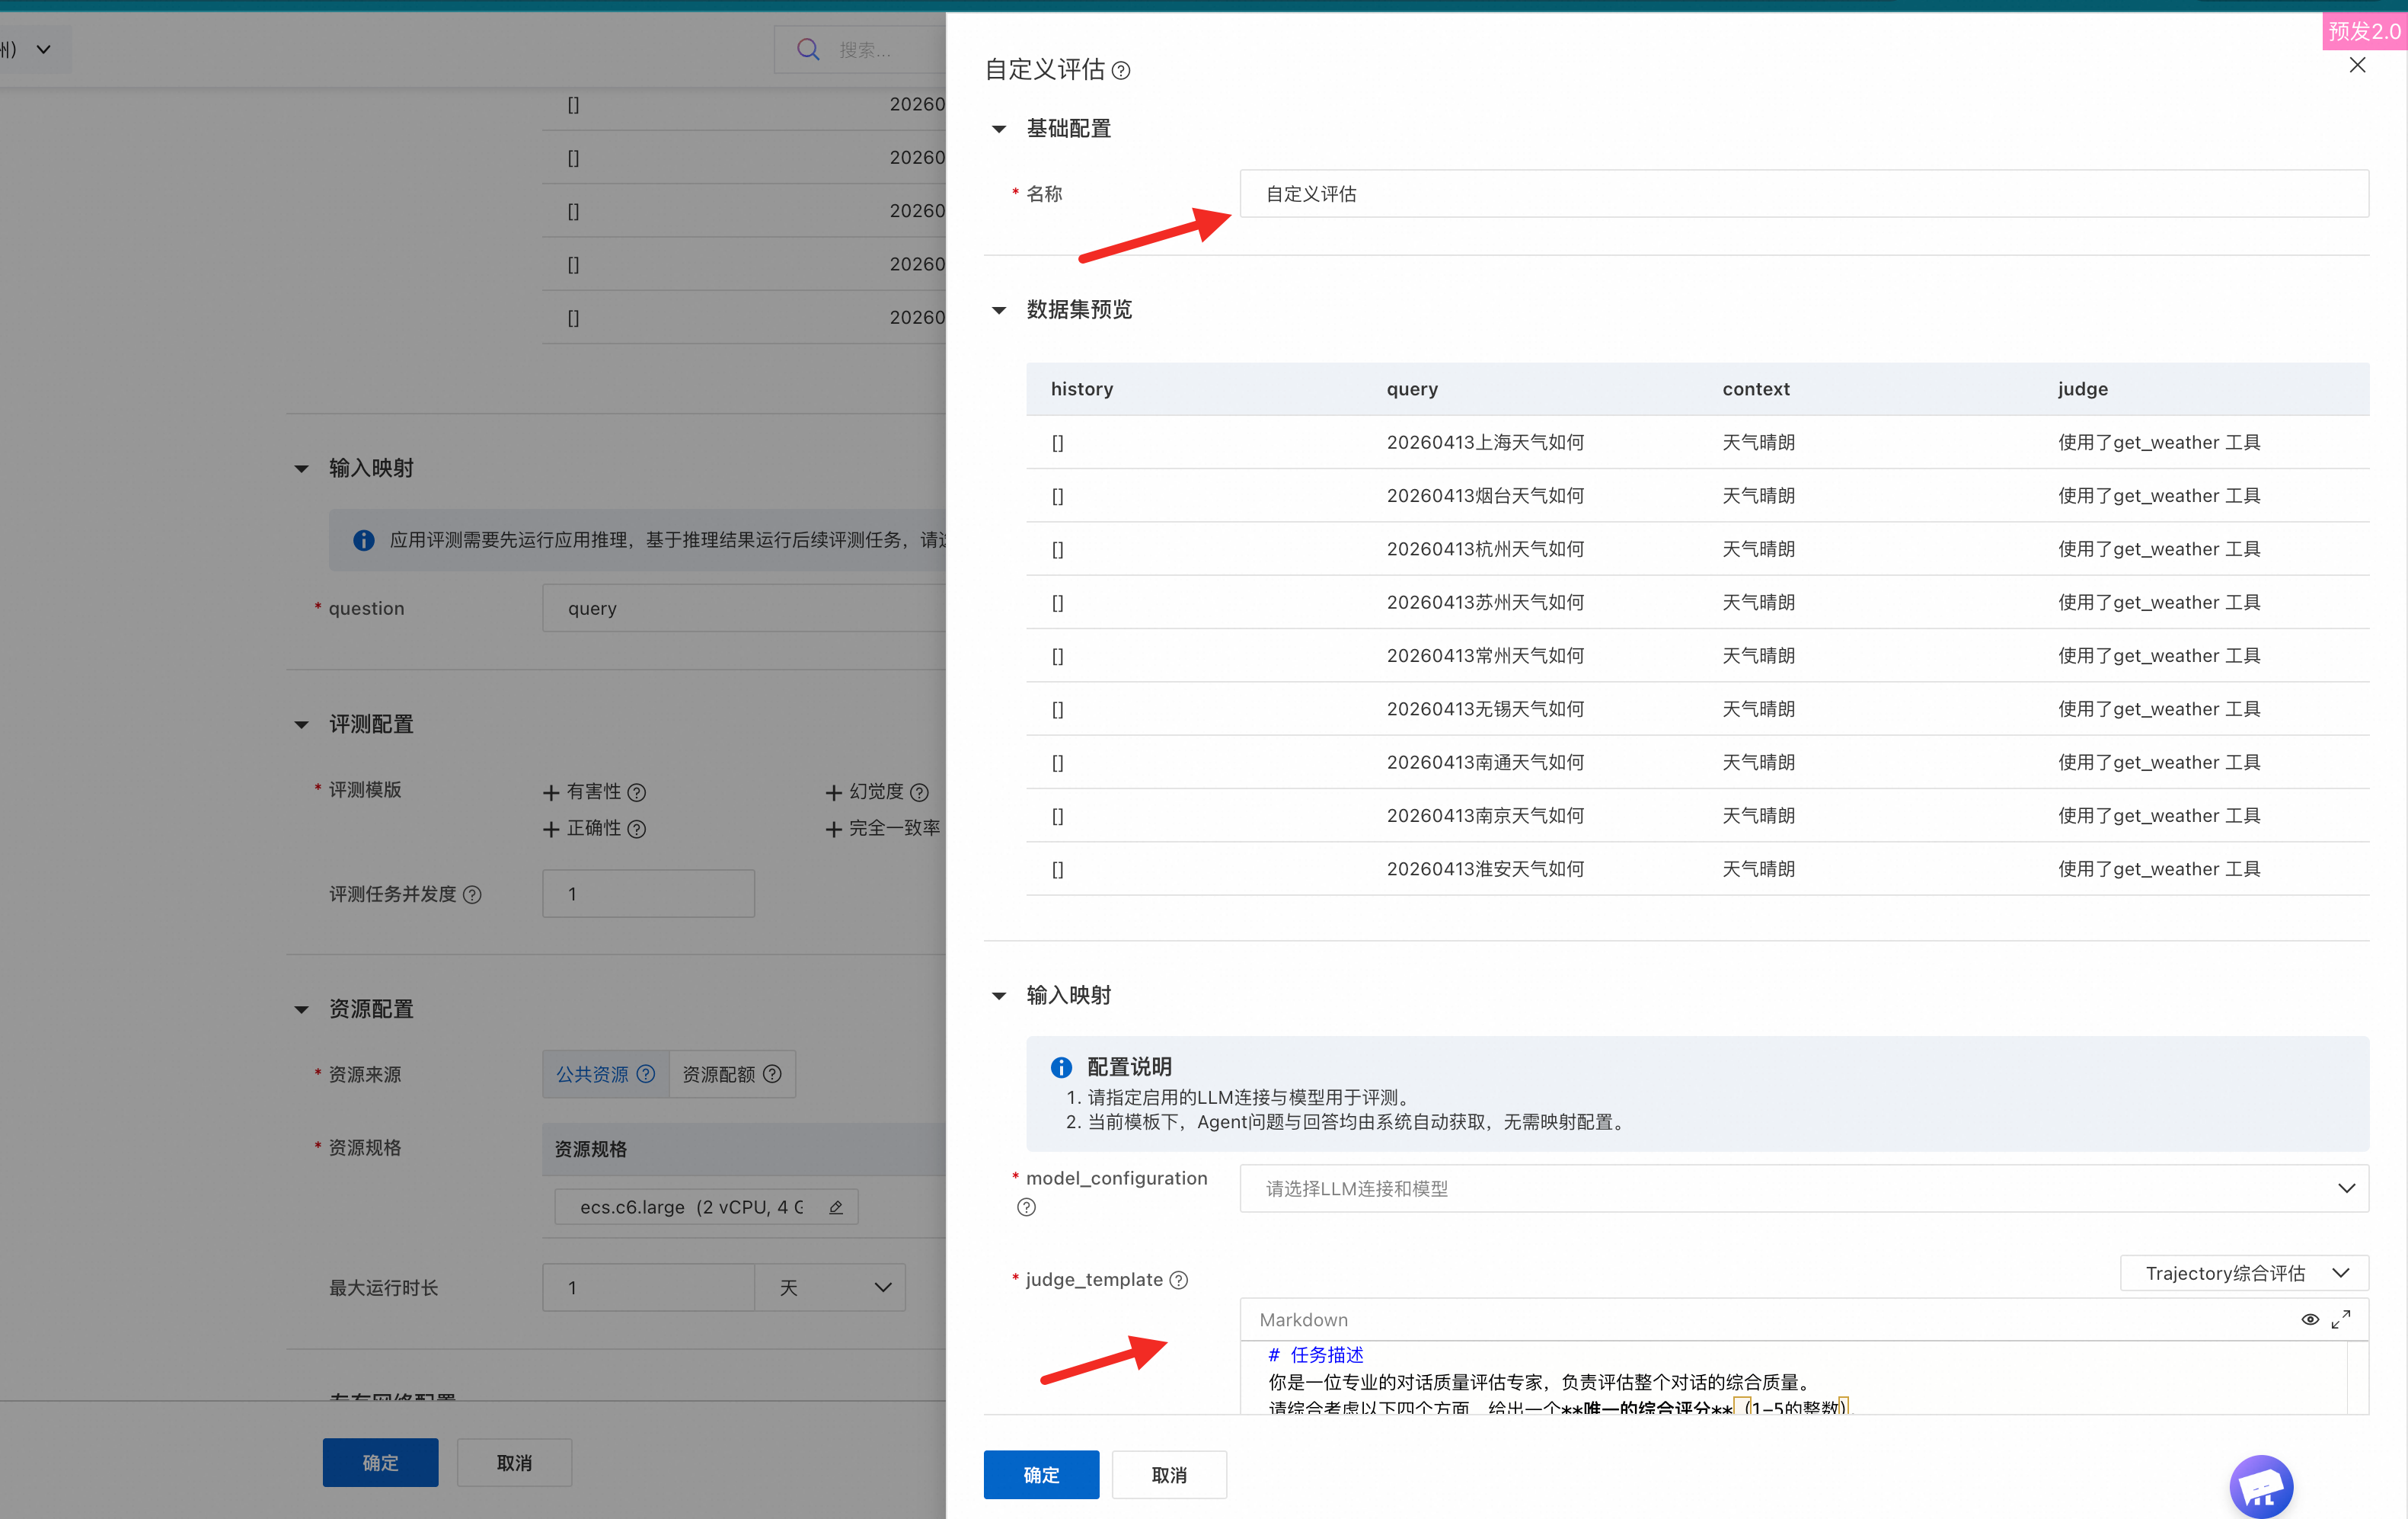
Özel değerlendirme |
Kullanıcı tanımlı bir istem şablonuyla özel bir değerlendirme oluşturun.
|
|
Kaynak yapılandırması: Değerlendirme görevinin zamanlanması için kullanılır. Görev karmaşıklığına göre CPU resources seçin. |
|
Değerlendirme sonuçlarını görüntüleme
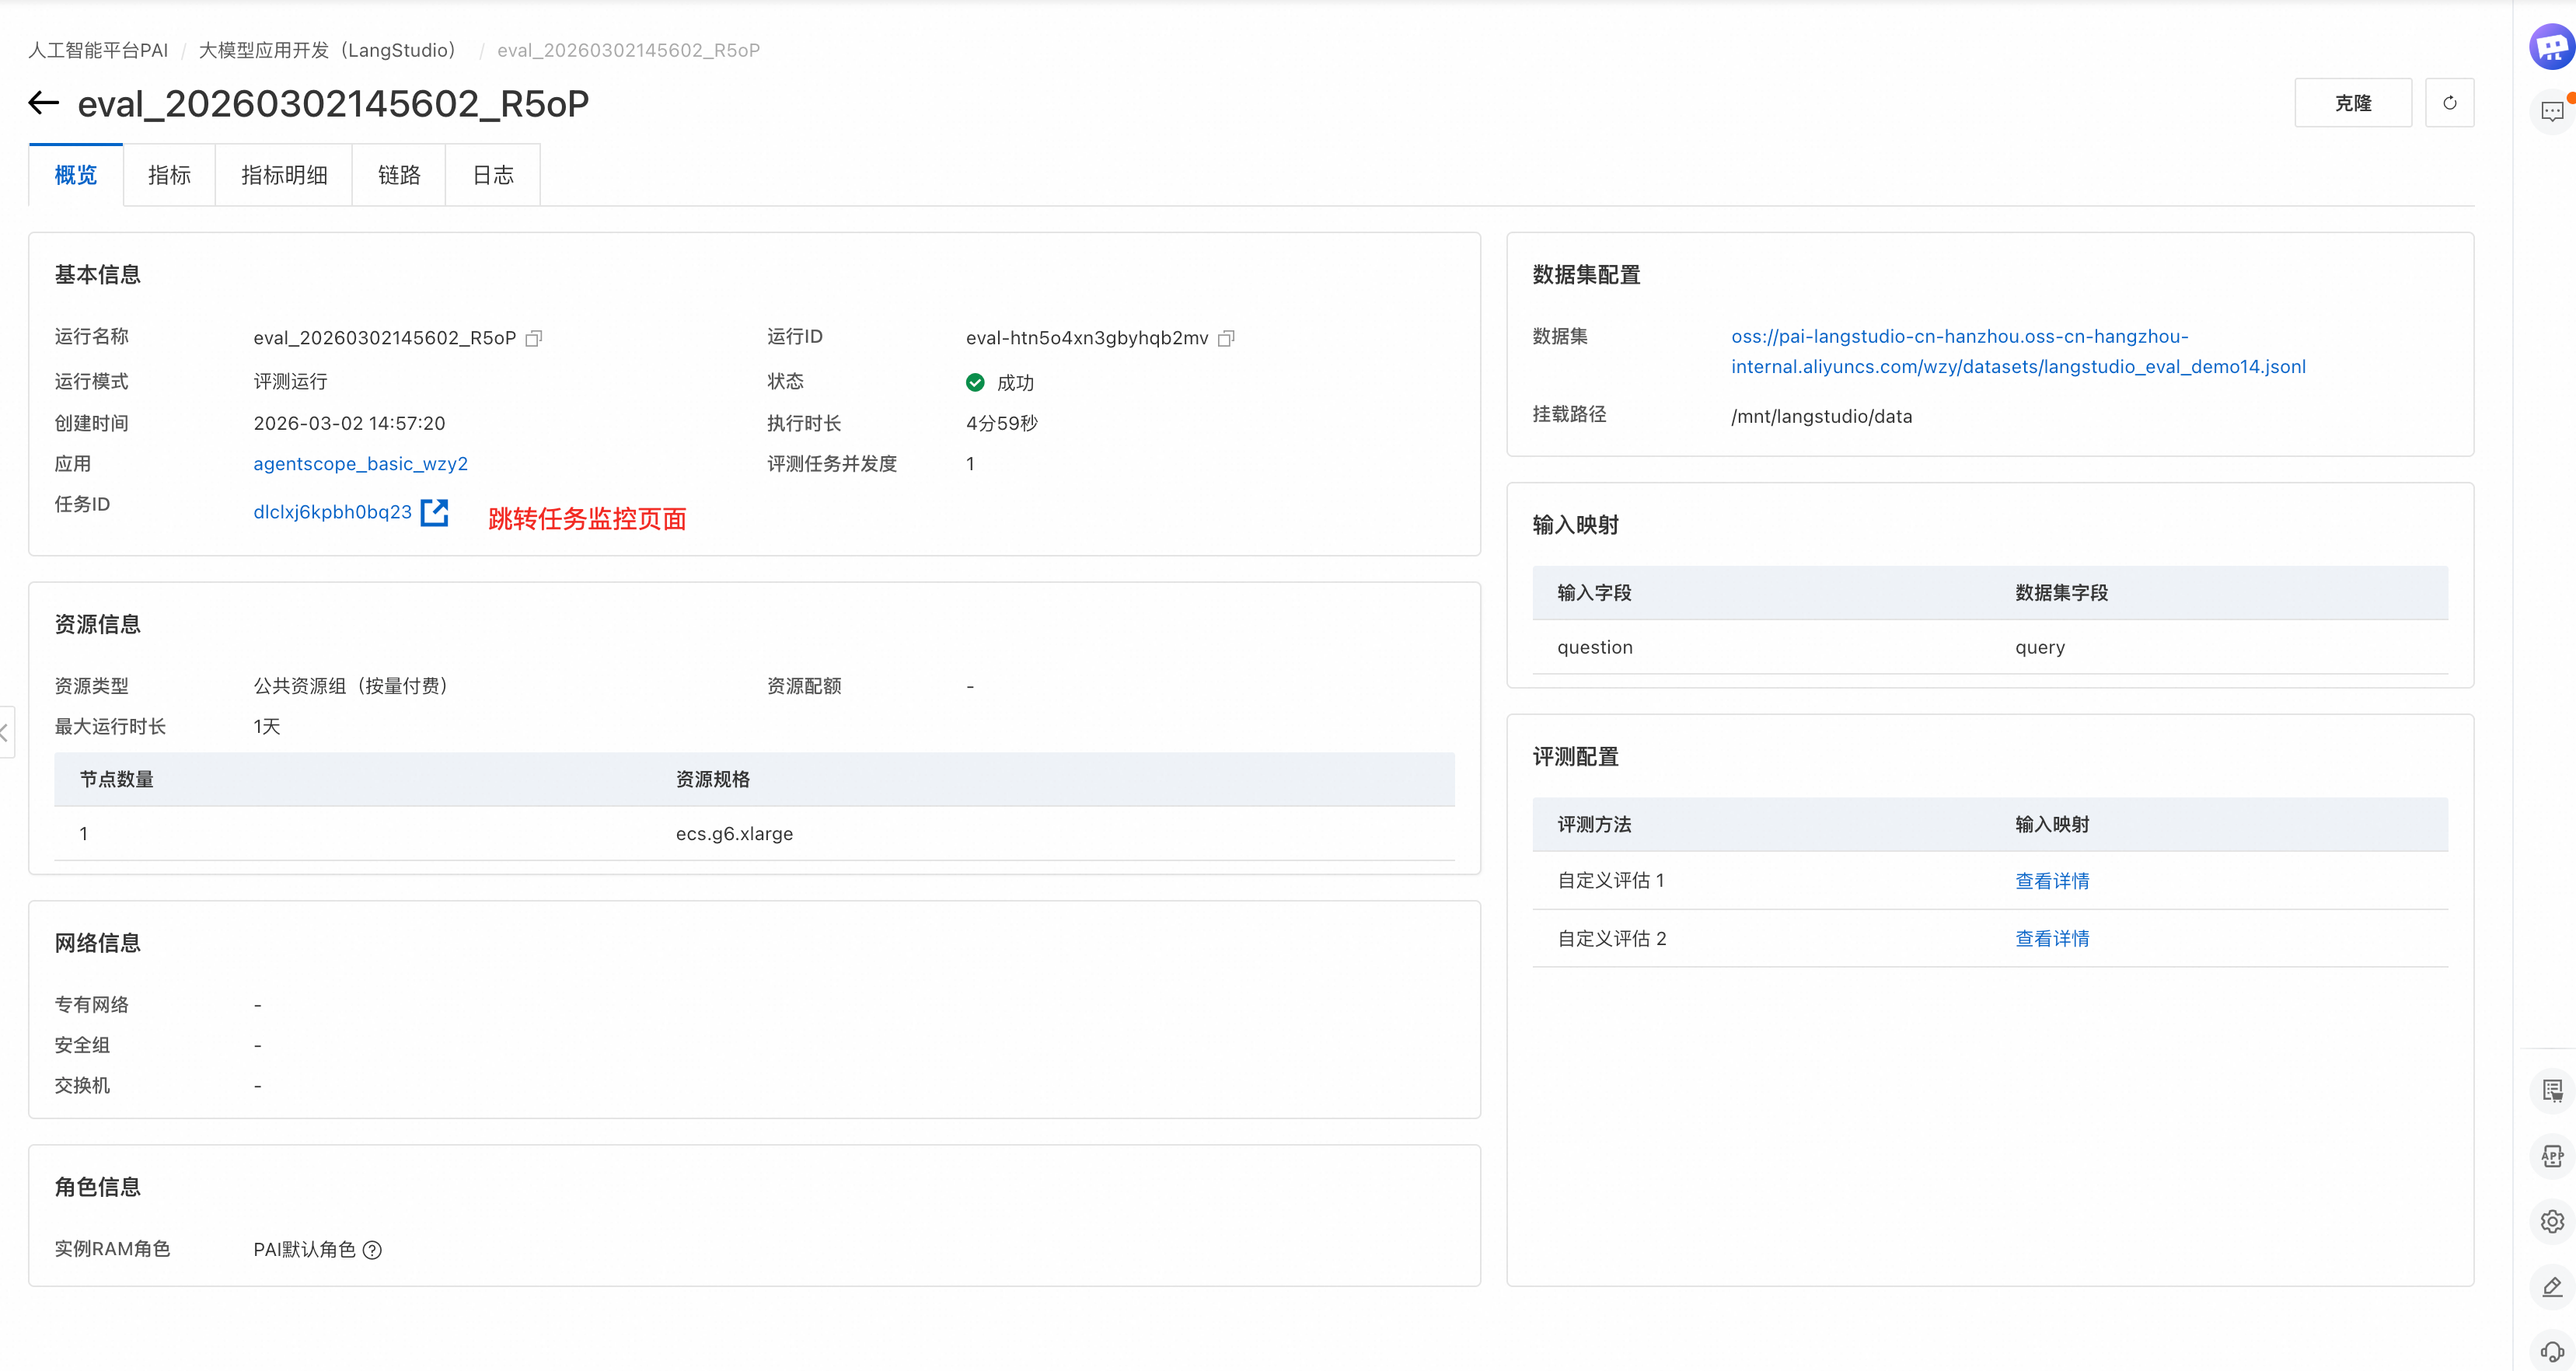
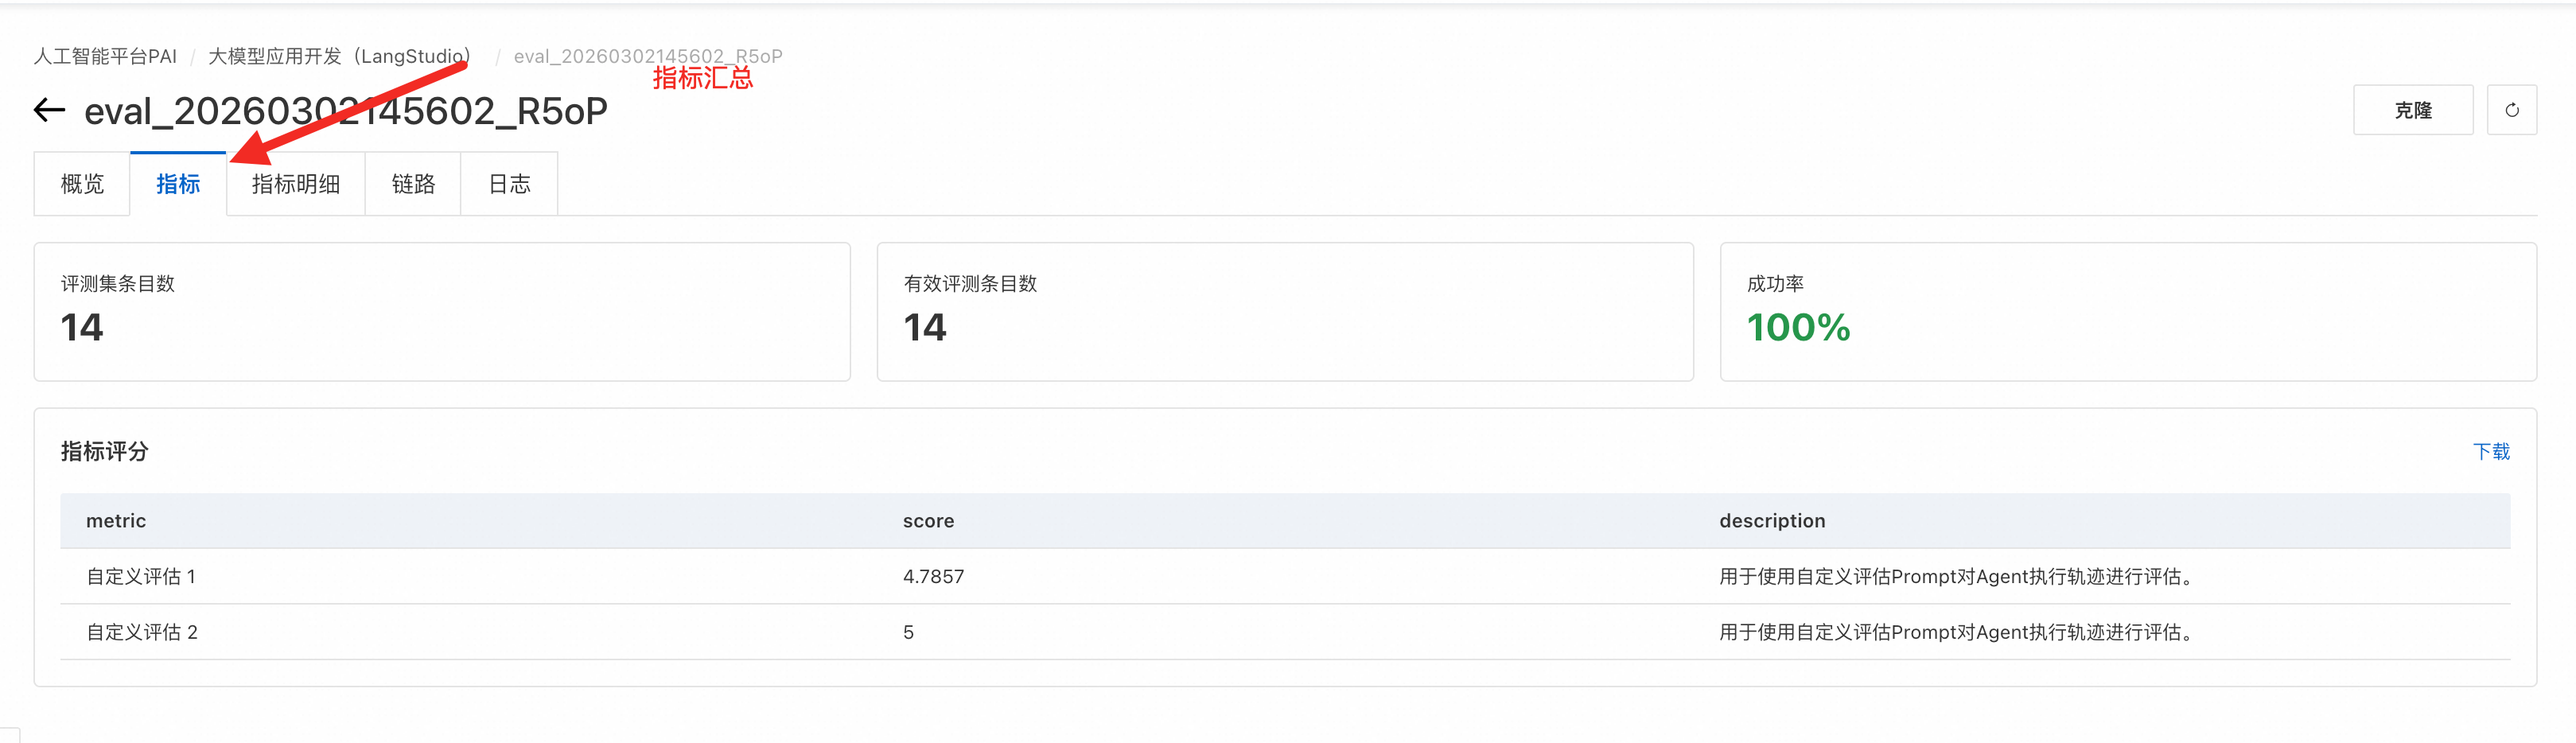
Bir değerlendirme görevi gönderdikten sonra LangStudio, görevin Overview sayfasına yönlendirir. Her çalıştırma iki aşamadan oluşur: Batch Run, her veri kümesi satırını uygulamanız üzerinden işler ve Metric Evaluation, her çıktıyı yardımcı alanlara göre puanlar. Tamamlandıktan sonra, her alt görev için izlemeyi, ölçümleri ve çıktı ayrıntılarını görüntüleyin.
Metrics sayfası tüm değerlendirme ölçüm sonuçlarını gösterir. Ölçüm adları Ek: Önceden tanımlanmış değerlendirme şablonları bölümünde tanımlanmıştır.
Ek: Önceden tanımlanmış değerlendirme şablonları
LangStudio aşağıdaki yerleşik değerlendirme şablonlarını sağlar:
|
Şablon adı |
Açıklama |
Model hizmeti türü |
Giriş alanları |
|
Exact Match Evaluation |
Agent'in çıktısını referansla karşılaştırarak tam eşleşmeleri kontrol eder. Puan: 0 (eşleşme yok) ile 1 (mükemmel eşleşme) arasında. |
Yok |
|
|
Answer Relevancy Evaluation |
Bir LLM yargıcı kullanarak uygulamanın çıktısının girdiyle olan ilgisini puanlar. Puan: 1–5 (yüksek = daha ilgili). |
LLM |
|
|
Answer Correctness Evaluation |
Bir referansa karşı olgusal doğruluğu, bilgi kapsamını ve format uyumunu değerlendirir. Puan: 1–5 (yüksek = daha yakın eşleşme). |
LLM |
|
|
Instruction Following Evaluation |
İçerik, format ve kısıtlamalardaki talimatlara uyumu değerlendirir. Puan: 1–5 (yüksek = daha iyi uyum). |
LLM |
|
|
Answer Faithfulness Evaluation |
Bağlam tarafından desteklenmeyen veya bağlamla çelişen uydurma bilgileri tespit eder. Puan: 1–5 (yüksek = daha sadık). |
LLM |
|
|
Safety Evaluation |
Zararlı, saldırgan veya uygunsuz içeriği tespit eder. Puan: 1–5 (yüksek = daha güvenli). |
LLM |
|
|
Trajectory Evaluation |
Agent'in yürütme yolunu bütünsel olarak değerlendirir. Puan: 1–5 (yüksek = daha iyi performans). |
LLM |
|