AIMaster, büyük ölçekli dağıtılmış derin öğrenme işlerinin kararlılığını ve sürekliliğini artırır. İş izleme, hata toleransı kararları ve kaynak denetimi sağlayarak yazılım ve donanım hataları, iş takılmaları ve örnek arızaları gibi sorunları giderir.
Arka plan
Derin öğrenme yaygın olarak kullanılır. Modeller ve veriler büyüdükçe dağıtılmış eğitim standart bir uygulama haline gelir. İş örneklerinin sayısı arttıkça yazılım ve donanım hataları iş başarısızlıklarına yol açabilir.
Büyük ölçekli dağıtılmış derin öğrenme işlerinin kararlı çalışmasını sağlamak amacıyla DLC, AIMaster tabanlı bir hata toleransı izleme özelliği sunar. AIMaster, iş düzeyinde bir bileşendir. Bu özelliği etkinleştirdiğinizde, işinizin diğer örnekleriyle birlikte çalışan bir AIMaster örneği devreye girer ve iş izleme, hata toleransı kararları ile kaynak denetimi hizmetlerini sağlar.
Sınırlamalar
AIMaster şu anda aşağıdaki çerçeveleri destekler: PyTorch, MPI, TensorFlow ve ElasticBatch.
1. Adım: Hata toleransı izlemeyi etkinleştirin
Bir DLC eğitim işi gönderirken konsolda veya SDK kullanarak hata toleransı izleme özelliğini etkinleştirebilirsiniz.
Konsolda
Konsolda bir DLC eğitim işi gönderirken Fault Tolerance and Diagnosis bölümüne gidin, Automatic Fault Tolerance anahtarını açın ve ek parametreleri yapılandırın. Daha fazla bilgi için Eğitim işi oluşturun konusuna bakın. DLC daha sonra işin yaşam döngüsü boyunca izleme yapmak ve hatalar oluştuğunda hata toleransı uygulamak üzere ek bir AIMaster rolü başlatır.

Ayrıntılar:
Ek parametreleri Other Cofiguration metin kutusunda yapılandırabilirsiniz. Parametre ayrıntıları için Ek: Hata toleransı parametreleri bölümüne bakın.
-
Hanging Detection özelliğini etkinleştirdikten sonra C4D Detection özelliğini açabilirsiniz. C4D (Calibrating Collective Communication over Converged ethernet - Diagnosis), büyük model eğitimlerinde yavaşlayan veya takılan işleri tanılamak için Alibaba Cloud tarafından geliştirilen bir tanılama aracıdır. Daha fazla bilgi için C4D'yi kullanın bölümüne bakın.
NotC4D, ACCL (Alibaba Cloud yüksek performanslı kolektif iletişim kitaplığı) bağımlılığına sahiptir. ACCL'nin yüklü olduğundan emin olun. Daha fazla bilgi için ACCL: Alibaba Cloud yüksek performanslı kolektif iletişim kitaplığı konusuna bakın.
Şu anda C4D algılama, Lingjun AI Computing Service kullanan DLC işleri için kullanılabilir.
Hanging Detection özelliğini etkinleştirdikten sonra, iş takılmasının gerçekleştiği kod satırını tam olarak belirlemek için işlev çağrı yığını anlık görüntüsü analiz aracını kullanabilirsiniz. Bu aracın doğru çalışması için takılma algılama eşiğini yapılandırmanız gerekir. Daha fazla bilgi için "İşlev çağrı yığını anlık görüntüsü analiz aracını kullanın" bölümüne bakın.
DLC SDK'sı aracılığıyla
2. Adım: Gelişmiş özellikleri yapılandırın
İzleme ihtiyaçlarınıza göre aşağıdaki gelişmiş özelliklerden seçim yapın.
Hata toleransı bildirimlerini yapılandırın
Bir iş için hata toleransı izlemeyi etkinleştirdikten sonra hata toleransı olayları için bildirimler yapılandırabilirsiniz. Workspace Details sayfasında Configure Workspace > Configure Event Notification seçeneklerini seçin. Ardından Create Event Rule seçeneğine tıklayın ve olay türünü DLC task > Automatic Fault Tolerance olarak ayarlayın. Daha fazla bilgi için Çalışma Alanı Olay Merkezi konusuna bakın.
Bir eğitim işi NaN kaybı gibi bir özel durumla karşılaştığında, kodunuzda AIMaster SDK'sını kullanarak özel bir bildirim mesajı gönderebilirsiniz:
Bu özelliği kullanmak için AIMaster wheel paketini yüklemeniz gerekir. Daha fazla bilgi için SSS bölümüne bakın.
from aimaster import job_monitor as jm

job_monitor_client = jm.Monitor(config=jm.PyTorchConfig())

...

if loss == Nan and rank == 0:
  st = job_monitor_client.send_custom_message(content="The training loss of the job is NaN.")
  if not st.ok():
      print('failed to send message, error %s' % st.to_string())
Özel yeniden denenebilir hata anahtar kelimelerini yapılandırın
Hata toleransı izleme, yaygın yeniden denenebilir hatalar için yerleşik algılama içerir. Başarısız olan bir örneğin günlüklerinde belirli anahtar kelimeler göründüğünde AIMaster'ın hata toleransı uygulamasını istiyorsanız bunları kodunuzda yapılandırabilirsiniz. Yapılandırmadan sonra izleme modülü, başarısız örneğin günlüğünün son kısmında bu anahtar kelimeleri tarar.
Hata toleransı ilkesi ExitCodeAndErrorMsg olarak ayarlanmalıdır.
-
PyTorch işi için özel yeniden denenebilir hata anahtar kelimelerini yapılandırma örneği
from aimaster import job_monitor as jm

jm_config_params = {}
jm_config = jm.PyTorchConfig(**jm_config_params)
monitor = jm.Monitor(config=jm_config)
monitor.set_retryable_errors(["connect timeout", "error_yyy", "error_zzz"])
monitor.set_retryable_errors içinde yapılandırılan parametreler, özel yeniden denenebilir hata anahtar kelimeleridir.
-
TensorFlow işi için özel yeniden denenebilir hata anahtar kelimelerini yapılandırma örneği
from aimaster import job_monitor as jm

jm_config_params = {}
jm_config = jm.TFConfig(**jm_config_params)
monitor = jm.Monitor(config=jm_config)
monitor.set_retryable_errors(["connect timeout", "error_yyy", "error_zzz"])
Aşamalı iş takılma algılamasını yapılandırın
Varsayılan olarak takılma algılama yapılandırması tüm iş için geçerlidir. Ancak işler genellikle farklı aşamalarda çalışır. Örneğin, başlatma sırasındaki düğüm iletişimi, günlüklerin daha sık güncellendiği eğitim aşamasına kıyasla daha uzun sürebilir. Eğitim süreci sırasında iş takılmasını hızla algılamak için DLC, aşamalı takılma algılama özelliği sunar. Bu özellik, işin farklı aşamaları için farklı takılma algılama aralıkları yapılandırmanıza olanak tanır. Yapılandırmayı aşağıdaki gibi gerçekleştirin:
monitor.reset_config(jm_config_params)

# Example:
#     monitor.reset_config(job_hang_interval=10)
#     or
#     config_params = {"job_hang_interval": 10, }
#     monitor.reset_config(**config_params)
Aşağıda PyTorch işi için aşamalı takılma algılama örneği verilmiştir.
import torch
import torch.distributed as dist
from aimaster import job_monitor as jm

jm_config_params = {
    "job_hang_interval": 1800 # Global 30-minute detection.
}
jm_config = jm.PyTorchConfig(**jm_config_params)
monitor = jm.Monitor(config=jm_config)

dist.init_process_group('nccl')

...

# impl these two funcs in aimaster sdk
# user just need to add annotations to their func
def reset_hang_detect(hang_seconds):
    jm_config_params = {
        "job_hang_interval": hang_seconds
    }
    monitor.reset_config(**jm_config_params)

def hang_detect(interval):
    reset_hang_detect(interval)
    ...

@hang_detect(180) # Reset hang detection to 3 minutes, for this function's scope only.
def train():
    ...

@hang_detect(-1) # Disable hang detection temporarily, for this function's scope only.
def test():
    ...

for epoch in range(0, 100):
    train(epoch)
    test(epoch)
    self.scheduler.step()
C4D'yi kullanın
C4D (Calibrating Collective Communication over Converged ethernet - Diagnosis), büyük model eğitimlerinde yavaşlayan veya takılan işleri tanılamak için Alibaba Cloud tarafından geliştirilen bir araçtır. C4D, Alibaba Cloud yüksek performanslı kolektif iletişim kitaplığına (ACCL) bağımlıdır. ACCL'nin yüklü olduğundan ve ortam değişkenlerinin doğru yapılandırıldığından emin olun. Daha fazla bilgi için ACCL: Alibaba Cloud yüksek performanslı kolektif iletişim kitaplığı konusuna bakın. Şu anda bir DLC işi için Lingjun AI Computing Service'i seçtiğinizde C4D algılama özelliğini kullanabilirsiniz.
Özelliklere genel bakış
C4D, bir işteki tüm düğümlerden durum bilgilerini toplayarak bir düğümde iletişim katmanında veya başka bir yerde sorun olup olmadığını belirler.

Tüm parametreler
C4D algılama özelliğini etkinleştirdikten sonra aşağıdaki parametreleri Other Configurations metin kutusunda yapılandırabilirsiniz:
Parametre | Açıklama | Örnek değer |
--c4d-log-level | C4D çıkış günlük düzeyini ayarlar. Geçerli değerler:
Varsayılan değer Warning'dir ve Warning ile Error düzeyindeki günlükleri çıktılar. Normal çalışma için varsayılan değeri kullanmanızı öneririz. Performans sorunlarını gidermek için düzeyi Info olarak ayarlayabilirsiniz. |
|
--c4d-common-envs | C4D yürütmesi için ortam değişkenlerini ayarlayın. Format
|
|
Error düzeyindeki günlükler için AIMaster ilgili düğümü otomatik olarak yalıtır ve işi yeniden başlatır. Her günlük düzeyi için işleme mantığı aşağıdaki gibidir:
Hata düzeyi | Açıklama | Eylemler |
Error | Varsayılan olarak üç dakikayı aşan bir iletişim katmanı iş takılması işin başarısız olmasına neden olur. C4D_HANG_TIMEOUT ve C4D_HANG_TIMES parametrelerini yapılandırarak bu varsayılanı değiştirebilirsiniz. | AIMaster, günlükte bildirilen düğümü otomatik olarak yalıtır. |
Warning | Varsayılan olarak 10 saniyeyi aşan bir iletişim katmanı iş takılması performansı etkiler ancak işin başarısız olmasına neden olmaz. C4D_HANG_TIMEOUT parametresini yapılandırarak bu varsayılanı değiştirebilirsiniz. | Otomatik düğüm yalıtımı yoktur. Manuel onay gereklidir. |
10 saniyeyi aşan bir iletişim katmanı dışı iş takılması işin başarısız olmasına neden olabilir. | Otomatik düğüm yalıtımı yoktur. Manuel onay gereklidir. | |
Info | İletişim katmanı ve iletişim katmanı dışı yavaşlamalar. | Bu tanılama günlükleri öncelikle performans sorunları içindir ve manuel onay gerektirir. |
Bir DLC işinin yavaş çalıştığını veya takıldığını fark ederseniz DLC iş listesine gidin ve iş adına tıklayarak işe genel bakış sayfasını açın. Örnekler bölümünde C4D tanılama sonuçlarını görmek için AIMaster düğüm günlüğünü görüntüleyin. Tanılama sonuçları hakkında daha fazla bilgi için Tanılama sonucu örnekleri bölümüne bakın.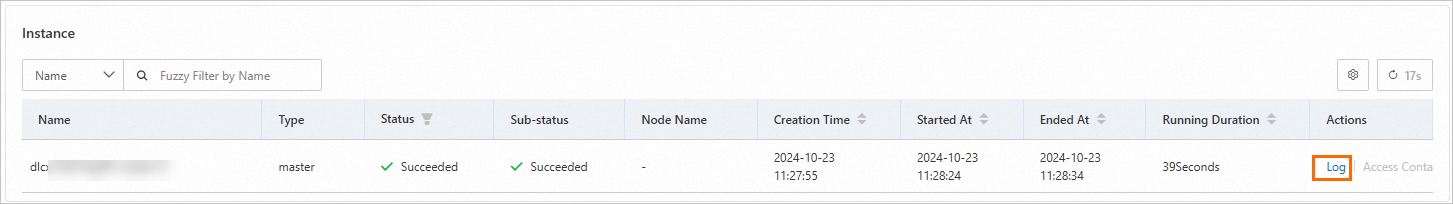
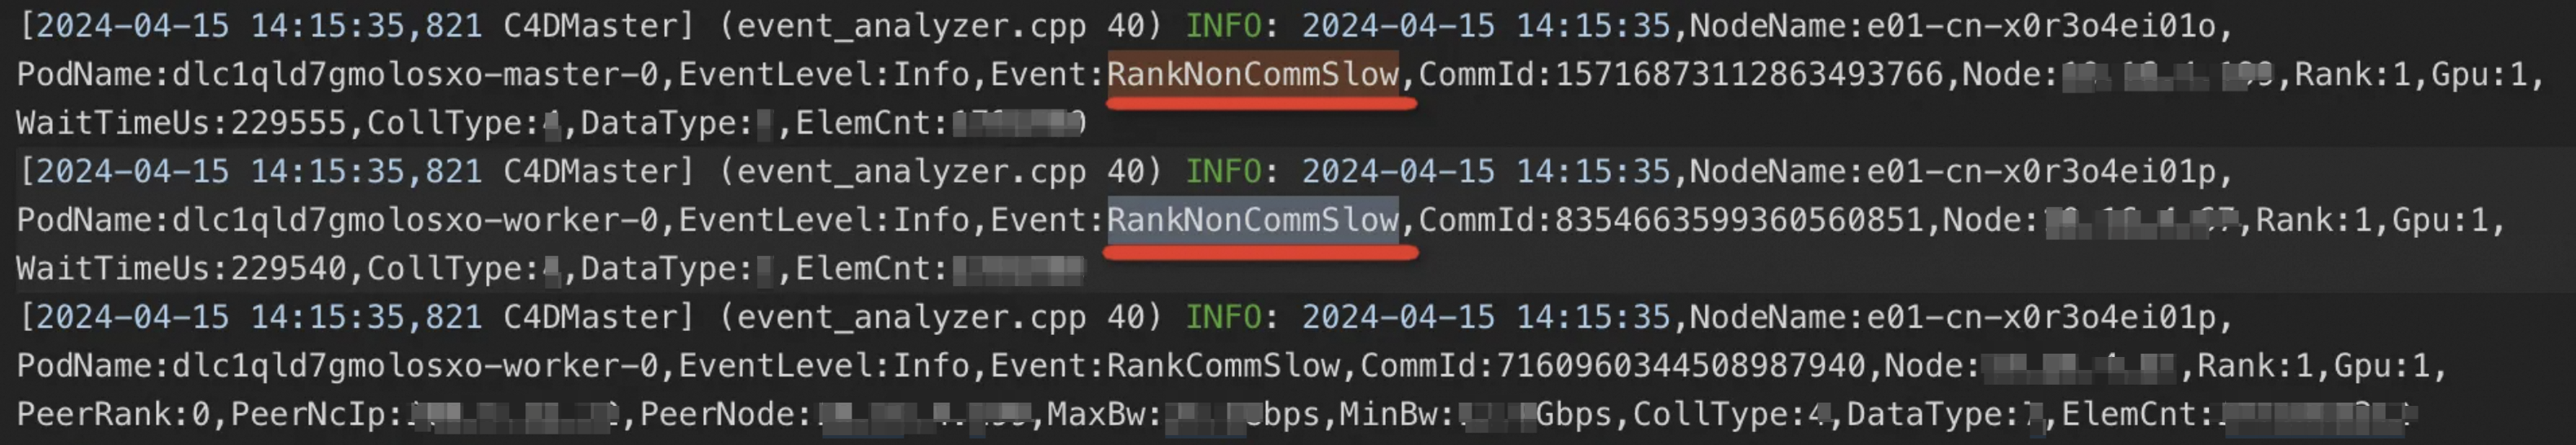
Tanılama sonucu örnekleri
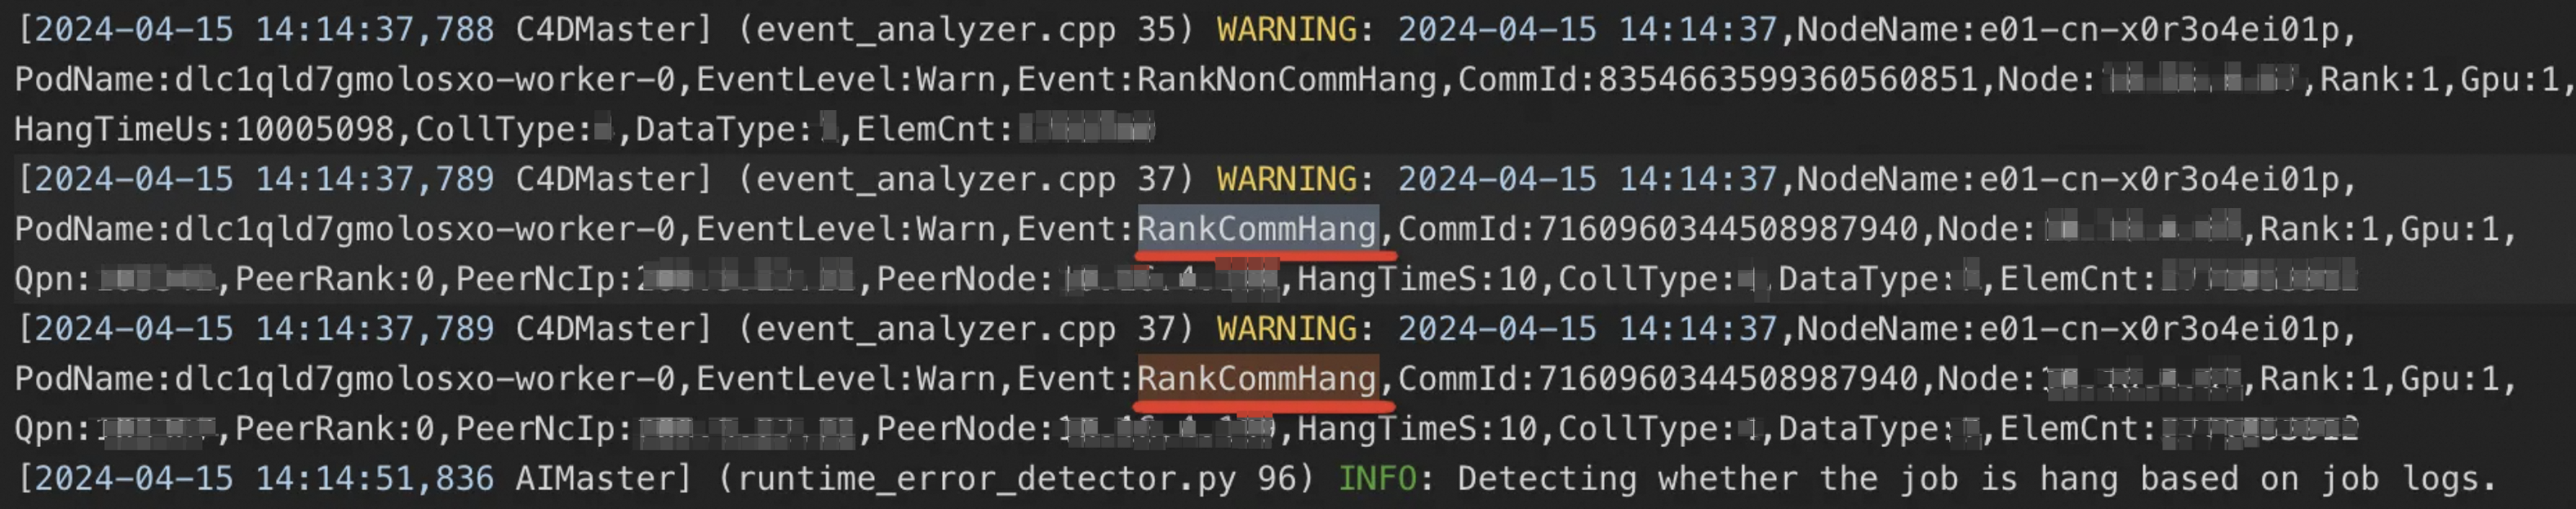
RankCommHang: Bir düğümde iletişim katmanında takılma olduğunu gösterir.
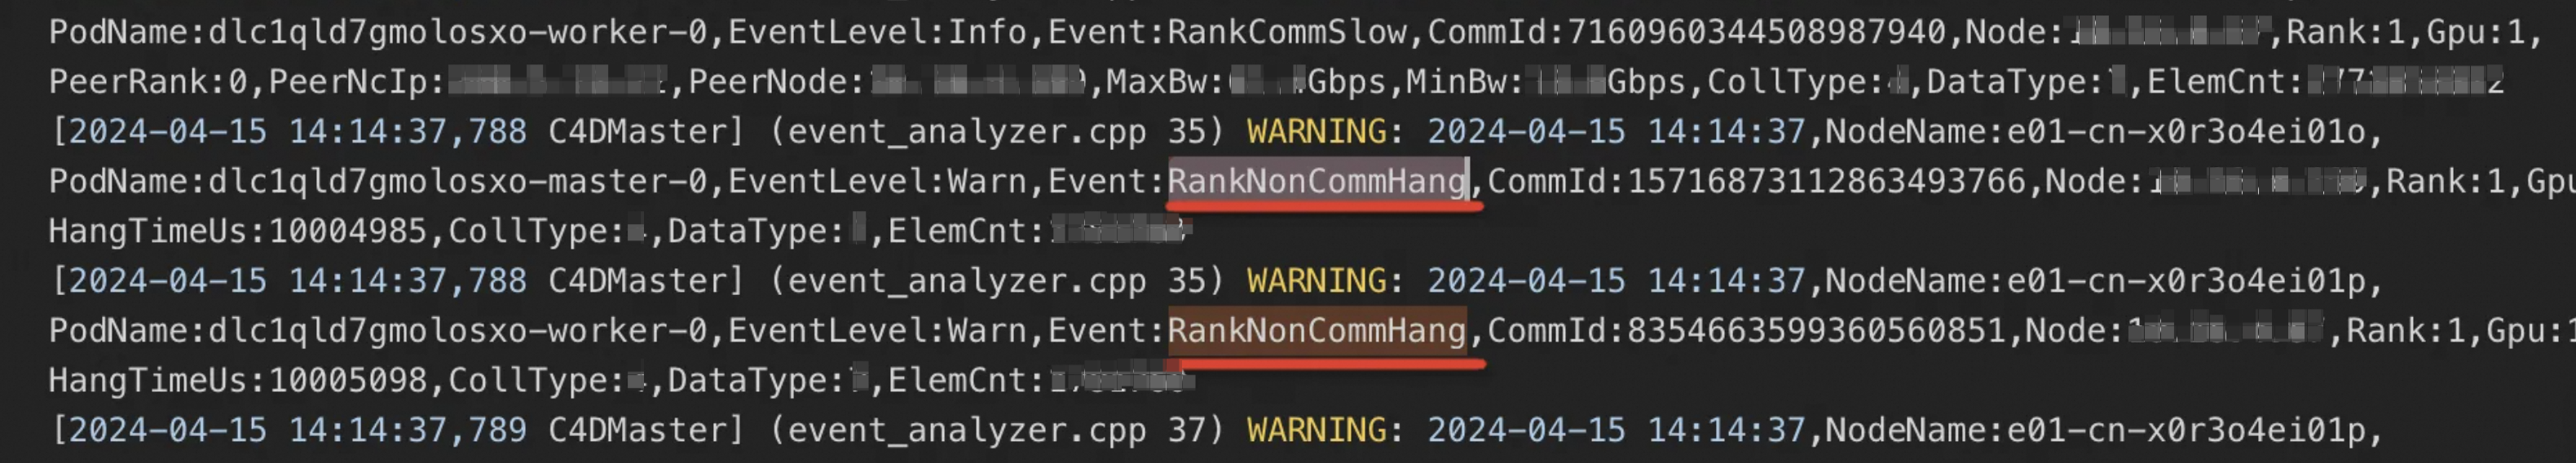
RankNonCommHang: Bir düğümde iletişim katmanı dışında, örneğin hesaplama sürecinde takılma olduğunu gösterir.
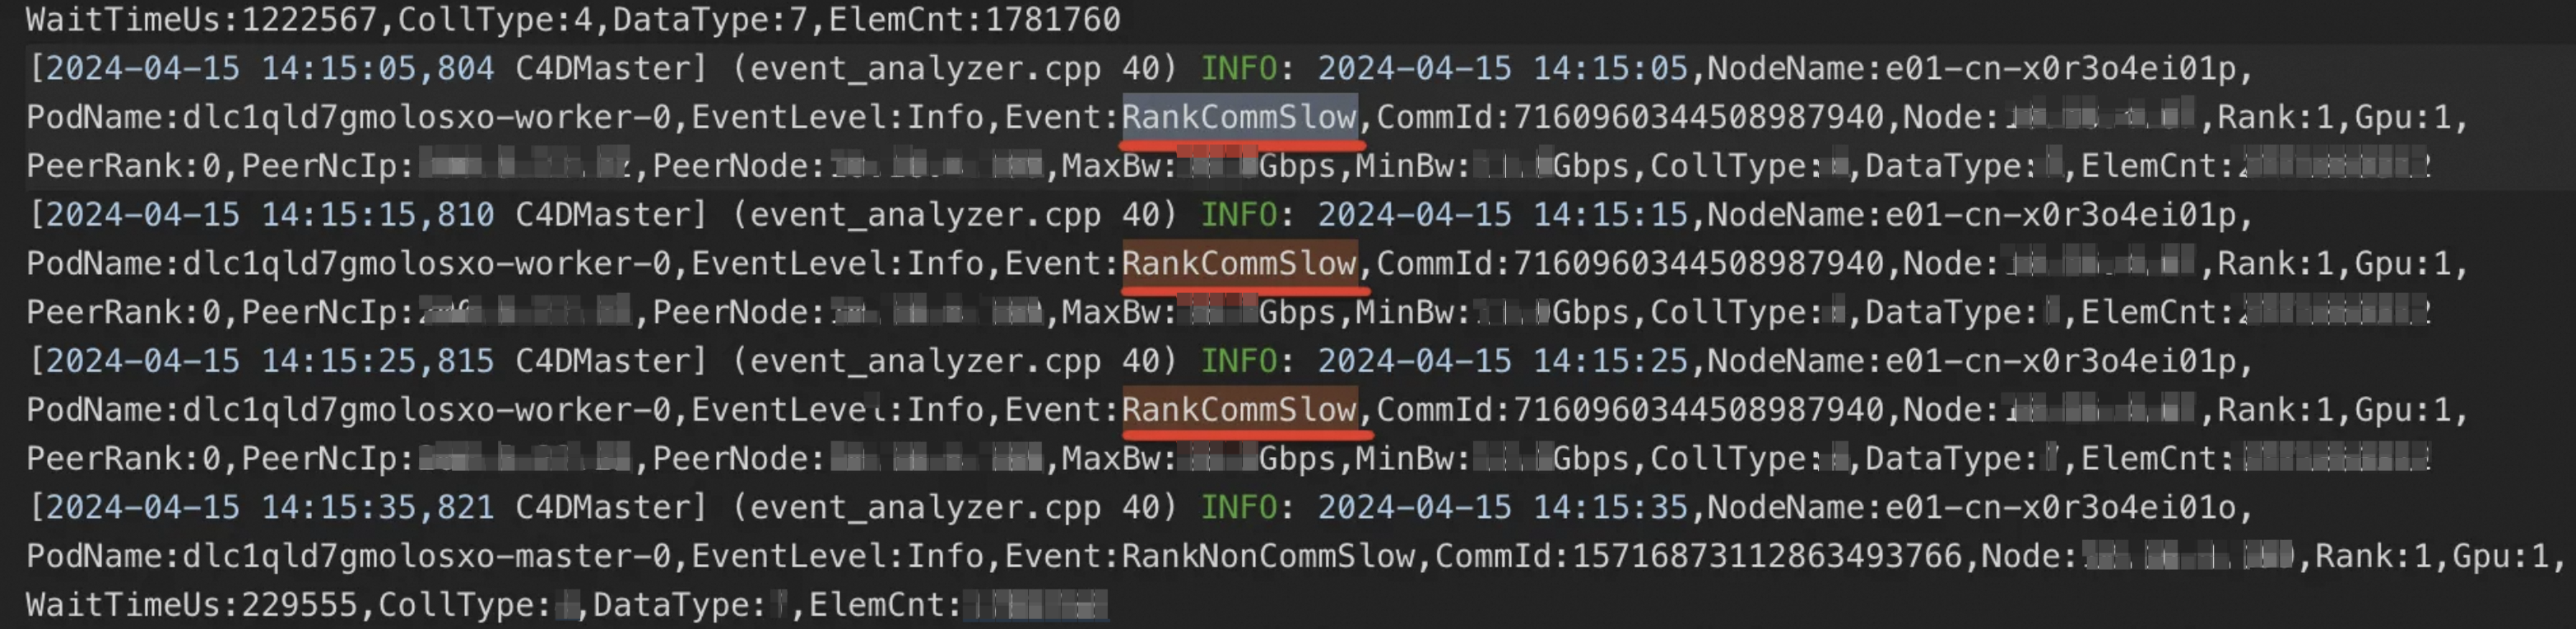
RankCommSlow: Bir düğümün iletişim katmanında yavaşladığını gösterir.
RankNonCommSlow: Bir düğümün iletişim katmanı dışında yavaşladığını gösterir.
Çağrı yığını anlık görüntülerini analiz edin
Büyük model eğitimlerinde sık karşılaşılan bir hata türü iş takılmasıdır. Yaygın türlerden biri NCCL takılmasıdır ve genellikle "Watchdog caught collective operation timeout" şeklinde bir günlük girişi oluşturur. İş takılmalarının kök nedenini hızlıca belirlemenize yardımcı olmak için işlev çağrı yığını anlık görüntüsü analiz aracını geliştirdik. Kullanmak için şu adımları izleyin:
1. Adım: pystack veya py-spy yükleyin
Önce konteyner görüntünüzde pystack veya py-spy'nin yüklü olup olmadığını doğrulayın. Yüklü değilse birini yüklemeniz gerekir. Örneğin pystack'i yüklemek için aşağıdaki komutu kullanın:
pip install pystack -i https://mirrors.cloud.aliyuncs.com/pypi/simple/ --trusted-host mirrors.cloud.aliyuncs.com2. Adım: Takılma algılamayı etkinleştirin
Takılma algılamayı nasıl etkinleştireceğinizle ilgili talimatlar için Konsolda bölümüne bakın. İşlev çağrı yığını anlık görüntüsü analiz aracının doğru çalışması için takılma algılama eşiği için uygun bir değer de ayarlamanız gerekir. Önce model işiniz için zaman aşımı değerini belirleyin. Bu değeri genellikle bir iş takıldıktan sonraki hata günlüğünde bulabilirsiniz. Örneğin:
Watchdog caught collective operation timeout: WorkNCCL(SeqNum=2143, OpType=ALLREDUCE, NumelIn=659, NumelOut=659, Timeout(ms)=600000) ran for 600535 milliseconds before timing outBu hata günlüğündeki Timeout alanından işin zaman aşımının 600.000 milisaniye (600 saniye veya 10 dakika) olduğunu görebilirsiniz. Bu durumda takılma algılama eşiğini 450 saniye olarak ayarlamanızı öneririz. Günlüğünüzdeki Timeout değeri 1.800 saniye ise eşiği 1.500 saniye olarak ayarlamanızı öneririz. Genel kural olarak takılma algılama eşiği, işin zaman aşımı değerinden yaklaşık 150 ila 200 saniye daha az olmalıdır.
Takılma algılamayı doğru yapılandırdıktan sonra AIMaster, bir takılma olduğunda iş sürecinin işlev çağrı yığınını otomatik olarak toplar ve analiz eder. Analiz sonucunu AIMaster düğüm günlüğünde görüntüleyebilirsiniz. Aşağıda, bir iş takılmasından sonra aracın örnek bir analiz sonucu verilmiştir:

Analiz sonucunda stack alanı işlev çağrı yığınını gösterir, threads alanı bu yığının oluştuğu iş parçacıklarını listeler ve count alanı bu yığına sahip iş parçacığı sayısını belirtir. count değeri 1 olan yığınların iş takılmasının nedeni olma olasılığı yüksektir ve öncelikle incelenmelidir.
3. Adım: Yeniden başlatma nedenlerini görüntüleyin
-
Yeniden başlatma turlarını görüntüleyin: İş yeniden başlatma bilgileri tur bazında düzenlenir. İş ayrıntıları sayfasında bir turun ayrıntılarını genişleterek her aşamada harcanan zaman gibi bilgileri görüntüleyebilirsiniz. Bu, işin yürütme durumunu daha doğru anlamanıza yardımcı olur.

-
Yeniden başlatma geçmişini görüntüleyin: İlgili yeniden başlatma bilgilerini (yeniden başlatma nedeni, sonucu ve süresi dahil) görüntülemek için yeniden başlatma sayısı bağlantısına veya Restart records sekmesine tıklayabilirsiniz.

Yordam:
Restart records listesinde belirli bir yeniden başlatma için Description seçeneğine tıklayarak Restarts, Restart Time, Node Name, Instance Name, Error Code, Error Message ve Error Source dahil olmak üzere ayrıntılı bilgileri görüntüleyin.
-
Tüm yeniden başlatma kayıtları için ayrıntı listesinin tamamını genişletmek üzere View Aggregation Fault Details seçeneğine tıklayın.

Ek: Hata toleransı parametreleri
Bu bölümde hata toleransı izleme özelliğine ait tüm parametreler açıklanmaktadır. Ayarlarınızı planlamak için yaygın parametre yapılandırma örneklerine başvurabilirsiniz. Hata toleransı izlemeyi etkinleştirirken bu parametreleri gerektiği şekilde Other Cofiguration bölümünde yapılandırabilirsiniz.
Tüm parametreler
Genel yapılandırma
Özellik | Parametre | Açıklama | Varsayılan |
İş yürütme modu | --job-execution-mode | İşin yürütme modu. Geçerli değerler:
Yeniden denenebilir hatalar için hata toleransı davranışı iş türüne göre farklılık gösterir:
| Sync |
İş yeniden başlatma ayarları | --enable-job-restart | Hata toleransı koşulları karşılandığında veya bir çalışma zamanı özel durumu algılandığında işin yeniden başlatılıp başlatılmayacağını belirtir. Geçerli değerler:
| False |
--max-num-of-job-restart | İşin yeniden başlatılabileceği maksimum sayı. Bu sayı aşıldığında iş başarısız olur. | 3 |
Çalışma zamanı yapılandırması
Hiçbir örneğin başarısız olmadığı senaryolar için geçerlidir.
Özellik | Parametre | Açıklama | Varsayılan |
İş takılma algılama | --enable-job-hang-detection | İş için çalışma zamanı takılma algılamanın etkinleştirilip etkinleştirilmeyeceğini belirtir. Bu özellik yalnızca eşzamanlı işleri destekler. Geçerli değerler:
| False |
--job-hang-interval | Bir işin askıda kalabileceği saniye cinsinden süre. Pozitif bir tamsayı olmalıdır. Askıda kalma süresi bu değeri aşarsa iş anormal kabul edilir ve yeniden başlar. | 1800 | |
--enable-c4d-hang-detection | Çalışma sırasında iş takılmasına neden olan yavaş düğümleri ve hatalı düğümleri hızlıca teşhis etmek ve konumlandırmak için C4D algılamayı etkinleştirip etkinleştirmeyeceğinizi belirtir. Not Bu parametre yalnızca --enable-job-hang-detection parametresi de etkinleştirildiğinde etkili olur. | False | |
İş çıkışı takılma algılama | --enable-job-exit-hang-detection | İş çıkışı sırasında takılma algılamayı etkinleştirip etkinleştirmeyeceğinizi belirtir. Bu özellik yalnızca eşzamanlı işleri destekler. Geçerli değerler:
| False |
--job-exit-hang-interval | İşin çıkış sırasında askıda kalabileceği saniye cinsinden süre. Pozitif bir tamsayı olmalıdır. Çıkış süresi bu değeri aşarsa iş anormal kabul edilir ve yeniden başlar. | 600 |
Hata toleransı yapılandırması
En az bir örneğin başarısız olduğu senaryolar için geçerlidir.
Özellik | Parametre | Açıklama | Varsayılan |
Hata toleransı ilkesi | --fault-tolerant-policy | Hata toleransı ilkesi. Geçerli değerler:
| ExitCodeAndErrorMsg |
Aynı hatanın maksimum oluşum sayısı | --max-num-of-same-error | Tek bir örnekte aynı hatanın oluşabileceği maksimum sayı. Hata sayısı bu değeri aşarsa iş başarısız olur. | 10 |
Maksimum tolere edilebilir hata oranı | --max-tolerated-failure-rate | Maksimum tolere edilebilir hata oranı. Başarısız örneklerin oranı bu değeri aşarsa iş başarısız olur. -1 varsayılan değeri bu özelliği devre dışı bırakır. Örneğin 0,3 değeri, worker'ların %30'undan fazlası bir hatayla karşılaşırsa işin başarısız olacağı anlamına gelir. | -1 |
Parametre yapılandırma örnekleri
Aşağıdaki örnekler farklı eğitim işleri için yaygın parametre yapılandırmalarını göstermektedir.
-
Eşzamanlı eğitim işi (PyTorch işleri için yaygındır)
Bir örnek başarısız olur ve hata toleransı koşullarını karşılarsa iş yeniden başlar.
--job-execution-mode=Sync --enable-job-restart=True --max-num-of-job-restart=3 --fault-tolerant-policy=ExitCodeAndErrorMsg -
Eşzamansız eğitim işi (TensorFlow işleri için yaygındır)
Yeniden denenebilir hatalar için başarısız Worker örnekleri yeniden başlatılır. Bir PS veya Chief örneği başarısız olursa iş varsayılan olarak yeniden başlatılmaz. İş yeniden başlatmalarını etkinleştirmek için --enable-job-restart=True ayarlayın.
--job-execution-mode=Async --fault-tolerant-policy=OnFailure -
Çevrimdışı çıkarım işi (ElasticBatch işleri için yaygındır)
Örnekler bağımsızdır ve eşzamansız bir işe benzer. Bir örnek başarısız olduğunda yalnızca o örnek yeniden başlar.
--job-execution-mode=Async --fault-tolerant-policy=OnFailure
SSS
S: AIMaster SDK'sını nasıl yüklerim?
Python sürümünüze karşılık gelen komutu kullanarak wheel paketini yükleyin.
# Python 3.6
pip install -U http://odps-release.cn-hangzhou.oss.aliyun-inc.com/aimaster/pai_aimaster-1.2.1-cp36-cp36m-linux_x86_64.whl

# Python 3.8
pip install -U http://odps-release.cn-hangzhou.oss.aliyun-inc.com/aimaster/pai_aimaster-1.2.1-cp38-cp38-linux_x86_64.whl

# Python 3.10
pip install -U http://odps-release.cn-hangzhou.oss.aliyun-inc.com/aimaster/pai_aimaster-1.2.1-cp310-cp310-linux_x86_64.whl